Une transcription propre d'un podcast ou d'une vidéo de formation de 30 minutes est réalisable en moins de 10 minutes avec DubSmart AI, et la plupart des créateurs y parviennent pour un montant compris entre 0 $ et environ 20–50 $ par mois selon le volume. Si vous voulez savoir comment transcrire de l'audio en texte sans assembler une application de transcription séparée, un nettoyeur de bruit et un éditeur de sous-titres, notre moteur de reconnaissance vocale réalise toute la tâche dans un seul espace de travail : téléchargez le média, générez du texte avec une précision supérieure à 95 % sur un audio clair, modifiez les étiquettes des locuteurs et la ponctuation, puis exportez une transcription ou des sous-titres prêts à publier.
Le véritable avantage ici n'est pas seulement la vitesse. Comme la transcription, le nettoyage audio, le doublage et la voix off partagent le même pool de crédits, la même transcription que vous créez aujourd'hui peut alimenter le Doublage IA dans 33 langues cibles ou la synthèse vocale avec plus de 300 voix plus tard. Cela compte si vous gérez une chaîne YouTube, créez des cours en e-learning ou localisez des formations d'entreprise.
Table des matières
Ce dont vous avez besoin avant de commencer
La qualité de la transcription se décide avant même d'appuyer sur un seul bouton. Parcourez d'abord cette liste de contrôle :
- Un compte DubSmart avec accès à Reconnaissance vocale et à Speech Separator sur le forfait Free, Starter ou supérieur.
- Vos fichiers source prêts à l'emploi : épisodes de podcast, webinaires, interviews ou un lien YouTube.
- Les droits et l'autorisation de transcrire le contenu, ce qui est particulièrement important pour les travaux clients et les enregistrements de tiers.
- Un format de sortie cible clair en tête : une transcription complète (DOC/TXT), des sous-titres (SRT/VTT) ou un script pour le doublage et la voix off.
- Des informations de base sur l'enregistrement : langue source, nombre de locuteurs et présence éventuelle de musique ou de bruit de fond important.
- Pour les équipes soumises à réglementation, vos directives internes sur le traitement des données personnelles ou sensibles dans les outils cloud.
Connaître votre format de sortie à l'avance vous évite un aller-retour. Un travail de notes de blog nécessite du texte brut ; un téléversement YouTube nécessite des sous-titres synchronisés ; un travail de localisation nécessite un script propre que vous pouvez directement envoyer vers le doublage.
Étape par étape : transcrire de l'audio en texte avec DubSmart
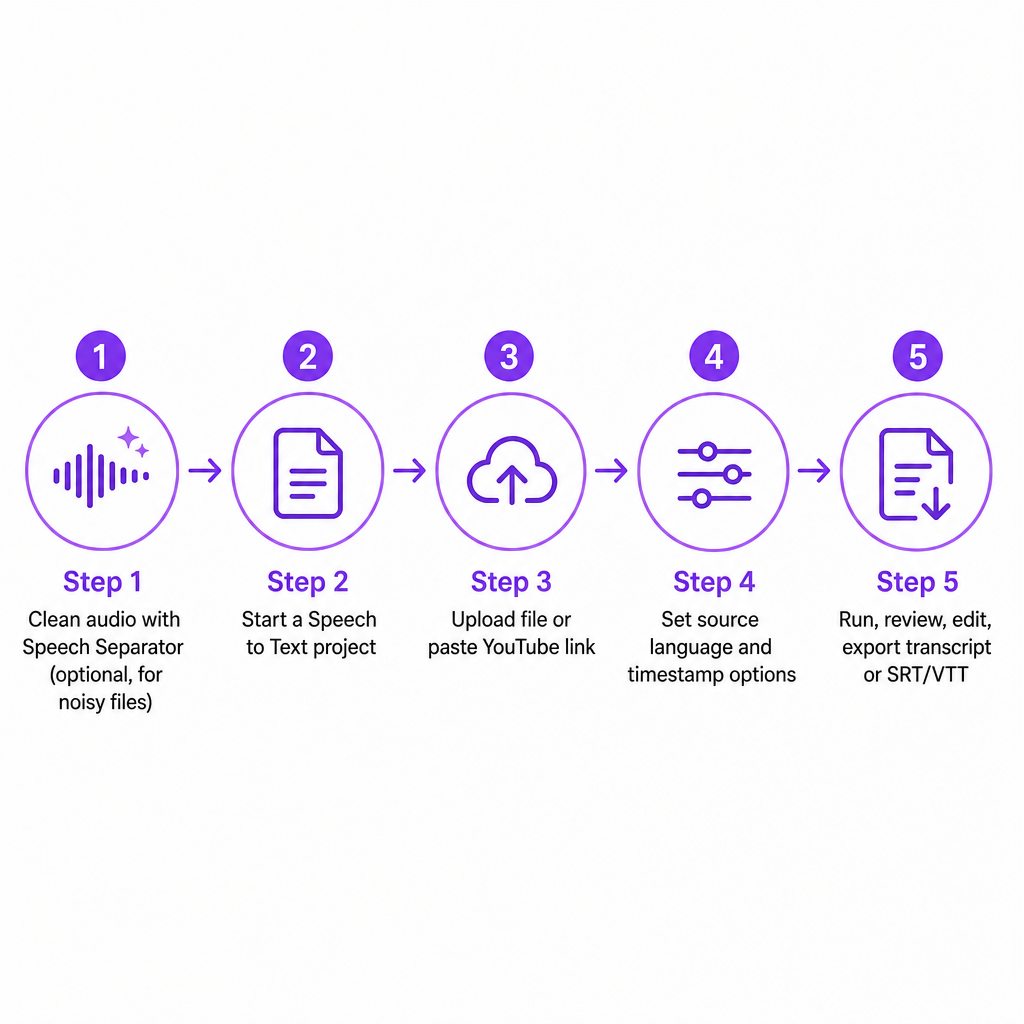
1. Choisissez les bons outils pour l'enregistrement
Reconnaissance vocale convertit l'audio parlé en texte écrit, et elle fonctionne de pair avec Speech Separator pour les enregistrements bruyants. Les crédits sont partagés entre Doublage IA, Synthèse vocale, Clonage de voix, Reconnaissance vocale et Speech Separator, donc chaque minute que vous traitez puise dans le même pool.
La décision est simple. Si l'enregistrement contient de la musique, du bruit de foule ou de l'écho de pièce, commencez par Speech Separator pour isoler les voix. Si l'audio est déjà propre, passez directement à la transcription.
2. Nettoyez l'audio avec Speech Separator (recommandé)
Une entrée de haute qualité est le facteur le plus déterminant pour une transcription automatisée précise, en particulier pour les podcasts, interviews et tables rondes à plusieurs locuteurs. Speech Separator isole la parole de la musique et du bruit de fond dans des formats courants comme MP3, WAV et AAC, laissant une piste vocale plus propre.
- Ouvrez l'outil Speech Separator dans votre compte.
- Téléversez votre audio ou vidéo depuis votre appareil, ou sélectionnez-le parmi vos projets.
- Laissez l'IA séparer la voix du fond sonore ; cela se termine généralement en quelques secondes à quelques minutes selon la durée.
- Enregistrez le fichier vocal propre dans votre bibliothèque de projet.
Avec cette piste nettoyée en main, l'étape de transcription produit moins d'erreurs et nécessite moins de correction manuelle.
3. Démarrez un nouveau projet de reconnaissance vocale
Le flux est volontairement court : sélectionnez la fonctionnalité, téléversez le média, modifiez, exportez.
- Connectez-vous et ouvrez le tableau de bord de l'espace de travail.
- Choisissez Reconnaissance vocale dans la liste des outils.
- Créez un nouveau projet et donnez-lui un nom descriptif, comme « Webinaire produit – Octobre ».
Nommer les projets permet de garder les transcriptions organisées et de les réutiliser facilement pour le sous-titrage, le doublage ou la synthèse vocale plus tard.
4. Téléversez votre audio ou votre vidéo
Vous pouvez téléverser des fichiers directement ou récupérer une URL YouTube, ce qui est pratique pour les créateurs et les agences qui gèrent les chaînes de clients.
- Téléversez de l'audio ou de la vidéo depuis votre appareil dans des formats standard comme MP3, WAV et MP4.
- Collez une URL YouTube pour importer la vidéo directement dans le projet, y compris les téléversements en 1080p lorsqu'ils sont pris en charge.
DubSmart analyse ensuite le fichier, extrait l'audio et le prépare pour la reconnaissance.
5. Définissez la langue et les options de reconnaissance
Reconnaissance vocale prend en charge plus de 60 langues, dont l'anglais, l'espagnol, l'allemand, l'hindi, le turc, le portugais, le japonais, le russe, le chinois et l'arabe. Définir la bonne langue source n'est pas un détail facultatif ; le moteur s'appuie sur des modèles spécifiques à chaque langue pour décoder la parole en texte.
- Choisissez la langue source correspondant à l'enregistrement. Pour un contenu multilingue, commencez par la langue dominante.
- S'il y a plusieurs locuteurs, prévoyez d'ajouter des étiquettes de locuteurs lors de l'édition.
- Confirmez les options d'horodatage et de segmentation si vous comptez exporter des sous-titres SRT ou VTT plutôt qu'une simple transcription.
Pour la plupart des fichiers à locuteur unique, la reconnaissance s'exécute à la vitesse réelle ou plus rapidement, donc le traitement se termine souvent dans la durée de l'enregistrement.
6. Lancez la transcription
Démarrez le processus et laissez le moteur travailler. Il segmente l'audio, identifie les phonèmes et les mots, puis applique des modèles linguistiques pour produire du texte. Sur un audio clair, la précision dépasse 95 %, ce qui réduit fortement votre charge de correction. Pendant qu'il s'exécute, préparez un court glossaire des noms, marques ou termes techniques que vous savez déjà devoir standardiser.
7. Relisez et modifiez la transcription
Le résultat automatisé est rapide, mais un texte de qualité professionnelle nécessite tout de même une relecture humaine, en particulier pour les noms, acronymes et jargons. Modifiez directement dans l'éditeur de projet :
- Relisez en écoutant les sections clés pour repérer les mots mal entendus.
- Ajoutez des étiquettes de locuteurs telles que Animateur, Invité ou Formateur afin que le dialogue soit facile à suivre.
- Corrigez la ponctuation et les majuscules, qui affectent à la fois la lisibilité et le calage des sous-titres.
- Standardisez la terminologie, comme les noms de produits, les termes médicaux ou les expressions juridiques, en vous appuyant sur votre glossaire de marque ou de conformité.
Comme la même transcription peut ensuite alimenter Doublage IA dans plus de 33 langues et Synthèse vocale avec plus de 300 voix, une édition soignée maintenant est rentabilisée à chaque réutilisation du contenu.
8. Exportez le texte ou les sous-titres
Lorsque les modifications sont correctes, exportez dans le format dont votre cas d'usage a besoin :
- Sous-titres (SRT ou VTT) pour YouTube, les plateformes LMS et les portails vidéo d'entreprise.
- Texte brut (TXT) ou formats de document pour les blogs, les notes d'épisode, les manuels de formation et les comptes rendus de réunion.
Choisissez le format, puis téléchargez ou enregistrez le projet terminé. Cela complète le flux de travail principal pour transcrire de l'audio en texte dans DubSmart.
Temps et coût : à quoi s'attendre
DubSmart fonctionne sur un système basé sur les crédits qui s'applique à Doublage IA, Synthèse vocale, Clonage de voix, Reconnaissance vocale et Speech Separator. Les crédits sont interchangeables, donc un seul pool couvre les minutes de transcription, le nettoyage audio et le doublage. D'après nos tarifs publiés :
| Forfait | Prix mensuel | Crédits mensuels | Notes |
|---|---|---|---|
| Free | 0 $ | 2 000 | Environ 2 minutes de Doublage IA/TTS pour tester le flux de travail |
| Starter | ~20 $ | 50 000 | Environ 50 minutes de Doublage IA/TTS ; les crédits inutilisés sont reportés |
| Standard | ~50 $ | 150 000 | Volume plus élevé avec un coût par 1 000 crédits inférieur |
Comme les crédits couvrent la transcription, le nettoyage vocal et le doublage, vous pouvez traiter l'ensemble du pipeline comme un seul budget au lieu d'outils séparés. Pour la plupart des créateurs, cela signifie transcrire des dizaines de courtes vidéos par mois avec la tarification de niveau Starter tout en conservant une capacité de crédit libre pour le doublage et les voix off.
Erreurs courantes et comment les corriger
Utiliser un audio bruyant sans le nettoyer. La musique de fond, le bruit de foule ou l'écho provoquent des erreurs de reconnaissance et un travail d'édition supplémentaire. Passez d'abord le fichier par Speech Separator, puis transcrivez la piste vocale isolée pour une meilleure précision et un calage de sous-titres plus propre.
Sélectionner la mauvaise langue source. Si vous la laissez sur l'anglais alors que l'audio est en espagnol, le moteur interprète mal les phonèmes et produit un texte inutilisable. Vérifiez bien la langue avant de commencer, et pour les vidéos multilingues, segmentez par langue ou donnez la priorité à la langue principale pour la première passe.
Ignorer les étiquettes de locuteurs. Les podcasts et tables rondes à plusieurs locuteurs sont difficiles à lire sans attribution. Ajoutez des étiquettes comme Animateur, Invité 1 ou des balises basées sur les noms lors de l'édition, et gardez-les cohérentes d'un épisode à l'autre.
Sauter la relecture humaine pour un contenu à fort enjeu. Pour du matériel juridique, médical ou sensible à la conformité, une petite erreur peut changer le sens. Traitez la transcription automatisée comme un premier brouillon et effectuez une validation humaine complète, en l'associant à des relecteurs internes ou à des contrôles de conformité externes si nécessaire.
Mal estimer les crédits. Traiter un vaste catalogue existant sans comprendre l'usage peut épuiser votre quota. Vérifiez d'abord les crédits mensuels de votre forfait et la politique de report, puis lancez un petit lot pilote pour mesurer les minutes par crédit sur Speech Separator et Reconnaissance vocale avant de vous engager dans un travail de masse.
DIY vs aide professionnelle : où tracer la ligne
DubSmart est conçu pour une utilisation en libre-service par les créateurs, les petites entreprises, les équipes d'e-learning et les agences qui souhaitent un contenu multilingue évolutif sans jongler avec des prestataires. Des outils basés sur navigateur, un niveau gratuit et un modèle de crédit partagé permettent à la plupart des utilisateurs de gérer eux-mêmes la transcription, le nettoyage et le doublage.
Le libre-service suffit généralement lorsque :
- Vous transcrivez du contenu épisodique comme des podcasts, des vidéos YouTube, des démonstrations de produits ou des formations internes.
- L'audio est raisonnablement propre ou peut être amélioré avec Speech Separator.
- La précision doit être élevée mais n'a pas de valeur juridique contraignante, comme les sous-titres d'accessibilité, le matériel de cours ou les supports marketing.
- Votre volume mensuel tient dans vos crédits disponibles avec une marge pour le doublage ou les voix off.
Penchez vers un support professionnel ou de niveau entreprise lorsque :
- Vous gérez de vastes catalogues, des centaines d'heures, qui nécessitent une AQ, un style et une terminologie cohérents entre les régions.
- Votre contenu relève de normes juridiques ou réglementaires strictes, comme les procédures judiciaires, la documentation médicale ou les divulgations financières.
- Vous devez intégrer notre API de Doublage IA ou notre API de Synthèse vocale dans des flux de travail complexes avec des exigences de disponibilité et de débit pour les clients.
Dans ces cas, associer notre automatisation à une relecture linguistique ou de conformité professionnelle vous offre le meilleur équilibre entre vitesse, coût et risque. Pour la plupart des transcriptions quotidiennes, le parcours en libre-service est plus rapide et moins cher, et il maintient votre transcription prête à devenir des sous-titres, des doublages ou des voix off dès que vous en avez besoin.
Foire aux questions
Quels types de contenu DubSmart peut-il transcrire ?
Reconnaissance vocale gère les podcasts, les vidéos YouTube, les webinaires, les interviews, les films et les formations d'entreprise, du moment que l'audio est disponible par téléversement ou via un lien.
Quelles langues sont prises en charge pour la transcription ?
Reconnaissance vocale prend en charge plus de 60 langues, dont l'anglais, l'espagnol, l'allemand, l'hindi, le turc, le portugais, le japonais, le russe, le chinois et l'arabe, et la même plateforme double dans 33 langues cibles.
Quelle est la précision de la reconnaissance vocale de DubSmart ?
Sur un audio clair avec la bonne langue sélectionnée, la précision dépasse 95 %, conformément à la reconnaissance vocale automatique moderne.
Combien coûte une transcription avec DubSmart ?
Les tarifs commencent à 0 $/mois avec un niveau gratuit de 2 000 crédits. Les forfaits payants comme Starter (environ 20 $/mois) et Standard (environ 50 $/mois) ajoutent des crédits et réduisent le coût par crédit, et les crédits sont partagés entre la transcription, le doublage et les outils associés.
Puis-je utiliser la transcription pour le doublage et les voix off ?
Oui. Le résultat de la reconnaissance vocale peut alimenter directement le Doublage IA et la Synthèse vocale pour produire des versions doublées multilingues et des voix off par IA utilisant plus de 300 voix au son naturel.