Ein Skript in eine YouTube-Erzählung zu verwandeln, bedeutete früher ein Mikrofon, einen ruhigen Raum und eine Menge Wiederholungen. Heute können Sie mit youtube text to speech ein Skript einfügen, eine Stimme auswählen und eine Erzählung exportieren, die Sie in ein Video, einen Short, ein Tutorial oder eine übersetzte Version eines bereits veröffentlichten Uploads einfügen können. Die eigentliche Entscheidung ist nicht, ob Sie überhaupt eine synthetische Stimme verwenden sollten. Es geht darum, welche Produktionsmethode zu dem konkreten Video vor Ihnen passt: eine vorgefertigte KI-Stimme, ein individueller Klon, eine menschliche Aufnahme oder eine Mischung aus allen dreien.
Dieser Leitfaden erklärt, wie die Technologie tatsächlich funktioniert, welcher Workflow zu welchen Kanalzielen passt und was Sie bei Rechten und Offenlegung prüfen sollten, bevor Sie auf Veröffentlichen klicken. Er ist der zentrale Anlaufpunkt für unsere umfassendere Reihe von Erklärungen zu Sprache und Transkription, sodass Sie Verlinkungen zu tiefergehenden Beiträgen finden, wo ein einzelnes Thema seine eigene Seite verdient.
Inhaltsverzeichnis
Was YouTube Text-to-Speech wirklich bedeutet
YouTube Text-to-Speech bedeutet einfach, Text-to-Speech-Technologie zu nutzen, um eine Erzählung für YouTube-Inhalte zu erzeugen. Sie liefern ein Skript, wählen eine Stimme und Sprache, passen an, wie es vorgetragen werden soll, und exportieren eine Audiodatei zum Bearbeiten oder Hochladen. Im Hintergrund wandelt ein TTS-System Text oder Speech Synthesis Markup Language (SSML) in Audiodaten um, etwa MP3- oder WAV-kompatibles Audio, das Sie zu Video und anderen Medien hinzufügen können.
Zwei Unterscheidungen beseitigen die meisten Missverständnisse. Untertitel erfüllen die umgekehrte Aufgabe von TTS: Untertitel verwandeln gesprochenes Audio in Text, während Text-to-Speech geschriebenen Text in gesprochenes Audio verwandelt. Synchronisation ist noch umfassender. TTS beginnt in der Regel mit einem geschriebenen Skript und erzeugt eine neue Sprachspur, während Synchronisation im Allgemeinen ein bestehendes Video übersetzt und die ersetzte Sprache an das ursprüngliche Timing und die Bedeutung anpasst. Wenn diese Abgrenzungen für Ihren Workflow wichtig sind, behandelt unser Erklärbeitrag zu welche Sprachen KI synchronisieren kann die Lokalisierungsseite im Detail.
Wie die Synthese-Pipeline ein Skript in eine Stimme verwandelt
Ein TTS-System kombiniert vier Zutaten: Ihr Skript, ein ausgewähltes Stimmmodell, Sprachinformationen und Steuerungen für den Vortrag. Daraus arbeitet es sich durch eine kurze Abfolge, die erklärt, warum derselbe Satz großartig oder holprig klingen kann, je nachdem, wie Sie ihn geschrieben haben.
Zuerst kommt die Texteingabe, bei der es sich um ein vollständiges YouTube-Skript, eine zu einer Erzählung ausgebaute Gliederung, eine übersetzte Version eines bestehenden Skripts oder in Voiceover umgewandelte Untertitel handeln kann. Die Qualität der Eingabe bestimmt die Qualität der Ausgabe. Lange Sätze, unerklärte Abkürzungen, ungewöhnliche Namen und chaotische Zeichensetzung können eine leistungsfähige Stimme schlecht klingen lassen. Die Lösung besteht darin, fürs Hören statt fürs stille Lesen zu schreiben: kürzere Sätze, klare Übergänge, bewusste Pausen.
Als Nächstes analysiert die Engine den Text, um zu entscheiden, wie Wörter ausgesprochen und gruppiert werden sollen. Sie liest Satzgrenzen, Zeichensetzung und Pausen, Zahlen und Daten, Abkürzungen, Namen und regionale Aussprachehinweise. Deshalb verändert Zeichensetzung den Vortrag. Fügen Sie ein Komma hinzu, schreiben Sie eine Zahl in Worten oder buchstabieren Sie ein Akronym aus, und die Stimme reagiert darauf.
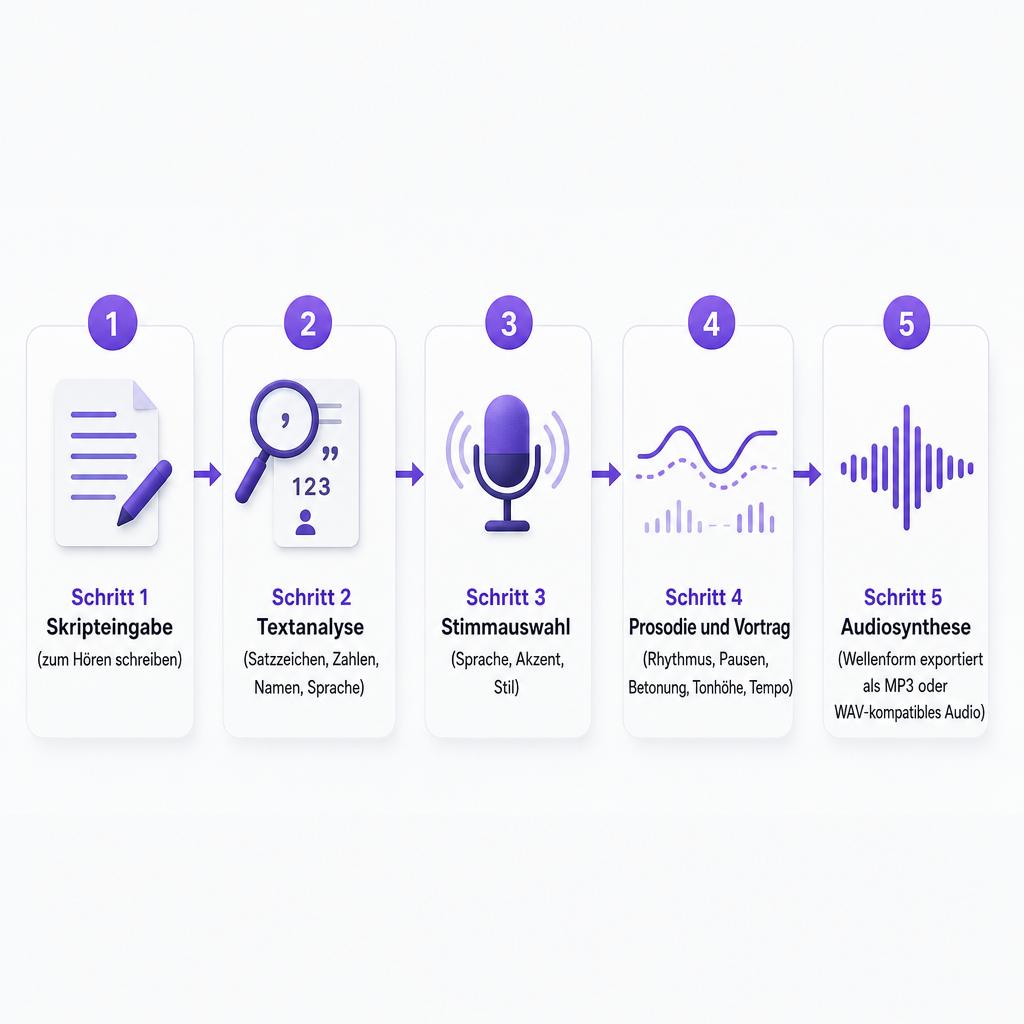
Dann wählen Sie eine Stimme. Stimmen unterscheiden sich nach Sprache, Akzent, Alter oder stimmlichem Charakter, Geschlechterdarstellung, Sprechstil, Energie und Formalität. Die Ausgabeeinstellungen umfassen oft Sprechgeschwindigkeit, Tonhöhe, Lautstärke und Abtastrate. Für einen Kanal schlägt Konsistenz meist Dramatik. Eine wiedererkennbare Stimme, die über alle Videos hinweg beibehalten wird, lässt den Kanal stimmig wirken, was wichtiger ist, als für einen einzelnen Upload die theatralischste Option auszuwählen.
Die Engine erzeugt dann die Prosodie – den Rhythmus, die Pausen, die Betonung, die Tonhöhenbewegung und die Intonation, die ausdrucksstarke Sprache von gleichmäßig aneinandergereihten Wörtern unterscheiden. Einige Tools legen diese Steuerungen direkt offen; andere leiten sie aus Zeichensetzung, Satzstruktur oder Stilanweisungen ab. Hier zeigen sich die meisten Qualitätslücken. Eine Stimme kann jedes Wort korrekt aussprechen und sich dennoch falsch anfühlen, wenn das Tempo oder der emotionale Ton mit dem Video kollidiert.
Schließlich synthetisiert das Modell Audio und wandelt den analysierten Text in eine Wellenform um, die der Dienst als herunterladbare Datei zurückgibt. Ein API-Workflow kann codierte Audiodaten zurückliefern, die Sie in eine abspielbare Datei dekodieren, während gehostete Creator-Tools diesen Schritt für Sie übernehmen. Selbst dann ist die Erzählung noch kein fertiges Video. Sie müssen sie immer noch auf der Timeline platzieren, tote Luft herausschneiden, Musik und Effekte hinzufügen, sie an die Bilder anpassen, Pegel ausbalancieren, Untertitel hinzufügen und Aussprache und Timing überprüfen. Bei einem Erklärvideo sollte die Stimme der visuellen Abfolge folgen; eine technisch saubere Spur wirkt dennoch schlampig, wenn sich die Bilder ändern, bevor der dazugehörige Satz beginnt. Wenn Sie das vollständige neuronale Bild möchten, geht unsere Aufschlüsselung dazu, wie neuronales Text-to-Speech funktioniert, tiefer auf die internen Modellabläufe ein.
Vier Produktionswege und wann sich welcher lohnt
Die meiste YouTube-Erzählung läuft auf vier Optionen hinaus, und die richtige hängt davon ab, was das Video braucht, und nicht davon, welche in einer Vorschau am fortschrittlichsten klingt.
| Weg | Am besten für | Wichtigster Kompromiss |
|---|---|---|
| Standard-KI-Stimme | Gesichtslose Kanäle, Erklärvideos, Tutorials, Nachrichten-Zusammenfassungen, Shorts | Schnell und zuverlässig, aber nicht an eine bestimmte Person gebunden |
| Individueller Stimmklon | Eine wiedererkennbare Identität über viele Videos hinweg beibehalten | Erfordert eine Stimme, die Sie reproduzieren dürfen |
| Mehrsprachiges TTS oder Synchronisation | Übersetzte Erklärvideos, lokalisierte Produktvideos, Tests für neue Märkte | Erfordert pro Sprache eine Aussprache- und Kulturprüfung |
| Menschliches Voiceover | Nuancierte Darbietung, Zeugenaussagen, sensible oder markenkritische Formulierungen | Langsamer und schwerer zu skalieren |
Eine Standardstimme aus der Bibliothek eines Anbieters ist der schnellste Weg für Inhalte mit hohem Volumen, bei denen die Erzählung nicht nach einer bestimmten Person klingen muss. Individuelles Stimmklonen erstellt eine synthetische Stimme aus einer Audioprobe, was einem Creator hilft, eine konsistente Identität beizubehalten, ohne jedes Skript von Hand aufzunehmen. Verwenden Sie Klonen nur mit Erlaubnis und mit einer Stimme, die Sie reproduzieren dürfen; ein Klon ist keine Abkürzung, um die Identität oder Darbietung einer anderen Person zu besitzen. Unser Text-to-Speech-Tool gibt Ihnen Zugang zu KI-Stimmen und Klon-Workflows, und unsere Voice-Cloning-Seite ist der Ausgangspunkt, wenn Sie einen wiederverwendbaren, individuellen Erzähler statt eines vorgefertigten wünschen.
Mehrsprachige Erzählung ermöglicht es Ihnen, ein Skript zu übersetzen und eine neue Sprachspur in einer anderen Sprache zu synthetisieren, was nützlich ist, um einen Bildungskanal im Ausland auszubauen, Produktvideos zu lokalisieren oder die Nachfrage in einem neuen Markt zu testen. TTS beginnt mit Text; unser AI-Dubbing-Workflow fügt die umfassendere Lokalisierungsebene hinzu, einschließlich Übersetzung und Ersatzaudio für ein bestehendes Video in 33 Sprachen. Ein menschlicher Erzähler gewinnt weiterhin, wenn das Video auf nuancierter Darbietung, persönlichem Zeugnis, sensiblen Themen, komplexem Humor, rechtlichen oder markenkritischen Formulierungen oder der Interpretation eines unverwechselbaren Darstellers beruht. Viele Kanäle setzen auf ein Hybridmodell: KI-Erzählung für Entwürfe, Versionen und Uploads mit hohem Volumen, menschliche Stimme für Flaggschiff-Videos.
Wann Text-to-Speech seinen Platz auf einem Kanal verdient
YouTube-TTS zahlt sich am meisten aus, wenn Ihr Engpass bei der Aufnahme liegt, nicht beim Schreiben. Wenn das Verfassen von Skripten einfach ist, aber das Buchen einer Aufnahmesitzung der langsame Teil ist, entfernt synthetische Erzählung den langsamsten Schritt.
Bildungs- und Lehrvideos profitieren direkt. Aktualisieren Sie ein Skript und erzeugen Sie nur den betroffenen Abschnitt neu, anstatt eine neue Aufnahme zu organisieren, was sich für Software-Tutorials, Onboarding und Kursinhalte eignet, die sich häufig ändern. Gesichtslose Kanäle können Videos erzählen, die aus Bildschirmaufnahmen, Stockmaterial, Animationen, Folien oder generierten Bildern bestehen, auch wenn die Stimme weiterhin redaktionelle Steuerung benötigt; über unzusammenhängendes Material gelegtes Audio untergräbt das Vertrauen der Zuschauer. Shorts gewinnen durch die schnelle Umsetzung von Skript zu Audio, was es Ihnen ermöglicht, mehrere Hooks oder Zielgruppenvarianten zu testen, solange die Stimme nicht gehetzt oder repetitiv klingt.
Barrierefreiheit ist eine weitere ehrliche Verwendung. Eine gesprochene Version schriftlicher Inhalte hilft Zuschauern, die Audio bevorzugen oder mit Bildschirmtext Schwierigkeiten haben, aber die Erzählung sollte präzise Untertitel und klares visuelles Design ergänzen, nicht ersetzen. Und für die mehrsprachige Expansion können Sie übersetzte Sprachspuren erzeugen, ohne pro Sprache einen separaten Produktionsprozess durchzuführen. Die Funktion für mehrsprachige Audiospuren von YouTube ermöglicht es berechtigten Creatorn, zusätzliche Audiospuren an ein einzelnes Video oder einen Short anzuhängen, anstatt für jeden Markt einen separaten Kanal zu verwalten.
Eine Stimme auswählen und testen, bevor Sie sich festlegen
Beurteilen Sie eine Stimme anhand der tatsächlichen Anforderungen des Videos, nicht anhand einer schmeichelhaften Zehn-Sekunden-Vorschau. Eine Stimme, die eine Zeile perfekt trifft, kann über ein vollständiges Skript hinweg auseinanderfallen, also testen Sie sie zuerst unter Druck.
- Passen Sie die Stimme an das Format an. Ein ruhiger Vortrag passt zu einer Dokumentation oder einem Tutorial; eine energiegeladenere Stimme passt zu einem Kurzformat-Hook oder einer Ankündigung. Lassen Sie Thema, Tempo und Zielgruppe entscheiden.
- Testen Sie schwierige Wörter. Bevor Sie ein vollständiges Video erzeugen, lassen Sie Ihre wiederkehrenden Markennamen, Ortsnamen, Akronyme, wissenschaftlichen Begriffe, Fremdwörter, Einheiten und Personennamen durchlaufen. Eine Stimme, die gewöhnliche Sätze bewältigt, kann über den Wortschatz Ihres Kanals stolpern.
- Prüfen Sie die Konsistenz bei Langform. Erzeugen Sie eine längere Probe und achten Sie auf repetitive Intonation, falsche Pausen, unnatürlichen Rhythmus, wechselnde Aussprache und abrupte Absatzübergänge.
- Berücksichtigen Sie die regionale Zielgruppe. Englische Erzählung benötigt möglicherweise eine US-, UK-, australische oder andere Aussprache. Bestätigen Sie bei anderen Sprachen, dass die Stimme für ein muttersprachliches Ohr natürlich klingt und nicht nur, dass das Tool die Sprache auflistet.
- Prüfen Sie die Nutzungsrechte. Bevor Sie monetarisieren oder werben, lesen Sie die Bedingungen des Anbieters und bestätigen Sie, dass die Stimme und die Ausgabe für kommerzielle YouTube-Inhalte, Kundenarbeit, bezahlte Anzeigen und abgeleitete Versionen freigegeben sind.
Ein paar Schreibgewohnheiten heben die Qualität ebenfalls schnell an. Schreiben Sie für Sprache, indem Sie dichte Prosa gegen gesprächige Sätze austauschen und Zeichensetzung nutzen, um Pausen zu lenken, ohne sich für Emotion darauf zu verlassen. Buchstabieren Sie mehrdeutige Begriffe aus, damit die Engine sie korrekt liest, und testen Sie Varianten wie „AI“ gegenüber „A.I.“ oder „2026“ gegenüber „zwanzig sechsundzwanzig“. Erzeugen Sie in Abschnitten statt in einer einzigen riesigen Datei, damit Sie einen einzelnen Fehler neu erzeugen, Szenen umsortieren und Audio an die Bilder anpassen können. Fügen Sie dann menschliche Bearbeitung hinzu: Sehen Sie sich das vollständige Video mit abgespielter Spur an, schneiden Sie holprige Pausen heraus, korrigieren Sie das Timing und senken Sie die Musik unter der Sprache ab. KI reduziert die Aufnahmezeit; sie ersetzt nicht die redaktionelle Prüfung.
Rechte, Offenlegung und das Hochladen einer zweiten Sprachspur
Der Teil, den Creator am häufigsten überspringen, ist auch der Teil, der dazu führt, dass Videos entfernt werden. Wenn Sie eine separate Sprachversion erstellen, können Sie sie als neues Video veröffentlichen oder, sofern verfügbar, die Funktion für mehrsprachige Audiospuren von YouTube nutzen, aber die Plattform erstellt diese synchronisierten Spuren nicht für Sie. Creator müssen ihre eigenen Audiodateien in einem unterstützten reinen Audioformat vorbereiten und hochladen, ungefähr in der gleichen Länge wie das Video. YouTube kann eine sekundäre Audiodatei auch entfernen, wenn ihr urheberrechtlich geschützter Inhalt vom Original abweicht, was eine Rechteprüfung unerlässlich macht, wenn Ihre synchronisierte Spur Musik, Clips oder anderes geschütztes Material enthält.
Offenlegung ist eine separate Verpflichtung. YouTube verlangt von Creatorn, KI-generierte oder veränderte Inhalte offenzulegen, die realistisch wirken, einschließlich Inhalten, die eine reale Person so erscheinen lassen, als würde sie etwas sagen oder tun, was sie nicht getan hat, Material eines realen Ereignisses oder Ortes verändern oder eine realistische Szene erfinden. Bemerkenswerterweise führt YouTube das Klonen der eigenen Stimme für Voiceover oder Synchronisationen als Beispiel auf, das im Rahmen dieser spezifischen Richtlinie keine Offenlegung erfordert. Das ist keine Lizenz, die Stimme einer anderen Person zu klonen, und das Kennzeichnen synthetischer Inhalte berechtigt nicht dazu, das Gesicht oder die Stimme einer anderen Person ohne Erlaubnis zu verwenden.
Eine sichere redaktionelle Richtlinie besteht darin, Ihre eigene oder eine lizenzierte Stimme zu verwenden, Erlaubnisnachweise für alle individuellen Stimmproben aufzubewahren, die Nachahmung einer realen Person ohne Autorisierung zu vermeiden, kommerzielle Nutzungsbedingungen zu prüfen, realistische synthetische oder veränderte Inhalte offenzulegen, wenn YouTube es verlangt, und Rechte an Musik, Material und übersetztem Audio separat zu prüfen. Für Teams, die wiederholt Erzählungen aus einem Content-System oder einer App erzeugen, ist unsere Text-to-Speech-API für programmatische Spracherzeugung gebaut, sodass Sie Spuren in großem Umfang produzieren können, ohne den Workflow jedes Mal neu aufzubauen.
Lohnt sich YouTube Text-to-Speech also? Es passt gut, wenn Sie wiederholbare Erzählung, schnelle Überarbeitungen, mehrsprachige Versionen oder ein Voiceover ohne Aufnahmeausrüstung benötigen. Es passt weniger gut, wenn der Erfolg des Videos von nuancierter Darbietung, persönlichem Zeugnis oder einer rechtlich sensiblen Darbietung abhängt. Der Maßstab, der zählt, ist nicht, ob Zuschauer erkennen können, dass eine Stimme synthetisch ist. Es geht darum, ob die Erzählung klar, angemessen, konsistent, rechtlich nutzbar und gut in das Video integriert ist.
Häufig gestellte Fragen
Kann ich Text-to-Speech-Audio auf YouTube verwenden?
Ja. Sie können erzeugte Erzählung in einem YouTube-Video verwenden, solange Sie die Lizenzbedingungen des TTS-Anbieters, die Richtlinien von YouTube und die Rechte an Ihrem Skript, Ihrer Musik, Ihrem Material und Ihrer Stimme respektieren.
Verwandelt YouTube automatisch ein Skript in eine Erzählung?
Nein. Die Funktion für mehrsprachige Audiospuren von YouTube erstellt Ihre synchronisierten Spuren nicht für Sie. Creator müssen ihre eigenen Audiodateien vorbereiten und hochladen.
Was ist der Unterschied zwischen YouTube Text-to-Speech und automatischer Synchronisation?
Text-to-Speech wandelt geschriebenen Text in gesprochenes Audio um. Automatische Synchronisation ist ein umfassenderer Lokalisierungsprozess, der bestehende Inhalte übersetzen und eine Ersatzsprachspur erzeugen kann. Die genauen Funktionen hängen von der Plattform und dem Workflow ab.
Kann ich meine Stimme für YouTube-Videos klonen?
Sie können einen Stimmklon verwenden, wenn Sie das Recht besitzen, ihn zu erstellen und zu nutzen. YouTube führt das Klonen der eigenen Stimme für Voiceover oder Synchronisationen als Beispiel auf, das im Rahmen seiner Richtlinie zu realistischen Inhalten keine Offenlegung erfordert, obwohl andere KI-generierte oder veränderte Inhalte dennoch eine Offenlegung erfordern können.
Welche Audiodatei sollte ich für eine zweite Sprache hochladen?
Für die Funktion für mehrsprachige Audiospuren von YouTube muss die Datei in einem unterstützten reinen Audioformat und ungefähr in der gleichen Länge wie das Video vorliegen. Prüfen Sie die aktuelle Upload-Oberfläche von YouTube Studio, bevor Sie exportieren.