Wenn Sie voiceforge text to speech für ein Projekt in Betracht ziehen, ist die eigentliche Frage selten, ob die Stimmen interessant klingen. Es geht vielmehr darum, ob das Tool zu Ihrer Skriptlänge, Ihren Veröffentlichungsrechten und der Art von Inhalten passt, die Sie tatsächlich erstellen. VoiceForge ist ein browserbasierter Text-to-Speech-Dienst, der sich auf unverwechselbare Charakterstimmen konzentriert. Er wandelt ein Skript in herunterladbares Audio um und nutzt dabei eine Unit-Selection-Synthese-Engine, die aufgenommene Sprachsegmente menschlicher Sprecher zusammenfügt, anstatt jeden Laut aus einer einzigen mathematischen Wellenform zu erzeugen. Die praktische Entscheidung läuft auf vier Bedürfnisse hinaus: eine unterhaltsame, wiedererkennbare Stimme für persönliche Projekte; lizenziertes Audio für monetarisierte Medien; präzise Kontrolle über Aussprache und Tempo; oder einen skalierbaren mehrsprachigen Workflow. Nur die ersten drei passen sauber zu einem Charakterstimmen-Generator, und genau an dieser Lücke stolpern die meisten Creator.
Wir veröffentlichen diesen Leitfaden, weil dieselbe Verwirrung immer wieder auftaucht: Menschen erzeugen Audio in einer kostenlosen Testversion, gehen davon aus, dass sie es monetarisieren können, und stellen dann fest, dass die Lizenz an einen bestimmten Tarif gebunden ist. Im Folgenden erläutern wir, wie die Engine funktioniert, was sie kann und was nicht, und wann ein Einzelstimmen-Spaßtool die richtige Wahl ist – im Gegensatz zu einem vollständigen Lokalisierungs-Workflow.
Inhaltsverzeichnis
Was VoiceForge text to speech wirklich ist
VoiceForge wandelt geschriebene Wörter in gesprochenes Audio um: Sie geben ein Skript ein, wählen eine Stimme, erzeugen den Clip, hören ihn an und laden das Ergebnis herunter, wenn Ihr Tarif es erlaubt. Was es von einer allgemeinen Sprecherbibliothek unterscheidet, ist seine Ausrichtung. VoiceForge setzt eher auf Stimmen mit Persönlichkeit als auf neutrale, unternehmerische Vorträge, was es zu einer natürlichen Wahl für YouTube-Sketche, Gaming-Clips, animierte Charaktere, Memes, originelle Ankündigungen und Musikprojekte macht.
Dieser Fokus auf Charaktere ist für manche Inhalte ein Vorteil und für andere ein Nachteil. Eine komische oder bewusst synthetische Stimme kann eine Parodie oder einen Spiel-NPC tragen, aber dieselbe Stimme wirkt in einem E-Learning-Kurs, einer Produktdemo oder einem hochwertigen Markenspot ablenkend. Der erste Filter lautet also nicht „Klingt das menschlich?" Er lautet: „Passt diese Stimme vor mein spezifisches Publikum?"
Wenn Sie noch unentschlossen sind, ob ein Stock-Stimmgenerator überhaupt für Ihre Zwecke geeignet ist, behandelt unser Erklärtext darüber, was ein KI-Stimmgenerator leistet, die breitere Kategorie und wie sich diese Tools von Cloning und Dubbing unterscheiden.
Wie die Unit-Selection-Engine eine Stimme aufbaut
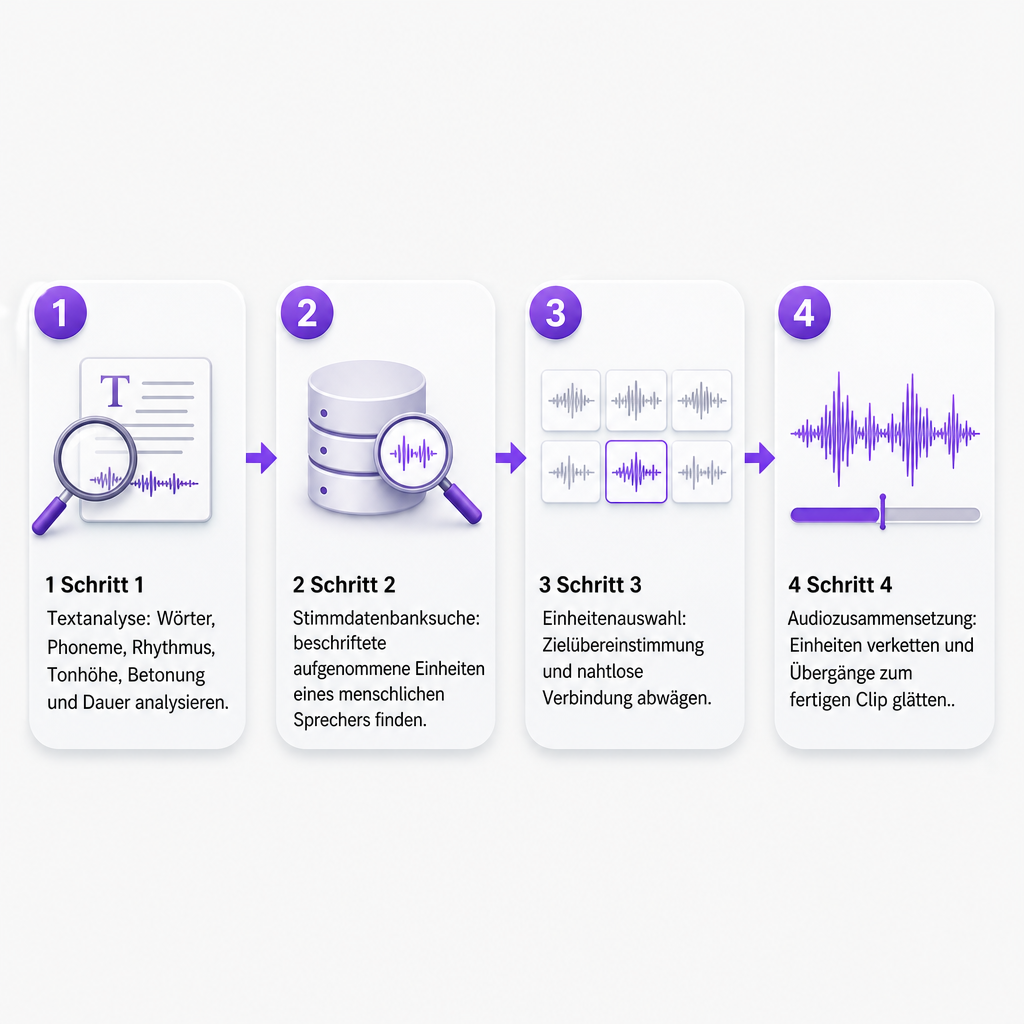
VoiceForge nutzt die Unit-Selection-Synthese, auch konkatenative Synthese genannt. Anstatt eine komplette Aufnahme aus einer einzigen modellerzeugten Wellenform zu generieren, durchsucht das System eine Datenbank aufgenommener Sprachsegmente und fügt die am besten passenden Teile zu Ihrem Satz zusammen. Das Verständnis dieser Pipeline erklärt sowohl, warum die Stimmen wiedererkennbar klingen, als auch, warum sie sich unter Belastung so verhalten, wie sie es tun.
Der Prozess läuft in mehreren Stufen ab. Zuerst die Textanalyse: Die Engine zerlegt Wörter, Satzstruktur, Phoneme, Rhythmus, Tonhöhe, Betonung und Dauer, um zu entscheiden, wie eine Zeile gesprochen werden soll. Danach eine Suche in der Stimmdatenbank: Jede Stimme ist aus den Aufnahmen eines menschlichen Sprechers aufgebaut, in kleinere Einheiten zerlegt und nach Laut und Kontext gekennzeichnet. Dann folgt die Unit-Selection, bei der die Engine zwei konkurrierende Ziele gleichzeitig ausbalanciert — Zielabgleich, der eine Einheit mit dem richtigen Laut, der richtigen Tonhöhe, Dauer und dem richtigen Kontext auswählt, und reibungsloses Verbinden, das benachbarte Einheiten bevorzugt, die ohne erkennbare Naht ineinandergreifen. Schließlich fügt die Audio-Zusammensetzung die gewählte Abfolge zusammen und wendet an den Übergängen eine leichte Glättung an.
Da die Ausgabe aus echten Aufnahmen zusammengesetzt wird, behält jede Stimme eine unverwechselbare Identität. Der Kompromiss ist, dass diese Methode nicht dafür entwickelt wurde, unbegrenzte emotionale Steuerung oder die vollständig anpassbare Darbietung zu bieten, die mit neueren generativen Systemen verbunden ist. Ungewöhnliche Formulierungen, schnelle Wechsel oder umständliche Aussprachekombinationen können die Übergänge zwischen den Einheiten sichtbar machen und Ergebnisse erzeugen, die weniger konsistent klingen als eine durchgehende menschliche Aufnahme. Wenn Sie sehen möchten, wie sich eine vollständig generative Pipeline unterscheidet, führt unsere Aufschlüsselung dazu, wie neuronale Text-to-Speech funktioniert, durch den Deep-Learning-Ansatz, der die Konkatenation ersetzt.
Stimmen, SSML und die 500-Zeichen-Obergrenze
VoiceForge listet 42 einzigartige Stimmen auf, jede aufgenommen von einem anderen Sprecher mit eigenem Klangcharakter und Sprechstil. Das ist reichlich, wenn die Stimme selbst Teil des kreativen Konzepts ist — ein komischer Erzähler für einen Kurzfilm, eine schräge Persönlichkeit für ein Gaming-Video, ein synthetischer Ton für ein Meme. Für Teams, die viele regionale Varianten oder einen sorgfältig abgestimmten Erzähler über mehrere Märkte hinweg benötigen, ist es jedoch ein kleinerer Katalog.
Zur Steuerung der Darbietung unterstützt VoiceForge eine Teilmenge der Speech Synthesis Markup Language (SSML). Anstatt sich allein auf Interpunktion zu verlassen, betten Sie Anweisungen direkt in das Skript ein.
| SSML-Steuerung | Was sie bewirkt |
|---|---|
<break> |
Fügt eine Pause ein |
<emphasis> |
Betont ein Wort oder eine Phrase |
<prosody> |
Passt Tonhöhe, Sprechtempo oder Lautstärke an |
<phoneme> |
Erzwingt eine exakte Aussprache |
<sub> |
Spricht einen Ersatz für den sichtbaren Text |
<p> / <s> |
Markiert einen Absatz oder Satz |
Diese Tags zahlen sich aus, wenn die Engine einen Produktnamen, ein Akronym oder einen Fachbegriff falsch liest. Das Einschließen einer Abkürzung in <sub alias="application programming interface">API</sub> lässt sie die vollständige Phrase aussprechen, und <phoneme> legt einen kniffligen Namen fest. Ein <break time="500ms"/> zwischen den Zeilen fügt einen bewussten Taktschlag ein, wo Interpunktion dies nicht täte.
Hier ist der Haken, der die Art, wie Sie dafür schreiben, verändert: Die Texteingabe ist auf 500 Zeichen begrenzt, und SSML-Markup zählt zu diesem Limit. Jedes Tag, das Sie hinzufügen, verbraucht Platz, der für die eigentlichen Wörter zur Verfügung steht. Lange Erzählungen müssen in mehrere Generierungen aufgeteilt werden, und umfangreiches Markup verkleinert jeden Abschnitt weiter. In der Praxis bedeutet das, dass Sie Ihr Skript in kurzen, in sich geschlossenen Passagen planen müssen, anstatt eine ganze Seite einzufügen.
Kostenlose Testversion vs. kommerzielle Lizenz: die entscheidende Frage
VoiceForge bietet eine begrenzte kostenlose Testversion, aber eine Testversion ist keine Veröffentlichungslizenz. Seine Tarife ziehen eine klare Linie zwischen persönlicher und kommerzieller Nutzung, und genau an dieser Linie passieren die meisten Fehler.
Die Stufe „Fan Voice" ist für Witze, Videos, Spiele, Animationen und Memes gedacht, die nicht monetarisiert werden. Der Publisher-Tarif ist das Abonnement, das eine kommerzielle Lizenz für TTS-Audio in monetarisierten oder kommerziellen Inhalten gewährt — monetarisierte Videos, Indie-Spiele und Musik — und wirbt mit unbegrenzten Downloads. Die kostenlose Testversion existiert, damit Sie den Dienst testen können, bevor Sie sich festlegen.
Die Betriebsregel ist einfach: Wenn ein Projekt Geld einbringt, ein Unternehmen bewirbt, in monetarisierten Medien erscheint oder kommerziell ausgeliefert wird, bestätigen Sie den anwendbaren Tarif, bevor Sie veröffentlichen. Audio, das Sie während einer kostenlosen Testversion erzeugen, trägt nicht automatisch kommerzielle Rechte, nur weil es heruntergeladen wurde. Lizenzbestimmungen können sich auch ändern, sodass die Tarifseite ein Ausgangspunkt ist, kein Ersatz für eine projektspezifische Prüfung, wenn viel auf dem Spiel steht — eine Kundenlieferung, eine bezahlte Anzeige, eine gebrandete Kampagne oder eine App-Veröffentlichung.
Stärken und Grenzen für echte Projekte
Die Stärken von VoiceForge gruppieren sich um Persönlichkeit und Einfachheit. Die Charakterstimmen stechen hervor, wenn der Klangcharakter Teil des Witzes oder der Marke eines Kanals ist. Da die Grundlage aufgenommene menschliche Sprache ist, behalten die Stimmen natürliche stimmliche Eigenschaften und eine wiedererkennbare Identität. Die SSML-Aussprachesteuerung gibt Ihnen echten Einfluss auf Akronyme, Namen und ungewöhnliche Begriffe. Und der Publisher-Tarif macht die Frage der kommerziellen Nutzung expliziter als Tools, die den Zugang zur Generierung von den Lizenzdetails trennen.
Die Einschränkungen sind ebenso konkret. Die 500-Zeichen-Obergrenze zwingt lange Skripte in viele kleine Generierungen, und Markup macht jede einzelne kürzer. Der Katalog mit 42 Stimmen ist bescheiden im Vergleich zu großen Bibliotheken, was wichtig ist, wenn Sie Hunderte von Optionen oder viele regionale Akzente benötigen. Der charakterorientierte Stil, der im Unterhaltungsbereich glänzt, kann juristische, medizinische, instruktive oder hochwertige Markeninhalte untergraben. Tarifbeschränkungen sind leicht zu übersehen, da die Fähigkeit, Audio zu erzeugen, nicht dasselbe ist wie das Recht, es zu monetarisieren. Und da die Engine aufgenommene Einheiten zusammenfügt, können bestimmte Formulierungen Nahtstellen-Artefakte zutage treten lassen, die bei einer durchgehenden Aufnahme nicht auftreten würden.
Keines davon ist für sich genommen ein Ausschlusskriterium. Sie definieren einfach den optimalen Einsatzbereich: kurze, persönlichkeitsgetriebene, einsprachige Clips, bei denen die Stimme im Mittelpunkt steht.
Wann eine Charakterstimme passt und wann ein Lokalisierungs-Workflow gewinnt
VoiceForge ist die richtige Wahl, wenn die Persönlichkeit der Stimme zentral ist, Ihre Skripte sich ordentlich in kurze Abschnitte aufteilen lassen, Sie grundlegende Aussprache- und Tempokontrolle benötigen und Sie Videos, Memes, Animationen, Musik oder Indie-Game-Inhalte produzieren — sei es persönlich (Fan Voice) oder monetarisiert mit dem passenden Abonnement.
Ein umfassenderer Workflow dient Ihnen besser, wenn Sie einen ausgefeilten neutralen Erzähler, viele Sprachen und Akzente, Ihre eigene geklonte Stimme, Langform-Narration, häufige kommerzielle Updates, API-Integration oder konsistente Stimmen über einen großen Katalog hinweg benötigen, bei dem Verlässlichkeit wichtiger ist als Originalität. Ein Kanal, der international expandiert, veranschaulicht diese Aufteilung gut: VoiceForge könnte die Charakterstimme für einen englischsprachigen Sketch liefern, während ein mehrsprachiges TTS- und Dubbing-Setup die lokalisierten Versionen für andere Zielgruppen produziert.
Auf dieses zweite Szenario konzentrieren wir uns. Unser Text-to-Speech-Tool bietet über 300 KI-Stimmen, mehrsprachige Voiceovers, Sprechtempo-Kontrollen und herunterladbare Projekte, die für die Produktion gebaut sind statt für einmalige Spielereien. Creator, die über jedes Video hinweg ihre eigene Identität bewahren möchten, können Voice Cloning nutzen, anstatt sich mit einem Stock-Charakter zu begnügen, und Entwickler, die Sprachgenerierung innerhalb einer App benötigen, können auf unserer Text-to-Speech-API aufbauen. Wenn das Ziel darin besteht, einen einzelnen Clip in eine vollständige lokalisierte Veröffentlichung zu verwandeln, überträgt AI Dubbing dasselbe Skript an einem Ort auf weitere Sprachen.
Eine Qualitäts-Checkliste vor der Veröffentlichung
Bevor Sie VoiceForge-Audio ausliefern, gehen Sie die Dinge durch, die am häufigsten schiefgehen. Zuerst kurze Testpassagen zu erzeugen ist die paar zusätzlichen Minuten wert, denn eine Stimme, die in einem Satz überzeugt, kann über ein ganzes Video hinweg ermüdend oder ablenkend werden.
- Aussprache: Werden Namen, Abkürzungen, Zahlen und Fachbegriffe korrekt gesprochen?
- Tempo: Fallen Pausen natürlich und nicht mitten in der Phrase?
- Charakterkonsistenz: Passt dieselbe Stimme zu jeder Szene, nicht nur zum Auftakt?
- Audio-Übergänge: Gibt es hörbare Sprünge zwischen separat erzeugten Clips?
- Lizenzierung: Deckt Ihr aktueller Tarif tatsächlich die monetarisierte oder kommerzielle Nutzung ab?
- Zielgruppeneignung: Ist der Charakterstil für die Plattform und das Thema angemessen?
- Abstimmung: Sitzt das Audio sauber zu Ihrem Video, Ihrer Musik oder Ihrem Spieldialog?
- Rechte: Haben Sie die Erlaubnis für ein bereitgestelltes Skript, einen Namen oder eine Drittanbieter-Referenz im Audio?
Häufig gestellte Fragen
Was ist VoiceForge text to speech?
Es handelt sich um einen browserbasierten Dienst, der geschriebenen Text mithilfe einer Bibliothek unverwechselbarer Charakterstimmen in gesprochenes Audio umwandelt. Er beruht auf der Unit-Selection-Synthese, die aufgenommene Sprachsegmente aus menschlichen Stimmdatenbanken zusammensetzt, anstatt Audio aus einer einzigen Modell-Wellenform zu erzeugen.
Ist VoiceForge KI-generiert?
Es ist ein Sprachsynthese-Dienst, aber seine dokumentierte Methode ist die Unit-Selection, nicht ein vollständig generatives neuronales Stimmsystem. Die Engine wählt aufgenommene menschliche Spracheinheiten aus und fügt sie zusammen, um jede Äußerung zu erzeugen.
Wie viele VoiceForge-Stimmen sind verfügbar?
VoiceForge listet 42 einzigartige Stimmen auf, jede verbunden mit einem anderen Sprecher und einer anderen stimmlichen Persönlichkeit.
Was ist das Zeichenlimit von VoiceForge?
Der Dienst dokumentiert ein Limit von 500 Zeichen pro Texteingabe, und jedes SSML-Markup, das Sie hinzufügen, zählt zu diesem Limit. Längere Skripte müssen in mehrere Generierungen aufgeteilt werden.
Kann ich VoiceForge-Audio auf YouTube verwenden?
Sie können, aber monetarisierte Inhalte erfordern das passende kommerzielle Abonnement. Der Publisher-Tarif wird als Lizenz für TTS-Audio beschrieben, das in monetarisierten oder kommerziellen Inhalten verwendet wird, also bestätigen Sie Ihren Tarif, bevor Sie ein monetarisiertes Video veröffentlichen.
Ist VoiceForge dasselbe wie Voice Cloning?
Nein. VoiceForge nutzt seine vorhandene Stimmbibliothek, während Voice Cloning aus autorisierten Aufnahmen eines bestimmten Sprechers eine individuelle synthetische Stimme erstellt. Wir erläutern diesen separaten Workflow auf unserer Voice-Cloning-Seite.