So transkribieren Sie Video in Text mit KI in Minuten
Sie haben ein 45-minütiges Interview, das bis morgen transkribiert sein muss. Der Freiberufler, den Sie im letzten Quartal engagiert haben, verlangte 90 Dollar und drei Tage Bearbeitungszeit. Ihre andere Option ist, es selbst zu machen – was bedeutet, einen ganzen Nachmittag vor einer Wellenform zu starren, alle fünf Sekunden zurückzuspulen und jede Minute zu hassen. Es gibt einen dritten Weg, den es vor drei Jahren für die meisten Creator noch nicht gab: Video-zu-Text-Transkriptions-KI, die Ihre komplette Datei in etwa der Zeit umwandelt, die es braucht, um einen Topf Kaffee zu kochen.
Dieser Leitfaden führt Sie durch das, was tatsächlich in diesen Engines passiert, wie Sie das richtige Ausgabeformat beim ersten Mal wählen, den Schritt-für-Schritt-Prozess von der Rohdatei zum polierten Transkript und die Workflows, die ein Transkript in fünf Verteilungskanäle umwandeln.
Inhaltsverzeichnis
- Die tatsächlichen Kosten der manuellen Videotranskription (und warum die meisten Creator es immer noch falsch machen)
- Wie KI-Video-zu-Text-Engines 2025 tatsächlich funktionieren
- Das richtige Ausgabeformat vor dem Klick auf „Transkribieren" wählen
- Die 6-Schritte-Anleitung – Von der Rohdatei zum polierten Transkript in unter 5 Minuten
- Genauigkeit hängt von der Audioqualität ab, nicht von der Toolwahl – So beweisen Sie es
- Was Sie mit Ihrem Transkript tun, sobald Sie es haben – Fünf wirksame Workflows
- Ihre erste Transkription – Die Checkliste für Vor-, Während- und Nach-dem-Flug
Die tatsächlichen Kosten der manuellen Videotranskription (und warum die meisten Creator es immer noch falsch machen)
Beginnen Sie mit der Zeitmessung. Ein ausgebildeter menschlicher Transkriptionist durchschnittlich 4–6 Stunden Arbeit pro Stunde fertig gestelltes Video, laut dem Transkriptionsanbieter SpeakWrite. Für einen untrainierten Creator, der sein eigenes Material transkribiert, liegt das realistische Tempo näher bei sechs Minuten Arbeit pro Videominute – was bedeutet, dass ein 45-minütiges Interview unter Berücksichtigung von Zurückspulen, Faktenprüfung und den unvermeidlichen „Moment, was hat er gerade gesagt?"-Momenten einen ganzen Arbeitstag verschlingt.
KI komprimiert dasselbe 45-minütige Interview in etwa 5 Minuten Verarbeitungszeit, laut Benchmarks, die von TrulyScribe veröffentlicht wurden. Das ist keine 10%-ige Verbesserung. Das ist nicht einmal eine 10-fache Verbesserung. Das ist ein Kategoriewechsel in der Art, wie Transkription in Ihren Workflow passt.
Jetzt führen Sie die Dollarmathematik durch. Freiberufliche Transkription auf dem US-Markt kostet 1,50–3,00 USD pro Audio-Minute, plus 24–72 Stunden Bearbeitungszeit. Ein monatlicher Podcast mit vier 60-Minuten-Episoden in der Mitte dieses Bereichs kostet ungefähr 480 USD pro Monat, bevor Bearbeitungszuschläge hinzukommen. Ein wöchentliches YouTube-Channel mit einer 30-Minuten-Show kostet etwa 180–360 USD pro Monat. Übers Jahr gerechnet sind das 2.000–5.800 USD, die für Text ausgegeben werden, den KI jetzt für Bruchteile eines Dollar pro Stunde produzieren kann.
Die Dollarkosten sind das offensichtliche Problem. Die versteckten Kosten sind schlimmer.
Wenn ein Freiberufler Ihren Inhalt transkribiert, weiß er nicht, dass „Cura Nettis" „Kubernetes" sein sollte. Er weiß nicht, dass Ihr CFO Aoife heißt und nicht Eva. Er weiß nicht, dass Ihr Produkt als „DubKit" gestartet wurde und sich acht Monate später zu „DubFlow" umbenannt hat. Jeder fachspezifische Begriff – jeder Name, jedes Akronym, jeder interne Codename – braucht ohnehin eine Korrekturüberprüfung von Ihrer Seite. Sie zahlen 90 Dollar für einen Entwurf, der immer noch Ihre Augen auf jeder Zeile braucht.
Die Frage ist nicht, ob Sie Ihr Video transkribieren sollen – es ist, ob Sie die sechsstündige Zeitsteuer leisten können, wenn ein fünfminütiger KI-Durchgang Sie 95 Prozent des Weges bringt.
Die tiefere Falle ist der Workflow selbst. Die meisten Creator verzögern die manuelle Transkription, weil sie sich optional anfühlt. Untertitel können warten. Show Notes können warten. Blog-Umgestaltung kann warten. Das Ergebnis: Videoarchive werden nicht durchsuchbar. Ein Team mit 200 Stunden Zoom-Aufnahmen kann nicht antworten auf „wann haben wir über die Q3-Preisänderung gesprochen?" Dieses Archiv ist kein Asset – es ist ein Heuhaufen, in dem Sie nie suchen werden.
Die manuelle Transkription bricht auch strukturell zusammen, wenn Ihre Ausgabe skaliert. Ein Creator, der zwei Videos pro Woche veröffentlicht, kann vielleicht eines davon, schlecht, am Sonntagabend transkribieren. Ein Team, das zwanzig Videos pro Monat veröffentlicht, kann nicht. Sie geben ganz auf und versenden Videos mit automatischen Untertiteln, die niemand überprüft hat. Suche verliert. Barrierefreiheit verliert. Lokalisierung ist vom Tisch.
KI-Transkription kollapst nicht nur die Zeit- und Dollarkosten. Es ändert, welche Workflows überhaupt möglich sind. Wenn ein 30-minütiges Video in fünf Minuten für unter einen Dollar zu einem vollständig mit Zeitstempel versehenen Transkript wird, hören Sie auf, Transkription als Kosten pro Video zu betrachten, und beginnen, es als Standard-Erster-Schritt nach dem Export zu behandeln. Untertitel folgen. Blog-Entwürfe folgen. Übersetzung folgt. Das Archiv wird durchsuchbar. Die Mathematik ist nicht mehr knapp.
Der Wendepunkt ist einfach: Die KI-Transkription hat sich so weit entwickelt, dass der einzige Grund, die Zeitsteuer weiterhin zu zahlen, Trägheit ist. Ein Video-zu-Text-Transkriptions-KI-Workflow, der 95%+ genaue Ausgabe bei sauberen Audios in fünf Minuten für Cent pro Stunde Video liefert – und Ihnen ermöglicht, das Ergebnis in weiteren zehn Minuten zu polieren – hat die Grenze von „interessantes Tool" zu „Standard-Infrastruktur" für jeden überschritten, der mehr als zwei Videos pro Monat veröffentlicht.
Der Rest dieses Leitfadens setzt voraus, dass Sie diese Entscheidung getroffen haben und jetzt Sprache-zu-Text gut nutzen möchten, nicht nur darauf zeigen und hoffen.
Wie KI-Video-zu-Text-Engines 2025 tatsächlich funktionieren
Sie müssen kein Forschungspapier lesen, um KI-Transkription gut zu nutzen, aber das Verständnis der Pipeline zeigt Ihnen, welche Knöpfe wichtig sind und welche Beschwerden tatsächlich über Audio, nicht Algorithmen, gehen.
Eine moderne KI-Transkriptions-Engine bewegt Ihre Datei durch fünf unterschiedliche Stufen:
- Audio-Extraktion und Normalisierung. Zunächst extrahiert das System die Audiospur aus Ihrem Container (MP4, MOV, WebM) und normalisiert die Lautstärke, sodass leise und laute Abschnitte auf vergleichbarem Niveau liegen. Je sauberer diese Eingabe, desto besser alles Nachgelagerte. Audio unter ~65 dB Signal-Rausch-Verhältnis braucht schwere Vorverarbeitung, während professionelle Rundfunkqualitäts-Transkription ≥85 dB SNR erwartet, laut dem National Association of Broadcasters Engineering Handbook.
- Spracherkennung (ASR) Inferenz. Ein neuronales akustisches Modell – typischerweise eine Transformer-basierte Variante von Whisper, NVIDIA Canary oder ein proprietäres Äquivalent – konvertiert Audio-Wellenformen in Phoneme, dann Phoneme in Wörter. Die Wortfehlerrate bei Studio-Audio liegt bei 3–5%, klettert aber auf 15–30% bei verrauschten Feldaufnahmen, laut Benchmarks aggregiert von WhisperBot. Das ist die Stufe, die für „schlechte KI-Transkription" verantwortlich gemacht wird, wenn das echte Problem fast immer stromaufwärts lag.
- Spracherkennung und Code-Switching. Moderne Engines erkennen automatisch die Sprache aus den ersten 5–15 Sekunden Audio und können Mid-Satz-Code-Switching über 60+ Ausgangssprachen bewältigen. Die Genauigkeit sinkt bei nicht-Muttersprachlern und technischer Terminologie um 15–30%, laut NIST-Spracherkennungsevaluationen – weshalb das manuelle Setzen der Sprache das automatische Erkennen schlägt, wenn Sie die Quelle kennen.
- Sprechererkennung (die „wer hat was gesagt"-Ebene). Ein separates Modell gruppiert Audio-Segmente nach Sprecheridentität. In kontrollierten zwei-Sprecher-Umgebungen liegt die Genauigkeit bei 78–85%. In natürlichen Gesprächen mit häufigem Sprecherwechsel und Überschneidungen fällt sie auf 45–60%, laut NVIDIA Canary-1B Benchmarks, auf die in Latenode's Forschungsvideo verwiesen wird. Die Sprechererkennung ist die Stufe, die die meisten Pipelines als Nebensache behandeln, und hier bricht Multi-Sprecher-Inhalt am häufigsten zusammen.
- Zeitstempel-Ausrichtung und Nachverarbeitung. Jedes Wort erhält einen Zeitstempel auf Millisekunden-Ebene, was klickbare Transkripte, framegenau genaue Untertitel und Wort-für-Wort-Suche ermöglicht. Professionelle Rundfunkstandards erfordern Zeitcode-Abweichung unter 150 ms pro Stunde, laut SMPTE, und Qualitäts-Engines bleiben gut innerhalb dieser Toleranz.

Hier ist, warum das jetzt ein fünf-minütiger Job statt ein fünf-Stunden-Job ist: Cloud-GPU-Inferenz auf A100s und H100s verarbeitet Audio mit 50–100x Echtzeit-Geschwindigkeit. Der Grund, warum Consumer-KI-Transkription 2018 nicht praktikabel war, war nicht schlechte Algorithmen – Forscher hatten anständige akustische Modelle vor einem Jahrzehnt. Der Engpass war, dass sich niemand die Compute-Zeit leisten konnte. Heute kostet die Pro-Minute-Verarbeitungszeit für ASR-Inferenz Bruchteile eines Cents, weshalb kreditbasierte Plattformen für einzelstellige Dollar pro Stunde Video-zu-Text-Konvertierung berechnen und immer noch nachhaltig arbeiten können. Die Engine-Pipeline hat sich nicht über Nacht geändert. Die Wirtschaft um sie herum hat sich geändert, und das ist, was KI-Transkription endlich in die Standard-Tool-Kategorie gedrückt hat.
Das richtige Ausgabeformat vor dem Klick auf „Transkribieren" wählen
Wählen Sie das Ausgabeformat vor dem Upload, nicht danach. Eine 90-Minuten-Datei erneut auszuführen, weil Sie TXT exportiert haben, als Sie SRT brauchten, ist ein 20-minütiger Fehler, der nicht passieren muss.
| Format | Best-Use-Fall | Zeitstempel-Detail | Zeilenlänge | Wo es sich einfügt |
|---|---|---|---|---|
| Reiner Text (TXT) | Blog-Beiträge, Wissensdatenbank, KI-Zusammenfassung-Input | Keine | Keine Begrenzung | Notion, Google Docs, CMS Paste |
| SRT (SubRip) | YouTube, Social-Video-Untertitel | Frame-genau, HH:MM:SS,ms | 42 Zeichen/Zeile, max 2 Zeilen | YouTube Studio, Premiere, DaVinci |
| WebVTT (.vtt) | HTML5 Web-Video, gestaltete Untertitel | Frame-genau + CSS-Gestaltung | 42 Zeichen/Zeile empfohlen | JW Player, Video.js, Web-Player |
| Zeitgestempelter TXT | Podcast-Show Notes, Navigationslinks | Pro-Absatz oder Pro-Sprecher | Keine Begrenzung | Podcast-Hosts, Blog-Einbettungen |
| JSON | API-Workflows, Suchindexierung, benutzerdefinierte Apps | Wort-Ebenen-Zeitstempel | N/A (strukturiert) | Developer-Pipelines, Datenbanken |
Die 42-Zeichen-pro-Zeile, zwei-Zeilen-pro-Frame-SRT-Beschränkung ist nicht willkürlich – sie ist die SubRip-Spezifikation und der Grund, warum Plattformen SRT-Dateien, die sie verletzen, ablehnen. Die CSS-Gestaltungsebene von WebVTT ist in der W3C WebVTT-Spezifikation definiert, und breitere Streaming-Timed-Text-Formatierung fällt unter ISO/IEC 23009-1.
Jetzt die Konsequenzen der falschen Wahl. Drei Workflows, drei Formate, drei verschiedene Entscheidungen:
Ein YouTube-Creator, der global lokalisiert, sollte zuerst SRT exportieren. YouTube Studio zieht SRT direkt für Untertitel ein, und dieselbe SRT-Datei wird zur Eingabe für generierte übersetzte Untertitel und die Quelle der Wahrheit für alle übersetzten Untertitel und synchronisierten Voiceovers, die Sie später produzieren. Wählen Sie TXT hier und Sie haben die Zeitstempel weggeworfen; Sie müssen entweder erneut transkribieren oder jede Zeile manuell erneut synchronisieren.
Ein B2B-Podcaster, der Show Notes erstellt, sollte zeitgestemplten TXT exportieren. Hörer klicken auf Zeitstempel, um zu Themen zu springen. Show-Note-Builder wie Descript, Castos und Podpage analysieren das Format nativ. SRT würde technisch funktionieren, aber seine Zeilenlängen-Beschränkungen kämpfen mit dem natürlichen Absatz-Rhythmus von Podcast-Notizen, und Sie würden Zeit damit verbringen, in Klammern gesetzte Zeitcodes aus dem Text zu entfernen.
Ein Entwickler, der ein Video-Suchtool baut, sollte JSON mit Wort-Ebenen-Zeitstempeln exportieren. Jetzt kann jedes Schlüsselwort im Transkript zu seiner exakten Millisekunde im Video verlinken. Ein Benutzer sucht „Pricing-Strategie" und das Ergebnis springt den Player zu Sekunde 1.847. Das ist mit SRT-Ebenen-Granularität unmöglich, wo Zeitstempel nur Untertitel-Blöcke markieren, nicht einzelne Wörter.
Eine letzte Überlegung, wenn Ihr Endziel mehrsprachige Reichweite ist: Die SRT-Datei, die Sie heute generieren, wird zum Dokument der Wahrheitsquelle für die zukünftigen übersetzten Untertitel und synchronisierten Voiceovers. SRT jetzt zu wählen bedeutet, dass die Lokalisierungs-Pipeline startet, wenn Sie bereit sind – nicht später, wenn Sie zurückgehen müssen, um die Zeitstempel zu generieren, die Sie übersprungen haben.
Die 6-Schritte-Anleitung – Von der Rohdatei zum polierten Transkript in unter 5 Minuten
Dies ist der Klick-Pfad, von Anfang bis Ende. Gesamtzeit für ein 30-minütiges Video: ungefähr 15 Minuten einschließlich des Bearbeitungsdurchgangs.
Schritt 1 – Datei vorbereiten (90 Sekunden)
Bestätigen Sie zuerst die Formatkompatibilität: MP4, MOV, WebM, M4A, WAV und MP3 werden über große Plattformen hinweg universell unterstützt. Die meisten Engines begrenzen einzelne Uploads auf 1–2 GB oder 4 Stunden Dauer; teilen Sie längere Videos vor dem Start auf. Wenn Ihr Audio verrauscht ist – per Telefon aufgezeichnete Interviews, Konferenzzimmer-Mikrofone, Außenaufnahmen mit Wind oder Verkehr – führen Sie es zuerst durch einen Sprach-Separator, um die Stimme vom Hintergrundgeräusch zu isolieren. Dieser einzelne Vorverarbeitungsschritt kann die Wortfehlerrate von 18% auf unter 5% senken, was der Unterschied zwischen einem Transkript ist, das Sie in zehn Minuten polieren, und einem, an dem Sie eine Stunde verbringen.
Schritt 2 – Hochladen und Sprache auswählen (30 Sekunden)
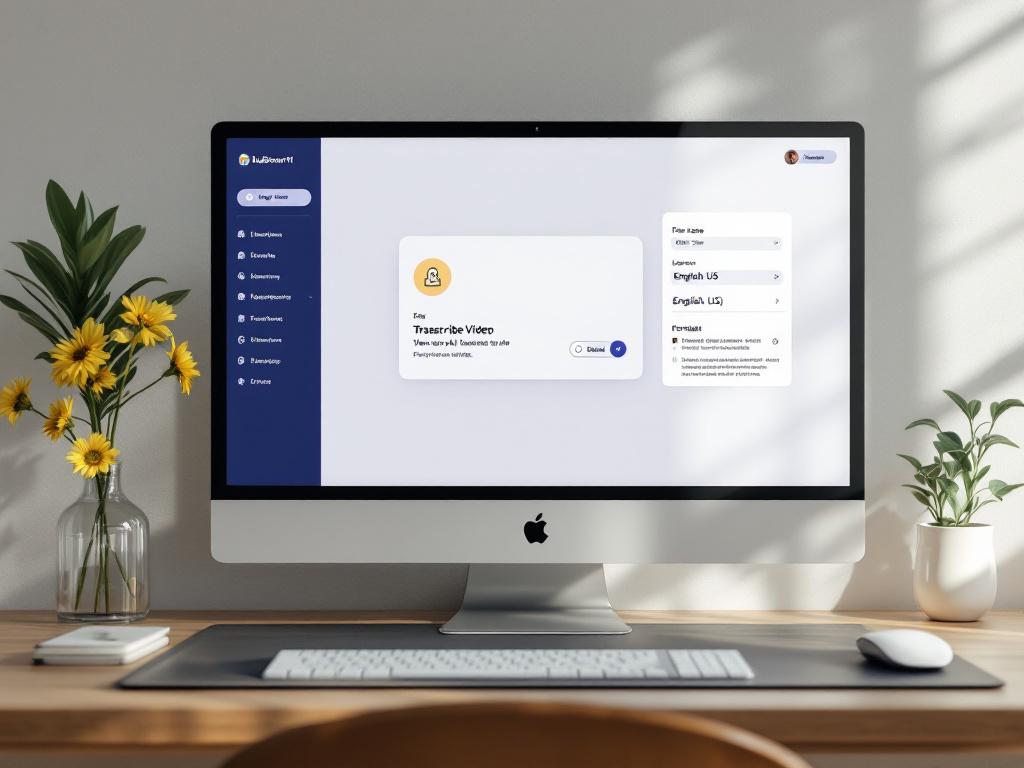
Ziehen Sie die Datei in die Upload-Zone der Plattform. Stellen Sie die Quellsprache explizit ein, wenn Sie sie kennen, anstatt sich auf automatische Erkennung zu verlassen. Die manuelle Auswahl vermeidet Spracherkennungsfehler in den ersten 10 Sekunden Audio – genau wo Automatische Erkennung ihre Entscheidung trifft, und genau wo Intros, Musikstiche und Stille leben.
Schritt 3 – Ausgabeformat auswählen und Verarbeitung starten (15 Sekunden)
Beziehen Sie sich auf die Formattabelle aus dem vorherigen Abschnitt: TXT für Blogs, SRT für Untertitel, zeitgestempelter TXT für Podcasts, JSON für Entwickler. Schalten Sie Sprechererkennung für Videos mit mehr als einer Stimme ein. Klicken Sie auf Transkribieren.
Schritt 4 – Das Verarbeitungsfenster produktiv nutzen (3–5 Minuten)
Ein 30-minütiges Video wird normalerweise in 3–5 Minuten auf moderner Cloud-Infrastruktur verarbeitet. Starren Sie nicht auf die Fortschrittsleiste. Entwerfen Sie Ihre YouTube-Beschreibung, schreiben Sie Ihre Blog-Überschrift, stellen Sie das nächste Video zum Upload bereit oder beantworten Sie E-Mails. Der größte Workflow-Gewinn der KI-Transkription ist nicht die Transkription selbst – es ist, dass Sie Multitasking ausführen können, während sie läuft. Die manuelle Transkription sperrt Ihre Aufmerksamkeit für Stunden. KI-Transkription gibt sie in unter fünf Minuten zurück.
Schritt 5 – Den ersten Durchgang überprüfen und die vorhersehbaren Fehler beheben (8–10 Minuten)
KI landet typischerweise bei 95–99% Genauigkeit bei sauberen Audios, laut Benchmarks von TechSmith, aber die Fehlschläge häufen sich vorhersehbar:
- Eigennamen – der Nachname Ihres Gastes, Ihr Produktname, Stadtnamen mit ungewöhnlichen Schreibweisen.
- Technischer Jargon – Kubernetes, OAuth, FFmpeg, alles Fachspezifisches.
- Homonyme – their/there/they're, to/two/too, besonders in ungezwungener Rede, wo Prosodie der einzige Disambiguator ist.
- Überlappende Übergänge – wenn zwei Sprecher sich unterbrechen und die ASR raten muss, welche Stimme zu folgen ist.
Verwenden Sie die Find-and-Replace-Funktion des Editors, um wiederkehrende Fehler in einem Durchgang zu beheben, anstatt jede Instanz einzeln zu korrigieren. Wenn der Name Ihres Gastes „Siobhan" ist und das Transkript „Shavon" elf Mal schrieb, das ist eine Ersetzen-Operation, keine elf manuellen Fixes. Der vollständige Bearbeitungsdurchgang dauert typischerweise 8–12 Minuten pro Stunde Video bei sauberen Audios – nennen wir es zehn Minuten für eine 30-minütige Datei.
Schritt 6 – Exportieren und an Ihren Workflow weiterleiten
Laden Sie die Datei in Ihrem gewählten Format herunter. Laden Sie SRT direkt in YouTube Studio für sofortige Untertitel hoch. Fügen Sie TXT in Ihren CMS als Blog-Entwurf ein. Pushen Sie JSON zu Ihrem Suchindex oder leiten Sie es durch einen programmatischen TTS-Workflow für Batch-Verarbeitung weiter. Das Transkript ist jetzt ein Asset mit einem permanenten Zuhause – durchsuchbar, wiederverwendbar, wiederverwendbar – nicht eine temporäre Datei, die in Ihrem Downloads-Ordner verrottet. Diese einzelne Verschiebung, von „Transkript als einmalige Aufgabe" zu „Transkript als dauerhaftes Asset", ist das, was Video-zu-Text-Transkriptions-KI wert macht, als Standard-Infrastruktur zu integrieren statt als einmaliges Experiment.
Genauigkeit hängt von der Audioqualität ab, nicht von der Toolwahl – So beweisen Sie es
Die meisten Beschwerden „dieses KI-Tool ist ungenau" sind tatsächlich „mein Audio war schlecht" Beschwerden in Verkleidung. Die Lösung ist fast nie, Tools zu wechseln. Die Lösung ist, das Audio zu beheben.
Die meisten Beschwerden über die Ungenauigkeit der KI-Transkription sind tatsächlich Beschwerden über die Audioqualität, die sich als etwas anderes ausgeben.
Dr. Jane Chen, Direktorin der Spracherkennungsforschung an der Carnegie Mellon University, drückte es in MIT Technology Review deutlich aus: „Die grundlegende Einschränkung der aktuellen KI-Transkription ist nicht die Technologie selbst, sondern die Nichtübereinstimmung zwischen Benutzererwartungen und Audio-Realität. Die meisten Genauigkeitsbeschwerden stammen von schlechtem Quellenaudio, nicht von Transkriptionsfehlern."
Das heißt, Audioqualität ist nicht die einzige Variable. Es gibt stärkere Gegenevidenzen zu kennen, bevor Sie davon ausgehen, dass eine saubere Aufnahme saubere Ausgabe garantiert. Forschung von Stanford-Linguistin Dr. Lisa Kim (Stanford News, 2024) zeigt, dass KI-Transkription nicht-standardisierte Akzente und Dialekte systematisch falsch darstellt – was bedeutet, dass wenn Ihr Inhalt Sprecher mit regionalen Akzenten, AAVE oder nicht-englischen Muttersprachlern hat, Sie eine höhere Fehlerrate erwarten sollten, die nicht Ihre Schuld ist und nicht nur durch Plattformwechsel behebbar ist. Ein parallele Feststellung im Journal of the American Medical Informatics Association dokumentiert KI-Transkription systematisch medizinische Terminologie auslassend oder falsch darstellend mit potenziell gefährlichen Konsequenzen in Gesundheitseinrichtungen – eine Warnung, die in niedrigeren Einsätzen auf alle technischen oder spezialistischen Inhalte zutrifft.
Die Genauigkeitsansprüche der Anbieter selbst verdienen Skepsis. Eine 2023 Federal Trade Commission Mitteilung warnte, dass „99% Genauigkeit" Ansprüche typischerweise auf Laborbedingungen basieren – einzelner Sprecher, Studio-Mikrofon, kein Hintergrundgeräusch, gemeinsames Vokabular – und echte Verwendungsszenarien nicht widerspiegeln. Dr. Marcus Rodriguez, IEEE Senior Member, machte einen verwandten Punkt in IEEE Spectrum über Sprechererkennung speziell, die in den meisten Pipelines als Nebensache behandelt wird, was kaskadierte Fehler in Multi-Sprecher-Inhalten verursacht, auch wenn die zugrunde liegende ASR ausgezeichnet ist.

Der praktische Takeaway: Sie können die Qualität Ihres Transkripts vorhersagen, bevor Sie jemals hochladen, und Sie können das meiste davon in der Audio-Phase beheben. Hier ist die Pre-Transkription Genauigkeits-Checkliste, die Sie auf jeder Datei ausführen sollten, die Sie kümmert.
- Messen Sie Ihren Raum, bevor Sie aufnehmen. Wenn Sie eine Klimaanlage, einen Kühlschrank oder Straßenlärm hören können, können das auch die KI. Zielen Sie auf einen hörbaren Rauschpegel unter 65 dB SNR; professionelle Transkription erwartet ≥85 dB SNR nach NAB-Standards.
- Verwenden Sie ein Lavaliermikrofon oder Dynamisches Mikrofon, nicht Ihr Laptop. Eingebaute Laptop-Mikrofone nehmen Tastaturgeräusche, Lüftergeräusche und Reflexionen von der Schreibtischoberfläche auf. Sogar ein 40-Dollar-Lav reduziert Ihre WER auf denselben Quellinhalt um ungefähr die Hälfte.
- Nehmen Sie jeden Sprecher auf einem separaten Track auf, wenn möglich. Zwei-Track-Aufnahme ermöglicht dem Engine saubere Sprechererkennung, weil Sprecheridentifikation ein Routing-Problem statt eines Clustering-Problems wird. Ein einzelnes Mikrofon, das Cross-Talk erfasst, reduziert die Sprechererkennung-Genauigkeit von ~85% auf ~55%.
- Pre-isolieren Sie Stimme von Hintergrundmusik oder Geräusch. Wenn Ihre Quelle Musik, Umgebungsgeräusche oder mehrere überlappende Stimmen hat, führen Sie zuerst einen Audio-Isolierungs-Durchgang aus. Dieser einzelne Vorverarbeitungsschritt ist oft der Unterschied zwischen 96% und 78% Genauigkeit auf derselben zugrunde liegenden Aufnahme.
- Erstellen Sie ein Glossar von Eigennamen und Jargon. Verbringen Sie 60 Sekunden damit, Namen, Produktbegriffe und im Video verwendete Akronyme zu tippen. Viele Plattformen akzeptieren eine benutzerdefinierte Vokabular-Datei; wenn die Ihrige nicht, halten Sie die Liste als Find-and-Replace Spickzettel nach dem ersten Durchgang bereit.
- Testen Sie mit einem 60-Sekunden-Clip, bevor Sie eine 90-minütige Datei transkribieren. Wenn der Test-Clip unter 90% Genauigkeit landet, beheben Sie das Audio, bevor Sie Credits auf die Transkription der vollständigen Datei verschwenden. Die fünf Minuten, die Sie zum Testen verwenden, verhindern die Stunde, die Sie damit verbringen würden, gegen schlechte Ausgabe anzukämpfen.
- Audits Zeitstempel bei den 25%-, 50%- und 75%-Marken. Sync-Abweichung ist selten auf modernen Engines, aber katastrophal, wenn sie passiert. Eine 30-Sekunden-Abweichung in einem 60-Minuten-Video desynct Ihre gesamte Untertitel-Datei und erzwingt einen vollständigen Re-Export.
- Für nicht-englische Muttersprachler erwarten Sie 12–18% niedrigere Genauigkeit und budgetieren Sie zusätzliche Bearbeitungszeit entsprechend. Das ist keine Tool-Defekt – es ist eine dokumentierte systemische Lücke, laut MIT CSAIL Forschung über überlappendes Sprache und Akzent-Variation. Planen Sie den zusätzlichen Bearbeitungsdurchgang, anstatt überrascht zu sein.
Führen Sie diese Checkliste ein oder zweimal aus und sie wird zur Gewohnheit. Die Creator, die lautest über Video-Transkriptions-Genauigkeit klagen, überspringe normalerweise die Punkte 1, 2 und 4. Die Creator, die ruhig jedes Mal saubere Transkripte bekommen, verwenden nicht ein besseres Tool – sie füttern dasselbe Tool mit besserem Audio.
Was Sie mit Ihrem Transkript tun, sobald Sie es haben – Fünf wirksame Workflows
Ein Transkript ist nicht die Ziellinie. Es ist die Startlinie für fünf verschiedene Verteilungskanäle, von denen jeder den Wert der ursprünglichen Aufnahme verstärkt.
- Transkript-als-Blog-Beitrag für zusammengesetzte SEO. Ein 60-Minuten-Schulungsvideo als Text auf Ihrer Website veröffentlicht kann für 20–30 Long-Tail-Keywords ranken, die das Video allein nicht beeinflussen könnte. Google indexiert den Text, YouTube indexiert das Video, und Sie haben Ihre Entdeckungsfläche aus einer Produktion verdoppelt. Dr. Elena Petrova, Medienzugangsforscherin an der USC, drückte es gut im Journal of Digital Media & Policy aus: „Der größte Fehler von Content-Creatorn ist, KI-Transkripte als fertige Inhalte statt als Rohstoff zu behandeln. Die Bearbeitungsphase ist, wo echter Wert für Publikumskonsum schaffenirewunder wird." Übersetzung: Fügen Sie nicht das Rohe Transkript ein und nennen Sie es einen Beitrag. Bearbeiten Sie es wie ein Schriftsteller würde – entfernen Sie Füllwörter, fügen Sie Unterüberschriften hinzu, straffen Sie die Eröffnung – und Sie haben einen veröffentlichbaren Artikel in unter einer Stunde.
- Untertitel-Dateien für Barrierefreiheit und Engagementanstieg. Das Hinzufügen von SRT- oder WebVTT-Untertiteln verbessert die Wiedergabezeit auf Sozial-Plattformen um zweistellige Prozentpunkte, weil die meiste mobile Wiedergabe mit ausgeschaltetem Sound passiert. Untertitel erweitern auch die Reichweite auf gehörlose und schwerhörig Menschen – ein Barrierefreiheits-Engagement, nicht nur ein Engagementspiel. Dieselbe SRT-Datei, die Sie zu YouTube hochgeladen haben, kann für Instagram Reels, TikTok und LinkedIn Native Video wiederverwendet werden, ohne erneut transkribieren zu müssen.
- Übersetzungs- und Synchronisierungs-Pipelines. Ihr Transkript ist das Quelldokument für Lokalisierung. Eine saubere English SRT kann KI-Synchronisierungs-Systemen speisen, die synchronisierte Audio in 33+ Zielsprachen generieren, wodurch ein einziges englisches Video ohne Neuaufnahme in eine mehrsprachige Bibliothek verwandelt wird. Kombinieren Sie es mit Sprach-Kloning und die synchronisierten Versionen klingen wie Sie, nicht wie ein generischer synthetischer Erzähler. Ein English-Upload wird eine spanische, portugiesische, deutsche, japanische und Hindi-Verteilungsfläche an einem Nachmittag.
- Durchsuchbare Team-Wissensdatenbank. Leiten Sie Transkripte als JSON oder indiziertes TXT zu Ihrem Team-Wiki, Notion-Datenbank oder internen Suchtool weiter. Jetzt wird „was haben wir über die Q3-Roadmap beim All-Hands gesagt?" eine durchsuchbare Abfrage, nicht ein Archäologie-Projekt. Für Teams, die wöchentlich all-hands, monatlich Kundeninterviews und vierteljährlich Strategie-Reviews durchführen, ändert dieser einzelne Workflow die Sperre auf Jahre aufgezeichneter Kontexte, die vorher in nicht durchsuchbaren Videodateien eingesperrt waren.
- Wiederverwendungs-Treibstoff für Short-Form-Inhalt. Führen Sie Ihr Transkript durch einen Zusammenfassungsschritt aus und identifizieren Sie die 6–10 höchst einflussreichen Zitate. Jede wird ein LinkedIn-Beitrag, ein Instagram Reel Caption, ein X-Thread oder ein Newsletter-Pull-Zitat. Eine Stunde Quellvideo wird zu einem Monat Verteilungsmaterial. Pairing standout Zitate mit einem KI-Bildgenerator um passende Visuals für jeden Beitrag zu schaffen, und das Transkript ist die Naht zwischen „Long-Form-Denken einmal erfasst" und „Short-Form-Verteilung läuft für Wochen."
Ein Transkript ist nicht ein Lieferable. Es ist das Hub-Asset, das fünf separate Verteilungskanäle speist – und sobald Sie es so sehen, ändert sich die Mathematik über Transkriptions-Kosten komplett.
Verbinden Sie die Punkte: von einem Hub-Asset produzieren Sie Untertitel, Blog-Inhalte, übersetzte und synchronisierte Versionen, Such-Indizierung und Short-Form-Treibstoff – fünf Outputs aus einer Eingabe. Die Wirtschaft verschiebt sich dramatisch, sobald Sie aufhören, Transkription als Pro-Video-Kosten zu behandeln und anfangen, sie als Input zu behandeln, der fünf Output-Kanäle freischaltet. Für Creator oder Teams, die mehr als 4–5 Videos pro Monat produzieren, macht das Automatisieren dieser Kette via Transkriptions- und Synchronisierungs-APIs die ganze Pipeline hands-off – Uploads in einen Ordner, bekommen Untertitel, Übersetzungen und indizierte Texte zurück, ohne manuelle Schritte. Das ist, wenn Video-zu-Text-Transkriptions-KI aufhört, ein Tool zu sein, das Sie erreichen, und beginnt, Infrastruktur zu sein, die Sie nicht bedenken.
Ihre erste Transkription – Die Checkliste für Vor-, Während- und Nach-dem-Flug
Sie haben die Theorie gelesen. Hier ist die operative Version, organisiert in drei Phasen plus ein Entscheidungs-Gate.
Vor-dem-Flug (Bevor Sie hochladen)
- Bestätigen Sie Dateiformat und -größe. MP4, MOV, WebM, MP3, WAV, M4A werden universell unterstützt. Bleiben Sie unter Plattform-Größenlimits (typischerweise 1–2 GB oder 4 Stunden Dauer). Teilen Sie längere Dateien vor dem Upload auf.
- Identifizieren Sie die primäre gesprochene Sprache. Markieren Sie alle Code-Switching-Segmente mental, sodass Sie wissen, wo die Ausgabe überprüft werden soll. Wenn 90% des Videos Englisch sind mit 30 Sekunden Spanisch, erwarten Sie, dass das spanische Segment zusätzliche Aufmerksamkeit braucht.
- Erstellen Sie ein 60-Sekunden-Eigennamenglossar. Geben Sie Namen, Produktbegriffe, Akronyme und ungewöhnliches Vokabular ein, die für dieses Video spezifisch sind. Speichern Sie es neben der Datei. Sie werden es später für Find-and-Replace verwenden.
- Führen Sie zuerst einen 60-Sekunden-Test-Clip aus. Wenn der Test unter 90% Genauigkeit landet, beheben Sie das Audio – re-isolieren Sie Stimme, reduzieren Sie Geräusch, wechseln Sie Dateiquelle – bevor Sie die vollständige Datei transkribieren. Fünf Minuten Testing verhindern eine Stunde mit schlechter Ausgabe.
- Wählen Sie Ihr Ausgabeformat basierend auf dem Ziel. SRT für YouTube und Untertitel. TXT für Blogs und KI-Zusammenfassung. Zeitgestempelter TXT für Podcasts. JSON für Entwickler und Such-Indizierung. Entscheiden Sie, bevor Sie hochladen, nicht danach.
Während-dem-Flug (Während der Verarbeitung)
- Starren Sie nicht auf die Fortschrittsleiste. Eine 30-minütige Datei wird in 3–5 Minuten verarbeitet. Verwenden Sie dieses Fenster, um die Videobeschreibung zu schreiben, den Blog-Titel zu schreiben oder die nächste Datei in die Warteschlange zu stellen. Das ganze Ziel der KI-Transkription ist, dass es Ihre Aufmerksamkeit freisetzt, während es funktioniert.
- Batch, wenn möglich. Wenn Sie mehrere Dateien verarbeiten, reihen Sie sie in die Warteschlange ein und gehen weg. Die meisten Plattformen verarbeiten parallel, was bedeutet, dass zehn 30-Minuten-Dateien in ungefähr der gleichen Wanduhr-Zeit wie einer fertig werden.
Nach-dem-Flug (Nach dem Export)
- Überprüfen Sie die erste 10% und letzte 10%. Fehler häufen sich an den Kanten – wenn ASR immer noch am Anfang kalibriert und wenn Audioqualität oft am Ende abfällt (Energie sinkt, Aufnahme-Artefakte, Ausblendungen). Höre und lese diese Segmente speziell.
- Führen Sie Find-and-Replace auf Ihr Glossar aus. Nehmen Sie das 60-Sekunden-Glossar aus Schritt 3 und führen Sie es in einem Durchgang aus. Beheben Sie jede Instanz von „Cura Nettis" → „Kubernetes" auf einmal, nicht elf separate Male.
- Überprüfen Sie Zeitstempel bei 25%, 50% und 75%. Öffnen Sie das Video bei jedem Marker, überprüfen Sie, dass der Transkript-Zeitstempel mit dem Audio übereinstimmt. Abweichung ist selten, aber korrosiv, wenn es passiert.
- Leiten Sie die Datei sofort an ihr Ziel weiter. Laden Sie SRT zu YouTube Studio hoch. Fügen Sie TXT in Ihren CMS-Entwurf ein. Pushen Sie JSON zu Ihrem Index. Dateien, die in Ihrem Downloads-Ordner sitzen, werden Dateien, die Sie vergessen.
Entscheidungs-Gate – Welche Ausgabe brauchen Sie?
Bevor Sie hochladen, führen Sie sich durch diese Verzweigung:
- Videos mit Untertiteln? → Exportieren Sie SRT oder WebVTT, laden Sie direkt zu der Videoplattform hoch.
- Schreiben eines Blog-Beitrags oder Artikels? → Exportieren Sie TXT, bearbeiten Sie für Lesbarkeit (schneiden Sie Füllwörter, fügen Sie Unterüberschriften hinzu), veröffentlichen Sie.
- Bauen eines Podcast-Show-Notes? → Exportieren Sie zeitgestempelten TXT, verlinken Sie die Zeitstempel als Navigation in den Show Notes.
- Bauen einer mehrsprachigen Content-Bibliothek? → Exportieren Sie SRT, leiten Sie es dann in einen KI-Synchronisierungs-Workflow weiter, um synchronisierte Versionen in Ihren Zielsprachen zu generieren.
- Indizieren für Team-Suche oder App-Bau? → Exportieren Sie JSON mit Wort-Ebenen-Zeitstempeln, leiten Sie zu Ihrem Such-Backend oder Wissensdatenbank weiter.
Wählen Sie die Ausgabe, die dem Ziel entspricht, klicken Sie auf Transkribieren, und die nächsten vier Workflow-Schritte entsperren sich selbst.