Die Entscheidung zwischen TTS und Voice Cloning für Narration läuft auf eine ehrliche Frage hinaus: Brauchen Sie eine zuverlässige Stimme für den Inhalt oder die spezifische Identität eines bestimmten Sprechers darin? Standard-Text-to-Speech liefert Ihnen schnelle, flexible Narration aus einer fertigen Bibliothek. Voice Cloning bildet eine wiedererkennbare Stimme nach, sodass dieselbe Person scheinbar über neue Skripte, Videos und Sprachen hinweg spricht. Für viele Creator und Teams ist der kluge Weg beides: Mit einer Stock-Stimme für Tempo prototypisieren und dann freigegebene Arbeiten auf einen einwilligungsbasierten Klon umstellen, sobald Markenidentität oder Sprecherkontinuität wichtig werden. Der Rest dieses Leitfadens zeigt genau, wo jede Variante gewinnt.
Inhaltsverzeichnis
Der schnellste Weg, bei dieser Entscheidung nicht länger im Kreis zu drehen, besteht darin, zwei Dinge zu trennen, die ständig verwechselt werden: den Stil einer Stimme und die Identität dahinter. Eine Standard-TTS-Stimme liefert Ihnen einen produktionsreifen Stil. Sie kann warm, autoritär, energiegeladen, gesprächig oder neutral vorlesen, und Sie wählen sie, weil sie zum Skript passt. Eine geklonte Stimme liefert Ihnen Kontinuität mit einer bestimmten Person. Zuhörer erkennen sie als Creator, Dozent, Gründer oder Sprecher, und Sie wählen sie, weil diese Identität Teil des Produkts ist.
Dieser Unterschied verändert mehr als nur den Klang eines Clips. Er verändert Ihren operativen Aufwand. Stil ist etwas, das Sie frei austauschen; Identität ist etwas, das Sie schützen, dokumentieren und über jede neue Datei hinweg konsistent halten. Behalten Sie diese Trennung im Kopf, und die meisten der folgenden Entscheidungen beantworten sich von selbst.
Wie Text-to-Speech-Narration tatsächlich funktioniert
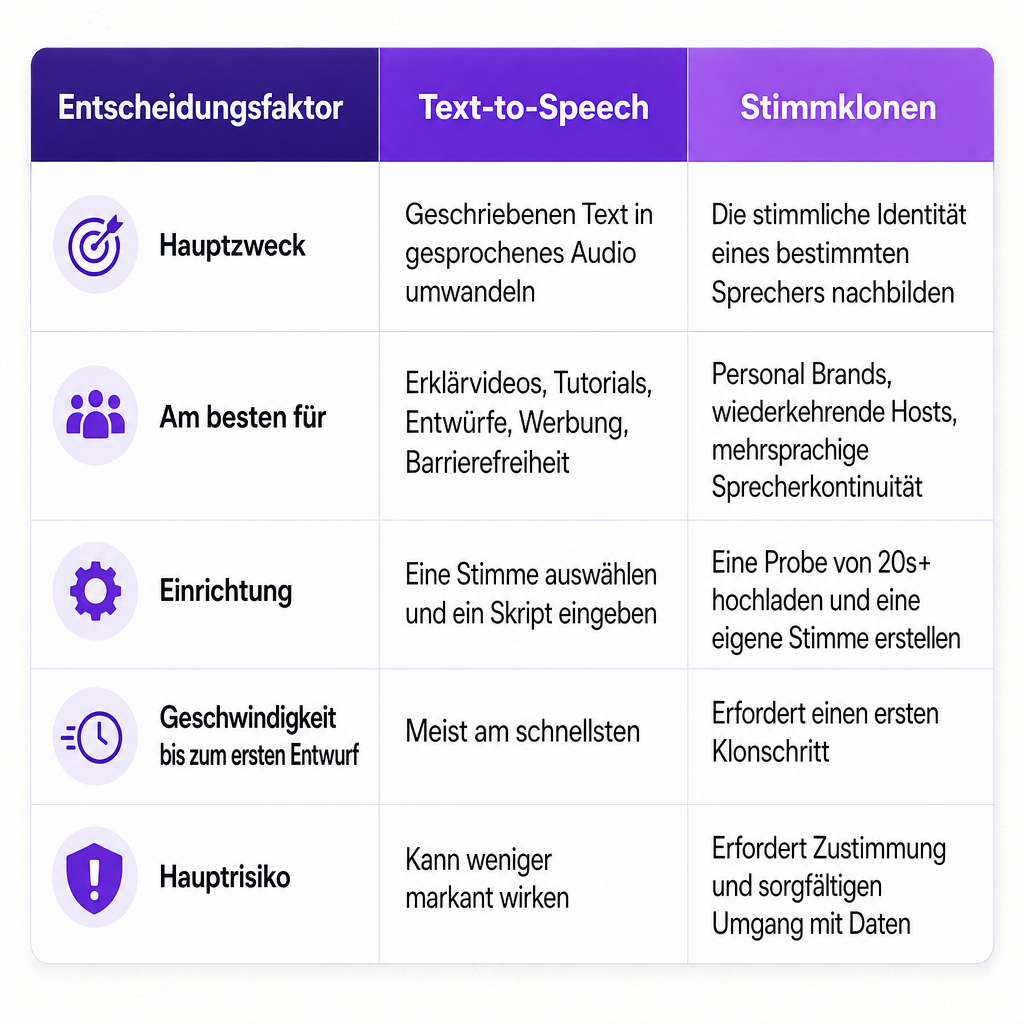
Text-to-Speech wandelt geschriebenen Text in synthetisierte Sprache um. Das System liest Ihr Skript, interpretiert Aussprache und Satzstruktur und erzeugt eine Audiospur in einer Stimme, die Sie aus einem Katalog wählen. Sie erfassen keine bestimmte Person, die die Worte vorliest; Sie erzeugen frische Sprache im Stil einer vorgefertigten Stimme.
In der Praxis steuern Sie eine Handvoll Stellhebel: Sprache, Akzent, Stimmprofil, Tonfall, Sprechgeschwindigkeit und Vortragsstil. Genau diese Flexibilität ist der springende Punkt. Wenn sich ein Preis, Produktname, eine Statistik oder eine Lektion ändert, bearbeiten Sie den Text und generieren nur den betroffenen Abschnitt neu, anstatt erneut ein Studio zu buchen. Unser Text-to-Speech-Tool durchläuft diesen Kreislauf von Anfang bis Ende: Text eingeben, einen Sprecher aus über 300 KI-Stimmen auswählen, generieren, das Projekt bearbeiten und herunterladen – mit Steuerungen für die Sprechgeschwindigkeit und Textmarkierungen zur Betonung.
Greifen Sie zu Standard-TTS, wenn die Stimme selbst nicht wiedererkennbar sein muss. Sie eignet sich für erste Entwürfe und Testversionen, für Kanäle, die häufig veröffentlichen und schnelle Aktualisierungen benötigen, für Workflows, in denen mehrere Personen Skripte schreiben oder verwalten, und für Inhalte, die unterschiedliche Stimmen für verschiedene Charaktere oder Abschnitte erfordern. Sie ist auch die natürliche Wahl, wenn Sie mehrere Sprachen, Akzente oder Vortragsstile ausprobieren möchten oder wenn Sie lehrreiches, informatives und auf Barrierefreiheit ausgerichtetes Material produzieren. Ein kleines Unternehmen, das wöchentlich Produkt-Tutorials veröffentlicht, kann beispielsweise eine konsistente Stock-Stimme beibehalten und Funktionen sowie Handlungsaufforderungen aktualisieren, ohne jemals eine Aufnahme koordinieren zu müssen.
Wie Voice-Cloning-Narration tatsächlich funktioniert
Voice Cloning erzeugt synthetische Sprache, die einer bestimmten Person ähnelt. Das System analysiert eine Probe hinsichtlich Aussprache, Tonhöhe, Rhythmus, Tonfall und Sprechstil und nutzt diese Merkmale dann, um aus Text neue Sprache zu generieren. Dabei wird kein fertiges Voiceover in eine Zeitleiste geschnitten. Es entsteht ein wiederverwendbares Stimmmodell, das Skripte sprechen kann, die der Sprecher nie aufgenommen hat.
Die Probe leistet den Großteil der Arbeit. Unsere Voice-Cloning-Seite weist darauf hin, dass Sie aus einer Audiodatei von mindestens 20 Sekunden eine benutzerdefinierte Stimme erstellen können und dass eine saubere Aufnahme ohne Hintergrundgeräusche bessere Ergebnisse liefert. Der Sprechstil in diesem Upload überträgt sich: Eine monotone Referenz führt tendenziell zu flacherer Narration, während eine Probe mit der Energie und Emotion, die Sie tatsächlich wünschen, dem Modell ein stärkeres Ziel vorgibt. Einmal erstellt, kann die Stimme sowohl in Text-to-Speech- als auch in KI-Dubbing-Projekten wiederverwendet werden.
Wählen Sie Cloning, wenn die Identität des Sprechers Teil der Marke oder des Produkts ist. Es passt zu einem YouTube-Host, der häufiger veröffentlichen muss, ohne jede Zeile aufzunehmen, zu einem Podcaster, der kleine Abschnitte korrigiert, statt eine Episode neu aufzunehmen, zu einem Unternehmen, das eine konsistente Gründer- oder Dozentenstimme möchte, und zu einem Kurs, der denselben Dozenten über mehrere Sprachen hinweg beibehalten muss. Ein Online-Lehrer kann einmal eine saubere Probe aufnehmen und dann einen einwilligungsbasierten Klon verwenden, um Lektionen aufzufrischen, veraltete Fakten zu korrigieren oder Versionen für internationale Lernende zu erstellen. Für einen tieferen Einblick in die Wiederverwendung einer Identität über verschiedene Formate hinweg lesen Sie unseren Leitfaden zu KI-Dubbing vs. Voice Cloning für die Wiederverwertung von Inhalten.
Der entscheidende Unterschied: Stimmstil oder Stimmidentität
Wenn Sie sich sonst nichts merken, merken Sie sich diesen Rahmen, denn er löst die meisten Grenzfälle schneller als jede Funktionstabelle. Standard-TTS ist ein Auswahlproblem: Sie wählen einen Stil aus dem Regal, und Sie können es sich nächste Woche kostenlos anders überlegen. Cloning ist eine Kontinuitätsverpflichtung: Sie binden sich an eine Identität und verpflichten sich, diese im Laufe der Zeit zu pflegen, zu verwalten und zu schützen.
Deshalb verhält sich eine gründergeführte Marke anders als ein gesichtsloser Erklärkanal, selbst wenn die Skripte identisch aussehen. Der Erklärkanal braucht nur eine kompetente Stimme, also trägt ihn TTS. Die Gründermarke lebt von Wiedererkennung, also wird die geklonte Stimme zu einem Asset, das den zusätzlichen Aufwand und Papierkram wert ist. Wenn Sie feststecken, fragen Sie sich, ob ein Austausch der Stimme im nächsten Monat die Beziehung des Publikums zum Inhalt beeinträchtigen würde. Wenn ja, befinden Sie sich im Cloning-Bereich. Für einen genaueren direkten Vergleich dieser beiden Wege erläutert unser Beitrag zur Entscheidung zwischen einer geklonten Stimme und einer Stock-TTS-Stimme die Kriterien ausführlicher.
Welche Variante wählen, je nach Produktionsziel
Die richtige Antwort verschiebt sich je nachdem, was Sie tatsächlich erstellen. So fällt die Entscheidung bei den häufigsten Narrationsaufgaben aus.
YouTube-Creator. TTS passt zu gesichtslosen Kanälen, Erklärvideos, Listenvideos und nachrichtenähnlichen Inhalten, bei denen keine Host-Identität auf dem Spiel steht. Cloning passt zu Kanälen, die Zuschauer mit einem bestimmten Moderator verbinden, sodass Sie den wiedererkennbaren Klang beibehalten und Neuaufnahmen für Korrekturen, Intros und Kurzform-Varianten überspringen können. Für mehrsprachige Expansion kombinieren Sie eine benutzerdefinierte Stimme mit KI-Dubbing, anstatt pro Sprache eine separate Narrationsidentität zu erfinden.
Kleine Unternehmen und Marketingteams. Setzen Sie auf TTS für Kampagnenvarianten, Produkterklärer, Social Ads und häufige Textänderungen. Bringen Sie Cloning ins Spiel, wenn ein Gründer, Botschafter oder Sprecher für das Vertrauen zentral ist. Ein Klon kann freigegebene Skriptvarianten sprechen, ersetzt aber niemals die Prüfung von Aussagen, Aussprache und Markentonalität.
E-Learning und Unternehmensschulungen. TTS glänzt, wenn Kurse viele Module, Themen oder häufige Aktualisierungen umfassen, da Stock-Stimmen es leicht machen, verschiedenen Kursen oder Rollen unterschiedliche Stimmen zuzuweisen. Cloning passt zu Programmen, in denen Lernende durchgängig einen Dozenten erwarten, oder wenn Sie einen bestehenden Kurs auffrischen, ohne die vertraute Stimmidentität zu verlieren. In beiden Fällen bleibt die menschliche Prüfung von Namen, Fachbegriffen, Abkürzungen und Zahlen unerlässlich.
Podcasts und unabhängige Filme. Nutzen Sie TTS für Scratch-Tracks, Narrationstests und Platzhalterarbeit, bevor der endgültige Sprecher feststeht. Nutzen Sie Cloning für konsistente Nachaufnahmen, alternative Versionen oder die freigegebene Lokalisierung eines Hosts oder Darstellers, wobei Rechte und beabsichtigter Verwendungszweck vor Produktionsbeginn dokumentiert werden.
Entwickler und Agenturen. TTS ist in der Regel der einfachere API-Einstiegspunkt: Text senden, eine Stimme wählen, Sprache erhalten. Cloning passt zu Apps, die dauerhafte benutzerdefinierte Stimmen pro Kunde, Marke oder Charakter benötigen. Unsere Voice Cloning API akzeptiert Uploads in MP3, WAV, AAC, M4A und FLAC, gibt eine benutzerdefinierte Stimme zurück, auf die Sie in TTS oder KI-Dubbing verweisen können, und stellt Operationen zum Auflisten und Löschen benutzerdefinierter Stimmen bereit.
Welche klingt natürlicher
Keine der Optionen ist automatisch die natürliche. Eine hochwertige Stock-Stimme kann einen Klon, der aus verrauschtem Audio erstellt wurde, mühelos übertreffen, und eine schlechte Probe reproduziert ihre eigenen Fehler: Hintergrundbrummen, ungleichmäßiger Vortrag, ein emotionaler Tonfall, der nicht zum Skript passt. Natürlichkeit ist ein Ergebnis, das Sie testen, kein Etikett, das Sie voraussetzen.
Beurteilen Sie das Ergebnis anhand konkreter Kriterien statt eines ersten Eindrucks:
- Aussprache: Werden Namen, Akronyme, Zahlen und Fachbegriffe richtig wiedergegeben?
- Prosodie: Passt der Rhythmus zum Skript?
- Konsistenz: Bleibt die Stimme über Clips und Sprachen hinweg stabil?
- Emotion: Passt der Vortrag zum Zweck der Narration?
- Klarheit: Ist sie auf Telefonen, Laptops und Kopfhörern verständlich?
- Bearbeitbarkeit: Können Sie einen Satz neu generieren, ohne dass die gesamte Spur abdriftet?
- Lokalisierung: Passt sie noch, wenn sie für einen anderen Markt angepasst wird?
Lassen Sie bei TTS mehrere Stock-Stimmen denselben Absatz vortragen und vergleichen Sie. Testen Sie bei Cloning ein repräsentatives Skript mit den schwierigen Wörtern, dem emotionalen Spektrum und dem Tempo des fertigen Projekts, nicht nur eine kurze Begrüßung. Die Begrüßung klingt fast immer gut; die eigentliche Herausforderung liegt dort, wo Klone ihre Schwächen offenbaren.
Rechte, Einwilligung und Kennzeichnung, die Sie nicht überspringen dürfen
Cloning bringt eine Verantwortung mit sich, die reines TTS nicht hat, denn es kann die Stimme einer identifizierbaren Person reproduzieren. Klonen Sie eine Stimme nur, wenn Sie die Erlaubnis und Rechte für den beabsichtigten Verwendungszweck besitzen, und machen Sie diese Erlaubnis spezifisch. Eine gute Einwilligung klärt, wem die Originalaufnahme gehört, wo die synthetische Stimme erscheinen darf, ob kommerzielle Nutzung erlaubt ist, welche Sprachen und Gebiete eingeschlossen sind, ob Werbung oder Dubbing zulässig ist, wie lange die Erlaubnis gilt, wie das Modell und die Quelldateien gespeichert werden und was passiert, wenn die Lizenz endet.
Wir behandeln Einwilligung und ethische Nutzung als Teil unseres Voice-Cloning-Ansatzes, und unsere API unterstützt das Löschen benutzerdefinierter Stimmen und der zugehörigen Audiodaten. Prüfen Sie die aktuellen Bedingungen, die für Ihr Konto und Projekt gelten, bevor Sie eine Probe hochladen. Auch der rechtliche Rahmen ist weiterhin in Bewegung: Das U.S. Copyright Office hat realistische Stimmnachbildungen als digitale Nachbildungen eingestuft und zusätzlichen bundesweiten Schutz gegen unautorisierte Nachbildungen empfohlen, wie in seinem Bericht über Urheberrecht und digitale Nachbildungen dargelegt.
Hinzu kommt eine Kennzeichnungsebene. YouTubes Leitfaden zur Offenlegung KI-generierter Inhalte nennt das synthetische Erzeugen der Stimme einer Person zur Narration eines Videos als realistische veränderte oder synthetische Inhalte, die Creator offenlegen müssen. Stellen Sie eine geklonte Stimme also nicht als unveränderte Aufnahme dar, wenn dies Zuschauer in die Irre führen könnte. Die FTC hat separat gewarnt, dass Voice Cloning Betrugsmaschen durch Identitätsnachahmung glaubwürdiger macht – genau deshalb sind Autorisierung und transparente Nutzung keine optionalen Nettigkeiten.
Eine Entscheidungsregel, die Sie heute anwenden können
Wenn das Publikum eine gute Stimme braucht, wählen Sie TTS. Wenn das Publikum genau diesen bestimmten Sprecher braucht, wählen Sie Voice Cloning.
Beginnen Sie mit TTS, wenn Tempo, Vielfalt, Experimentieren und häufige Skriptänderungen dominieren. Es ist schneller zu testen, leichter zu überarbeiten und eröffnet eine breite Palette an Stimmen, ohne dass eine Probe erforderlich ist. Wechseln Sie zu Cloning, wenn Wiedererkennung, Kontinuität und Sprecheridentität im Mittelpunkt stehen, etwa bei einem Creator-geführten Kanal, einem Dozenten-geführten Kurs, einer gründergeführten Marke, einem Podcast-Host oder einem mehrsprachigen Sprecher. Verwenden Sie nur eine autorisierte Probe, prüfen Sie das generierte Audio genau und befolgen Sie die Kennzeichnungsregeln, wo sie gelten.
Viele Teams entscheiden sich für beides, und zwar bewusst: Mit einer Stock-Stimme prototypisieren und dann freigegebene, wiederkehrende Inhalte auf eine benutzerdefinierte Stimme migrieren, sobald die Produktion den Aufwand rechtfertigt. Dieser Hybridansatz ist besonders wirksam für YouTube-Kanäle, Online-Kurse, Markenkampagnen und mehrsprachige Bibliotheken. Wir bringen beides in einen Workflow, sodass Sie mit flexibler Narration aus über 300 Stimmen beginnen, benutzerdefinierte Stimmen aus Audioproben erstellen und sie in TTS oder KI-Dubbing wiederverwenden können, während das Projekt reift.
Häufig gestellte Fragen
Ist Voice Cloning dasselbe wie TTS?
Nein. TTS wandelt geschriebenen Text mithilfe einer ausgewählten synthetischen Stimme in Sprache um. Voice Cloning erstellt ein benutzerdefiniertes Stimmmodell, das einem bestimmten Sprecher ähneln soll und anschließend TTS-Narration erzeugen kann.
Ist TTS besser als Voice Cloning?
Nicht grundsätzlich. TTS gewinnt in der Regel bei Tempo, Stimmvielfalt, Tests und häufigen Aktualisierungen. Cloning gewinnt, wenn die Identität eines bestimmten Sprechers über neue Inhalte hinweg konsistent bleiben muss.
Wie viel Audio wird benötigt, um eine Stimme mit DubSmart zu klonen?
Unsere Voice-Cloning-Seite besagt, dass der Upload mindestens 20 Sekunden Audio enthalten sollte. Für bessere Ergebnisse wird eine saubere Aufnahme ohne Hintergrundgeräusche empfohlen.
Kann ich eine geklonte Stimme für mehrsprachige Narration verwenden?
Ja. Geklonte Stimmen können in KI-Dubbing über unsere unterstützten Sprachen hinweg wiederverwendet werden. Testen Sie Aussprache und kulturelle Passung in jedem Zielmarkt vor der Veröffentlichung.
Sollten YouTube-Creator KI-Narration offenlegen?
Prüfen Sie die aktuellen Offenlegungssteuerungen von YouTube. YouTube stuft das synthetische Erzeugen der Stimme einer Person für Narration als realistische veränderte oder synthetische Inhalte ein, die möglicherweise offengelegt werden müssen.