Wählen Sie eine Standard-TTS-Stimme, wenn Sie schnelle, flexible Sprachausgabe benötigen und niemand den Sprecher wiedererkennen muss. Wählen Sie eine geklonte Stimme, wenn der Klang einer bestimmten Person Vertrauen, Kontinuität oder Markenwiedererkennung vermittelt. Dieser eine Kompromiss zwischen Geschwindigkeit und Identität steht im Zentrum der Entscheidung geklonte Stimme vs. Standard-TTS-Stimme, und die meisten Kreativen machen es sich zu kompliziert, weil sie die beiden als Rivalen statt als Werkzeuge für unterschiedliche Aufgaben behandeln.
Bei DubSmart AI integrieren wir beide in einen einzigen Workflow, daher konzentriert sich dieser Leitfaden auf die Entscheidung selbst: was jede Option tatsächlich ist, wie sie funktioniert und die konkreten Kriterien, die Ihnen sagen, welche für ein bestimmtes Projekt passt. Am Ende sollten Sie in der Lage sein, jedes Skript anzusehen und innerhalb von Sekunden zu wissen, ob Sie eine fertige oder eine maßgeschneiderte Stimme benötigen.
Inhaltsverzeichnis
Was eine geklonte Stimme von einer Standard-TTS-Stimme unterscheidet
Der Unterschied läuft auf eine Sache hinaus: die Stimmidentität.
Eine Standard-TTS-Stimme ist eine fertige synthetische Stimme, die Sie aus einer Bibliothek auswählen. Sie fügen ein Skript ein, wählen eine Stimme und Sprache und erzeugen Audio. Sie ist darauf ausgelegt, über viele Projekte und Zielgruppen hinweg wiederverwendbar zu sein, weshalb sie neutral statt persönlich wirkt.
Eine geklonte Stimme ist eine synthetische Version eines bestimmten Sprechers. Das System analysiert eine Aufnahme dieser Person und reproduziert deren Tonfall, Aussprache, Rhythmus und stimmlichen Charakter in neuer Sprache. Das Ergebnis ist an eine autorisierte Einzelperson gebunden statt an eine Plattform-Voreinstellung.
Diese Unterscheidung bestimmt jede nachgelagerte Entscheidung über Einrichtung, Flexibilität, Kontinuität und Governance.
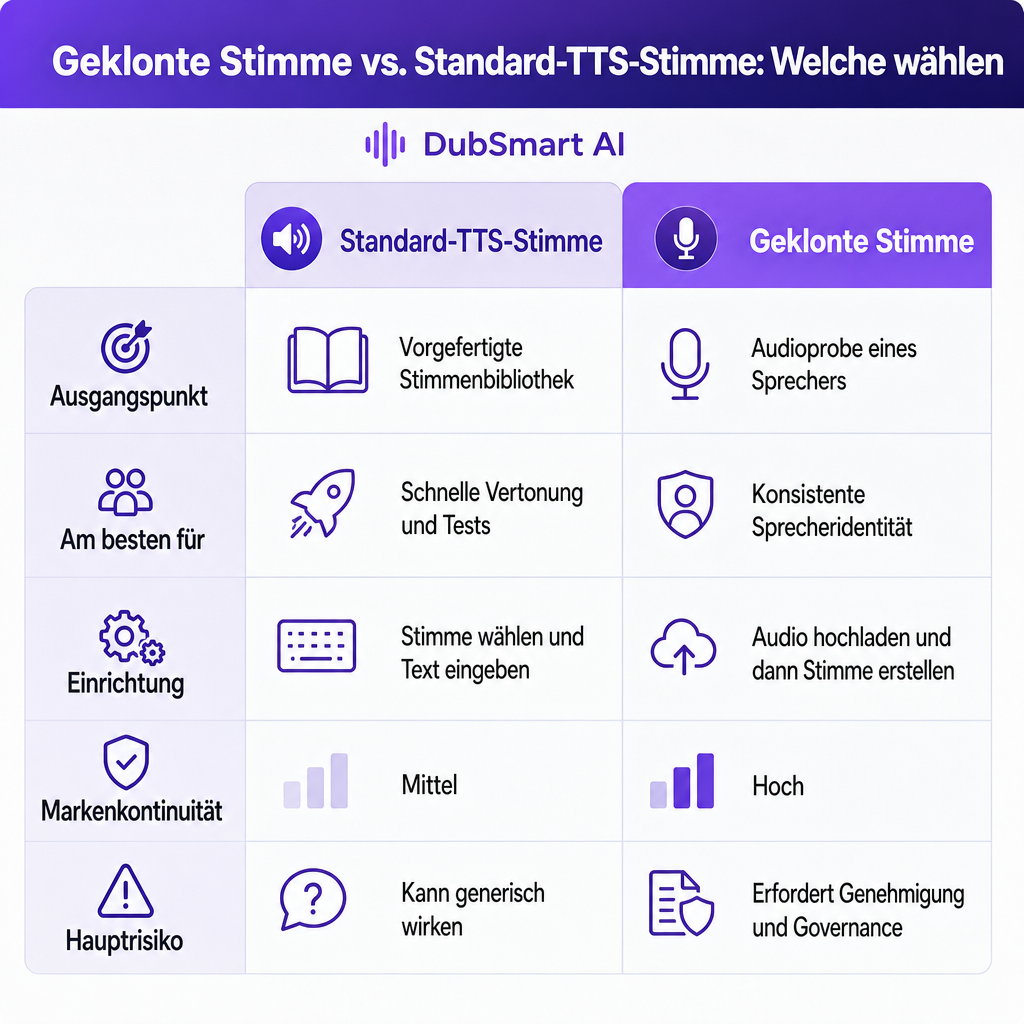
| Faktor | Standard-TTS-Stimme | Geklonte Stimme |
|---|---|---|
| Ausgangspunkt | Vorgefertigte Stimmbibliothek | Audioprobe eines Sprechers |
| Am besten geeignet für | Schnelle Sprachausgabe und Tests | Konsistente Sprecheridentität |
| Einrichtung | Stimme wählen, Text eingeben | Audio hochladen, dann Stimme erstellen |
| Markenkontinuität | Mittel | Hoch |
| Hauptrisiko | Kann generisch wirken | Benötigt Erlaubnis und Governance |
Wenn Sie eine tiefergehende Analyse darüber wünschen, wie sich die zugrunde liegenden Werkzeuge unterscheiden, vergleicht unser Erklärbeitrag zu Voice Cloning vs. Text-to-Speech Identität, Einrichtung, Skalierbarkeit und Governance im Detail.
Wie jede Option tatsächlich funktioniert
Das Verständnis der Mechanik macht die Entscheidung offensichtlich, denn jeder Weg verlagert den Aufwand an eine andere Stelle.
Standard-TTS wandelt Text mit einer bereits vorhandenen Stimme in Sprache um. Sie schreiben oder fügen ein Skript ein, wählen eine Stimme und Sprache, passen bei Bedarf die Wiedergabe an und exportieren. Es gibt keinen Datensatz zu pflegen und keinen Sprecher, den man für eine kleine Skriptänderung zurückrufen muss. Unser Tool Text-to-Speech bietet mehr als 300 menschenähnliche Stimmen und Steuerelemente wie Sprechgeschwindigkeit, Emotions-Prompts und Betonungsformatierung, sodass Sie in wenigen Minuten mehrere Richtungen ausprobieren können.
Voice Cloning verlagert den Aufwand stattdessen nach vorne. Es beginnt mit einer Aufnahme des Sprechers; das System analysiert dessen stimmliche Eigenschaften und erstellt eine wiederverwendbare, maßgeschneiderte Stimme, die Sie dann mit neuem Text ansteuern können. Bei DubSmart können Sie eine Audiodatei von mindestens 20 Sekunden hochladen, um einen Klon zu erstellen, und eine saubere Aufnahme ohne Hintergrundgeräusche liefert bessere Ergebnisse. Auch der Sprechstil in der Probe ist wichtig: Ein monotoner Clip erzeugt tendenziell flachere Sprache, während eine Probe mit der gewünschten Emotion hilft, diesen Stil zu reproduzieren. Unser Tool Voice Cloning stellt diese maßgeschneiderte Stimme anschließend sowohl für Text-to-Speech als auch für AI Dubbing zur Verfügung.
Die praktische Konsequenz ist das Timing. Standard-TTS liefert Ihnen heute ohne jegliche Einrichtung Audio. Cloning verlangt im Vorfeld eine Aufnahme, eine Genehmigung und eine Qualitätsprüfung, zahlt diesen Aufwand dann aber bei jeder zukünftigen Erstellung zurück.
Die sechs Kriterien, die darüber entscheiden
Prüfen Sie ein Projekt anhand dieser sechs Fragen, und die Antwort ergibt sich meistens von selbst.
1. Trägt die Stimme selbst Bedeutung? Wenn es den Zuschauern wichtig ist, wer spricht, gewinnt das Klonen. Ein YouTube-Pädagoge, Podcast-Moderator oder Gründer, der durch seine Stimme Vertrauen aufgebaut hat, verliert etwas, wenn ein generischer Sprecher ihn ersetzt. Wenn die Stimme nur Informationen vermittelt, etwa bei einem Software-Tutorial oder einer internen Ankündigung, reicht Standard-TTS aus.
2. Wie viel Inhalt werden Sie produzieren? Für eine einzelne 30-Sekunden-Anzeige ist das Greifen zu einer Standardstimme schneller als die Vorbereitung eines Klons. Für Hunderte von Videos, Lektionen oder Episoden beseitigt eine geklonte Stimme wiederholte Aufnahmearbeit und wahrt die Kontinuität über die gesamte Bibliothek hinweg.
3. Benötigen Sie mehrsprachige Lokalisierung? Beide bewältigen mehrere Sprachen, aber sie lösen unterschiedliche Probleme. Mit Standard-TTS wählen Sie für jede Zielsprache eine passende Stimme, was hilfreich ist, wenn ein regionaler Stil wichtiger ist als der ursprüngliche Sprecher. Beim Klonen besteht das Ziel darin, den ursprünglichen Sprecher über alle Sprachen hinweg zu erhalten. Unser Voice Cloning unterstützt 33 Sprachen, und unser Dienst AI Dubbing synchronisiert Inhalte aus über 60 Ausgangssprachen in 33 Zielsprachen.
4. Wie viel emotionale Kontrolle benötigen Sie? Ein Klon erfindet keine Emotion, die er nie gehört hat. Wenn der Ausgangsclip flach ist, ist die Ausgabe tendenziell flach, weshalb wir empfehlen, die Emotion und den Sprechstil aufzunehmen, die Sie reproduziert haben möchten. Standardstimmen lassen sich leichter über mehrere Tonlagen hinweg testen, wenn Sie an einem Tag einen ruhigen Erklärbeitrag und am nächsten eine energiegeladene Anzeige benötigen. Egal, wozu Sie tendieren, testen Sie beide mit demselben Skript und achten Sie auf die Aussprache von Namen und Fachbegriffen, den Satzrhythmus, die emotionale Glaubwürdigkeit, die Betonung und die Konsistenz über lange Passagen hinweg.
5. Wie schnell benötigen Sie den ersten Entwurf? Standard-TTS hat den kürzesten Weg vom Skript zum Audio, weil die Stimme bereit ist. Cloning fügt einen Vorbereitungsschritt hinzu und wird dann für die wiederkehrende Produktion effizient. Für eine einmalige Deadline beginnen Sie mit Standard-TTS; für ein fortlaufendes Content-System investieren Sie in einen Klon, wenn die Identität dauerhaften Wert hat.
6. Wer kontrolliert die Identität des Sprechers? Cloning erfordert Governance. Klonen Sie eine Stimme nur, wenn Sie die Erlaubnis des Sprechers und das Recht haben, die Aufnahme und die Ausgabe für den beabsichtigten Zweck zu verwenden. Führen Sie eine Dokumentation darüber, wessen Stimme aufgenommen wurde, was autorisiert wurde, wo die Stimme verwendet werden darf, ob kommerzielle und werbliche Nutzung gestattet ist und wie die Stimme deaktiviert werden soll, wenn die Autorisierung endet. Dies ist besonders wichtig für Agenturen und Entwickler, die Inhalte für Kunden produzieren, und eine Stimme, die wie eine echte Person klingt, kann das Publikum in die Irre führen, wenn synthetische Sprachausgabe nie offengelegt wird.
Was verschiedene Kreative wählen sollten
Derselbe Kompromiss fällt je nachdem, was Sie produzieren, unterschiedlich aus.
YouTube-Kreative: Klonen Sie Ihre Stimme, wenn der Kanal um Ihre Persönlichkeit aufgebaut ist, damit Intros, Korrekturen, Shorts und mehrsprachige Versionen wiedererkennbar bleiben. Greifen Sie zu Standard-TTS bei gesichtslosen Kanälen, Nischen-Experimenten oder Formaten, die unterschiedliche Charakterstimmen benötigen.
Kleine Unternehmen und Marketingteams: Beginnen Sie mit Standard-TTS für Produktvideos, Social-Media-Anzeigen, Sales Enablement und interne Entwürfe, weil es schnell und einfach für A/B-Tests zu Tonfall und Tempo ist. Wechseln Sie zu einer geklonten Gründer- oder Markenstimme, wenn derselbe Sprecher über Kampagnen und Kundenschulungen hinweg auftritt.
E-Learning- und Unternehmensschulungsteams: Verwenden Sie Standard-TTS für modulare Inhalte, die sich häufig ändern oder mehrere Lehrstimmen benötigen. Verwenden Sie eine geklonte Stimme, wenn Lernende Kontinuität von einem Dozenten über eine große Bibliothek hinweg erwarten, damit separate Module wie ein einziger Kurs wirken.
Filmemacher und Podcast-Ersteller: Klonen Sie, wenn die Erhaltung der Identität eines Moderators oder einer Figur wesentlich ist; unser AI-Dubbing-Workflow ist darauf ausgelegt, die Stimme jedes Sprechers für die mehrsprachige Lokalisierung zu klonen. Verwenden Sie Standard-TTS für Scratch-Tracks, Vorschauen, Nebenrollen oder frühe Schnitte vor dem endgültigen Casting.
Entwickler und Agenturen: Wählen Sie eine Standard-Text-to-Speech-API, wenn Ihre App eine Auswahl an Stimmen und schnelles Prototyping ohne Einbindung von Sprechern benötigt. Wählen Sie eine Voice-Cloning-API, wenn Ihr Produkt autorisierte, maßgeschneiderte Stimmen benötigt, die aus Audioproben erstellt werden.
Wann die Nutzung beider die klügere Wahl ist
Standard-TTS und Voice Cloning schließen sich nicht gegenseitig aus, und die stärksten Produktionssysteme kombinieren sie gezielt.
Ein realistisches Setup könnte eine geklonte Moderatorenstimme für die Haupterzählung auf YouTube mit Standardstimmen für Nebenfiguren kombinieren. Ein Kurs könnte eine geklonte Dozentenstimme für Kernlektionen und Standardstimmen für Rollenspiel-Dialoge verwenden. Ein Team könnte frühe Skripte in Standard-TTS entwerfen und dann die endgültige genehmigte Version in einem Klon erzeugen. Für die Lokalisierung bewahren geklonte Stimmen den Erzähler über alle Sprachen hinweg, während regionale Standardstimmen einspringen, wenn ein lokaler Erzähler besser passt.
Dieser hybride Ansatz bewahrt kreative Flexibilität dort, wo Geschwindigkeit zählt, und schützt die Identität dort, wo Wiedererkennung zählt, ohne einen einzigen Kompromiss über das gesamte Projekt zu erzwingen.
Die eine Regel, die die meisten Entscheidungen klärt
Wenn die Kriterien ausgewogen erscheinen, bricht diese Regel das Patt:
Wenn der Sprecher Teil des Produkts ist, wählen Sie eine geklonte Stimme. Wenn die Sprache das Produkt ist, wählen Sie eine Standard-TTS-Stimme.
Der Sprecher ist Teil des Produkts, wenn seine Identität Vertrauen, Wiedererkennung oder Kontinuität aufbaut: Kreative, Dozenten, Gründer, Moderatoren und fiktive Charaktere. Die Sprache ist das Produkt, wenn die Priorität auf klarer, kostengünstiger, schnell editierbarer Sprachausgabe liegt: Erklärvideos, Produktupdates, interne Schulungen, Prototypen und Variationen in großem Umfang.
Die meisten ersten Projekte starten besser mit Standard-TTS, weil es sofort verfügbar und leicht zu ändern ist. Steigen Sie auf eine geklonte Stimme um, sobald der Klang des Erzählers zu einem echten Vermögenswert in Ihrer Marke, Ihrem Kanal, Ihrem Kurs oder Ihren lokalisierten Inhalten wird. Für Teams, die sowohl Geschwindigkeit als auch Kontinuität benötigen, bewältigt unsere Standardbibliothek flexible Sprachausgabe, während unsere Voice-Cloning- und Dubbing-Tools die autorisierte, mehrsprachige Konsistenz übernehmen.
Häufig gestellte Fragen
Ist eine geklonte Stimme besser als eine Standard-TTS-Stimme?
Nicht grundsätzlich. Eine geklonte Stimme gewinnt bei Identität und Konsistenz; eine Standard-TTS-Stimme gewinnt bei Geschwindigkeit, Vielfalt und einer Produktion mit geringer Verpflichtung. Die richtige Wahl hängt davon ab, ob die Identität des Sprechers für dieses Projekt wichtig ist.
Wie viel Audio wird benötigt, um eine Stimme mit DubSmart zu klonen?
Die Mindestprobe beträgt 20 Sekunden. Für bessere Qualität empfehlen wir eine saubere Aufnahme ohne Hintergrundgeräusche sowie eine Probe, die die Emotion und den Stil enthält, die Sie reproduziert haben möchten.
Kann eine geklonte Stimme eine andere Sprache sprechen?
Ja. Unser Voice Cloning unterstützt 33 Sprachen, und unser AI-Dubbing-Dienst synchronisiert Inhalte aus über 60 Ausgangssprachen in 33 Zielsprachen, während die Identität des ursprünglichen Sprechers erhalten bleibt.
Kann ich eine geklonte Stimme für AI Dubbing verwenden?
Ja. Eine geklonte Stimme kann sowohl in Text-to-Speech als auch in AI Dubbing verwendet werden, und unser Dubbing-Tool kann außerdem die Stimme jedes Sprechers während der mehrsprachigen Lokalisierung automatisch klonen.
Was ist der sicherste Weg, Voice Cloning zu nutzen?
Klonen Sie nur einen autorisierten Sprecher, dokumentieren Sie die erlaubte Nutzung, schützen Sie das Ausgangsaudio, überprüfen Sie jede erzeugte Ausgabe und legen Sie synthetische Sprachausgabe überall dort offen, wo Ihre Plattform, Ihr Kunde oder geltende Vorschriften dies erfordern.