Die Aufbereitung von Inhalten für eine neue Zielgruppe erfordert selten zweimal dieselbe Sprachtechnologie. Genau deshalb stellt sich immer wieder die Frage nach KI-Synchronisation oder Stimmenklonen bei der Wiederverwendung von Inhalten. Hier ist die kurze Antwort, die wir Kreativen und Teams jede Woche geben: KI-Synchronisation lokalisiert bereits vorhandene Inhalte, während Stimmenklonen die Identität eines bestimmten Sprechers bewahrt, wenn neue oder übersetzte Sprache erzeugt wird. Das eine ist ein Workflow zur Lokalisierung. Das andere ist eine Technologie zur Bewahrung der Stimmidentität. Beide überschneiden sich so häufig, dass in der Praxis oft beide Technologien gemeinsam eingesetzt werden.
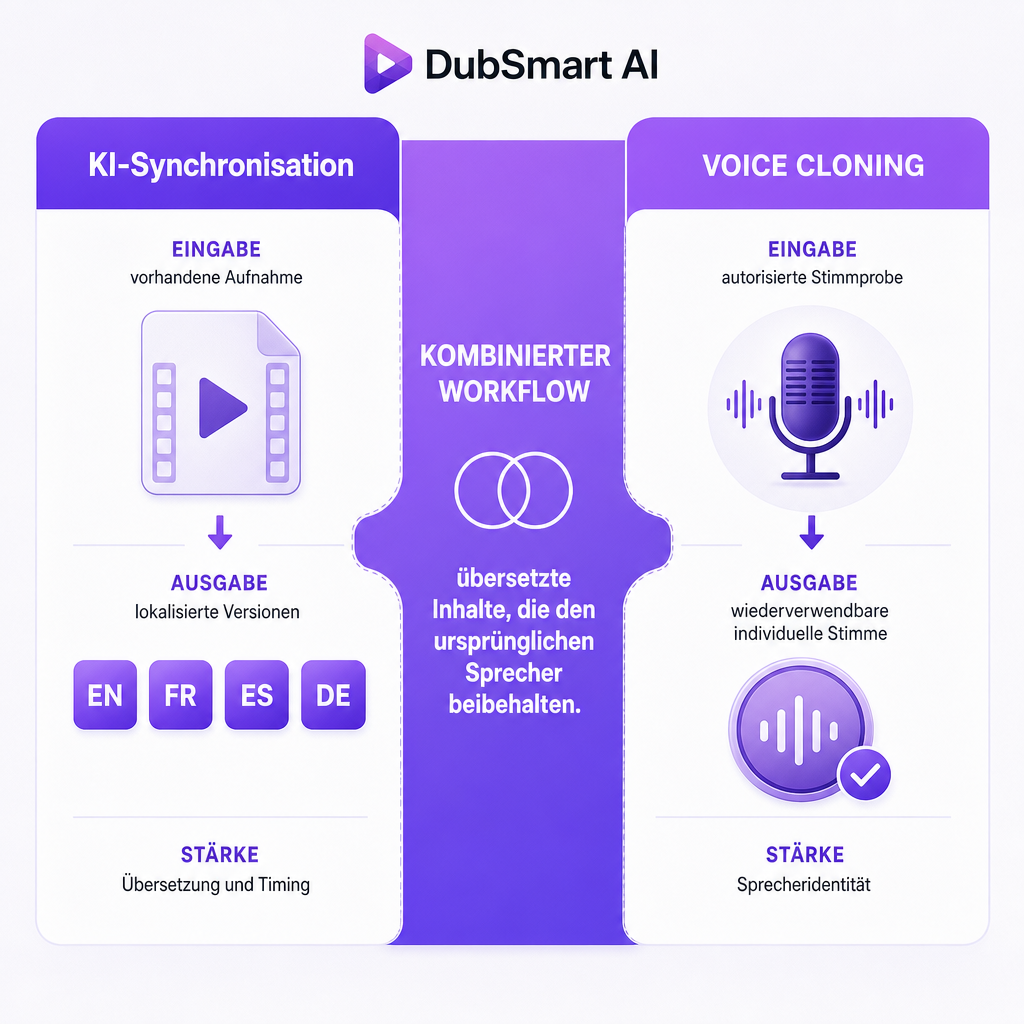
KI-Synchronisation lokalisiert bereits vorhandene Inhalte. Stimmenklonen bewahrt die Identität des Sprechers bei der Erzeugung neuer oder übersetzter Sprache.
Diese Unterscheidung bestimmt nahezu alles, was danach kommt: Ihren Zeitplan, Ihren Prüfprozess, die Dokumentation Ihrer Nutzungsrechte und die Entscheidung zwischen einem browserbasierten Studio und einer API. Im Folgenden erklären wir beide Technologien, zeigen ihre Überschneidungen und stellen Ihnen eine Entscheidungshilfe vor, die Sie direkt bei Ihrem nächsten Projekt zur Wiederverwendung von Inhalten anwenden können.
Inhaltsverzeichnis
Der wesentliche Unterschied auf einen Blick
Abseits aller Marketingversprechen beantworten die beiden Technologien unterschiedliche Fragen. Bei der KI-Synchronisation lautet die Frage: Wie mache ich diese vorhandene Aufnahme in einer anderen Sprache verständlich? Beim Stimmenklonen lautet sie: Wie lasse ich neue Sprachaufnahmen so klingen wie diesen Sprecher, dessen Einwilligung vorliegt? Die folgende Tabelle verdeutlicht diese Unterschiede, bevor wir näher auf die Details eingehen.
| KI-Synchronisation | Stimmenklonen |
|---|---|
| Wandelt vorhandene gesprochene Inhalte in eine andere Sprache oder eine lokalisierte Version um | Erzeugt neue synthetische Sprache, die wie ein bestimmter Sprecher klingt |
| Ausgangspunkt ist ein Video, eine Audiodatei oder eine Originalaufnahme | Ausgangspunkt ist eine autorisierte Stimmprobe |
| Kombiniert Transkription, Übersetzung, Sprachgenerierung, zeitliche Anpassung und Austausch der Tonspur | Kombiniert Stimmanalyse, Modellerstellung und Text-zu-Sprache-Generierung |
| Ideal für mehrsprachige Versionen vorhandener Inhalte | Ideal, um die Identität eines Sprechers über neue Skripte und Formate hinweg beizubehalten |
| Kann Sprechern während der Synchronisation Stimmen zuweisen oder deren Stimmen klonen | Erzeugt eine wiederverwendbare individuelle Stimme für TTS- oder Synchronisationsprojekte |
Die Überschneidung in der letzten Zeile ist der Grund für viele Missverständnisse. Eine geklonte Stimme kann innerhalb eines Synchronisationsworkflows eingesetzt werden. Das Stimmenklonen ist damit eine mögliche Komponente der Synchronisation und keine konkurrierende Alternative. Wenn Sie einen umfassenden Vergleich hinsichtlich Kosten, Geschwindigkeit und Compliance suchen, behandelt unser Artikel KI-Synchronisation im Vergleich zur menschlichen Synchronisation auch den Personalaufwand bei dieser Entscheidung.
Was KI-Synchronisation tatsächlich leistet
KI-Synchronisation ist mehr als die bloße Umwandlung eines Transkripts in gesprochene Sprache. Sie muss eine vorhandene Aufnahme verstehen und eine neue Sprachfassung erzeugen, die zur ursprünglichen Szene passt. Ein typischer Workflow umfasst mehrere aufeinanderfolgende Schritte: Spracherkennung zur Erfassung der Aussagen jedes Sprechers, Sprechererkennung oder -trennung zur Unterscheidung der Stimmen und Isolierung der Dialoge von Hintergrundgeräuschen, maschinelle Übersetzung des Transkripts, Sprachsynthese in der Zielsprache, zeitliche Anpassung der neuen Dialoge an den Schnitt sowie eine Tonmischung, die Sprache, Musik und Umgebungsgeräusche aufeinander abstimmt. Das Klonen der Originalstimme ist ein optionaler zusätzlicher Schritt und keine Voraussetzung.
Stellen Sie sich einen Content-Creator aus den USA vor, der ein englischsprachiges Produkttutorial erstellt hat und nun spanische, französische und deutsche Versionen veröffentlichen möchte. Das Ziel ist kein neues Skript. Vielmehr sollen Bedeutung, Struktur und Timing des Originalvideos erhalten bleiben, während neue Zielgruppen erschlossen werden. In unserem KI-Synchronisationsworkflow können Sie ein Video oder eine Audiodatei hochladen oder einen YouTube-Link verwenden. Anschließend lassen sich Sprecher, Texte, Zeitmarken und Audio vor dem Download bearbeiten. Die Synchronisation wird aus mehr als 60 Ausgangssprachen in 33 Zielsprachen unterstützt. Während des Prozesses kann jedem Sprecher eine geklonte Stimme zugewiesen werden.
Wenn es bei Ihrem Projekt hauptsächlich um Übersetzung und eine schnelle Veröffentlichung geht, sollten Sie mit dieser Technologie beginnen. Den gesamten Produktionsablauf erklären wir in unserem Leitfaden So ändern Sie die gesprochene Sprache in einem Video. Betreiber mehrsprachiger Kanäle finden außerdem in unserem Artikel So erstellen Sie einen mehrsprachigen YouTube-Kanal einen umfassenderen Überblick.
Was Stimmenklonen tatsächlich leistet
Beim Stimmenklonen wird aus Aufnahmen eines echten Sprechers ein synthetisches Stimmmodell erstellt. Das Modell analysiert Aussprache, Sprechrhythmus, Tonhöhe, Intonation, Stimmklang, Pausenmuster und Ausdrucksstil. Anschließend erzeugt es aus Text neue Sprachaufnahmen, die dem ursprünglichen Sprecher ähneln, ohne dass dieser jede einzelne Zeile selbst aufnehmen muss. Mit unserer Voice-Cloning-Funktion können Sie eine mindestens 20 Sekunden lange, möglichst störungsfreie Audioaufnahme hochladen, um eine Stimme zu klonen. Stimmenklonen ist in 33 Sprachen verfügbar.
Ein Detail ist wichtiger, als viele erwarten: Der emotionale Ausdruck Ihrer Stimmprobe beeinflusst das Ergebnis. Eine monotone Aufnahme führt tendenziell zu einer wenig ausdrucksstarken Sprachausgabe, während eine lebendige Aufnahme dem Modell mehr stilistische Informationen liefert. Wählen Sie deshalb eine Stimmprobe, die zur gewünschten Sprechweise passt, und nicht einfach nur die technisch sauberste Datei, die Ihnen zur Verfügung steht.
Eine geklonte Stimme ist besonders wertvoll, wenn derselbe Sprecher in vielen verschiedenen Inhalten konsistent klingen soll. Beispiele sind Kanal-Intros und Updates, mehrsprachige Kurskommentare, Podcast-Korrekturen, Produkterklärungen, Audio-Newsletter, Marketingvarianten und per API generierte App-Inhalte. Da diese Stimme auch innerhalb des Synchronisationsworkflows eingesetzt werden kann, fungiert das Stimmenklonen als Baustein der Synchronisation und nicht als konkurrierende Technologie. Einen umfassenderen Überblick über die Möglichkeiten individueller Stimmen finden Sie in unserem Artikel über die besten Einsatzmöglichkeiten von KI-Stimmenklonen für Content-Creator.
Wie beide Technologien zusammenarbeiten
Nehmen wir einen Content-Creator, der bereits ein 20-minütiges englischsprachiges Lernvideo veröffentlicht hat. Ein Synchronisationsworkflow transkribiert das Video, identifiziert die Sprecher, übersetzt das Transkript, erzeugt Sprache in der Zielsprache, passt anschließend das Timing an und mischt die neuen Dialoge mit der ursprünglichen Hintergrundtonspur. Wenn der Creator möchte, dass seine Stimmidentität auch in der übersetzten Version erhalten bleibt, integriert das System eine geklonte Stimme in die Sprachgenerierung. Derselbe Workflow, nur mit einer zusätzlichen Komponente.
Am einfachsten lässt sich der Unterschied anhand der Fragen verstehen, die beide Technologien beantworten:
- KI-Synchronisation beantwortet die Frage: Wie mache ich diese vorhandenen Inhalte in einer anderen Sprache verständlich?
- Stimmenklonen beantwortet die Frage: Wie lasse ich neue Sprachaufnahmen so klingen wie diesen Sprecher, dessen Einwilligung vorliegt?
- Der kombinierte Workflow beantwortet die Frage: Wie lokalisiere ich diese Inhalte und bewahre gleichzeitig die wiedererkennbare Stimme des Moderators?
Unsere geklonten Stimmen sind sowohl für Text-to-Speech als auch für KI-Synchronisation ausgelegt. Dadurch ist der kombinierte Ansatz eine praktische Standardlösung und kein umständlicher Behelf. Genau darin liegt der Nutzen der Wiederverwendbarkeit: eine autorisierte Stimme, viele Einsatzmöglichkeiten.
Welche Technologie zu Ihrem Projekt passt
Die richtige Wahl hängt davon ab, was sich tatsächlich ändern soll: die Sprache, das Skript, die Identität des Sprechers oder alle drei. Die folgende Übersicht ordnet typische Projekte zur Wiederverwendung von Inhalten der jeweils besser geeigneten Technologie zu.
| Anforderung bei der Wiederverwendung | Besser geeignet | Begründung |
|---|---|---|
| Ein vorhandenes Video ins Spanische übersetzen | KI-Synchronisation | Originalaufnahme und Timing sind bereits vorhanden |
| Denselben Moderator in mehreren Sprachen veröffentlichen | Synchronisation mit Stimmenklonen | Sowohl die Lokalisierung als auch die Kontinuität der Sprecheridentität sind wichtig |
| Zehn neue Videos aus dem Skript eines Moderators erstellen | Stimmenklonen | Sie benötigen neue Sprachaufnahmen und keine übersetzte Originalaufnahme |
| Einen Satz in einem veröffentlichten Podcast ersetzen | Stimmenklonen | Eine individuelle Stimme ermöglicht eine passende Ergänzung ohne erneute Aufnahme |
| Einen Kurs mit mehreren Dozenten lokalisieren | Synchronisation, gegebenenfalls mit mehreren geklonten Stimmen | Der Workflow verwaltet Ausgangsmaterial, Sprecher, Übersetzung und Timing |
| Gesprochene Antworten mit Markenidentität in einer App generieren | Voice-Cloning-API oder TTS-API | Im Mittelpunkt steht die programmgesteuerte Sprachgenerierung |
| Einen Film, ein Interview oder eine Podiumsdiskussion synchronisieren | KI-Synchronisation | Mehrere Sprecher, das Timing der Dialoge und die Tonmischung stehen im Mittelpunkt |
| Neutrale Sprechertexte in vielen Sprachen produzieren | Synchronisation oder mehrsprachiges TTS | Eine wiedererkennbare Originalstimme ist möglicherweise nicht erforderlich |
Entscheiden Sie sich für KI-Synchronisation, wenn der vorhandene Inhalt im Mittelpunkt steht: Sie haben bereits ein fertiges Video oder einen Podcast, bestehende Dialoge, die übersetzt werden sollen, mehrere Sprecher, eine Hintergrundtonspur, die erhalten bleiben muss, und einen Veröffentlichungsplan für mehrere Sprachen. Besonders hilfreich ist diese Technologie, wenn Sie die Nachfrage in einem neuen Markt testen möchten, ohne ein komplett neues Video zu produzieren.
Entscheiden Sie sich für Stimmenklonen, wenn die Identität des Sprechers im Mittelpunkt steht: etwa die Stimme eines Unternehmensgründers in verschiedenen Produktvideos, eines Dozenten bei der Aktualisierung von Lektionen oder eines Podcasters bei der Korrektur eines sachlichen Fehlers. Weitere Anwendungsfälle sind lokalisierte Intros und Outros sowie die skalierbare Erstellung personalisierter Audioinhalte. Stimmenklonen reduziert den Aufnahmeaufwand, ersetzt aber keine redaktionelle Qualitätskontrolle. Ein Modell kann die stimmlichen Eigenschaften einer Person reproduzieren und trotzdem einen Namen falsch aussprechen, den Kontext verfehlen oder eine unpassende Emotion vermitteln.
Qualitätskriterien für professionelle Ergebnisse
Ein fundierter Vergleich geht über die Frage hinaus, ob das Ergebnis „realistisch klingt“. Bei der Wiederverwendung von Inhalten für professionelle Zwecke entscheiden sechs Kriterien darüber, ob ein Ergebnis brauchbar oder peinlich ist.
Bedeutung und Übersetzungsgenauigkeit. Eine flüssig klingende Stimme kann eine fehlerhafte Übersetzung nicht retten. Prüfen Sie Produktnamen, Fachbegriffe, Zahlen und Maßeinheiten, Handlungsaufforderungen, rechtliche und sicherheitsrelevante Formulierungen, Redewendungen, Humor und regionale Bezüge besonders sorgfältig. Eine wörtliche Übersetzung kann grammatikalisch korrekt und für kommerzielle Zwecke trotzdem völlig ungeeignet sein. Marketing- und Schulungsinhalte erfordern in der Regel eine kulturelle und sprachliche Anpassung statt einer Wort-für-Wort-Übersetzung.
Konsistenz der Sprecherstimme. Entscheiden Sie, ob dieselbe Person in Originalfassungen und lokalisierten Versionen, über mehrere Episoden hinweg, in Kampagnenmaterialien, Kurzvideos und zukünftigen Updates identisch klingen soll. Wenn ja, bietet Stimmenklonen einen Mehrwert. Wenn Sie lediglich eine klare lokalisierte Erzählstimme benötigen, reicht häufig eine vorgefertigte synthetische Stimme aus.
Timing und Bearbeitbarkeit. Übersetzte Sprache hat selten genau dieselbe Länge wie der ursprüngliche Satz. Ein praxistaugliches Synchronisationstool muss Redakteuren ermöglichen, das Timing einzelner Segmente, die Sprechgeschwindigkeit, den Text, neu generierte Abschnitte und die Lautstärke des Hintergrundtons anzupassen. Unser Dubbing Studio bietet genau diese Funktionen: Texte und Zeitmarken bearbeiten, Sprechgeschwindigkeit ändern, einzelne Segmente neu generieren und Hintergrundgeräusche anpassen.
Emotionaler Ausdruck. Stimmidentität und emotionaler Ausdruck sind zwei unterschiedliche Herausforderungen. Eine geklonte Stimme kann dem Originalsprecher ähneln und dennoch Dringlichkeit, Humor, Empathie, Autorität, Spannung oder Begeisterung nicht überzeugend vermitteln. Verwenden Sie eine Stimmprobe, die die gewünschte Sprechweise demonstriert. Eine ruhige Aufnahme eignet sich für einen Kurs, eine energiegeladene Aufnahme für ein Video zur Produkteinführung.
Lippensynchronität und visuelle Abstimmung. Bei Videos mit Moderatoren oder dargestellten Figuren muss die übersetzte Tonspur zur sichtbaren Darbietung passen: Mundbewegungen, Pausen, Szenenwechsel, zeitliche Abstimmung von Reaktionen, Untertitel und Sprecherwechsel. Bei einer Erzählstimme aus dem Off sind kleinere Synchronisationsabweichungen tolerierbar, bei Dialogen in Nahaufnahme dagegen nicht.
Produktionsgeschwindigkeit und Skalierbarkeit. KI zahlt sich besonders dann aus, wenn die Anzahl der Inhalte und Sprachen steigt. Vergleichen Sie deshalb den gesamten Arbeitsaufwand und nicht nur die reine Generierungszeit. Wie viele Sprachen und Sprecher sind beteiligt? Wie häufig werden die Inhalte aktualisiert? Kann das Team einen einzelnen Satz neu generieren, ohne das gesamte Projekt neu erstellen zu müssen? Wird eine API benötigt, und lässt sich dieselbe Stimme unter Einhaltung der entsprechenden Nutzungsrechte wiederverwenden? Wir bieten separate Produkte für KI-Synchronisation, die Voice-Cloning-API, die Text-to-Speech-API und die AI-Dubbing-API an. Prüfen Sie vor der Entwicklung die jeweiligen Produktseiten auf aktuelle Informationen zu Authentifizierung, Ein- und Ausgabeformaten, Ratenbegrenzungen und Tarifdetails.
Rechte, Kennzeichnungspflichten und Governance: Was Sie beachten müssen
Aufgrund der hohen Geschwindigkeit übersieht man leicht den notwendigen Papierkram. Genau dadurch können Projekte in Schwierigkeiten geraten. Klonen Sie eine Stimme nur dann, wenn Sie über die Einwilligung des Sprechers und die erforderlichen Rechte für den vorgesehenen Verwendungszweck, die Sprachen, die Vertriebskanäle, die Nutzungsdauer und die geografischen Gebiete verfügen. Die Erlaubnis, eine Person aufzunehmen, ist nicht gleichbedeutend mit der Erlaubnis, eine wiederverwendbare synthetische Kopie ihrer Stimme zu erstellen. Dokumentieren Sie bei geschäftlicher Nutzung die Identität des Stimmrechteinhabers, die erlaubten Nutzungsarten, Vertriebskanäle, geografischen Gebiete, Vertragslaufzeit, Vergütungsbedingungen, die Zulässigkeit einer Verwendung in Werbung, die mögliche Nutzung des Modells über eine API sowie die Verfahren zur Löschung oder zum Widerruf. Einwilligung und verantwortungsvoller Einsatz sind grundlegende Bestandteile unseres Ansatzes beim Stimmenklonen. Die Sicherung der erforderlichen Rechte an Ihren Materialien und Stimmproben liegt jedoch weiterhin in Ihrer Verantwortung.
Behandeln Sie hochgeladene Aufnahmen als sensible Daten. Stimmproben können biometrische und personenbezogene Informationen enthalten. Beschränken Sie daher den Zugriff auf Quelldateien, laden Sie niemals Material hoch, für dessen Nutzung Sie keine Berechtigung haben, und prüfen Sie, wie der jeweilige Anbieter Stimmdaten speichert, verarbeitet und löscht. Das NIST weist auf die Risiken synthetischer Stimmen hin, da geklonte Audioaufnahmen Identitätsmissbrauch und Betrug ermöglichen können. Seine Empfehlungen betonen die Prüfung der Einwilligung und den Umgang mit Risiken im Zusammenhang mit synthetischen Inhalten.
Die Regeln der Plattformen bilden eine weitere Ebene. YouTube verlangt derzeit in bestimmten Fällen, dass Creator realistische KI-generierte oder wesentlich veränderte Inhalte kennzeichnen. Aus den eigenen Beispielen der Plattform geht hervor, dass das Klonen der eigenen Stimme für Voiceovers oder Synchronfassungen nach diesem Beispiel keine Kennzeichnung erfordert. Realistische synthetische Inhalte, die Zuschauer irreführen könnten, können dagegen kennzeichnungspflichtig sein. Richtlinien ändern sich. Prüfen Sie deshalb vor jeder Veröffentlichung die aktuellen Regeln der Zielplattform. Denken Sie außerdem daran, dass eine Kennzeichnung niemals die erforderlichen Urheberrechte, Persönlichkeitsrechte, Markenfreigaben oder die Einhaltung werberechtlicher Vorschriften ersetzt. Die entsprechenden YouTube-Richtlinien finden Sie im Hilfeartikel zur Kennzeichnung.
Behalten Sie schließlich immer eine menschliche Qualitätskontrolle bei. Prüfen Sie alle lokalisierten Inhalte auf Übersetzungsfehler, falsche Namen, fehlerhaft ausgesprochene Markennamen, unzutreffende Zahlen, kulturell unangemessene Formulierungen, unnatürliche Pausen, uneinheitliche Terminologie, Stimmartefakte, Audioübersteuerungen und falsch zugeordnete Sprecher. Ziehen Sie bei regulierten, sicherheitskritischen, politischen, medizinischen oder juristischen Inhalten qualifizierte Prüfer und entsprechende Fachexperten hinzu.
Wie DubSmart beide Technologien vereint
Wir vereinen KI-Synchronisation, Stimmenklonen, Text-to-Speech, Speech-to-Text, Speech Separator und weitere Medienwerkzeuge auf einer Plattform. Dadurch müssen Content-Creator und kleine Teams Dateien nicht ständig zwischen verschiedenen Anwendungen für Transkription, Übersetzung, Sprachgenerierung und Bearbeitung hin- und herschieben. Laut unseren öffentlich zugänglichen Produktseiten unterstützt die KI-Synchronisation die Übersetzung aus mehr als 60 Sprachen in 33 Zielsprachen. Sie kann geklonte Sprecherstimmen verwenden und bietet Funktionen zur Projektbearbeitung. Für das Stimmenklonen reichen mindestens 20 Sekunden sauberes Audiomaterial aus. Geklonte Stimmen können sowohl für Text-to-Speech als auch für KI-Synchronisation eingesetzt werden. Darüber hinaus stehen die Voice-Cloning-API und die AI-Dubbing-API als separate Entwicklerprodukte zur Verfügung.
Für kleinere Projekte reicht der browserbasierte Workflow in der Regel aus. Agenturen, Plattformbetreiber und Entwicklungsteams sollten vor der Entscheidung für eine automatisierte Integration die API-Dokumentation, Nutzungslimits, Datenverarbeitung, kommerziellen Nutzungsrechte, Fehlerbehandlung sowie die aktuellen Guthaben- und Tarifbedingungen prüfen. Sie sind unsicher, welche Technologie für Ihr nächstes Projekt zur Wiederverwendung von Inhalten geeignet ist? Teilen Sie uns das Ausgangsformat, die Zielsprachen, die Anzahl der Sprecher und die Häufigkeit geplanter Aktualisierungen mit. Wir helfen Ihnen dabei, die passende Lösung zu finden.
Häufig gestellte Fragen
Ist KI-Synchronisation dasselbe wie Stimmenklonen?
Nein. KI-Synchronisation lokalisiert vorhandene gesprochene Inhalte durch die Kombination von Transkription, Übersetzung, Sprachgenerierung, zeitlicher Anpassung und Tonmischung. Stimmenklonen erstellt aus einer autorisierten Stimmprobe eine wiederverwendbare synthetische Stimme. Stimmenklonen kann innerhalb eines Synchronisationsworkflows eingesetzt werden, aber die beiden Technologien sind nicht austauschbar.
Ist Stimmenklonen für YouTube besser als KI-Synchronisation?
Das hängt vom Ziel ab. Verwenden Sie KI-Synchronisation, um vorhandene Videos in neue Sprachen zu übersetzen. Nutzen Sie Stimmenklonen, wenn Sie die Stimme desselben Moderators für neue Skripte, Korrekturen oder lokalisierte Intros benötigen. Für das Wachstum eines mehrsprachigen Kanals ist die Kombination beider Technologien häufig die beste Lösung.
Kann ich KI-Synchronisation verwenden, ohne meine Stimme zu klonen?
Ja. Ein Synchronisationsworkflow kann statt einer geklonten Originalstimme eine vorgefertigte synthetische Stimme oder eine andere freigegebene Stimme verwenden. Das Klonen ist optional, wenn die Identität des Sprechers für den jeweiligen Inhalt nicht entscheidend ist.
Wie viel Audiomaterial wird benötigt, um mit DubSmart eine Stimme zu klonen?
Laut unserer Voice-Cloning-Produktseite können Sie eine Audiodatei mit einer Länge von mindestens 20 Sekunden hochladen. Wir empfehlen Aufnahmen ohne Hintergrundgeräusche. Außerdem beeinflusst der Sprechstil Ihrer Stimmprobe die emotionale Qualität der generierten Stimme.
Muss KI-generierte Synchronisation auf YouTube gekennzeichnet werden?
In manchen Fällen. Nach den aktuellen YouTube-Richtlinien müssen realistische KI-generierte oder wesentlich veränderte Inhalte in bestimmten Fällen gekennzeichnet werden. Das Klonen der eigenen Stimme für Voiceovers oder Synchronfassungen wird als Beispiel genannt, bei dem keine Kennzeichnung erforderlich ist. Für andere realistische synthetische Inhalte kann dagegen eine Kennzeichnungspflicht bestehen. Prüfen Sie vor der Veröffentlichung die jeweils aktuellen Richtlinien.