Früher bedeutete das Ändern der gesprochenen Sprache in einem Video, dass Sprecher neu aufgenommen, ein Studio gebucht und neuer Ton per Hand mit dem Bild zusammengefügt werden mussten. Mit DubSmart AI läuft das Erlernen, wie man die Stimmsprache in einem Video ändert, auf einen einzigen Arbeitsablauf hinaus: Datei hochladen, eine Zielsprache und Stimme wählen, die KI die Synchronisation erstellen lassen und das lokalisierte Ergebnis herunterladen. Unsere KI-Synchronisation übersetzt aus über 60 Ausgangssprachen in 33 Zielsprachen, sodass ein Video zu einem mehrsprachigen Asset werden kann, ohne das Tool zu wechseln. Für die meisten kurzen Clips von fünf bis fünfzehn Minuten schaffen Sie den Weg vom Hochladen bis zum Download in deutlich weniger als einer Stunde, Vorschauen und kleine Bearbeitungen inklusive, mit unseren guthabenbasierten Plänen, die mit einer kostenlosen Stufe beginnen.
Inhaltsverzeichnis
Was Sie erhalten, wie lange es dauert und ungefähre Kosten
Das Ergebnis ist eine natürlich klingende Sprachspur in Ihrer gewählten Sprache, abgestimmt auf Ihre Bilder, die das Original ersetzt oder überlagert. Derselbe Arbeitsablauf funktioniert für YouTube-Videos, Marketing-Clips, E-Learning-Module und Filminhalte, sodass Sie nicht für jedes Format einen neuen Prozess aufbauen müssen.
Die Zeit skaliert mit der Laufzeit und dem Umfang der Feinabstimmung. Ein ordentliches Video von fünf bis fünfzehn Minuten durchläuft in der Regel den gesamten Ablauf, vom Hochladen über die Vorschau bis zum Download, in unter einer Stunde. Längere Dateien und aufwändige Bearbeitung mit mehreren Sprechern erhöhen die Zeit hauptsächlich in der Überprüfungsphase, nicht beim Rendern.
Die Kosten basieren auf Guthaben statt auf Studio-Sätzen pro Minute. Guthaben deckt die Nutzung von KI-Synchronisation und Text-to-Speech ab, und wir bieten eine kostenlose Stufe, kostenpflichtige Pläne und Enterprise-Optionen an. Als grobe Orientierung, wie Guthaben zur Laufzeit passt: Eine Stufe listet 2.000 Guthaben als ausreichend für etwa zwei Minuten KI-Synchronisation und Text-to-Speech-Audio auf, was Ihnen ein Gefühl dafür gibt, wie Sie ein längeres Projekt budgetieren können.
Voraussetzungen: Ihre Checkliste vor dem Start
Ein paar Minuten Vorbereitung verhindern die meiste Nacharbeit. Arbeiten Sie das durch, bevor Sie das Tool öffnen:
- Inhaltsrechte bestätigen. Stellen Sie sicher, dass Sie das rechtliche Recht haben, das Video zu übersetzen, zu synchronisieren und weiterzuverbreiten, einschließlich Musik, Sprachdarbietungen und aller lizenzierten Materialien.
- Ein sauberes Ausgangsvideo vorbereiten. Klare Sprache, die nicht unter Musik oder Rauschen begraben ist, ermöglicht der KI eine bessere Transkription und ein natürlicheres Timing.
- Entscheiden Sie sich für Ihr Sprachpaar. Bestimmen Sie die Ausgangssprache (zum Beispiel Englisch) und die Zielsprache, die Sie in der neuen Sprachspur haben möchten (Spanisch, Portugiesisch, Hindi und so weiter). Mit über 60 Ausgangssprachen und 33 Zielsprachen sind die meisten beliebten Paare abgedeckt.
- Richten Sie Ihr Konto und Guthaben ein. Melden Sie sich an und stellen Sie sicher, dass Sie genügend Guthaben für die geplante Länge der Synchronisation haben.
- Halten Sie die Datei bereit. Sie können einen YouTube-Link einfügen oder eine Audio- oder Videodatei direkt von Ihrem Gerät hochladen.
- Optional: Bereiten Sie eine Stimmprobe vor. Wenn Sie Ihre eigene Stimme oder die eines Moderators sprachübergreifend beibehalten möchten, nehmen Sie 20 bis 60 Sekunden saubere Sprache mit minimalem Hintergrundgeräusch in einem unterstützten Format wie MP3, WAV, AAC, M4A oder FLAC auf.
Wenn Sie unsicher sind, ob Ihr Ausgangston sauber genug ist, ist unser Speech to Text-Tool eine schnelle Möglichkeit, zu überprüfen, wie gut die Originalspur transkribiert wird, bevor Sie Guthaben für eine vollständige Synchronisation einsetzen.
Schritt für Schritt: Die Stimmsprache ändern
Der folgende Arbeitsablauf deckt eine standardmäßige Änderung in eine einzelne Sprache vom Hochladen bis zur Veröffentlichung ab.
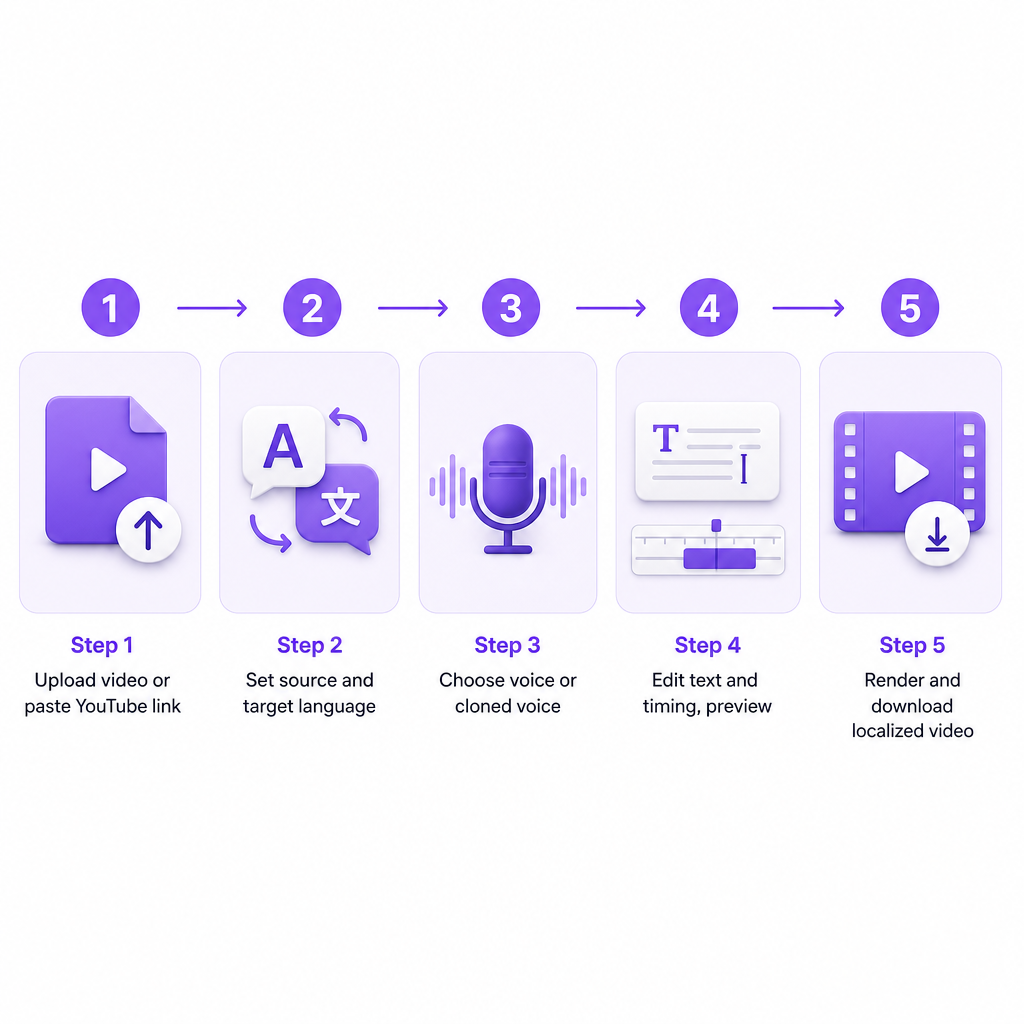
- Öffnen Sie AI Dubbing. Melden Sie sich an und wählen Sie dann im Dashboard AI Dubbing. Unsere einheitliche Oberfläche ermöglicht es Ihnen, jeweils ein Tool auszuwählen, und der AI-Dubbing-Arbeitsbereich ist speziell für das Übersetzen und Synchronisieren von Videos in mehrere Sprachen konzipiert.
- Laden Sie Ihre Quelle hoch oder fügen Sie einen Link ein. Fügen Sie eine YouTube-URL ein, wenn der Inhalt dort liegt, oder laden Sie eine Audio- oder Videodatei von Ihrem Gerät hoch. Längere Dateien benötigen mehr Zeit für die Verarbeitung, während die Pipeline den Inhalt für die Transkription vorbereitet.
- Ausgangs- und Zielsprache festlegen. Bestätigen Sie die erkannte Ausgangssprache und wählen Sie dann die Zielsprache, die Sie in der endgültigen Spur hören möchten, etwa Englisch zu Spanisch oder Hindi zu Englisch. Wählen Sie das Paar, das zu Ihrem Publikum passt.
- Wählen Sie eine Stimme und einen Stil. Wählen Sie eine Stimme aus unserer Bibliothek natürlich klingender KI-Stimmen und passen Sie, wo Optionen vorhanden sind, Geschlecht, Ton und Stil an: professionell für Unternehmensschulungen, freundlich für YouTube, neutral für E-Learning. Wenn Sie eine geklonte Stimme haben, wählen Sie diese hier aus.
- Konfigurieren Sie Sprecher, Text und Timing. Fügen Sie für Interviews oder Videos mit mehreren Moderatoren Sprecher hinzu und weisen Sie jedem Stimmen zu. Überprüfen Sie den transkribierten und übersetzten Text auf Richtigkeit, korrigieren Sie Namen und Fachbegriffe und passen Sie dann die Segment-Timings an, damit die Zeilen zu Szenenschnitten und Bildschirmtexten passen.
- Vorschau der Synchronisation. Erstellen Sie eine Vorschau und hören Sie sich die wichtigsten Teile an: das Intro, Handlungsaufforderungen und emotionale Szenen. Wenn eine Zeile gehetzt, flach oder leicht asynchron wirkt, kehren Sie zum Text- und Timing-Editor zurück, passen Sie sie an und generieren Sie sie neu.
- Rendern und herunterladen. Wenn die Vorschau überzeugt, rendern Sie das gesamte Projekt. Die KI wandelt den übersetzten Text in Sprache um und erstellt die vollständige Sprachspur, synchronisiert mit Ihren Bildern. Wählen Sie Ihr Ausgabeformat, nur Audio oder vollständig gemischtes Video, und laden Sie es dann herunter und speichern es.
- Überprüfen und veröffentlichen. Machen Sie einen abschließenden Durchgang zur Sprachgenauigkeit, insbesondere bei Fachbegriffen und Markennamen, bestätigen Sie, dass der Ton zum Zweck passt, und prüfen Sie, dass die Audiopegel konsistent sind und nicht übersteuern, bevor Sie auf Ihre Plattformen hochladen.
Wenn Sie die Mechanik dahinter verstehen möchten, wie übersetztes Audio erzeugt und an die Originaldarbietung angepasst wird, erklärt unser Beitrag über Speech-to-Speech-Synchronisation, was zwischen Hochladen und Rendern passiert.
Behalten Sie Ihre eigene Stimme in jeder Sprache
Die Sprache zu ändern muss nicht bedeuten, den Sprecher zu wechseln. Mit Voice Cloning können Sie eine Moderatoren-, Dozenten- oder Markenstimme in jeder Zielsprache beibehalten.
Beginnen Sie damit, eine saubere Probe von 20 bis 60 Sekunden für die Person aufzunehmen, die Sie klonen möchten, wobei Sie Musik, überlappende Sprecher, Echo und Hintergrundgeräusche vermeiden, und speichern Sie sie in einem unterstützten Format wie MP3, WAV, AAC, M4A oder FLAC. Laden Sie dieses Audio hoch, um ein benanntes benutzerdefiniertes Stimmprofil zu erstellen, das dann sowohl in Text-to-Speech- als auch in AI-Dubbing-Projekten verfügbar wird. Wählen Sie in Ihrem Synchronisationsprojekt einfach diese geklonte Stimme als Synchronisationsstimme für die Zielsprache aus.
Dies ist besonders nützlich für YouTube-Kanäle, E-Learning-Serien und Markeninhalte, bei denen die Stimme Teil der Marke ist und Sie von Region zu Region dieselbe Identität wünschen. Teams, die dies in großem Maßstab automatisieren möchten, können es mit unserer Voice Cloning API in ihre eigenen Anwendungen einbinden.
Häufige Fehler und Fehlerbehebung
| Problem | Warum es passiert | Was zu tun ist |
|---|---|---|
| Transkriptionsfehler, ungewöhnliches Tempo | Laute Musik, überlappende Sprecher oder starkes Rauschen in der Quelle | Verwenden Sie eine sauberere Audioversion oder trennen Sie die Sprache vom Hintergrund, bevor Sie synchronisieren |
| Übersetzung wirkt falsch oder überspringt Teile | Gemischte Sprachen in einer Spur verwirren die automatische Erkennung | Legen Sie die richtige Ausgangssprache manuell fest und synchronisieren Sie Sprachsegmente separat |
| Stimme nicht synchron mit dem Bild | Übersetzte Zeilen ändern ihre Länge; manche Sprachen benötigen mehr Wörter | Passen Sie Segment-Timing und Pausen an und straffen Sie lange Zeilen, damit sie in den Rhythmus passen |
| Ton passt nicht zum Inhalt | Die gewählte Stimme oder der Stil passt zu einem anderen Zweck | Probieren Sie andere Stimmen aus, bis der emotionale Ton passt, und verwenden Sie dann eine geklonte Stimme für Konsistenz wieder |
| Inkonsistente Begriffe oder Markennamen | Allgemeine Übersetzung verfehlt fachspezifisches Vokabular | Bearbeiten Sie Schlüsselbegriffe in den Textsegmenten und führen Sie ein einfaches Glossar über mehrere Videos hinweg |
Wenn Hintergrundton die eigentliche Ursache ist, lohnt sich das vorherige Bereinigen der Spur. Unser Speech Separator isoliert gesprochenen Dialog von Musik und Rauschen und gibt der Synchronisations-Engine ein klareres Signal zum Arbeiten.
Selbst machen oder abgeben
Für die meisten YouTube-Kanäle, Marketingkampagnen und internen Schulungen ist der Selbermach-Weg mit AI Dubbing und Voice Cloning schnell, wiederholbar und kosteneffektiv. Unser integriertes Toolset und der automatisierte Arbeitsablauf sind darauf ausgelegt, dass einzelne Kreative, kleine Unternehmen und schlanke Teams die Lokalisierung selbst durchführen können.
Manche Projekte rechtfertigen mehr praktische Unterstützung. Erwägen Sie professionelle Hilfe, wenn Sie langformatige episodische Inhalte haben, bei denen Lippensynchronisation und Darstellungsregie entscheidend sind, hochriskante Unternehmens- oder regulierte Schulungen in Bereichen wie Gesundheitswesen oder Finanzen, die rechtliche Prüfung und strikte Terminologiekontrolle erfordern, oder mehrsprachige Veröffentlichungen, bei denen Sie Untertitel, Synchronisation, Barrierefreiheitsspuren und regionsspezifische Anforderungen koordinieren müssen.
Eine praktische Faustregel: Wenn Sie weniger als ein Dutzend Videos pro Quartal veröffentlichen und hauptsächlich online verbreiten, reichen die Selbermach-Tools in der Regel aus. Wenn Sie eine mehrsprachige Veröffentlichung einer Show, eines Spielfilms oder eines regulierten Schulungslehrplans planen, lohnt es sich, Casting, Regie und dediziertes QA in den Prozess einzubeziehen. Wenn Sie einen ganzen lokalisierten Kanal statt eines einzelnen Clips aufbauen, zeigt unser Leitfaden zum Erstellen eines mehrsprachigen YouTube-Kanals die umfassendere Strategie auf.
Häufig gestellte Fragen
In welche Sprachen kann ich die Stimme meines Videos ändern?
Mit AI Dubbing können Sie Videos aus über 60 Ausgangssprachen in 33 Zielsprachen synchronisieren und dabei die wichtigsten globalen Sprachen abdecken, auf die sich Kreative und Unternehmen verlassen.
Kann ich DubSmart speziell für YouTube-Videos verwenden?
Ja. Sie können einen YouTube-Link direkt einfügen oder Videodateien von Ihrem Gerät in das AI-Dubbing-Tool hochladen, was Kreativen entgegenkommt, die ein mehrsprachiges Publikum erschließen möchten.
Kann ich meine eigene Stimme in anderen Sprachen behalten?
Ja. Voice Cloning erstellt eine benutzerdefinierte KI-Stimme aus einer kurzen, sauberen Probe, und Sie können diese Stimme in Text-to-Speech und AI Dubbing wiederverwenden, sodass Ihre Stimmidentität sprachübergreifend konsistent bleibt.
Was ist, wenn mein Video mehrere Sprecher hat?
Im AI-Dubbing-Editor können Sie Sprecher hinzufügen, verschiedene Stimmen zuweisen und Segment-Timing sowie Text bearbeiten, was Interviews und Podiumsdiskussionen abdeckt.
Wie werden die Kosten für das Ändern der Stimmsprache berechnet?
Die Kosten basieren auf dem von AI Dubbing und Text-to-Speech verbrauchten Guthaben. Als Referenz: Eine Stufe listet 2.000 Guthaben als ausreichend für etwa zwei Minuten Audio auf, wobei eine kostenlose Stufe und Enterprise-Pläne für unterschiedliche Nutzungsstufen verfügbar sind.