Ein sauberes Transkript aus einem 30-minütigen Podcast oder Schulungsvideo ist mit DubSmart AI in unter 10 Minuten realistisch, und die meisten Creator erledigen es für zwischen 0 $ und etwa 20–50 $ pro Monat, abhängig vom Volumen. Wenn Sie wissen möchten, wie Sie Audio in Text transkribieren, ohne eine separate Transkriptions-App, einen Rauschfilter und einen Untertitel-Editor zusammenzuflicken, erledigt unsere Speech-to-Text-Engine die gesamte Aufgabe in einem Arbeitsbereich: Medien hochladen, Text mit einer Genauigkeit von über 95 % bei klarem Audio generieren, Sprecherkennzeichnungen und Zeichensetzung bearbeiten und dann ein Transkript oder Untertitel exportieren, die bereit zur Veröffentlichung sind.
Der eigentliche Vorteil liegt hier nicht nur in der Geschwindigkeit. Da sich Transkription, Audiobereinigung, Synchronisation und Voiceover denselben Credit-Pool teilen, kann dasselbe Transkript, das Sie heute erstellen, später für AI Dubbing in 33 Zielsprachen oder Text to Speech mit über 300 Stimmen genutzt werden. Das ist wichtig, wenn Sie einen YouTube-Kanal betreiben, E-Learning-Kurse erstellen oder Unternehmensschulungen lokalisieren.
Inhaltsverzeichnis
Was Sie vor dem Start benötigen
Die Transkriptionsqualität entscheidet sich, bevor Sie eine einzige Taste drücken. Gehen Sie zunächst diese Checkliste durch:
- Ein DubSmart-Konto mit Zugriff auf Speech to Text und Speech Separator im Free-, Starter- oder einem höheren Tarif.
- Ihre Quelldateien bereit: Podcast-Episoden, Webinare, Interviews oder ein YouTube-Link.
- Rechte und Genehmigung zur Transkription des Inhalts, was besonders bei Kundenaufträgen und Aufnahmen Dritter wichtig ist.
- Ein klares Ziel für die Ausgabe: ein vollständiges Transkript (DOC/TXT), Untertitel (SRT/VTT) oder ein Skript für Synchronisation und Voiceover.
- Grundlegende Fakten über die Aufnahme: Quellsprache, Anzahl der Sprecher und ob es Musik oder starke Hintergrundgeräusche gibt.
- Für regulierte Teams: Ihre internen Richtlinien zum Umgang mit personenbezogenen oder sensiblen Daten in Cloud-Tools.
Wenn Sie Ihr Ausgabeformat von vornherein kennen, sparen Sie sich einen Umweg. Ein Auftrag für Blog-Shownotes benötigt reinen Text; ein YouTube-Upload benötigt zeitgesteuerte Untertitel; ein Lokalisierungsauftrag benötigt ein sauberes Skript, das Sie direkt in die Synchronisation übernehmen können.
Schritt für Schritt: Audio mit DubSmart in Text transkribieren
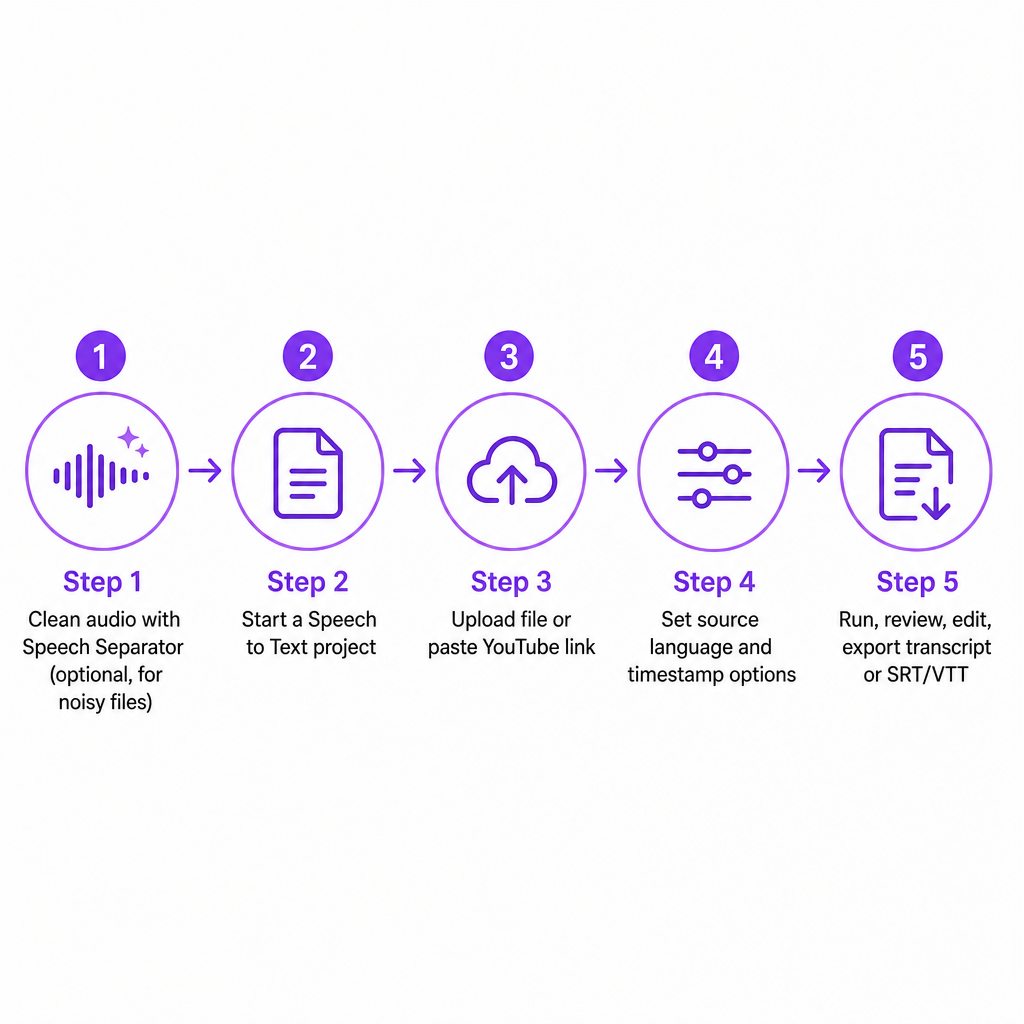
1. Wählen Sie die richtigen Tools für die Aufnahme
Speech to Text wandelt gesprochenes Audio in geschriebenen Text um und arbeitet bei verrauschten Aufnahmen mit dem Speech Separator zusammen. Credits werden über AI Dubbing, Text to Speech, Voice Cloning, Speech to Text und Speech Separator hinweg geteilt, sodass jede verarbeitete Minute aus demselben Pool schöpft.
Die Entscheidung ist einfach. Wenn die Aufnahme Musik, Menschenmengen-Geräusche oder Raumhall enthält, beginnen Sie mit dem Speech Separator, um die Stimmen zu isolieren. Wenn das Audio bereits sauber ist, springen Sie direkt zur Transkription.
2. Bereinigen Sie das Audio mit dem Speech Separator (empfohlen)
Hochwertiges Eingangsmaterial ist der wichtigste Faktor für eine genaue automatisierte Transkription, besonders bei Podcasts, Interviews und Diskussionsrunden mit mehreren Sprechern. Der Speech Separator isoliert Sprache von Musik und Hintergrundgeräuschen in gängigen Formaten wie MP3, WAV und AAC und hinterlässt eine saubere Stimmspur.
- Öffnen Sie das Speech-Separator-Tool in Ihrem Konto.
- Laden Sie Ihr Audio oder Video von Ihrem Gerät hoch oder wählen Sie es aus Ihren Projekten aus.
- Lassen Sie die KI Stimme und Hintergrund trennen; das dauert je nach Länge meist von Sekunden bis Minuten.
- Speichern Sie die saubere Stimmdatei in Ihrer Projektbibliothek.
Mit dieser bereinigten Spur produziert die Transkriptionsphase weniger Fehler und benötigt weniger manuelle Korrektur.
3. Starten Sie ein neues Speech-to-Text-Projekt
Der Ablauf ist bewusst kurz gehalten: Funktion auswählen, Medien hochladen, bearbeiten, exportieren.
- Melden Sie sich an und öffnen Sie das Dashboard des Arbeitsbereichs.
- Wählen Sie Speech to Text aus der Tool-Liste.
- Erstellen Sie ein neues Projekt und geben Sie ihm einen beschreibenden Namen, wie „Produkt-Webinar – Oktober".
Das Benennen von Projekten hält Transkripte organisiert und macht sie leicht wiederverwendbar für Untertitelung, Synchronisation oder Text-to-Speech später.
4. Laden Sie Ihr Audio oder Video hoch
Sie können Dateien direkt hochladen oder von einer YouTube-URL abrufen, was für Creator und Agenturen praktisch ist, die Kundenkanäle verwalten.
- Laden Sie Audio oder Video von Ihrem Gerät in Standardformaten wie MP3, WAV und MP4 hoch.
- Fügen Sie eine YouTube-URL ein, um das Video direkt in das Projekt zu holen, einschließlich 1080p-Uploads, wo unterstützt.
DubSmart analysiert dann die Datei, extrahiert das Audio und bereitet es für die Erkennung vor.
5. Legen Sie die Sprache und die Erkennungsoptionen fest
Speech to Text unterstützt über 60 Sprachen, darunter Englisch, Spanisch, Deutsch, Hindi, Türkisch, Portugiesisch, Japanisch, Russisch, Chinesisch und Arabisch. Die Einstellung der korrekten Quellsprache ist kein optionales Detail; die Engine stützt sich auf sprachspezifische Modelle, um Sprache in Text zu decodieren.
- Wählen Sie die Quellsprache, die zur Aufnahme passt. Bei mehrsprachigen Inhalten beginnen Sie mit der dominierenden Sprache.
- Wenn es mehrere Sprecher gibt, planen Sie, während der Bearbeitung Sprecherkennzeichnungen hinzuzufügen.
- Bestätigen Sie die Zeitstempel- und Segmentierungsoptionen, wenn Sie SRT- oder VTT-Untertitel statt eines reinen Transkripts exportieren möchten.
Bei den meisten Dateien mit einem einzelnen Sprecher läuft die Erkennung in Echtzeit oder schneller, sodass die Verarbeitung oft innerhalb der Länge der Aufnahme abgeschlossen ist.
6. Führen Sie die Transkription durch
Starten Sie den Prozess und lassen Sie die Engine arbeiten. Sie segmentiert das Audio, identifiziert Phoneme und Wörter und wendet Sprachmodelle an, um Text zu erzeugen. Bei klarem Audio erreicht die Genauigkeit über 95 %, was Ihren Korrekturaufwand erheblich reduziert. Während es läuft, bereiten Sie ein kurzes Glossar mit Namen, Marken oder Fachbegriffen vor, von denen Sie bereits wissen, dass Sie sie standardisieren müssen.
7. Überprüfen und bearbeiten Sie das Transkript
Die automatisierte Ausgabe ist schnell, aber Text in professioneller Qualität benötigt dennoch einen menschlichen Durchgang, besonders bei Namen, Akronymen und Fachjargon. Bearbeiten Sie direkt im Projekt-Editor:
- Lesen Sie durch und hören Sie dabei wichtige Abschnitte, um falsch verstandene Wörter zu erkennen.
- Fügen Sie Sprecherkennzeichnungen wie Moderator, Gast oder Dozent hinzu, damit der Dialog leicht zu verfolgen ist.
- Korrigieren Sie Zeichensetzung und Groß-/Kleinschreibung, die sich sowohl auf die Lesbarkeit als auch auf das Timing der Untertitel auswirken.
- Standardisieren Sie die Terminologie, wie Produktnamen, medizinische Begriffe oder juristische Formulierungen, anhand Ihres Marken- oder Compliance-Glossars.
Da dasselbe Transkript später AI Dubbing in über 33 Sprachen und Text to Speech mit über 300 Stimmen speisen kann, zahlt sich eine sorgfältige Bearbeitung jetzt jedes Mal aus, wenn Sie den Inhalt wiederverwenden.
8. Exportieren Sie Text oder Untertitel
Wenn die Bearbeitungen stimmig aussehen, exportieren Sie in dem Format, das Ihr Anwendungsfall benötigt:
- Untertitel (SRT oder VTT) für YouTube, LMS-Plattformen und Unternehmens-Videoportale.
- Reiner Text (TXT) oder Dokumentformate für Blogs, Shownotes, Schulungshandbücher und Besprechungsprotokolle.
Wählen Sie das Format und laden Sie dann das fertige Projekt herunter oder speichern Sie es. Damit ist der Kern-Workflow abgeschlossen, wie Sie Audio in DubSmart in Text transkribieren.
Zeit und Kosten: Was Sie erwartet
DubSmart läuft über ein kreditbasiertes System, das für AI Dubbing, Text to Speech, Voice Cloning, Speech to Text und Speech Separator gilt. Credits sind austauschbar, sodass ein Pool Transkriptionsminuten, Audiobereinigung und Synchronisation abdeckt. Aus unseren veröffentlichten Preisen:
| Tarif | Monatspreis | Monatliche Credits | Hinweise |
|---|---|---|---|
| Free | 0 $ | 2.000 | Etwa 2 Minuten AI Dubbing/TTS, um den Workflow zu testen |
| Starter | ~20 $ | 50.000 | Etwa 50 Minuten AI Dubbing/TTS; ungenutzte Credits werden übertragen |
| Standard | ~50 $ | 150.000 | Höheres Volumen mit niedrigeren Kosten pro 1.000 Credits |
Da sich Credits über Transkription, Stimmbereinigung und Synchronisation erstrecken, können Sie die gesamte Pipeline als ein einziges Budget behandeln statt als separate Tools. Für die meisten Creator bedeutet das, Dutzende kurzer Videos pro Monat zum Starter-Tarif zu transkribieren und gleichzeitig Credit-Kapazität für Synchronisation und Voiceover frei zu halten.
Häufige Fehler und wie Sie sie beheben
Verrauschtes Audio ohne Bereinigung verwenden. Hintergrundmusik, Menschenmengen-Geräusche oder Hall verursachen Fehlerkennungen und zusätzliche Bearbeitung. Lassen Sie die Datei zuerst durch den Speech Separator laufen und transkribieren Sie dann die isolierte Stimmspur für höhere Genauigkeit und saubereres Untertitel-Timing.
Die falsche Quellsprache auswählen. Wenn Sie sie auf Englisch belassen, obwohl das Audio Spanisch ist, interpretiert die Engine Phoneme falsch und produziert unbrauchbaren Text. Überprüfen Sie die Sprache doppelt, bevor Sie beginnen, und segmentieren Sie bei mehrsprachigen Videos nach Sprache oder priorisieren Sie die Hauptsprache für den ersten Durchgang.
Sprecherkennzeichnungen ignorieren. Podcasts und Diskussionsrunden mit mehreren Sprechern sind ohne Zuordnung schwer zu lesen. Fügen Sie während der Bearbeitung Kennzeichnungen wie Moderator, Gast 1 oder namensbasierte Tags hinzu und halten Sie sie über Episoden hinweg konsistent.
Menschliche Überprüfung bei kritischen Inhalten überspringen. Bei rechtlichem, medizinischem oder compliance-sensiblem Material kann ein kleiner Fehler die Bedeutung verändern. Behandeln Sie das automatisierte Transkript als ersten Entwurf und führen Sie eine vollständige menschliche Validierung durch, kombiniert mit internen Prüfern oder externen Compliance-Prüfungen, wo nötig.
Credits falsch einschätzen. Einen großen Rückkatalog zu bearbeiten, ohne die Nutzung zu verstehen, kann Ihr Kontingent erschöpfen. Prüfen Sie zuerst die monatlichen Credits und die Übertragungsrichtlinie Ihres Tarifs und führen Sie dann eine kleine Pilot-Charge durch, um die Minuten pro Credit über Speech Separator und Speech to Text zu messen, bevor Sie sich auf Massenarbeit festlegen.
DIY vs. professionelle Hilfe: Wo die Grenze liegt
DubSmart ist für die Selbstbedienung durch Creator, kleine Unternehmen, E-Learning-Teams und Agenturen konzipiert, die skalierbare mehrsprachige Inhalte wollen, ohne mit Anbietern jonglieren zu müssen. Browserbasierte Tools, ein kostenloser Tarif und ein geteiltes Credit-Modell ermöglichen es den meisten Nutzern, Transkription, Bereinigung und Synchronisation selbst zu erledigen.
Selbstbedienung ist in der Regel ausreichend, wenn:
- Sie episodische Inhalte wie Podcasts, YouTube-Videos, Produktdemos oder interne Schulungen transkribieren.
- Das Audio einigermaßen sauber ist oder mit dem Speech Separator verbessert werden kann.
- Die Genauigkeit hoch sein muss, aber nicht rechtsverbindlich ist, wie bei Barrierefreiheits-Untertiteln, Kursmaterialien oder Marketing-Unterlagen.
- Ihr monatliches Volumen in Ihre verfügbaren Credits passt, mit Spielraum für Synchronisation oder Voiceover.
Tendieren Sie zu professioneller Unterstützung oder Unterstützung auf Unternehmensebene, wenn:
- Sie große Kataloge verwalten, Hunderte von Stunden, die konsistente QA, Stil und Terminologie über Regionen hinweg benötigen.
- Ihre Inhalte strengen rechtlichen oder regulatorischen Standards unterliegen, wie Gerichtsverfahren, medizinische Dokumentation oder Finanzoffenlegungen.
- Sie unsere AI Dubbing API oder Text-to-Speech-API in komplexe Workflows mit Verfügbarkeits- und Durchsatzanforderungen für Kunden integrieren müssen.
In diesen Fällen bietet die Kombination unserer Automatisierung mit professioneller sprachlicher oder Compliance-Prüfung das beste Gleichgewicht aus Geschwindigkeit, Kosten und Risiko. Für die meisten alltäglichen Transkriptionen ist der Selbstbedienungsweg schneller und günstiger, und er hält Ihr Transkript bereit, um zu Untertiteln, Synchronisationen oder Voiceovern zu werden, wann immer Sie sie benötigen.
Häufig gestellte Fragen
Welche Arten von Inhalten kann DubSmart transkribieren?
Speech to Text bewältigt Podcasts, YouTube-Videos, Webinare, Interviews, Filme und Unternehmensschulungen, solange das Audio über Upload oder einen Link verfügbar ist.
Welche Sprachen werden für die Transkription unterstützt?
Speech to Text unterstützt über 60 Sprachen, darunter Englisch, Spanisch, Deutsch, Hindi, Türkisch, Portugiesisch, Japanisch, Russisch, Chinesisch und Arabisch, und dieselbe Plattform synchronisiert in 33 Zielsprachen.
Wie genau ist DubSmarts Speech to Text?
Bei klarem Audio mit korrekt ausgewählter Sprache erreicht die Genauigkeit über 95 %, im Einklang mit moderner automatischer Spracherkennung.
Wie viel kostet die Transkription mit DubSmart?
Die Preise beginnen bei 0 $/Monat mit einem kostenlosen Tarif von 2.000 Credits. Kostenpflichtige Tarife wie Starter (etwa 20 $/Monat) und Standard (etwa 50 $/Monat) fügen Credits hinzu und senken die Kosten pro Credit, und Credits werden über Transkription, Synchronisation und verwandte Tools hinweg geteilt.
Kann ich das Transkript für Synchronisation und Voiceover verwenden?
Ja. Die Speech-to-Text-Ausgabe kann direkt in AI Dubbing und Text to Speech einfließen, um mehrsprachige synchronisierte Versionen und KI-Voiceover mit über 300 natürlich klingenden Stimmen zu erstellen.