Normalerweise können Sie Hintergrundmusik aus einer Aufnahme in nur wenigen Minuten reduzieren oder entfernen, und die vollständige Antwort auf die Frage, wie man Hintergrundmusik aus Audio entfernt, läuft auf eine einzige Werkzeugwahl hinaus: einen KI-Sprachtrenner, der abschätzt, welche Klänge zur Stimme und welche zur Musik gehören, und sie dann in separate Spuren aufteilt. Die Ergebnisse sind am besten, wenn die Stimme klar ist und die Musik leise darunter liegt. Wenn sich Lied und Sprache auf denselben Frequenzen stark überlagern, bleiben einige Artefakte zurück. Auf unserer Plattform ist der Sprachtrenner mit 100 Credits pro Minute gelistet, und die kostenlose Stufe umfasst 2.000 Credits – bei diesem Tarif etwa 20 Minuten Trennung. Preise und Pläne können sich ändern, prüfen Sie daher unsere aktuellen Preise, bevor Sie einen längeren Auftrag beginnen.
Inhaltsverzeichnis
Was Sie vor dem Start benötigen
Die Trennung geht schneller und sauberer, wenn vorab einige Dinge geregelt sind. Keines davon ist optional, wenn Ihnen das Endergebnis wichtig ist.
- Die Quelldatei. Der Sprachtrenner unterstützt gängige Formate wie MP3, WAV und AAC und akzeptiert auch Videodateien.
- Eine unangetastete Sicherungskopie. Bewahren Sie die Originaldatei genau so auf, wie sie ist. Jede der folgenden Lösungen setzt voraus, dass Sie darauf zurückgreifen können.
- Genügend Credits für die Dauer. Bei 100 Credits pro Minute kostet ein fünfminütiger Clip etwa 500 Credits. Planen Sie für ein oder zwei erneute Verarbeitungen ein.
- Kopfhörer oder Monitore. Laptop-Lautsprecher verbergen die wässrigen, metallischen Artefakte, die eine Trennung einführen kann.
- Das Recht, die Aufnahme zu bearbeiten. Das Entfernen von Musik aus einer Datei ist ein technischer Schritt, kein lizenzrechtlicher. Diese Unterscheidung behandeln wir am Ende.
Musik Schritt für Schritt von der Stimme trennen
Der Mechanismus ist hier entscheidend: Ein Sprachtrenner „dreht die Musik nicht leiser". Er baut eine reine Sprachspur neu auf, indem er vorhersagt, welche Teile des Signals Sprache sind. Deshalb klingen sanfte Einstellungen oft natürlicher als aggressive.
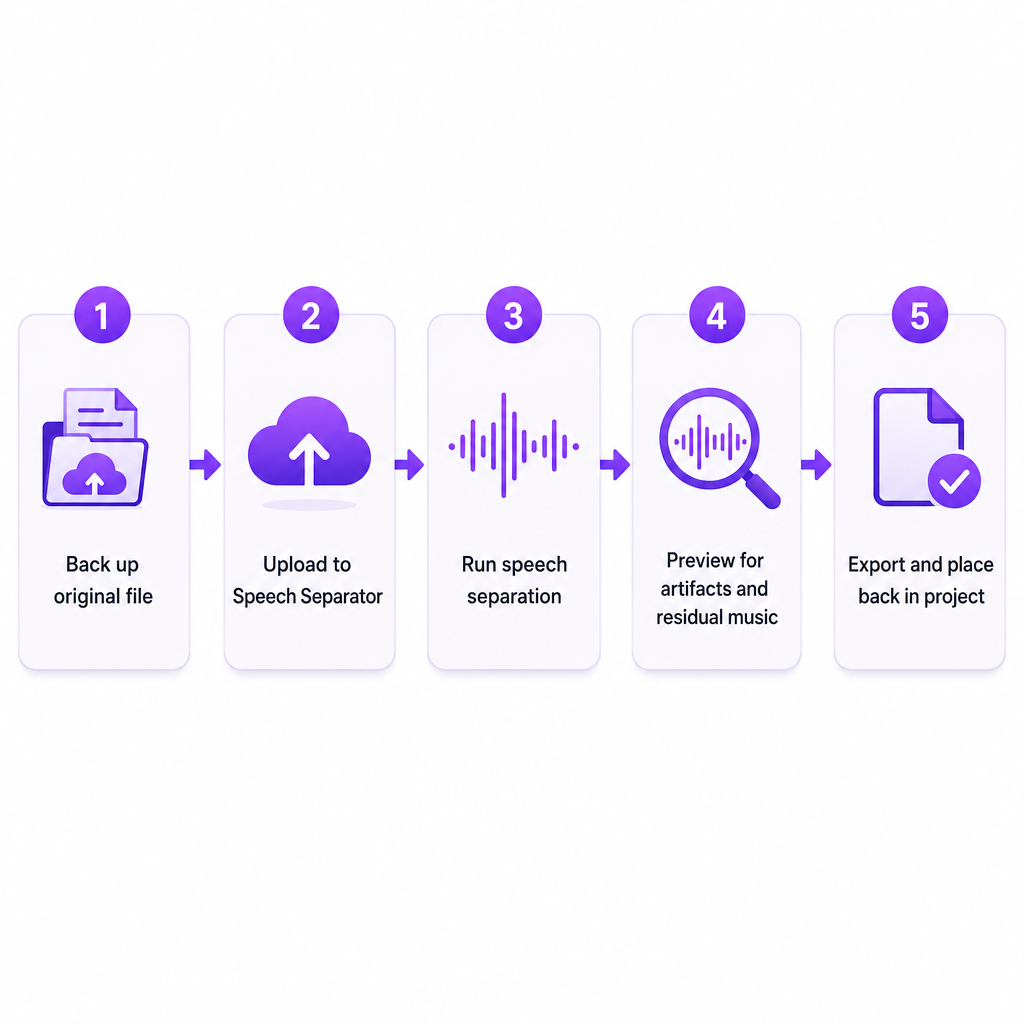
- Öffnen Sie den Sprachtrenner. Das Werkzeug ist darauf ausgelegt, klare Gesangs- bzw. Stimmanteile aus einer Audio- oder Videodatei zu extrahieren.
- Laden Sie Ihre Aufnahme hoch. Verweisen Sie auf die Quelldatei, nicht auf eine neu exportierte Kopie. Wenn Sie ein Arbeitsformat wählen können, bewahrt WAV mehr Details für spätere Bearbeitungen, während Sie das Original als Sicherung behalten.
- Wählen Sie die Option zur Sprachtrennung. Das Ziel ist, die Stimme von der Musik zu isolieren, nicht alles lauter zu machen. Lauter ist nicht sauberer.
- Führen Sie die Trennung durch. Die Verarbeitungszeit variiert je nach Dateilänge und aktueller Auslastung. Geben Sie einem kurzen Clip ein paar Minuten und beurteilen Sie dann den Export, statt anzunehmen, dass der erste Durchlauf endgültig ist.
- Hören Sie die Vorschau sorgfältig ab. Achten Sie auf fehlende Konsonanten, einen dünnen oder metallischen Klang und Musik, die noch unter der Stimme summt. Prüfen Sie den Anfang, das Ende und die Abschnitte mit der lautesten Musik, denn diese versagen zuerst.
- Passen Sie an oder verarbeiten Sie erneut, wenn die Stimme beschädigt ist. Wenn eine Stärke- oder Modusoption verfügbar ist, bewahrt eine weniger aggressive Einstellung meist natürlichere Sprache, selbst wenn eine Spur Musik übrig bleibt. Dieser Kompromiss ist oft der richtige.
- Prüfen Sie vor dem Export im Kontext. Wenn Sie ein Video bereinigen, setzen Sie die verarbeitete Sprachspur zurück in das Projekt und überprüfen Sie Synchronität und Lautstärke gegen das Bild.
Unsere Sprachtrenner-Seite beschreibt das Hochladen von Audio oder Video und das Extrahieren von Stimmen, veröffentlicht aber keine garantierte Verarbeitungszeit oder ein einzelnes festes Exportformat. Bestätigen Sie diese Details im Werkzeug, bevor Sie jemandem eine Frist zusagen. Wenn Sie verstehen möchten, was unter der Haube passiert, führt Sie unsere Erläuterung dazu, wie KI-Sprachtrennung funktioniert, durch die Deep-Learning-Pipeline, die dies möglich macht.
Wenn das Ergebnis nicht sauber ist: Lösungen, die wirklich helfen
Die meisten enttäuschenden Exporte haben eine Handvoll vorhersehbarer Ursachen. Ordnen Sie das Symptom der Lösung zu, bevor Sie blind erneut verarbeiten.
- Musik sitzt noch unter der Sprache. Die Trennung ist am schwierigsten, wenn Musik und Stimme Frequenzen teilen oder wenn das Lied laut ist. Testen Sie zuerst einen ruhigeren Abschnitt oder erhöhen Sie die Trennstärke, falls das Werkzeug eine anbietet.
- Die Stimme klingt dünn, verzerrt oder metallisch. Das Modell entfernt möglicherweise Teile der Stimme, die musikalischen Tönen ähneln. Wechseln Sie zu einer sanfteren Einstellung oder einer besseren Quelldatei und vermeiden Sie das erneute Verarbeiten einer bereits getrennten Spur – das stapelt Artefakte.
- Einige Wörter verschwinden. Sprache, die unter lauter Musik vergraben ist, kehrt möglicherweise nicht sauber zurück. Vergleichen Sie mit dem Original, und wenn Genauigkeit entscheidend ist, stellen Sie diese Passage aus einer anderen Aufnahme wieder her oder nehmen Sie sie neu auf.
- Die Datei lässt sich nicht hochladen. Bestätigen Sie, dass Format und Größe akzeptiert werden, und versuchen Sie dann ein unterstütztes Format wie MP3, WAV oder AAC.
- Sie müssen nur einen YouTube-Musikanspruch beseitigen. Bei einem berechtigten Anspruch bietet YouTube Studio Optionen wie Song löschen oder Song ersetzen. Das sind Plattform-Lösungen für beanspruchte Inhalte, keine Garantie, dass sich jede Spur perfekt trennt.
Eine schnelle Diagnoseregel: Wenn die Artefakte schlimmer sind als das ursprüngliche Problem, hören Sie mit dem erneuten Verarbeiten auf und greifen Sie zur folgenden Entscheidung.
Selbermachen oder einem Profi überlassen? Ein klarer Entscheidungspunkt
Die Trennung in Eigenregie ist eine vernünftige Wahl für einen kurzen Creator-Clip, eine Sprachnotiz, einen Entwurf oder eine grobe Sprachspur, die Sie ohnehin bearbeiten werden – jeden Fall, in dem etwas Restmusik oder kleinere Artefakte akzeptabel sind.
Ziehen Sie einen professionellen Audio-Editor hinzu oder greifen Sie auf die Original-Projektdateien zurück, wenn die Einsätze oder die Audio-Schwierigkeit steigen:
- Die Aufnahme ist für eine bezahlte Kampagne, eine Ausstrahlung, einen Film oder eine Kundenlieferung bestimmt.
- Die Musik ist ungefähr auf demselben Pegel wie die Stimme abgemischt.
- Die getrennte Stimme trägt bereits merkliche Artefakte, die Sie nicht entfernen können.
Es gibt eine Abkürzung, die man kennen sollte. Wenn die Original-Session noch separate Sprach- und Musikspuren enthält, gibt Ihnen das Stummschalten oder Absenken der Musikspur weitaus mehr Kontrolle als das Extrahieren von Sprache aus einem fertigen Mix. Die Extraktion ist die Rückfalllösung für den Fall, dass diese saubere Quelle nicht mehr existiert.
Die Musik zu entfernen klärt nicht die Rechte
Das Herausfiltern von Musik aus einer Datei gewährt nicht die Erlaubnis, die Aufnahme oder deren Inhalt zu verwenden. YouTube erklärt, dass Creator im Allgemeinen die Rechte an urheberrechtlich geschütztem Material in ihren Videos benötigen, einschließlich Musik, die nur im Hintergrund hörbar ist. Bevor Sie veröffentlichen, bestätigen Sie, dass Sie die Erlaubnis haben, oder tauschen Sie eine Spur ein, für die Sie tatsächlich lizenziert sind. Ein sauberer Export und eine geklärte Lizenz sind zwei verschiedene Aufgaben, und das Überspringen der zweiten ist der Grund für Takedowns.
Sobald die Stimme isoliert ist, haben Sie einen flexiblen Master, auf dem Sie aufbauen können. Eine saubere Spur wird mit Speech to Text genauer transkribiert, und wenn Sie planen, diese Stimme in andere Sprachen zu lokalisieren, kann KI-Synchronisation die getrennte Sprache in 33 Zielsprachen übertragen.
Häufig gestellte Fragen
Kann KI Musik vollständig entfernen und die Stimme dabei unangetastet lassen?
Nicht zuverlässig in jeder Aufnahme. Trennwerkzeuge schätzen, welche Klänge zur Sprache und welche zur Musik gehören, sodass überlappende Klänge, laute Musik und Nachhall Spuren von Musik hinterlassen oder die Stimme subtil verändern können.
Wie viel kostet der DubSmart Sprachtrenner?
Der Sprachtrenner ist mit 100 Credits pro Minute gelistet, und die kostenlose Stufe umfasst derzeit 2.000 Credits – bei diesem Tarif etwa 20 Minuten. Prüfen Sie unsere aktuellen Preise für verfügbare Pläne und Konditionen vor einem größeren Auftrag.
Welche Dateiformate kann ich hochladen?
Unsere Sprachtrenner-Seite listet MP3, WAV und AAC unter den unterstützten Audioformaten auf, und auch Videodateien werden unterstützt. Bestätigen Sie etwaige aktuelle Größenbeschränkungen in der Upload-Oberfläche.
Kann ich einen Song aus einem Video entfernen, das bereits auf YouTube ist?
Für berechtigte Urheberrechtsansprüche bietet YouTube Studio Optionen, einschließlich des Löschens oder Ersetzens eines Songs. Ob die Bearbeitung sauber klingt, hängt vom Audio und vom Anspruch ab, prüfen Sie daher die Anweisungen von YouTube, bevor Sie Änderungen speichern.
Was, wenn ich nach der Bereinigung des Audios ein Transkript benötige?
Verwenden Sie Speech to Text, um die getrennte Stimme zu transkribieren. Ein Transkript ist auch eine praktische Möglichkeit, zu überprüfen, ob die Trennung Wörter beschädigt oder verdeckt hat.