KI-Sprachtrennung ist ein Deep-Learning-Prozess, der eine menschliche Stimme aus einem verrauschten Mix herausholt und eine saubere Sprachspur zurückgibt, bereit für Transkription, Synchronisation oder Voice-Cloning. Diese eine Fähigkeit beantwortet die Frage, die die meisten Creator eigentlich haben: Kann ich diese Aufnahme retten, ohne sie neu zu drehen? Zu verstehen, wie KI-Sprachtrennung funktioniert, hilft dir zu entscheiden, wann du dich darauf verlassen solltest, wann du von vornherein sauberer aufnehmen solltest und wie eine saubere Sprachspur alles Nachfolgende leise verbessert. Dieser Leitfaden führt durch den Mechanismus, den Unterschied zwischen der Verbesserung eines Sprechers und dem Aufteilen mehrerer, wo der Prozess in eine Lokalisierungspipeline passt und was er noch immer nicht beheben kann.
Inhaltsverzeichnis
Die Entscheidung hinter der Sprachtrennung
Jede echte Aufnahme erfasst weit mehr als den Sprecher. Vlogs, Webinare, Schulungsvideos und Podcasts nehmen Straßenlärm, Raumatmosphäre, Musikbetten, Tastaturklicks und überlappendes Gerede auf, das die Worte, die zählen, überdecken kann. Ein Sprachtrenner existiert, um dieses Gemisch zu entwirren: Er nimmt eine gemischte Datei und gibt eine Spur zurück, die überwiegend menschliche Sprache enthält, plus eine optionale Spur mit dem übrigen Hintergrundton.
Diese saubere Sprachspur wird zur Grundlage für alles, was danach kommt: präzise Sprache-zu-Text-Umwandlung, mehrsprachige Synchronisation, hochwertiges Voice-Cloning oder einfach ein besser klingendes Original. Die eigentliche Entscheidung ist also nicht technisch, sondern praktisch. Vertraust du deinem aktuellen Audiomaterial genug, um mehrsprachige Inhalte darauf aufzubauen, oder möchtest du, dass die KI die Sprache zuerst bereinigt und trennt? Und möchtest du ein eigenständiges Bereinigungstool oder einen Trenner, der in eine breitere Erstellungs- und Lokalisierungsplattform eingebettet ist, damit du nicht mit mehreren Apps jonglieren musst?
Wir haben unseren Speech Separator so konzipiert, dass er als erstes KI-Gate in einem einheitlichen Workflow fungiert. Er sitzt vor Sprache-zu-Text, Text-zu-Sprache, Voice-Cloning und Synchronisation, sodass jedes nachgelagerte System das klarstmögliche Sprachsignal erhält, anstatt jegliches Rauschen aus dem Raum zu übernehmen.
Der Mechanismus: von der Wellenform zur sauberen Stimme
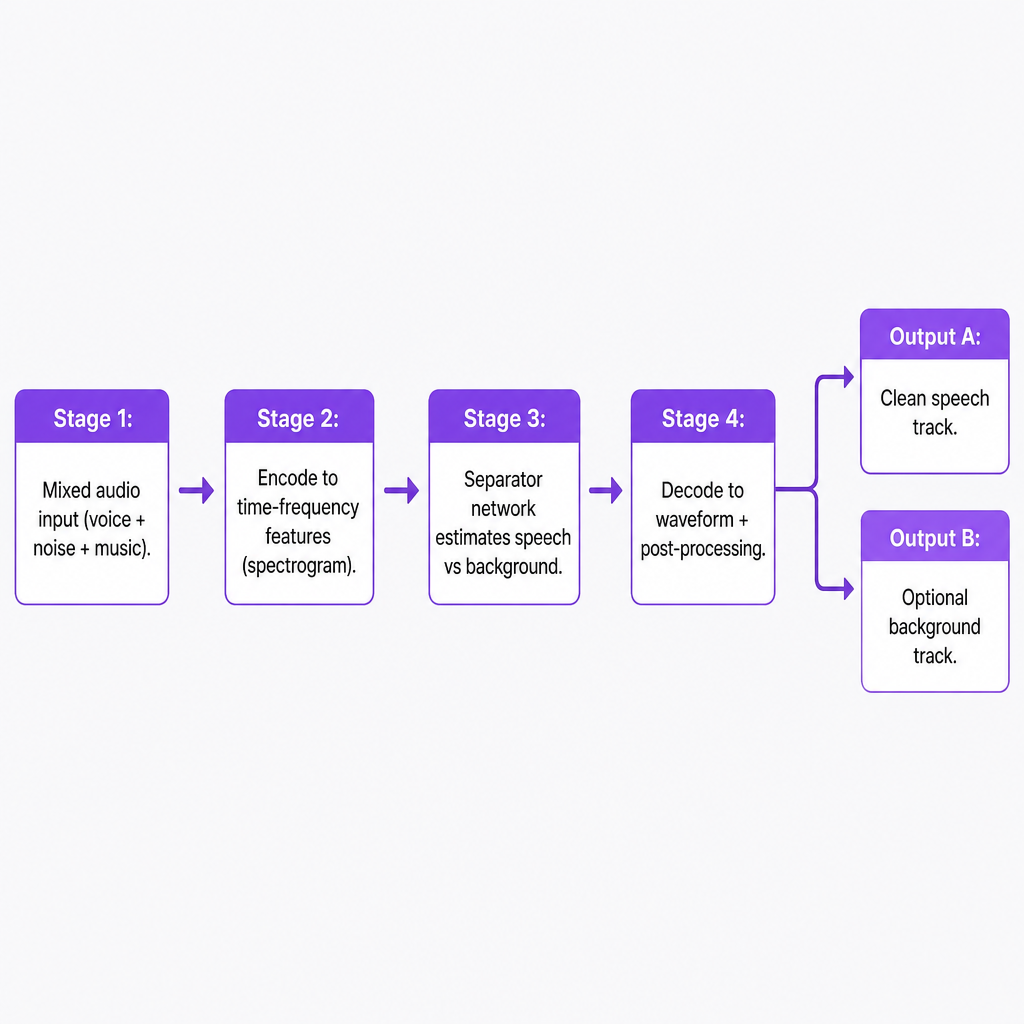
Moderne KI-Sprachtrennung folgt einer vierstufigen Pipeline: das Signal kodieren, Quellen in einem gelernten Merkmalsraum trennen, die saubere Sprache schätzen und sie zurück zu Audio dekodieren.
Von der Wellenform zu Merkmalen
Die meisten Systeme wandeln die rohe Wellenform von deinem Mikrofon zuerst in eine Zeit-Frequenz-Darstellung wie ein Spektrogramm um, das zeigt, wie sich die Energie in verschiedenen Frequenzbändern über die Zeit verändert. Diese Ansicht erleichtert es einem neuronalen Netz, die Muster zu erkennen, die menschlicher Sprache im Gegensatz zu Rauschen oder Musik entsprechen. Ein Encoder-Netzwerk bildet die Eingabe dann in einen hochdimensionalen Merkmalsraum ab, in dem verschiedene Klangquellen besser unterscheidbar werden, indem es Sprachmerkmale wie Formanten, Harmonische und zeitliche Struktur betont und irrelevante Hintergrundinhalte unterdrückt.
Trenner-Netzwerke und Masken
Der Kern des Prozesses ist das Trenner-Netzwerk, ein tiefes Modell, das darauf trainiert ist, an jedem Zeit-Frequenz-Punkt zu beurteilen, was zur Stimme gehört und was nicht. Zwei Strategien dominieren. Die maskenbasierte Trennung sagt eine Maske für das Spektrogramm voraus, die Sprachenergie beibehält und alles andere abschwächt; auf das ursprüngliche Spektrogramm angewendet, fallen Hintergrundrauschen und Musik stark ab, während die Sprache erhalten bleibt. Die direkte Quellenschätzung sagt stattdessen das saubere Sprachspektrogramm selbst voraus, und manchmal einen Rest-Hintergrund, der dann zurück zu Audio dekodiert wird.
Für schwierigere Fälle gibt es speziellere Ansätze. Deep Clustering lernt eine Einbettung für jeden Zeit-Frequenz-Bin, sodass Bins derselben Quelle zusammen clustern, woraufhin standardmäßiges Clustering die Sprache von anderen Quellen trennt. Andere Modelle verwenden permutationsinvariantes Training, sodass sie mehrere Sprecher trennen können, ohne anzunehmen, welcher Sprecher Ausgabe eins gegenüber Ausgabe zwei ist.
Training mit überwachten Beispielen
Diese Modelle lernen aus Beispielmischungen, die mit Ground-Truth-Reinsprache gepaart sind, und passen sich selbst an, um die Lücke zwischen ihrer Ausgabe und der Referenz zu minimieren. Trainingsziele können Masken, saubere Spektrogramme oder rekonstruierte Wellenformen sein, und die Verlustfunktionen sind oft an wahrnehmungsbezogene Qualitätsmaße wie das Signal-zu-Verzerrungs-Verhältnis gekoppelt. Wird das Netzwerk mit vielen unterschiedlichen Beispielen über Akzente, Mikrofone und Umgebungen hinweg gefüttert, verinnerlicht es robuste Hinweise, die menschliche Sprache von Hintergrundinhalten trennen, und verallgemeinert auf Aufnahmen, die es noch nie gesehen hat.
Zurück-Dekodierung zu Audio
Schließlich bildet das System die getrennte Sprachdarstellung durch eine inverse Transformation zurück auf eine Zeitbereichs-Wellenform ab, gefolgt von Nachbearbeitung wie Rauschunterdrückung und Lautheitsnormalisierung. Das Ergebnis ist eine sprachdominante Spur, die für sich allein stehen oder mit einer kontrollierten Menge Hintergrund zur Natürlichkeit neu kombiniert werden kann. Unser Speech Separator folgt genau diesem Muster: Er nimmt dein hochgeladenes Audio oder Video auf, durchläuft die Trennungspipeline und gibt eine sprachfokussierte Spur plus optionalen Hintergrund zurück, sodass du entscheidest, wie trocken oder atmosphärisch der finale Mix sein soll.
Einzelsprecher-Verbesserung vs. Mehrsprecher-Trennung
Es gibt eine wichtige Grenze zwischen der Verbesserung eines dominanten Sprechers und dem tatsächlichen Aufteilen mehrerer überlappender Stimmen, und sie prägt, was du realistisch erwarten kannst.
Die Einzelsprecher-Verbesserung isoliert eine Hauptstimme von Hintergrundrauschen, Nachhall und Nicht-Sprach-Geräuschen, sodass die Verständlichkeit springt. Dies funktioniert besonders gut für Vlogs, Webinare, Vorlesungen und Talking-Head-Inhalte, bei denen das Problem Umgebungsgeräusche oder ein Musikbett und nicht Übersprechen ist. Unser Speech Separator ist für diesen Fall optimiert: Er behandelt menschliche Sprache als primäre Quelle und alles andere als Hintergrund und liefert eine bereinigte Sprachspur und eine optionale Hintergrundspur.
Die Mehrsprecher-Trennung ist eine andere Aufgabe: das Aufteilen eines Gemischs mehrerer gleichzeitig sprechender Personen in einzelne Streams, einen pro Stimme. Forschungsmodelle haben bis zu fünf Stimmen von einem einzelnen Mikrofon getrennt, indem sie verschiedene Netzwerke für verschiedene Sprecheranzahlen trainierten und für jedes Beispiel die beste Passung auswählten. Techniken wie Deep Clustering und Multi-Mikrofon-Neural-Beamforming treiben die Leistung in Fernfeld- und Mehrkanalumgebungen weiter voran, sind aber komplexer und rechenintensiver. In der Praxis zielen diese Systeme immer noch auf spezialisierte Szenarien wie Besprechungstranskription, Callcenter und Smart Devices ab, statt auf alltägliche Creator-Workflows. Für die meisten unserer Nutzer, die YouTube-Kanäle, Marketingteams oder Kursbibliotheken betreiben, kommt der größte praktische Nutzen von einer starken Einzelsprecher-Verbesserung und der Trennung von Sprache und Hintergrund, nicht von vollständiger Mehrstimmen-Aufteilung.
Wo die Trennung in einem Lokalisierungs-Workflow sitzt
Die Trennung ist die Brücke zwischen verrauschten Aufnahmen aus der realen Welt und hochwertiger KI-Stimmarbeit. Ein typischer Weg verläuft sauber durch mehrere Tools.
Ein Creator lädt eine Audio- oder Videodatei hoch, und der Trenner isoliert die Sprachspur und optional den Hintergrund. Diese saubere Sprache fließt in Sprache-zu-Text, sodass Transkription und Übersetzung auf einem klaren Signal arbeiten, was die Genauigkeit verbessert und halluzinierte Wörter reduziert, die durch laute Musik oder Rauschen verursacht werden. Der resultierende Text und die Übersetzungen wandern dann in Text-zu-Sprache und KI-Synchronisation, die neue Sprachversionen mit geklonten oder synthetischen Stimmen erzeugen; da die Ausgangssprache sauber war, ist die zeitliche Ausrichtung präziser und Mischartefakte wie Pumping werden reduziert.
Voice-Cloning hängt von derselben sauberen Eingabe ab. Modelle benötigen relativ rauschfreie Beispiele, um Klangfarbe, Prosodie und Artikulation eines Sprechers zuverlässig zu lernen, und die Trennung reduziert die Hintergrundverunreinigung, die eine geklonte Stimme verzerren kann. Unser spanischsprachiger Leitfaden zur Trennung erfasst die alltägliche Erfahrung gut: Datei hochladen, die KI Stimme vom Hintergrund trennen lassen, dann entweder die saubere Sprachspur oder den isolierten Hintergrund für weitere Bearbeitung, Synchronisation oder Erzählung herunterladen, alles innerhalb eines Workflows. Diese Konsolidierung ist der Punkt für kleine Teams, die sonst zwischen separaten Rauschunterdrückungs-Plugins, Transkriptionstools, Synchronisationsdiensten und Cloning-Plattformen hin- und herspringen.
Auswahl und Verwendung von KI-Sprachtrennung
Wenn du entscheidest, wie du die Trennung einsetzt, erledigt eine Handvoll praktischer Kriterien den Großteil der Arbeit.
Audiobedingungen und Inhaltstyp. Mit einem einzelnen Hauptsprecher und moderatem Hintergrundrauschen oder Musik ist die Trennung hochwirksam und risikoarm. Bei starker Überlappung, Fernfeld-Mikrofonen oder sehr geringer Eingabequalität sind abnehmende Erträge zu erwarten, und du solltest die KI mit besseren Aufnahmen kombinieren, statt dich darauf zu verlassen, dass sie alles rettet.
Integration mit nachgelagerten Tools. Ein Trenner, der direkt in Transkription, Text-zu-Sprache und Synchronisation fließt, reduziert Reibung und kumulative Artefakte im Vergleich zum Exportieren und erneuten Importieren zwischen Apps. Wir verbinden den Speech Separator genau aus diesem Grund mit dem Rest unserer Lokalisierungstools, was umso wichtiger ist, wenn dein Ziel mehrsprachiges Publizieren statt einmaliger Rauschunterdrückung ist.
Kontrolle über Hintergrundton. Für Markenerzählungen möchtest du oft etwas Atmosphäre oder Musik für emotionale Wirkung behalten. Systeme, die sowohl eine saubere Sprachspur als auch einen isolierten Hintergrund ausgeben, geben Editoren mehr Spielraum als Tools, die nur einen einzelnen entrauschten Mix erzeugen. Unser Trenner unterstützt dieses Paradigma von Sprache-plus-optionalem-Hintergrund, sodass du gezielt neu mischen kannst.
Geschwindigkeit, Einfachheit und Skalierung. Für Creator und kleine Teams konkurriert die Benutzerfreundlichkeit mit der reinen Leistung. Ein-Klick-Trennung über einen Browser oder eine API, mit automatischer Handhabung gängiger Formate, schlägt komplexe Plugin-Ketten, die Audio-Engineering-Expertise voraussetzen. Sobald du Hunderte von Videos oder Kursmodulen verwaltest, hören Stapelverarbeitung und Automatisierung auf, Luxus zu sein.
Zuverlässigkeit und Artefakte. Ein starkes Modell verbessert die Verständlichkeit, ohne offensichtliche Verzerrung, metallisches Klingeln oder Atemartefakte hinzuzufügen. Demos können ein System schmeicheln, teste also mit deinen eigenen repräsentativen Aufnahmen, bevor du irgendeinen Trenner zu einem festen Bestandteil deiner Pipeline machst.
Datenschutz und Compliance. Die Trennung arbeitet direkt mit Sprachdaten, die sensible Informationen enthalten können. Enterprise-Teams sollten bestätigen, wie Audio gespeichert wird, ob es für Modelltraining verwendet wird und welche Kontrollen für Aufbewahrung und Zugriff bestehen, insbesondere für regulierte Branchen und interne Schulungsinhalte.
Wägst du diese Kriterien gegen deine tatsächlichen Anwendungsfälle ab, sei es Kanalexpansion, Schulung, Marketing, Erzählarbeit oder ein API-Produkt, zeigt dir das, ob ein integrierter Trenner mit nachgelagerten Stimm-Tools zu deiner Arbeitsweise passt.
Risiken, Grenzen und was sie nicht beheben kann
Selbst starke Modelle haben harte Grenzen, die es wert sind, gekannt zu werden, bevor du dich festlegst.
- Extremes Rauschen oder sehr niedriges Signal-zu-Rausch-Verhältnis. Wenn die Sprache unter lautem Rauschen oder Musik begraben ist, kann das Modell möglicherweise nicht jedes Wort wiederherstellen, was zu Aussetzern oder gedämpfter Ausgabe führt.
- Starke Sprecherüberlappung. Menschen, die genau gleichzeitig sprechen, fordern selbst fortgeschrittene Mehrsprecher-Systeme heraus und können dazu führen, dass Sprache zwischen getrennten Streams durchsickert.
- Übertrennungs-Artefakte. Aggressives Maskieren kann musikalisches Rauschen oder eine roboterhafte Klangfarbe einführen, am deutlichsten bei anhaltenden Klängen und Zischlauten.
- Diskrepanz zwischen Training und Realität. Modelle, die auf bestimmte Mikrofone, Sprachen oder Umgebungen abgestimmt sind, können bei sehr unterschiedlichen Aufnahmen unterdurchschnittlich abschneiden, was dann die Transkriptions- und Synchronisationsgenauigkeit herabzieht.
- Ethik und Rechte. Sauber getrennte Sprache lässt sich leichter transkribieren, analysieren und neu mischen, daher müssen Teams Einwilligung und Rechte respektieren, wenn sie Stimmen in neuen Sprachen oder Kontexten wiederverwenden.
Die ehrliche Erkenntnis ist, dass die Trennung eine leistungsstarke Verbesserung ist, kein Ersatz für vernünftige Aufnahmegewohnheiten. Gute Mikrofone, vernünftige Pegel und bedachte Standortwahl zahlen sich weiterhin aus, und die KI vervielfacht diese Entscheidungen dann, indem sie den Inhalt weitaus flexibler für Lokalisierung und Wiederverwendung macht. Wenn du erkundest, wie du dies in ein größeres Publishing-Setup einpasst, deckt unser Erklärtext dazu, was ein Sprachtrenner ist, die Grundlagen ausführlicher ab.
Häufig gestellte Fragen
Was ist KI-Sprachtrennung in einfachen Worten?
Es ist ein KI-Prozess, der eine gemischte Aufnahme nimmt und die menschliche Sprache isoliert, wodurch du eine saubere Sprachspur und optional eine separate Hintergrundspur erhältst, die du behalten oder verwerfen kannst.
Wie unterscheidet sich unser Speech Separator von einfacher Rauschunterdrückung?
Traditionelle Rauschunterdrückung schwächt hauptsächlich stationäres Rauschen ab. Unser Trenner verwendet Deep Learning, um Sprachmuster zu erkennen und sie aus einem breiten Spektrum von Hintergrundgeräuschen und Musik herauszuziehen, was in der Regel klarere und natürlichere Dialoge liefert.
Kann er mehrere Sprecher verarbeiten?
Unser Speech Separator ist für die Isolierung menschlicher Sprache von Nicht-Sprach-Hintergründen optimiert, was am besten mit einem Hauptsprecher im Mix funktioniert. Das Aufteilen mehrerer überlappender Stimmen ist ein aktives Forschungsgebiet, und es gibt spezialisierte Modelle, aber diese zielen typischerweise auf Besprechungen oder Callcenter ab statt auf allgemeine Creator-Workflows.
Warum ist Sprachtrennung wichtig für mehrsprachige Synchronisation?
Lokalisierung stützt sich auf präzise Transkription und Timing. Eine saubere Sprachspur reduziert Erkennungsfehler und hilft übersetzten Voiceovers, sich mit dem ursprünglichen Video auszurichten, wodurch hörbare Artefakte verringert werden, wenn neue Stimmen mit beibehaltener Musik und Effekten gemischt werden.
Wie viel technisches Wissen brauche ich, um es zu verwenden?
Sehr wenig. Du lädst eine Audio- oder Videodatei hoch, lässt die KI sie verarbeiten und lädst die getrennten Sprach- und Hintergrundspuren für Bearbeitung, Synchronisation oder Automatisierung herunter, ohne dass manuelle Parametereinstellung erforderlich ist.