Die ehrliche Antwort auf die Frage, wie viel Audiomaterial zum Klonen einer Stimme nötig ist, fällt kürzer aus, als die meisten erwarten: Mit DubSmart AI benötigen Sie mindestens 20 Sekunden einer sauberen Aufnahme von einem Sprecher. Dieses Minimum bringt einen brauchbaren Klon in Gang, erzählt aber selten die ganze Geschichte. Die Länge, die Sie tatsächlich aufnehmen sollten, hängt davon ab, wo die Stimme eingesetzt wird – ein einzelner Social-Clip, ein wiederkehrender Kanal-Erzähler, eine mehrsprachige Kursbibliothek oder ein Markenbotschafter, der in Dutzenden von Videos identisch klingen muss. Im Folgenden trennen wir das harte Minimum vom praktischen Ziel, erklären, worauf das Modell wirklich hört, und geben Ihnen eine Entscheidungsregel an die Hand, die Sie anwenden können, bevor Sie auf Aufnahme drücken.
Inhaltsverzeichnis
Das Minimum gegenüber dem praktischen Ziel
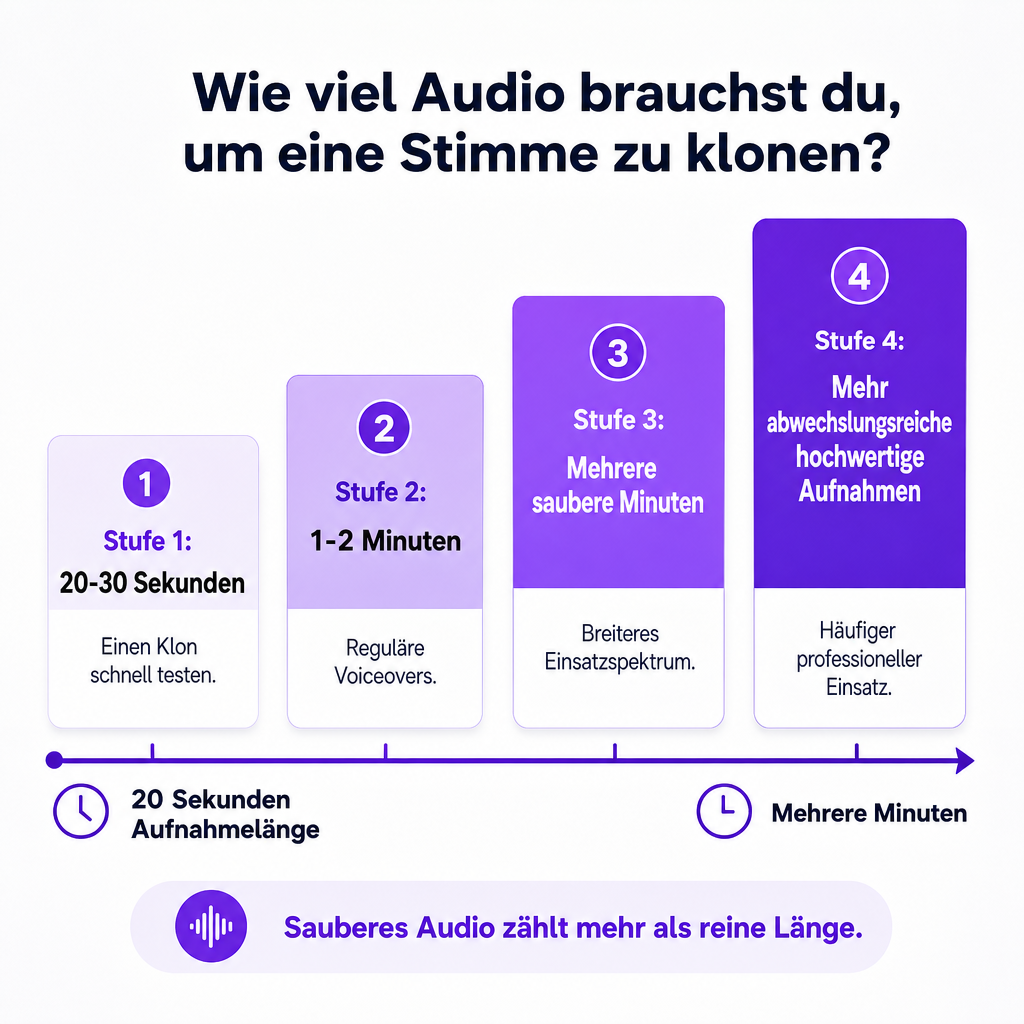
Zwanzig Sekunden sind die Untergrenze, nicht die Ziellinie. Eine Probe mit Mindestlänge erfasst die grundlegende Identität eines Sprechers, was für einen schnellen Test oder einen einmaligen Clip oft ausreicht. Doch die Menge an Material, die Sie dem Modell zur Verfügung stellen, prägt unmittelbar, wie gut der Klon mit unterschiedlichen Skripten umgeht. Das richtige Ziel skaliert damit, wie anspruchsvoll und wiederholt die Ausgabe sein wird.
| Ihr Ziel | Praktisches Audio-Ziel |
|---|---|
| Einen Klon schnell testen | 20–30 Sekunden |
| Regelmäßige Voiceovers erstellen | 1–2 Minuten |
| Eine breitere Vortragsbandbreite erfassen | Mehrere saubere Minuten |
| Eine Stimme für häufigen professionellen Einsatz aufbauen | Vielfältigere, hochwertige Aufnahmen |
Das Prinzip, das der gesamten Tabelle zugrunde liegt, ist unmissverständlich: Sauberes, konsistentes Audio ist in der Regel mehr wert als eine längere Aufnahme voller Rauschen, Echo, Musik oder mehreren Sprechern. Ein ordentlicher 30-Sekunden-Clip kann einen unordentlichen 10-Minuten-Clip übertreffen. Wenn Sie die umfassenderen Mechanismen verstehen möchten, wie aus einer Probe eine wiederverwendbare Stimme wird, deckt unser Erklärtext zu wie Voice Cloning eine Stimme nachbildet die gesamte Pipeline ab.
Was „genug Audiomaterial“ wirklich bedeutet
„Genug“ ist nicht wirklich eine Stoppuhr-Zahl – es ist eine Frage, ob das Modell genug nützliche Sprache hat, um die gewünschte Stimme zu rekonstruieren. Wenn Sie eine Stimme klonen, analysiert die KI die Aufnahme, um eine Reihe von Merkmalen zu identifizieren, und nutzt diese dann, um neue Sprache aus Text oder übersetzten Dialogen zu erzeugen.
Zu diesen Merkmalen gehören:
- Stimmlage und Klangfarbe
- Tonhöhe und Sprechrhythmus
- Aussprache und Akzent
- Pausen und Kadenz
- Energie, Betonung und emotionaler Vortrag
Eine kurze Probe legt die Kernidentität des Sprechers fest. Eine längere, vielfältigere ergänzt Informationen darüber, wie diese Person klingt, wenn sie erklärt, fragt, betont, pausiert oder den emotionalen Ton wechselt. Das eigentliche Ziel ist also repräsentatives Audio: Material, das dem Modell die Stimme bei genau den Dingen zeigt, die später von ihr verlangt werden.
Wann mehr als 20 Sekunden aufgenommen werden sollten
Gehen Sie über das Minimum hinaus, wann immer die geklonte Stimme wiederholt auftauchen, eine Marke repräsentieren oder längere Inhalte tragen soll. Für diese Fälle ist ein praktischer Ausgangspunkt eine bis zwei Minuten saubere Sprache, mit mehr, wenn die Stimme eine breitere Bandbreite an Vortragsstilen wiedergeben soll.
Längere Proben zahlen sich bei erzähllastiger Arbeit aus: YouTube-Videos, Podcasts, Online-Kurse, Unternehmensschulungen, Hörbuch-artige Inhalte, Produkterklärungen, mehrsprachige Synchronisation, Charakterdialoge und wiederholte Marketingkampagnen. Ein Creator, der nur eine ruhige Einleitung aufnimmt, bekommt tendenziell einen Klon, der in genau diesem einen ruhigen Register am besten funktioniert. Ein Creator, der Erklärungen, Fragen, Betonungen und natürliche Pausen aufnimmt, liefert dem Modell weit mehr Beispiele der Stimme in Aktion. Das Ziel ist niemals, die maximale Anzahl an Minuten abzuladen – es geht darum, Audio bereitzustellen, das repräsentiert, wie sich die Stimme wirklich verhält.
Warum sauberes Audio langes Audio schlägt
Mehr Audio hilft nur, wenn das zusätzliche Material von hoher Qualität und relevant ist. Eine 10-minütige Aufnahme mit Raumecho, Tastaturklappern, Hintergrundmusik, wechselnden Mikrofonen oder mehreren Sprechern kann weniger nützlich sein als ein kurzer, sauberer Clip. Lauteres Rauschen bleibt Rauschen, deshalb rettet das Aufdrehen der Verstärkung niemals eine schlechte Probe.
Zusätzliches Audio verdient seinen Platz, wenn es:
- Deutlich von einer Person gesprochen wird
- In Lautstärke und Mikrofonabstand konsistent ist
- Frei von Musik, Soundeffekten und überlappenden Stimmen ist
- In einer ruhigen, echoarmen Umgebung aufgenommen wurde
- In natürlichem Tempo vorgetragen wird
- Repräsentativ für den Stil ist, den Sie erzeugen möchten
Ein paar Aufnahmegewohnheiten schützen die Qualität mehr als jedes Längenziel. Halten Sie einen einzelnen Sprecher im Clip; andere Stimmen verwirren die Analyse. Bevorzugen Sie einen kleinen möblierten Raum gegenüber einem großen leeren, um Reflexionen zu reduzieren, und halten Sie durchgehend einen gleichmäßigen Mikrofonabstand ein. Nehmen Sie nicht einen Abschnitt aus der Nähe und einen anderen quer durch den Raum auf, und verzichten Sie darauf, die Datei mit langen Pausen oder unzusammenhängendem Audio aufzufüllen. Wenn Ihre einzige Quelle ein verrauschtes Video ist, reinigen Sie es zuerst, anstatt zu hoffen, dass die Länge das ausgleicht – unser Leitfaden zum Entfernen von Hintergrundmusik aus Audio führt durch diese Bereinigung.
Was Ihre Probe tatsächlich enthalten sollte
Der Inhalt zählt ebenso sehr wie der Zustand. Die Aufnahme sollte klare, natürliche Sprache enthalten statt isolierter Laute oder stark zerhackter Phrasen. Eine starke Probe mischt kurze und lange Sätze, eine Bandbreite an Vokal- und Konsonantenlauten, Zahlen und Daten, Namen und gängige Begriffe, Fragen, nachdrückliche Aussagen und natürliche Pausen – idealerweise in derselben Art von Sprache, die der endgültige Inhalt verwenden wird.
Wie das in der Praxis aussieht, variiert je nach Creator. Ein YouTuber könnte eine kurze Einleitung, eine Erklärung, einen Call-to-Action und ein paar Zeilen mit unterschiedlichen Betonungsgraden aufnehmen. Ein E-Learning-Produzent könnte instruktive Formulierungen, Definitionen, Listen und Übergänge einbauen. Ein Unternehmenssprecher profitiert davon, Markenterminologie und den konversationellen Stil einzuflechten, der in kundengerichteten Inhalten verwendet wird. Ob Sie hier überhaupt einen Klon brauchen, ist eine berechtigte Frage; unsere Gegenüberstellung von geklonter Stimme vs. Standard-TTS-Stimme hilft, wenn eine Bibliotheksstimme die Aufgabe schneller erledigen würde.
Mehrsprachiges Klonen und verrauschtes Quellaudio
Bei mehrsprachigen Projekten ist die Ausgangsanforderung weiterhin die Qualität der ursprünglichen Stimmprobe. Das Übersetzen erzeugter Sprache in andere Sprachen beseitigt nicht die Notwendigkeit einer klaren Quellaufnahme – ein matschiger englischer Clip erzeugt in jeder Zielsprache einen matschigen Klon.
Wenn Sie lokalisieren wollen, achten Sie auf die Klarheit der Originalstimme, die Aussprache von Namen und Markenbegriffen, den beabsichtigten Ton in jeder Sprache, ob der Stil des Sprechers formell, freundlich, energiegeladen oder konversationell bleiben soll, und ob übersetzte Skripte vor der Synchronisation geprüft wurden. Testen Sie bei einem größeren Lokalisierungsprojekt einen kurzen Abschnitt in jeder Zielsprache, bevor Sie das vollständige Video verarbeiten; das deckt Aussprache-, Tempo- und Kulturanpassungsprobleme frühzeitig auf. Der AI-Dubbing-Workflow von DubSmart kann eine geklonte Stimme für übersetzte Inhalte verwenden, und geklonte Stimmen können sowohl in Text-to-Speech als auch im AI Dubbing eingesetzt werden.
Die Quellqualität ist die andere Hälfte dieses Problems. Sie können oft Sprache aus einem Video extrahieren, aber Hintergrundmusik, Soundeffekte, Raumatmosphäre, Wind, Publikumsgeräusche, überlappende Sprache und Kompressionsartefakte machen einen Clip zu einem schlechten Ausgangspunkt. Wenn die Quelle wertvoll, aber verrauscht ist, isolieren Sie zuerst die Sprache. Unser Speech Separator trennt eine Stimmspur von anderen Audioelementen – und je sauberer diese Spur ist, desto zuverlässiger der Klon.
Einwilligung und das Recht, eine Stimme zu klonen
Sie dürfen die Stimme einer anderen Person nur klonen, wenn Sie über die entsprechende Erlaubnis und die entsprechenden Rechte verfügen. Voice Cloning birgt reale rechtliche, ethische, datenschutzrechtliche und Identitätsmissbrauchs-Risiken, holen Sie also vor dem Hochladen der Aufnahme einer anderen Person deren informierte Einwilligung ein und klären Sie, wie die Stimme verwendet, verbreitet und gespeichert werden darf. Die Voice Cloning Challenge-Regeln der U.S. Federal Trade Commission verlangten von den Teilnehmern, Stimmen nur mit Einwilligung der Person zu klonen, deren Stimme geklont wurde.
Dokumentieren Sie bei kommerzieller Arbeit, wer die Stimme besitzt oder kontrolliert, welche Aufnahmen verwendet werden dürfen, welche Inhaltstypen und Sprachen zulässig sind, ob kommerzielle Nutzung erlaubt ist, wie lange die Erlaubnis gilt, ob die Person sie widerrufen kann und wie synthetische Inhalte gegebenenfalls kenntlich gemacht werden. Klonen Sie keine öffentliche Person, keinen Mitarbeiter, Kunden, Schauspieler oder Familienangehörigen nur deshalb, weil Sie Zugang zu einer Aufnahme von ihnen haben. Zugang ist keine Erlaubnis.
Wie viel pro Creator-Typ aufgenommen werden sollte
Dasselbe Minimum gilt für alle, aber das praktische Ziel verschiebt sich mit dem Produktionsrisiko. Nutzen Sie das Minimum, wenn es auf Geschwindigkeit ankommt – frühe kreative Tests, Kurzform-Clips, interne Prototypen, einfache Ankündigungen – und nehmen Sie mehr auf, wann immer die Stimme über viele Videos oder Sprachen hinweg konsistent bleiben muss.
| Creator | Empfohlene Probe |
|---|---|
| YouTube-Creator | 20 Sek. zum Testen; 1–2 saubere, ausdrucksstarke Minuten für einen wiederkehrenden Erzähler |
| Kleinunternehmen / Marketing | Konsistenter Sprecher-Clip mit Kampagnenterminologie und Energie; testen Sie zuerst ein kurzes Voiceover |
| E-Learning / Schulung | Längere, vielfältige Probe mit Definitionen, Anweisungen, Fragen, Übergängen |
| Podcaster | Probe, die das normale Tempo des Hosts widerspiegelt; Aussprache von Namen und Sponsoren prüfen |
| Filmemacher | Probe, die der Charakterregie entspricht, einschließlich Flüstern, Intensität oder anderer dramatischer Qualitäten |
| Entwickler / Agenturen | Ein wiederholbarer Audiostandard, der angewendet wird, bevor Kundenproben akzeptiert werden |
Hinter dieser Tabelle stehen zwei praktische Hinweise. Eine neutrale Probe gibt keine Performance wieder, die auf Flüstern, Ironie oder Angst beruht, daher sollten Filmemacher den Charakter einfangen, nicht nur die Stimme. Und für API-gesteuerte Pipelines verhindert ein fester Aufnahmestandard inkonsistente Ergebnisse über Kunden hinweg; unsere Voice Cloning API erstellt individuelle Stimmen aus Audioproben und macht sie für Text-to-Speech und AI Dubbing verfügbar.
Eine kurze Prüfung vor dem Hochladen hält die Ergebnisse vorhersehbar. Vergewissern Sie sich, dass die Probe mindestens 20 Sekunden läuft, einen Sprecher enthält, keine Musik oder überlappenden Stimmen trägt, minimales Echo und Hintergrundrauschen aufweist, eine gleichmäßige Mikrofonposition und -pegel beibehält, natürliche Sprache statt langer Stille enthält, zum beabsichtigten Stil passt und von einem Sprecher stammt, der in die beabsichtigte Nutzung eingewilligt hat.
Nutzen Sie 20 Sekunden, um das Konzept zu testen, eine bis zwei Minuten für zuverlässige alltägliche Erzählung und vielfältigeres sauberes Audio, wenn die Stimme über Langform- oder mehrsprachige Inhalte hinweg konsistent performen muss.
Das Minimum bringt Sie an den Start. Aufnahmequalität, Sprecherkonsistenz, Ausdrucksbandbreite und Erlaubnis entscheiden darüber, ob das Ergebnis veröffentlichungsreif ist.
Häufig gestellte Fragen
Wie viel Audiomaterial braucht man, um eine Stimme zu klonen?
Mit DubSmart benötigen Sie mindestens 20 Sekunden Audio. Für eine bessere Abdeckung des Vortrags des Sprechers zielen Sie auf eine bis zwei Minuten saubere, natürliche Sprache ab.
Reichen 10 Sekunden aus, um eine Stimme zu klonen?
Für einige Systeme mag das genügen, aber es liegt unter dem angegebenen Minimum von DubSmart. Laden Sie für einen DubSmart-Klon mindestens 20 Sekunden hoch.
Reicht eine Minute für Voice Cloning aus?
Oft ja, für alltägliche Erzählung, vorausgesetzt, sie ist sauber, konsistent und natürlich gesprochen. Eine größere, vielfältigere Probe hilft bei ausdrucksstarkem oder professionellem Einsatz.
Macht eine längere Aufnahme den Klon genauer?
Nicht automatisch. Zusätzliche Länge hilft nur, wenn sie saubere, relevante Beispiele der Stimme hinzufügt. Rauschen, Echo, Musik und mehrere Sprecher verringern den Wert des zusätzlichen Audios.
Brauche ich eine Erlaubnis, um eine Stimme zu klonen?
Ja. Holen Sie eine Einwilligung ein und bestätigen Sie die geltenden Rechte, bevor Sie die Stimme einer anderen Person klonen – einschließlich beabsichtigter Nutzung, Verbreitung und kommerzieller Aktivität. Die Voice-Cloning-Challenge-Regeln der FTC verlangten ebenfalls die Einwilligung der Person, deren Stimme geklont wurde.
Kann ich einen Stimmklon für AI Dubbing verwenden?
Ja. Erstellte Stimmen können sowohl in Text-to-Speech als auch im AI Dubbing verwendet werden.