Wenn Menschen nach Ghostface Text to Speech suchen, wollen sie meist nur eines: ein geschriebenes Skript in eine dunkle, bedrohliche Stimme verwandeln, die an den maskierten Anrufer aus den Scream-Filmen erinnert. Was sie selten erkennen: Das bedeutet fast nie, die offizielle Charakterstimme zu erzeugen. In den Filmen gehört diese Darbietung dem Synchronsprecher Roger L. Jackson, vermittelt über ein stimmverzerrendes Gerät innerhalb der Handlung. Ein Text-to-Speech-Tool macht etwas anderes: Es erzeugt völlig neue Sprache aus Ihrem Text, indem es ein synthetisches oder autorisiertes Stimmmodell verwendet. Die eigentliche Frage lautet also nicht „Wie bekomme ich die Ghostface-Stimme?“, sondern „Brauche ich eine lizenzierte Darbietung oder eine originale Horrorstimme mit denselben verstörenden Eigenschaften – tiefes Register, bewusstes Tempo, bedeutungsgeladene Pausen und eine bedrohliche Vortragsweise?“
Diese Unterscheidung prägt jede nachfolgende Entscheidung, von der Wahl der Stimme bis zu dem, was Sie rechtlich veröffentlichen dürfen. Wir gehen durch, wie der Klang tatsächlich aufgebaut wird, wo DubSmart AI ins Spiel kommt und wie Sie bei den Stimmrechtsregeln in den Vereinigten Staaten auf der richtigen Seite bleiben.
Inhaltsverzeichnis
Was Ghostface Text to Speech wirklich bedeutet
Im Kern ist Ghostface Text to Speech ein Horror-Erzähler-Anwendungsfall für eine universelle KI-Sprach-Engine. Kreative greifen darauf zurück, um Halloween-Videos, fiktive Gruselgeschichten, Game-Trailer, Horror-Comedy-Sketche, Spannungs-Podcasts, animierte Charaktere und Kurzfilme mit originalen Besetzungen zu vertonen.
Ein Text-to-Speech-System liest Ihren geschriebenen Text, wandelt die Wörter in Aussprache- und Sprachinformationen um, sagt Sprachmerkmale wie Rhythmus, Tonhöhe, Betonung und Pausen voraus und synthetisiert diese Merkmale dann zu einer Audio-Wellenform. Das Ergebnis ist eine frische Aufnahme, die aus Text erzeugt wird, statt Zeile für Zeile von einem menschlichen Schauspieler aufgenommen zu werden. Unser Text to Speech-Tool führt genau diesen Prozess aus und verwendet Algorithmen, die menschliche Intonation über mehr als 300 Stimmen hinweg nachahmen, in mehreren Sprachen und Akzenten, mit Steuerungsmöglichkeiten für Sprechtempo, Emotion und Betonung sowie herunterladbarem Audio.
Der bedrohliche Charakter, den Sie suchen, ist kein einzelner Knopf. Er entsteht daraus, wie Sie die gewählte Stimme mit der Art kombinieren, wie Sie das Skript schreiben und verarbeiten. Wenn Ihnen die zugrunde liegende Technologie neu ist, behandelt unser Erklärtext zu wie neuronales Text to Speech funktioniert die Pipeline ausführlicher.
Ist es die echte Ghostface-Stimme?
Normalerweise nein – und das ist wichtiger, als es zunächst scheint. Eine „Ghostface-Stimme“, die von einem Online-Generator angeboten wird, ist in der Regel eines von vier Dingen: eine generische Horrorstimme, die dunkel und theatralisch klingen soll; eine Stilimitations-Voreinstellung, die das Tempo und die Haltung des Charakters hervorrufen soll; ein Stimmumwandlungseffekt, der eine Aufnahme mit Tonhöhe und Verzerrung umformt; oder eine unautorisierte Nachbildung, die darauf trainiert wurde, einen erkennbaren Darsteller ohne klare Erlaubnis zu imitieren.
Diese sind weder rechtlich noch technisch austauschbar. Eine originale, vom Horror inspirierte Stimme ist für einen von Ihnen erfundenen Charakter in Ordnung. Eine realistische Imitation eines bekannten Schauspielers oder eines markenrechtlich geschützten fiktiven Charakters wirft Rechts- und Lizenzfragen auf, die nichts damit zu tun haben, wie gut das Audio klingt.
Unsere öffentliche Text-to-Speech-Seite listet vorgefertigte Stimmen und Stimmklon-Funktionen auf; sie bietet keine offizielle Scream-Ghostface-Stimme oder eine Roger-L.-Jackson-Stimme. Behandeln Sie daher jede Drittanbieterseite, die einer Voreinstellung ein „Ghostface“-Etikett aufdrückt, als Marketing, nicht als Lizenznachweis. Geben Sie erzeugtes Audio nicht als offiziell, autorisiert oder von Jackson vorgetragen aus, es sei denn, Sie verfügen über eine gesonderte Berechtigung.
Wie der bedrohliche Klang entwickelt wird
Der erkennbare Effekt entsteht durch geschichtete Entscheidungen, nicht durch einen einzelnen Regler. Jede Schicht ist ein Hebel, den Sie unabhängig testen können.
Stimmregister. Eine tiefere Tonhöhe verleiht Gewicht und Bedrohung, aber das Absenken auf die tiefstmögliche Einstellung erzeugt meist ein unnatürliches, verzerrtes Ergebnis. Streben Sie eine moderate Absenkung an, die die Wörter auf Telefonlautsprechern, Laptoplautsprechern und Kopfhörern gleichermaßen verständlich hält.
Kontrolliertes Tempo. Ghostface-artige Dialoge wirken bewusst. Eine langsamere Vortragsweise lässt Zuhörer die nächste Zeile erahnen und sorgt dafür, dass kurze Sätze wie Konfrontationen wirken. Das Sprechtempo ist in unserem Workflow anpassbar, wobei die Standardeinstellung von 1,00x pro Projekt eingestellt werden kann. Der kluge Schritt ist, nur die bedrohlichen Zeilen zu verlangsamen; alles zu verlangsamen flacht die Spannung ab und klingt künstlich.
Pausen. Stille erzeugt mehr Grauen als ständige Verzerrung. Fügen Sie Satzzeichen, Zeilenumbrüche oder getrennte Dialogsegmente dort ein, wo der Sprecher zögern soll. „Magst du Horrorfilme?“ wird weit verstörender als „Magst du … Horrorfilme?“ Kurze Pausen wirken am besten direkt vor einem Namen, einer Enthüllung, einer Drohung oder einer Frage.
Betonung durch schriftliche Anweisungen. Synthetische Stimmen reagieren besser auf klare Anweisungen als auf vage. Sie können Dialogkennzeichnungen wie „sagte er fröhlich“ oder „rief er wütend“ verwenden, um den emotionalen Ton zu signalisieren, und Großschreibung, um einen Vokal zu betonen. Für Horror beschreiben Sie die Vortragsweise im Skript selbst:
[leise, kontrolliert, bedrohlich] Du hättest nicht abheben sollen.
Widerstehen Sie der Versuchung, überall in Großbuchstaben zu schreien. Übertriebene Betonung liest sich als Geschrei, nicht als Bedrohung.
Satzlänge. Kurze Zeilen geben dem Modell mehr Raum für dramatische Kontrolle. Vergleichen Sie „Ich beobachte dich schon seit mehreren Minuten und ich weiß genau, was du letzte Nacht getan hast“ mit:
Ich habe dich gesehen. Ich weiß, was du getan hast.
Die aufgebrochene Version gibt der Stimme mehr Gelegenheiten, zu pausieren und die Intensität zu verlagern.
Audioverarbeitung. TTS erzeugt die Stimme; die Bearbeitung formt den Horror. Nachdem Sie eine saubere Aufnahme haben, fügen Sie dezenten Raumhall, Telefonband-Filterung, leichte Sättigung, kontrollierte Kompression, Hintergrundatmosphäre und sorgfältig abgemischte Musik oder Effekte hinzu. Wenden Sie diese zuletzt an. Starke Verarbeitung von Anfang an verbirgt Ausspracheprobleme und begräbt die Wörter.
Vorgefertigte Stimme, Klonen oder ein menschlicher Sprecher
Text to Speech und Stimmklonen lösen unterschiedliche Probleme, und die falsche Wahl führt entweder zu einer schwachen Darbietung oder zu rechtlichem Ärger. Dieser Vergleich zeigt die Kompromisse auf.
| Option | Am besten für | Haupteingabe | Hauptrisiko |
|---|---|---|---|
| Vorgefertigte KI-Stimme | Schnelle Erzählung, originale Charaktere | Text | Stimme passt möglicherweise nicht zum gewünschten Charakter |
| Stimmklonen | Wiederverwendung der Identität eines autorisierten Erzählers | Sauberes Stimmbeispiel und Text | Einwilligungs- und Nachahmungsbedenken |
| Stimmumwandlung | Transformation einer bestehenden Darbietung | Aufgenommene Sprache | Kann eine reale Person zu sehr imitieren |
| Menschlicher Synchronsprecher | Lizenzierte Charakterarbeit, nuancierte Schauspielkunst | Skript und Regie | Höhere Kosten und Produktionszeit |
Aus diesem Grund halten wir Text to Speech und Stimmklonen als getrennte Tools. Unser Text-to-Speech-Produkt unterstützt vorgefertigte Stimmen und ermöglicht es Ihnen, Stimmen für die Verwendung über Sprachen hinweg zu klonen, aber unsere öffentlichen Seiten begründen kein Recht, eine Berühmtheit, einen fiktiven Charakter oder eine urheberrechtlich geschützte Darbietung ohne Erlaubnis zu klonen. Für einen erfundenen Horrorcharakter ist eine vorgefertigte Stimme mit präziser schriftlicher Regie in der Regel der sicherere und schnellere Weg. Für einen wiederkehrenden Kanal-Erzähler klonen Sie Ihre eigene Stimme oder nutzen einen Sprecher, der eine klare Erlaubnis erteilt hat.
Eine originale Horrorstimme in DubSmart AI aufbauen
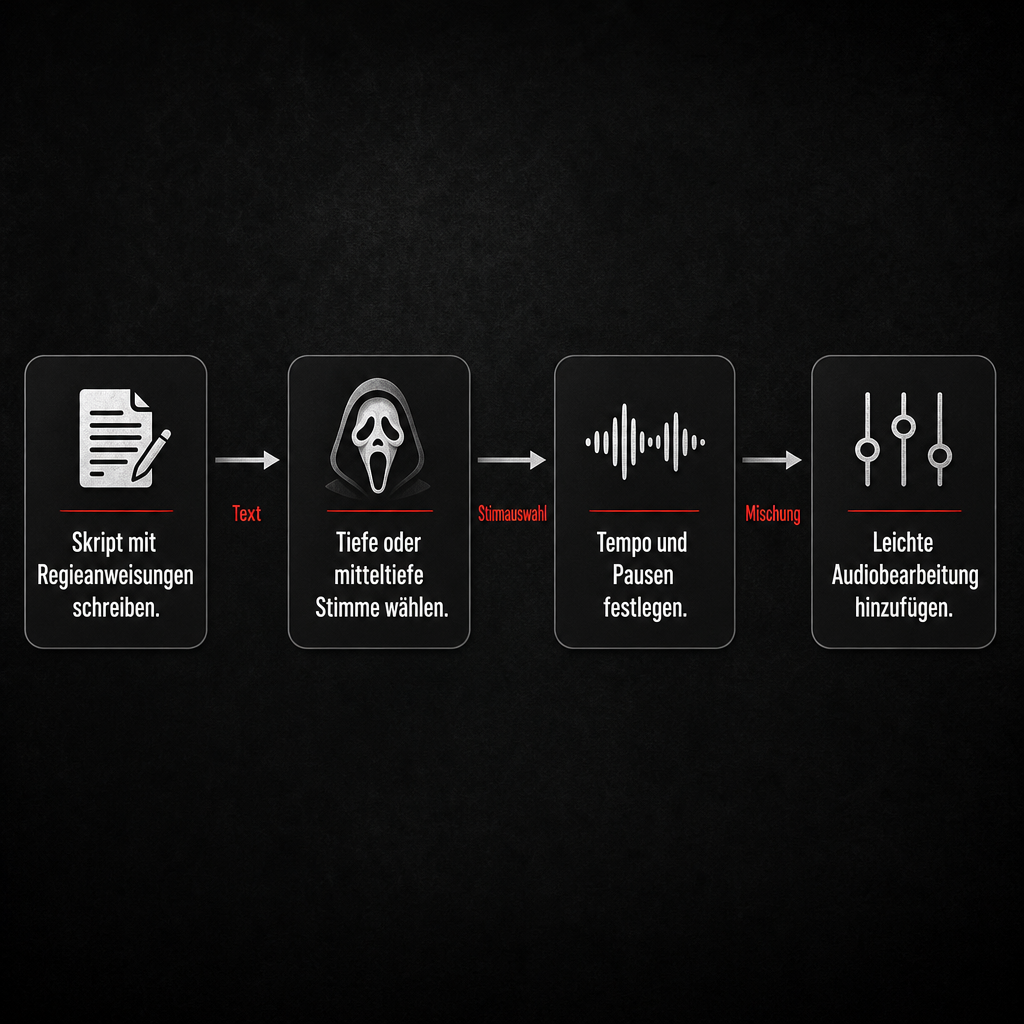
Unser Text-to-Speech-Workflow verwandelt ein Skript in erzeugtes Audio: Öffnen Sie Text to Speech, geben Sie Ihren Text ein, wählen Sie einen Sprecher, erzeugen Sie die Sprache, bearbeiten Sie das Projekt und laden Sie das Ergebnis herunter. Für ein von Ghostface inspiriertes, aber originales Ergebnis machen einige Gewohnheiten den Unterschied zwischen einem überzeugenden Bösewicht und einem offensichtlichen Roboter aus.
Wählen Sie die Stimme nach Verhalten, nicht nach Namen. Suchen Sie nach einer Stimme, die ruhig statt energisch ist, tief oder mittel-tief im Register, bei langsamerem Tempo deutlich, zu kontrollierter emotionaler Vortragsweise fähig und für das Alter und die Identität Ihres Charakters angemessen. Vermeiden Sie es, eine Stimme nur deshalb auszuwählen, weil eine Seite sie als „Ghostface“ bezeichnet hat; dieses Etikett beschreibt oft eine Imitation, keine lizenzierte Darbietung.
Schreiben Sie die Darbietung mit zurückhaltenden Anweisungen in das Skript:
[tief, ruhig, fast amüsiert] Du hast abgehoben. [Pause] Das war ein Fehler.
Das Ziel ist, den Ton zu lenken, ohne das System zu bitten, die genaue Vortragsweise eines benannten Schauspielers zu reproduzieren.
Korrigieren Sie die Aussprache, bevor Sie Effekte hinzufügen. Wenn ein Name oder eine Zahl falsch herauskommt, schreiben Sie sie phonetisch um oder buchstabieren Sie sie aus – Zahlen als Wörter zu schreiben hilft, wenn das System sie falsch ausspricht. Erzeugen Sie mehrere Versionen schwieriger Zeilen; eine saubere, genaue Aufnahme schlägt eine stark bearbeitete, die niemand verstehen kann.
Vergleichen Sie schließlich kurze Testbeispiele, bevor Sie sich auf eine ganze Episode festlegen. Lassen Sie dieselben drei Zeilen durch mehrere Stimmen und Tempos laufen: eine neutrale Aussage, eine geflüsterte oder leise Zeile und eine plötzliche Drohung. Wählen Sie die Stimme, die über alle drei hinweg glaubwürdig bleibt. Eine Stimme, die in einem Satz glänzt, kann über ein längeres Skript hinweg mechanisch werden. Wenn Ihre Geschichte reist, kann unser AI Dubbing die Stimme in andere Sprachen übertragen – überprüfen Sie nur jede einzelne, da die Übersetzung den Rhythmus und das kulturelle Gewicht einer Drohung verändert.
Stimmrechte und Ethik in den Vereinigten Staaten
Stimmimitation umfasst mehr als das Urheberrecht. Der Bericht des U.S. Copyright Office über digitale Nachbildungen behandelt Technologie, die die Stimme oder das Erscheinungsbild einer Person realistisch reproduziert; er stellt fest, dass das Urheberrecht Gesetze, die unautorisierte Stimmnachbildungen einschränken, nicht verdrängt, und erörtert Persönlichkeitsrechte, insbesondere dort, wo die Identität einer Person kommerziell genutzt wird. Sie können die Primärquelle im Bericht des Copyright Office über digitale Nachbildungen lesen.
Die sichersten Praktiken sind unkompliziert: Klonen Sie nicht die Stimme einer anderen Person ohne Erlaubnis; beschreiben Sie eine Imitation nicht als die offizielle Stimme; verwenden Sie nicht die Stimme eines erkennbaren Schauspielers, um Produkte ohne Autorisierung zu verkaufen; und nutzen Sie erzeugtes Audio niemals für Betrug, Belästigung, Drohungen oder Täuschung. Legen Sie KI-Beteiligung offen, wenn der Kontext Zuschauer verwirren könnte, führen Sie Aufzeichnungen über Einwilligung und erlaubte Nutzungen für jedes Stimmbeispiel und überprüfen Sie die Rechte an Musik, Filmausschnitten, Skripten und Charakternamen gesondert.
Es gibt einen realen Grund, Nachahmung ernst zu nehmen. Die Federal Trade Commission hat gewarnt, dass Stimmklonen Betrügereien glaubwürdiger macht, einschließlich Betrugsmaschen, die Verwandte oder Führungskräfte imitieren, um Geld oder Informationen zu erbitten; ihre Hinweise zu schädlichem Stimmklonen sind lesenswert. Vermeiden Sie selbst im Unterhaltungsbereich realistische Nachahmungen, die einen Zuhörer in die Irre führen könnten. Dies sind allgemeine Informationen, keine Rechtsberatung; kommerzielle Projekte, die einen erkennbaren Charakter oder Darsteller betreffen, sollten von qualifizierten Rechtsberatern oder den jeweiligen Rechteinhabern geprüft werden.
Ein einfaches Entscheidungsrahmenwerk hält Ihnen den Weg frei: Wählen Sie eine vorgefertigte KI-Stimme, wenn der Charakter original ist, Sie schnelle Erzählung benötigen oder häufig Inhalte produzieren. Wählen Sie einen autorisierten Stimmklon, wenn Ihnen die Quellstimme gehört oder Sie eine schriftliche Erlaubnis haben, konsistente Erzählung über mehrere Episoden hinweg benötigen und erlaubte Nutzungen dokumentieren können. Engagieren oder lizenzieren Sie einen menschlichen Darsteller, wenn das Projekt von erkennbarer Charakterschauspielerei abhängt, wenn emotionale Nuance zentral ist oder wenn die Grenze zwischen Inspiration und Imitation für eine kommerzielle Veröffentlichung nicht akzeptabel ist.
Bevor Sie veröffentlichen, führen Sie eine schnelle Prüfung durch: Wird die Stimme als original statt als offiziell präsentiert? Kann jedes Wort ohne Kopfhörer verstanden werden? Erzeugen die Pausen Spannung statt unangenehmer Lücken? Klingt der Charakter über die Szenen hinweg stabil? Sind Namen, Zahlen und Fremdwörter korrekt? Ist die Stimme lauter und klarer als die Musik? Könnte ein Zuschauer das Audio für eine offizielle Aufnahme halten? Haben Sie die Erlaubnis für jedes Stimmbeispiel, jeden Track, jeden Ausschnitt, jedes Skript und jede Charakterreferenz? Und funktioniert es auch auf Mobilgeräten und Kurzformat-Plattformen?
Häufig gestellte Fragen
Ist Ghostface Text to Speech kostenlos?
Einige Tools bieten kostenlose Testversionen oder eine begrenzte Erzeugung, aber Verfügbarkeit und Nutzungsrechte variieren. Wir bieten Text to Speech mit vorgefertigten KI-Stimmen und Stimmklon-Funktionalität an; prüfen Sie Ihre aktuellen Konto- und Guthabenbedingungen, bevor Sie ein kommerzielles Projekt produzieren.
Kann ich eine Ghostface-KI-Stimme auf YouTube verwenden?
Sie können eine originale, vom Horror inspirierte KI-Stimme verwenden, solange Ihr Skript, Audio, Ihre Musik und Ihre Bilder ordnungsgemäß lizenziert sind und die Präsentation nicht fälschlicherweise eine offizielle Scream-Beteiligung impliziert. Eine erkennbare Imitation kann zusätzliche Rechts- und Plattformrisiken schaffen.
Kann DubSmart AI die offizielle Ghostface-Stimme erzeugen?
Unsere öffentliche Text-to-Speech-Seite identifiziert keine offizielle Ghostface- oder Roger-L.-Jackson-Stimme. Nutzen Sie den Dienst, um eine originale Horror-Erzählung oder einen autorisierten Stimmklon zu erstellen, statt anzunehmen, dass ein generisches „Ghostface“-Etikett offiziell ist.
Kann ich die Stimme von Roger L. Jackson klonen?
Nicht ohne ausdrückliche Autorisierung des jeweiligen Rechteinhabers und Darstellers. Eine realistische Nachbildung der Stimme einer Person kann Fragen zu Persönlichkeitsrechten und digitalen Nachbildungen aufwerfen, insbesondere bei kommerzieller Nutzung.
Was lässt eine Stimme gruselig klingen?
Kontrolliertes Tempo, bedeutungsvolle Pausen, zurückhaltende Betonung, klare Aussprache und ein angemessenes Register sind in der Regel wichtiger als extreme Tonhöhenverschiebung. Eine saubere, verständliche Darbietung schlägt eine stark verzerrte.