Ein KI-Stimmenwandler fürs Dubbing leistet weit mehr, als nur eine Stimme gegen eine andere auszutauschen: Er transkribiert den Originaldialog, übersetzt ihn, erzeugt eine neue Darbietung in der Zielsprache und kann sogar die Identität, das Timing und den emotionalen Stil des ursprünglichen Sprechers bewahren. Genau diese Bandbreite an Aufgaben ist der Grund, warum die Frage „Welche Option soll ich verwenden?" keine einzige Antwort hat. Die richtige Wahl hängt davon ab, was Sie bewahren müssen.
Wenn der Sprecher erkennbar bleiben soll, passt ein Dubbing mit geklonter Stimme. Wenn Sie schnelle, flexible Sprachaufnahmen wünschen, ist eine vorgefertigte KI-Stimme einfacher zu handhaben. Wenn Sie eine wiederverwendbare Markenstimme über viele Projekte hinweg möchten, ist ein individueller Stimmenklon das aufzubauende Asset. Und wenn der Anwendungsfall ein Live-Gespräch ist, gehört ein Echtzeit-Stimmenwandler in eine andere Kategorie als jedes Postproduktions-Dubbing-Tool. Für die meisten YouTube-Creator, E-Learning-Teams, Marketer und unabhängigen Produzenten ist aufgezeichnetes KI-Dubbing der praktische Ausgangspunkt, weil es weitaus mehr Kontrolle bietet als ein Live-Wandler und mehrere lokalisierte Versionen aus einer einzigen Masterfassung ausgeben kann.
Inhaltsverzeichnis
Was ein KI-Stimmenwandler fürs Dubbing tatsächlich leistet
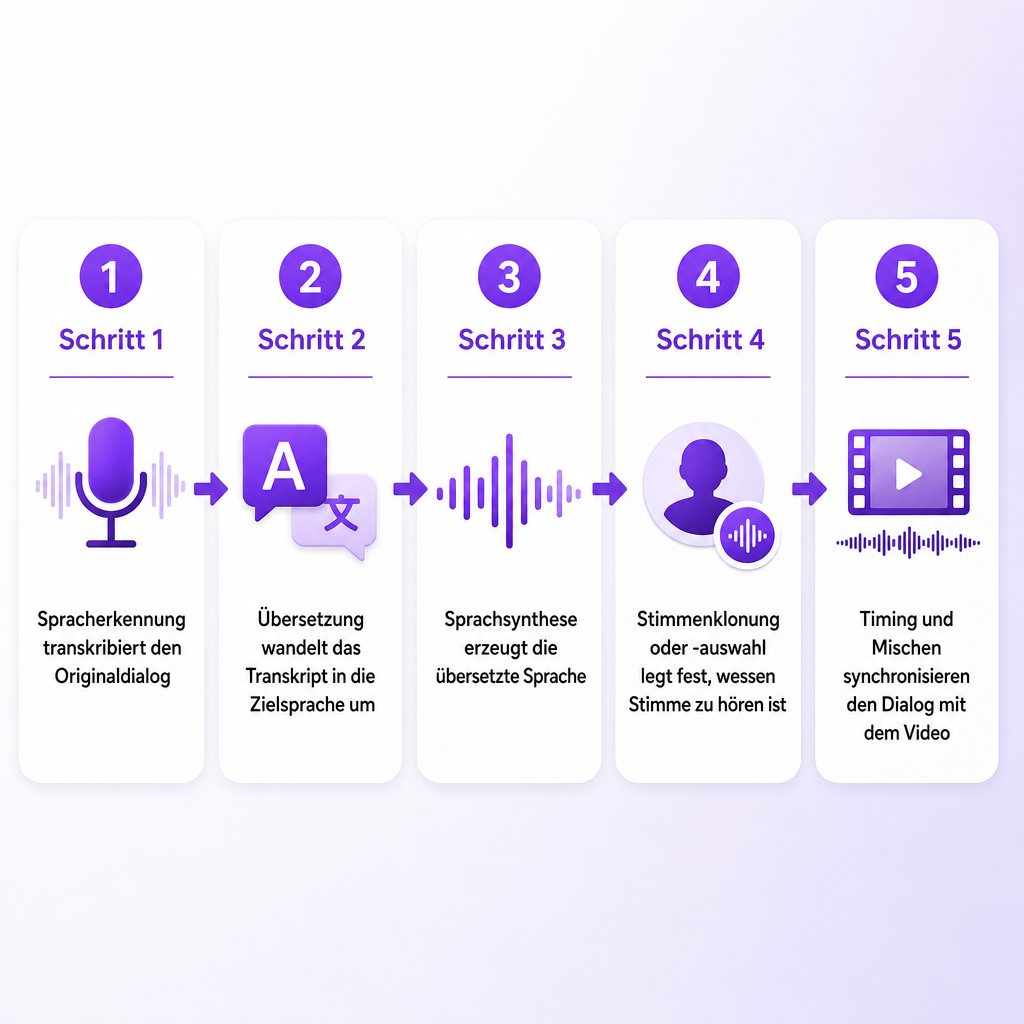
Ein KI-Stimmenwandler fürs Dubbing verändert sowohl die gesprochene Sprache als auch die Stimme von aufgezeichnetem Audio oder Video. Das ist eine Kette unterschiedlicher Technologien, die nacheinander arbeiten, und kein einzelner Effekt. Die Spracherkennung transkribiert den Originaldialog. Die Übersetzung wandelt diese Transkription in die Zielsprache um. Die Sprachsynthese erzeugt die übersetzte Sprache. Ein Klon- oder Auswahlschritt entscheidet, wessen Stimme das Publikum hört. Schließlich fügen Timing und Mischung den neuen Dialog in das Video, die Sprecher und das Hintergrundaudio ein.
Diese Abfolge unterscheidet es von einem herkömmlichen Stimmenwandler. Ein einfacher Wandler verändert Tonhöhe, Klangfarbe oder Charakter während eines Live-Anrufs und verlässt niemals die Audio-Ebene. Ein Dubbing-System muss Sprache verstehen, sie übersetzen, jeder Zeile den richtigen Sprecher zuordnen und eine synchronisierte Ersatzspur erstellen, die sich in die Originalszene einfügt.
Unser KI-Dubbing-Workflow akzeptiert eine hochgeladene Audio- oder Videodatei oder einen YouTube-Link und ermöglicht es Ihnen dann, Sprecher, Text und Timings zu bearbeiten, bevor Sie das Ergebnis herunterladen. Er verarbeitet Inhalte aus mehr als 60 Quellsprachen in 33 Zielsprachen, sodass die benötigte Übersetzungsrichtung in der Regel abgedeckt ist, bevor überhaupt eine Entscheidung über die Stimme getroffen wird. Wenn Ihnen das zugrunde liegende Konzept neu ist, führt Sie unser vollständiger Einsteigerleitfaden zum KI-Dubbing ausführlicher durch die Pipeline.
Die vier Optionen und für wen jede geeignet ist
Es gibt vier realistische Ansätze, und sie unterscheiden sich vor allem in einer Hinsicht: ob Sie den ursprünglichen Sprecher bewahren und ob Übersetzung überhaupt Teil der Aufgabe ist.
KI-Dubbing mit geklonter Stimme analysiert Merkmale wie Tonhöhe, Klang, Akzent und Sprechstil und erzeugt dann übersetzte Sprache mithilfe einer synthetischen Version der Originalstimme. Es passt am besten, wenn eine erkennbare Person den Inhalt trägt: YouTube-Kanäle rund um einen Moderator, Kursleiter, Markenbotschafter, durchgängige Podcast-Hosts, Filme mit wiederkehrenden Charakteren und Produktdemos, bei denen die Sprecherkontinuität wichtig ist. Seine Stärke liegt in der Bewahrung der Identität über Sprachen hinweg und in einer konsistenten Stimme für eine mehrsprachige Bibliothek, was die Notwendigkeit reduziert, Sprecher zu engagieren und zu koordinieren. Seine Grenzen sind ebenfalls real. Eine schlechte Quellaufnahme ergibt einen schlechten Klon, und Akzente, Emotionen, überlappende Dialoge, Musik und Hintergrundgeräusche verschlechtern alle die Qualität. Die Erlaubnis des Sprechers und die kommerziellen Rechte müssen zuerst geklärt werden, und eine geklonte Stimme kann weniger natürlich klingen, wenn die übersetzte Zeile ein sehr unterschiedliches Timing oder eine andere emotionale Absicht trägt.
KI-Dubbing mit vorgefertigter Stimme weist jedem Sprecher oder jeder Erzählspur eine ausgewählte synthetische Stimme zu, anstatt die Quelle zu klonen. Es eignet sich für Fälle, in denen der ursprüngliche Sprecher nicht erkennbar bleiben muss: eine Marke, die einen konsistenten Erzähler über viele Videos hinweg wünscht, Quellaudio, das zu verrauscht ist, um es sauber zu klonen, Erklär- und Onboarding-Inhalte oder das frühe Testen mehrerer Stimmstile, bevor man sich festlegt. Es ist auch der sicherere Weg, wenn Sie einfach keine Erlaubnis haben, die Stimme einer Person zu replizieren. Der Kompromiss besteht darin, dass sich die lokalisierte Version weniger mit dem Originalinhalt verbunden anfühlen kann.
Individuelles Stimmenklonen wird einmal erstellt und über Text-to-Speech-Sprachaufnahmen, Dubbing, Schulungsmaterial und andere genehmigte Inhalte hinweg wiederverwendet. Anders als wenn man eine Stimme für jedes Video separat klont, wird hier ein wiederverwendbares Stimm-Asset aufgebaut. Es passt zu einem Marketingteam, das dieselbe Markenstimme in Produktvideos, Hilfe-Center-Inhalten, E-Learning-Modulen, Social-Media-Anpassungen, mehrsprachigen Ankündigungen und Audioversionen schriftlicher Inhalte wünscht. Ein individueller Klon benötigt klare Eigentumsregeln: wer ihn verwenden darf, welche Sprachen und Kanäle erlaubt sind, ob externe Agenturen Zugriff erhalten und was passiert, wenn der Sprecher seine Zustimmung zurückzieht.
Echtzeit-KI-Stimmenwandlung verändert Sprache, während sie erzeugt oder übertragen wird, und priorisiert geringe Latenz, damit das Publikum die veränderte Stimme live hört. Es ist das richtige Werkzeug für Live-Anrufe, Streams, Gaming, virtuelle Events und interaktive Demos, aber selten das richtige Werkzeug für polierte mehrsprachige Lokalisierung. Echtzeitsysteme haben wenig Spielraum, um Übersetzungen zu überarbeiten, Timing zu korrigieren, Fehler zu entfernen oder einzelne Segmente fein abzustimmen, und sie können Latenz oder Artefakte einführen. Unser Erklärbeitrag zum Echtzeit-KI-Stimmenwandler behandelt, wo dieser Latenz-Kompromiss zu einer harten Grenze wird.
| Option | Am besten geeignet für | Bewahrt Originalidentität? | Übersetzung inbegriffen? | Hauptrisiko |
|---|---|---|---|---|
| Dubbing mit geklonter Stimme | Moderatorengeführte mehrsprachige Inhalte | Ja | Ja | Unbefugte oder unnatürliche Replikation |
| Dubbing mit vorgefertigter Stimme | Erklärvideos, Schulungen, Markenerzählung | Nein | Ja | Stimme kann von der Quelle losgelöst wirken |
| Individueller Stimmenklon | Wiederverwendbare Marken- oder Creator-Stimme | Ja | Meist, je nach Workflow | Zustimmung, Lizenzierung, Zugriffskontrolle |
| Echtzeit-Stimmenwandler | Live-Streams, Anrufe, Gaming | Manchmal | Nicht unbedingt | Latenz, Artefakte, begrenzte Korrektur |
| Menschliches Dubbing mit KI-Unterstützung | Hochkarätige Film- und Werbeproduktionen | Kann arrangiert werden | Ja | Höhere Kosten, längere Zeitpläne |
Wie man wählt, ohne sich zu sehr auf Stimm-Realismus zu fixieren
Der häufigste Fehler besteht darin, ein Tool zu wählen, weil eine kurze Stimmvorschau beeindruckend klingt. Ein realistisches Beispiel bedeutet wenig, wenn der fertige Dialog nicht zur Szene passt. Gehen Sie die Entscheidung der Reihe nach durch.
Beginnen Sie mit der Identitätsanforderung. Fragen Sie, ob die Zuschauer die erkennbare Stimme des ursprünglichen Sprechers hören müssen. Wenn ja, verwenden Sie Dubbing mit geklonter Stimme oder eine vorab genehmigte individuelle Stimme. Wenn nein, ist eine vorgefertigte Stimme schneller, einfacher und leichter zu verwalten. Eine Sprachlehrerin, die einen YouTube-Kanal ausbaut, profitiert von einem Klon der Stimme der Lehrkraft; ein Softwareunternehmen, das ein generisches Produkttutorial übersetzt, bevorzugt in der Regel einen professionellen vorgefertigten Erzähler.
Stimmen Sie das Tool auf das Inhaltsformat ab. Kurzformatige Inhalte, Podcasts, Tutorials und Produktvideos funktionieren oft gut mit automatisiertem Dubbing. Eine genauere Prüfung ist angebracht, wenn ein Projekt mehrere Sprecher, häufige Unterbrechungen, Witze oder Redewendungen, starke regionale Akzente, Musik über Dialogen, emotionales Schauspiel, schnelle Dialoge oder juristische, medizinische und finanzielle Fachterminologie umfasst.
Bewerten Sie die Sprachabdeckung nach Richtung statt nach der plakativen Gesamtzahl. Ein Tool kann Englisch, Spanisch und Französisch als Ziele auflisten, aber in jeder Richtung unterschiedliche Stimmqualität oder Dialektabdeckung bieten. Bestätigen Sie, ob die Plattform Ihre Quellsprache automatisch erkennt, den benötigten regionalen Akzent unterstützt, Namen und Terminologie bewahrt, gemischtsprachige Sprache verarbeitet, Untertitel oder nur Audio erzeugt und mehrere Zielsprachen in einem Projekt zulässt. Unser verbraucherorientiertes KI-Dubbing unterstützt mehr als 60 Quellsprachen und 33 Zielsprachen, während unsere API-Dokumentation separat über 33 Zielsprachen und die Verarbeitung aus über 99 Quellsprachen beschreibt. Überprüfen Sie daher das zutreffende Produkt oder den Tarif, bevor Sie sich für einen großen Auftrag entscheiden.
Prüfen Sie Timing und Synchronisation. Ein übersetzter Satz hat selten die gleiche Länge wie das Original, daher sollte ein Qualitätssystem es Ihnen ermöglichen, Start- und Endzeiten von Segmenten, Sprechgeschwindigkeit, Pausen, Sprecherzuordnung, Hintergrundlautstärke und einzelne neu generierte Zeilen anzupassen. Für lippensynchrone Inhalte sollten Sie Mundbewegungen und Szenen-Timing manuell überprüfen; eine natürliche Stimme kann dennoch unpassend aussehen, wenn die Übersetzung zu lang läuft oder die erzeugten Pausen vom Bild abweichen.
Berücksichtigen Sie das Produktionsvolumen. Ein einzelnes gelegentliches Video ist in einem Online-Studio problemlos möglich. Ein Kanal, eine Agentur oder ein Softwareprodukt, das kontinuierlich lokalisiert, sollte auf Batch- oder Mehrsprachenunterstützung, wiederverwendbare individuelle Stimmen, Projektbearbeitung, API-Zugriff, herunterladbare Segmente, Nutzungsüberwachung, Bedingungen für die kommerzielle Nutzung und zuverlässigen Support achten. Wenn Sie sich speziell für Sprachaufnahmen zwischen einer vorgefertigten Stimme und Klonen entscheiden, zeigt unser Vergleich von TTS versus Voice-Cloning für Sprachaufnahmen diese Wahl im Detail auf.
Qualitäts- und Rechtsrisiken, die Sie vor der Veröffentlichung prüfen sollten
Automatisiertes Dubbing ist ein Produktionsbeschleuniger, kein Ersatz für redaktionelles Urteilsvermögen. Eine Handvoll Risiken verdient bei jedem Projekt eine direkte Prüfung.
Eine Übersetzung kann Wort für Wort korrekt sein und dennoch Kontext, Humor, kulturelle Bezüge oder die beabsichtigte Förmlichkeit verfehlen. Überprüfen Sie Namen, Maßeinheiten, Handlungsaufforderungen, Produktbegriffe und Sicherheitshinweise mit einem Muttersprachler. Stimme und Emotion können ebenfalls abweichen: Eine geklonte Stimme kann vokale Merkmale beibehalten, ohne die genaue schauspielerische Leistung zu reproduzieren. Überprüfen Sie daher, ob Betonung, Dringlichkeit, Wärme und Pausen weiterhin zur Szene passen.
Hintergrundbedingungen sind für die Genauigkeit wichtig. Klonen und Transkription sind mit einem klaren Sprecher am zuverlässigsten, während Musik, Raumhall, Soundeffekte und überlappende Dialoge die Qualität der Transkription und Sprecherzuordnung mindern. Auf der Rechtsseite: Klonen Sie niemals eine Stimme nur, weil Sie Zugriff auf eine Aufnahme haben. Holen Sie die Erlaubnis des Sprechers ein und dokumentieren Sie den beabsichtigten Verwendungszweck, die Sprachen, Kanäle, Dauer und kommerziellen Rechte, was besonders wichtig ist bei Schauspielern, Mitarbeitern, Personen des öffentlichen Lebens, Kunden und verstorbenen Personen.
Ein realistisches Stimmbeispiel ist das Einfachste zu bewerten und der unzuverlässigste Prädiktor für ein brauchbares Ergebnis.
Das Vertrauen des Publikums ist die letzte Ebene. Einige Plattformen und Zielgruppen erwarten eine Offenlegung, wenn realistische synthetische Medien verwendet werden, und selbst dort, wo es nicht strikt erforderlich ist, reduziert Transparenz Verwirrung und schützt die Glaubwürdigkeit. Lassen Sie vor der Veröffentlichung eine prüfende Person die fertige Spur anhören, sie mit der Quelle vergleichen, die Übersetzung bestätigen und die Synchronisation überprüfen.
Wo DubSmart in diesen Workflow passt
Wir kombinieren KI-Dubbing, Voice-Cloning und Text-to-Speech in einer Plattform, anstatt in jeder Phase ein separates Tool aufzuzwingen. Unser KI-Dubbing-Produkt unterstützt automatisierte Lokalisierung, geklonte Sprecher, bearbeitbare Segmente, Timing-Änderungen und zeilengenaue Neugenerierung, sodass Sie einen einzelnen unpassenden Satz korrigieren können, anstatt ein ganzes Projekt neu aufzubauen.
Unser Voice-Cloning-Workflow akzeptiert ein mindestens 20 Sekunden langes Audio-Beispiel, und die resultierende Stimme wird sowohl für Text-to-Speech als auch für KI-Dubbing verfügbar, was eine genehmigte Markenstimme über viele Sprachen und Formate hinweg wiederverwendbar macht. Eine saubere Aufnahme ohne Hintergrundgeräusche erzeugt den besten Klon, und wir behandeln Zustimmung und verantwortungsvolle Nutzung als Voraussetzung und nicht als nachträglichen Gedanken.
Für Teams, die Lokalisierung in Software oder ein internes Produktionssystem einbauen, bieten wir außerdem eine KI-Dubbing-API mit mehrsprachigen Projekten, individuellen Stimmen, Sprechersteuerungen und segmentgenauer Bearbeitung an, zusammen mit Datei-Upload, Projekterstellung, Zielsprachenauswahl, Neugenerierung und dem Herunterladen von Ergebnissen. Die beste Eignung wird niemals durch den dramatischsten Stimmeffekt entschieden. Es kommt darauf an, ob ein Workflow die Sprachrichtung, Identität, Synchronisation, redaktionelle Kontrolle, Rechteverwaltung und Produktionsskalierung liefern kann, die Ihre Inhalte tatsächlich benötigen. Wenn Sie Ihre Quellsprache, Ihre Zielsprachen und die Frage kennen, ob Sie die Originalstimme bewahren müssen, wird diese Antwort in der Regel schnell offensichtlich.
Häufig gestellte Fragen
Ist ein KI-Stimmenwandler fürs Dubbing dasselbe wie ein normaler KI-Stimmenwandler?
Nein. Ein normaler KI-Stimmenwandler verändert eine Stimme in der Regel in Echtzeit oder verändert vokale Merkmale. Ein KI-Stimmenwandler fürs Dubbing übersetzt aufgezeichnete Sprache und baut eine Ersatzdarbietung auf, die zum Originalinhalt, den Sprechern und dem Timing passen muss.
Was ist die beste Option für YouTube-Creator?
KI-Dubbing mit geklonter Stimme ist in der Regel am stärksten, wenn die Identität des Creators zentral für den Kanal ist. Eine vorgefertigte Stimme ist oft besser für anonyme Erzählung, Erklärvideos oder Inhalte, bei denen Geschwindigkeit und Konsistenz wichtiger sind als die Sprecheridentität.
Kann DubSmart eine Stimme aus einer kurzen Aufnahme klonen?
Ja. Voice-Cloning erfordert mindestens 20 Sekunden Audio, und eine saubere Aufnahme ohne Hintergrundgeräusche erzeugt das beste Ergebnis. Die geklonte Stimme kann dann in Text-to-Speech und KI-Dubbing verwendet werden.
Sollte ich Echtzeit-Stimmenwandlung für die Videolokalisierung verwenden?
In der Regel nicht. Echtzeit-Wandlung passt zu Live-Anrufen, Streams und interaktiven Erlebnissen. Für mehrsprachige Videos bietet aufgezeichnetes KI-Dubbing weitaus mehr Spielraum, um das Endergebnis zu übersetzen, zu bearbeiten, zu synchronisieren und zu überprüfen.
Benötige ich eine Erlaubnis, um die Stimme einer Person zu klonen?
Ja. Holen Sie eine angemessene Erlaubnis ein und bestätigen Sie die kommerziellen Rechte, bevor Sie die erkennbare Stimme einer Person klonen oder verbreiten, und stellen Sie sicher, dass die Zustimmung die beabsichtigten Sprachen, Inhalte, Kanäle und die Nutzungsdauer abdeckt.