Ein Echtzeit-KI-Stimmenverzerrer wandelt Ihre Stimme während des Sprechens in eine andere Stimme um, indem er das Mikrofon-Audio erfasst, es analysiert, die Identität des Sprechers transformiert und das umgewandelte Audio mit einer kurzen Verzögerung abspielt. Anders als ein einfacher Tonhöhen-Verschiebungsfilter kann er einen Großteil Ihrer Worte, Ihres Timings und Ihrer Ausdrucksweise beibehalten, während Eigenschaften wie Klangfarbe, wahrgenommenes Alter, Geschlechtsdarstellung oder Charakterstil verändert werden. Und anders als Text-to-Speech geht er von gesprochener Sprache aus, nicht von getipptem Text.
Die eigentliche Entscheidung für Content-Ersteller, Streamer, Pädagogen und Unternehmen lautet nicht einfach, ob das Ergebnis realistisch klingt. Es geht darum, ob das Tool zu Ihrem Eingabetyp, Ihrer Latenztoleranz, Ihren Anforderungen an die Stimmsteuerung, Ihren Integrationen, Ihren Rechteverpflichtungen und Ihrer angestrebten Produktionsqualität passt. Dieser Leitfaden erklärt, wie die Technologie funktioniert, wie sie im Vergleich zu verwandten KI-Sprachtools abschneidet und wann ein aufgezeichneter Workflow besser für Sie geeignet ist.
Inhaltsverzeichnis
Was „Echtzeit" wirklich bedeutet
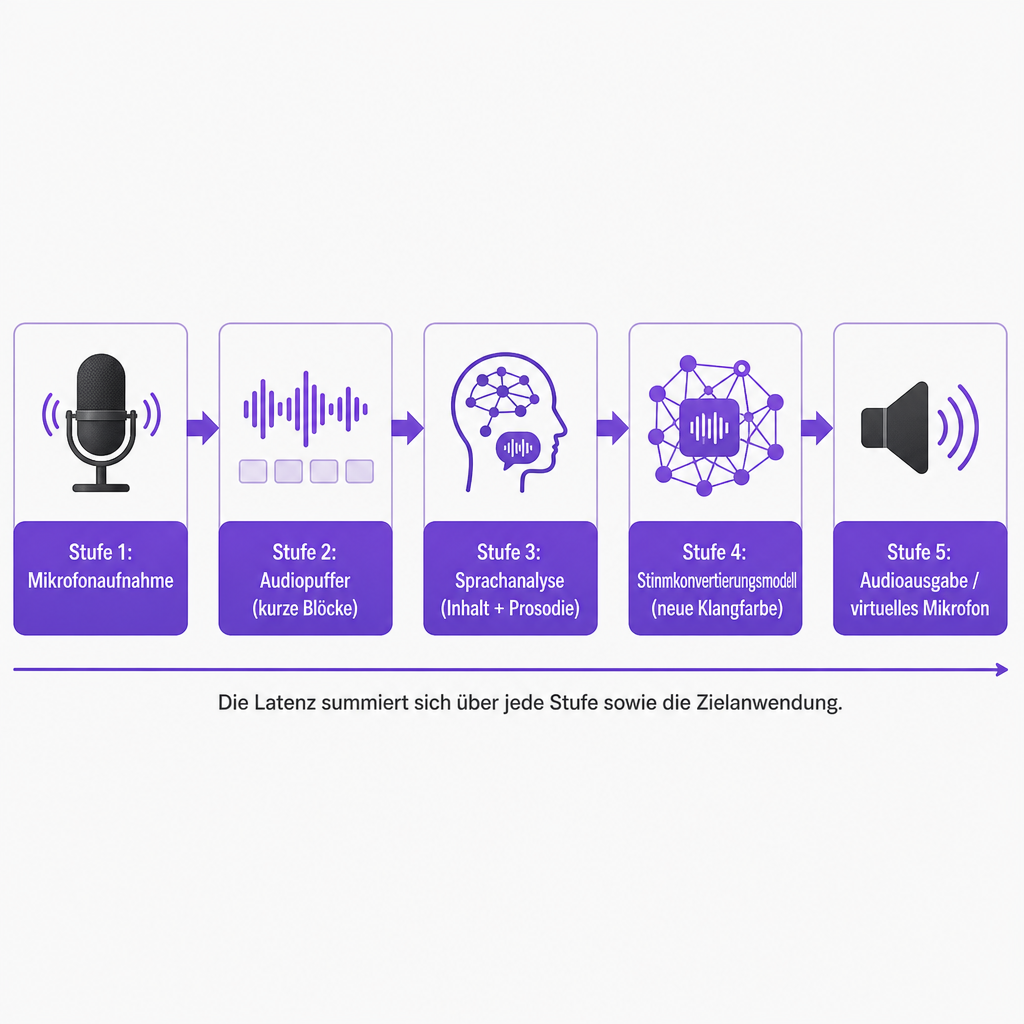
„Echtzeit" bedeutet, dass das System einen eingehenden Audiostream verarbeitet, während Sie sprechen, anstatt auf eine vollständige Aufnahme oder ein fertiges Skript zu warten. Das Signal durchläuft einen kontinuierlichen Weg: Mikrofon, Audiopuffer, Sprachanalyse, Stimmumwandlungsmodell, Audioausgabe. Da der Konverter an kurzen Segmenten statt an vollständigen Sätzen arbeitet, unterscheidet sich die Streaming-Stimmumwandlung technisch vom Rendern eines fertigen Voiceovers, bei dem das gesamte Skript im Voraus bekannt ist.
Eine gewisse Verzögerung ist unvermeidbar. Das System benötigt Zeit, um jeden Audioabschnitt zu erfassen, zu analysieren, zu synthetisieren und auszugeben. Die Forschung zeigt, dass eine Umwandlung mit geringer Latenz möglich ist, wobei die Werte stark vom Modell, der Hardware, der Puffergröße und der Audioqualität abhängen. Das LLVC-Forschungsmodell berichtet eine Latenz von unter 20 Millisekunden auf einer Consumer-CPU, während StreamVC eine End-to-End-Latenz von 70,8 Millisekunden in seiner Testumgebung angibt. Dabei handelt es sich um Forschungsergebnisse unter bestimmten Bedingungen, nicht um Leistungsgarantien für irgendein kommerzielles Tool, das Sie herunterladen könnten.
Wie ein Echtzeit-KI-Stimmenverzerrer funktioniert
Der Prozess läuft als Schleife, während Sie sprechen, nicht als einzelner Render-Vorgang. Das Verständnis der vier Phasen hilft Ihnen zu beurteilen, warum sich ein Tool natürlich anfühlt und ein anderes roboterhaft oder verzögert wirkt.
Zunächst erfasst das System Ihre Sprache. Es empfängt Audio von einem Mikrofon oder einer anderen Live-Eingabe und teilt es in kurze Abschnitte auf, damit das Modell es kontinuierlich verarbeiten kann. Die Eingabequalität ist wichtiger, als viele Nutzer erwarten. Hintergrundgeräusche, Raumhall, Tastaturgeklapper, Übersteuerung und ein instabiles Signal drängen die Umwandlung alle in Richtung unnatürlicher Artefakte.
Zweitens trennt es den Sprachinhalt von der Sprecheridentität. Eine Stimme trägt mehrere überlappende Ebenen gleichzeitig: den sprachlichen Inhalt bzw. die Worte; die Prosodie, also Rhythmus, Betonung und Intonation; die Tonhöhe; die Klangfarbe, die eine Stimme erkennbar macht; und die umfassendere Sprecheridentität. Umwandlungssysteme versuchen, den Inhalt und den Ausdruck zu bewahren, während sie die Sprechereigenschaften ersetzen. Die moderne Streaming-Forschung beschreibt dies als Beibehaltung von Sprachinhalt und Prosodie der Ausgangsquelle bei gleichzeitiger Anpassung an die stimmliche Klangfarbe eines Zielsprechers. Diese Trennung ist der Grund, warum Sie mit einem guten Konverter spontan in einer transformierten Stimme sprechen können, anstatt einen festen „Roboter"-Filter über die Wellenform zu schmieren.
Drittens synthetisiert das Modell eine neue Stimme. Es rekonstruiert Audio anhand eines Zielsprachprofils, das ein eingebauter Charakter, eine Bibliotheksstimme, eine aus autorisierten Aufnahmen erstellte benutzerdefinierte Stimme oder ein Profil sein könnte, das eher für Anonymisierung als für Nachahmung konzipiert ist. Die Ausgabe wird kontinuierlich mit einem kleinen Vorschaupuffer erzeugt. Mehr Kontext kann die Stabilität verbessern, fügt aber auch Verzögerung hinzu, was der zentrale Kompromiss der Live-Umwandlung ist.
Viertens wird das umgewandelte Signal in eine Anwendung geleitet. Ein Desktop-Tool stellt die Ausgabe typischerweise als virtuelles Mikrofon bereit, sodass andere Programme sie empfangen, als wäre sie ein normales Mikrofon. Diese Weiterleitung ermöglicht Livestreams, Online-Spiele, Videoanrufe, Sprachchats und virtuelle Events. Ein Echtzeit-Verzerrer muss daher auf Betriebssystem- und Anwendungsebene funktionieren, nicht nur innerhalb des Modells. Die Kompatibilität mit Streaming-Software, Discord, Zoom, Browsern und Mobilgeräten kann ebenso wichtig sein wie die reine Stimmqualität. Wenn Sie aus demselben erfassten Audio sauberen Text für Untertitel oder zur Weiterverwendung extrahieren möchten, übernimmt ein separater Speech-to-Text-Schritt die Transkription statt der Umwandlung.
Echtzeit-Umwandlung vs. verwandte KI-Sprachtools
Diese Technologien überschneiden sich in der Vorstellung vieler Menschen, lösen aber wirklich unterschiedliche Probleme. Die folgende Tabelle verdeutlicht, was jede als Eingabe verwendet und wann die Ausgabe eintrifft.
| Technologie | Eingabe | Zeitpunkt der Ausgabe | Am besten geeignet für |
|---|---|---|---|
| Echtzeit-Stimmenverzerrer | Live-Mikrofonsprache | Während des Gesprächs | Live-Anrufe, Gaming, Streaming, Performance |
| Text-to-Speech | Geschriebener Text | Nach Übermittlung des Textes | Narration, Tutorials, Werbung, E-Learning |
| Stimmenklonung | Stimmproben | Bei Bedarf generiert | Wiederverwendbare synthetische Stimme für Narration oder Synchronisation |
| KI-Synchronisation | Vorhandenes Audio oder Video | Nach der Verarbeitung | Übersetzen und Lokalisieren von aufgezeichneten Inhalten |
| Tonhöhen- oder Formanteffekt | Live- oder aufgezeichnetes Audio | Live oder nahezu live | Einfache kreative Stimmmodifikation |
Diese Unterscheidung ist praktisch, nicht akademisch. Eine Plattform kann eine leistungsstarke KI-Sprachgenerierung oder Stimmenklonung bieten, ohne einen Live-Mikrofon-Verzerrer für Anrufe und Streams anzubieten. Unsere eigenen Tools konzentrieren sich auf generierte und lokalisierte Medien: Wir bieten Text-to-Speech, Stimmenklonung, KI-Synchronisation, Speech-to-Text, Speech Separator, Text-to-Image und Image-to-Video in einem Workflow. Diese sind darauf ausgelegt, Audio aus Text zu erzeugen oder eine wiederverwendbare Stimme für generierte Inhalte zu erstellen, sodass sie zur Seite des aufgezeichneten Workflows in dieser Tabelle gehören und nicht zur Live-Mikrofon-Umwandlung.
Wofür Live-Stimmumwandlung geeignet ist
Streamer und Gamer greifen zur Stimmumwandlung, um einen Charakter aufrechtzuerhalten, die Privatsphäre zu schützen oder eine konsistente Kanal-Persona zu bewahren. Geringe Latenz ist hier am wichtigsten, da Sie auf andere Spieler reagieren und mit einem Publikum sprechen. Eine kleine Verzögerung ist in einem Monolog im Broadcast-Stil tolerierbar, wird aber bei schnellem Geplänkel, kompetitivem Spiel oder komödiantischem Timing störend auffällig.
In Online-Meetings und virtuellen Events kann eine umgewandelte Stimme Rollenspiele, Demonstrationen, Barrierefreiheitsszenarien oder datenschutzbewusste Teilnahme unterstützen. In professionellen Umgebungen sollten Verständlichkeit und Zuverlässigkeit Vorrang vor Neuheit haben, und den Teilnehmern sollte mitgeteilt werden, wenn eine Stimme transformiert wird, falls Schweigen sie in die Irre führen könnte.
Die Charakterdarstellung ist eine weitere Live-Anwendung. Indie-Filmemacher, Spieleentwickler und Podcaster können Charakterstimmen testen oder spontan temporäre Dialoge vortragen. Für die endgültige Auslieferung bietet jedoch ein aufgezeichnetes KI-Voiceover oder eine menschliche Darbietung in der Regel eine bessere Bearbeitungskontrolle und Konsistenz von Sitzung zu Sitzung.
Stimmprivatsphäre und Anonymisierung sind ein anderes Ziel als die Nachahmung. Die Anonymisierung versucht zu verschleiern, wer spricht, während die Nachahmung versucht, eine bestimmte Zielidentität zu reproduzieren. Keines von beiden ist narrensicher, und eine transformierte Stimme kann immer noch Sprechgewohnheiten, Formulierungen oder Hintergrundgeräusche verraten, die zur Identifizierung des Sprechers beitragen.
Schließlich unterstützt die synthetische Stimmtechnologie Barrierefreiheit und unterstützende Kommunikation für Menschen, die die Fähigkeit zu sprechen verloren haben. Die Federal Trade Commission erkennt diesen medizinischen und barrierefreien Nutzen an, warnt aber auch davor, dass die Stimmnachbildung für Betrug und Missbrauch biometrischer Daten missbraucht werden kann.
Die Entscheidungskriterien, die wirklich zählen
Die Latenz kommt zuerst, und Sie sollten die gemessene End-to-End-Latenz erfragen, nicht nur die Inferenzgeschwindigkeit des Modells. Die Verzögerung, die Sie tatsächlich spüren, umfasst Mikrofonaufnahme, Pufferung, Merkmalsextraktion, Modellinferenz, Synthese, Ausgaberoutung und alles, was die Anruf- oder Streaming-App obendrein hinzufügt. Ein Modell, das isoliert schnelle Benchmark-Werte erzielt, kann sich träge anfühlen, sobald der gesamte Weg zusammengesetzt ist.
Natürlichkeit ist der nächste Test. Achten Sie auf metallische Artefakte, plötzliche Tonsprünge, Atem- und Ausspracheprobleme, unnatürliche Pausen, verzerrte Konsonanten, Störungen an Satzgrenzen und Verlust des emotionalen Ausdrucks. Eine überzeugende Stimme sollte während spontaner Sprache verständlich bleiben, nicht nur bei sorgfältig vorgelesenen Demozeilen.
Die Bewahrung des Sprachinhalts wird leicht übersehen, bis sie versagt. Testen Sie schnelles Sprechen, Unterbrechungen, Zahlen, Namen, Akzente, Lachen, Fragen und Lautstärkeänderungen. Ein Tool, das die Identität ändert, aber Ihren Rhythmus und Ihre Intonation verflacht, ist für Performance oder Live-Interaktion schlecht geeignet.
Die Stimmauswahl und Anpassung bestimmen, wie weit Sie das Ergebnis formen können. Prüfen Sie auf eingebaute Stimmen, benutzerdefinierte Stimmerstellung, Tonhöhen- und Klangregler, Emotions- oder Stiloptionen, Akzentwahl, Konsistenz über Sitzungen hinweg und etwaige Beschränkungen für die kommerzielle Nutzung. Die benutzerdefinierte Stimmerstellung sollte immer eine klare Autorisierung erfordern: Eine Stimmprobe ist keine Erlaubnis, die Person nachzuahmen, von der sie stammt.
Die Hardware- und Plattformunterstützung entscheidet, ob das Tool überhaupt zu Ihrem Setup passt. Bestätigen Sie, ob es lokal auf CPU oder GPU, in einem Browser, über eine Desktop-App, auf Mobilgeräten, über ein virtuelles Mikrofon oder über eine API läuft. Die Cloud-Verarbeitung kann die Einrichtung vereinfachen, führt aber Netzwerklatenz und Fragen der Daten-Governance ein, während die lokale Verarbeitung die Netzwerkverzögerung reduzieren kann, aber leistungsfähigere Hardware erfordert. Überprüfen Sie außerdem das Audio-Routing: Ein starkes Modell ist nutzlos, wenn seine Ausgabe nicht als Mikrofon in Ihrer vorgesehenen Anwendung ausgewählt werden kann.
Der Umgang mit Daten schließt die Liste ab. Bevor Sie Stimmproben hochladen, prüfen Sie, ob Aufnahmen aufbewahrt werden, ob sie zur Modellverbesserung beitragen, wie benutzerdefinierte Stimmen gelöscht werden, wer auf die Dateien zugreifen kann, ob Geschäfts- oder Unternehmenskontrollen bestehen und was anschließend mit dem generierten Audio geschieht. Stimmaufnahmen können je nach Kontext und geltendem Recht sensible personenbezogene oder biometrie-bezogene Daten sein, also behandeln Sie sie entsprechend.
Wann ein aufgezeichneter Workflow Echtzeit schlägt
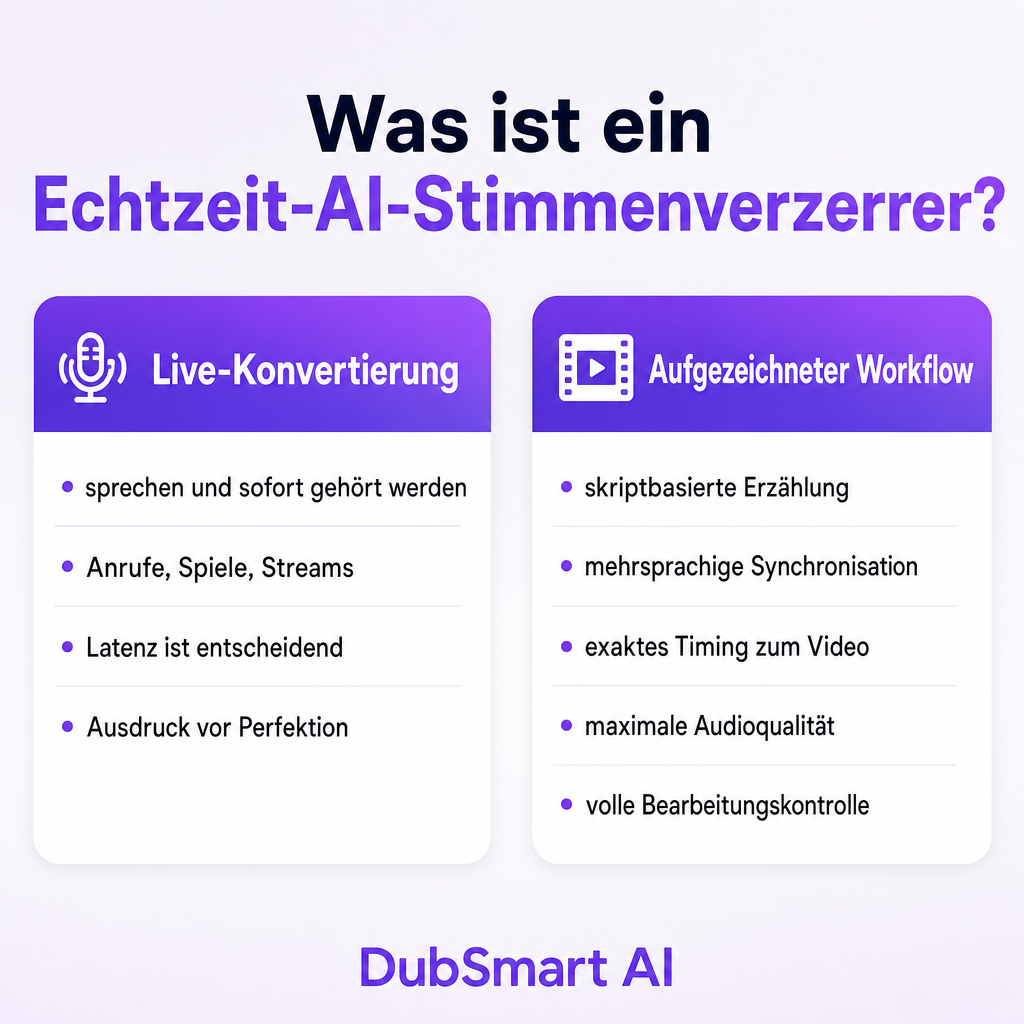
Die Live-Umwandlung ist die richtige Wahl, wenn eine Person natürlich sprechen und die transformierte Stimme sofort gehört werden muss. Sie ist die falsche Wahl, wenn Ihre Priorität maximale Audioqualität, präzise Aussprache, mehrsprachige Narration, exaktes Timing zu Video, detaillierte Bearbeitung, konsistentes kommerzielles Voiceover oder hochwertige Synchronisation ist.
Für diese Ziele gewinnt eine aufgezeichnete Pipeline. Mit Text-to-Speech steuern und verfeinern Sie das Skript, bevor Audio erzeugt wird, was das Live-Latenzproblem vollständig beseitigt. Mit KI-Synchronisation verarbeitet das System ein vorhandenes Video und richtet die übersetzte Sprache an der Quelle aus – etwas, das kein Live-Verzerrer kann. Wenn Ihre Quelldatei Dialoge mit Musik oder Geräuschen mischt, kann ein Speech Separator eine saubere Stimmspur isolieren, bevor Sie sie verarbeiten. Unsere KI-Synchronisation ist darauf ausgelegt, aufgezeichnetes Audio oder Video in unterstützte Zielsprachen zu übersetzen, nicht einen Live-Mikrofon-Feed umzuwandeln.
Risiken und verantwortungsvolle Nutzung
Identitätsdiebstahl und Betrug sind das Hauptrisiko. Eine realistische umgewandelte Stimme kann eine falsche Identität glaubwürdiger machen, und die FTC warnt, dass Stimmenklonungssysteme bei Familienbetrug, Unternehmensimitation, Erpressung und anderen Betrugsformen eingesetzt werden, zusammen mit Risiken für Sprachkünstler, deren Stimmen angeeignet werden könnten. Verwenden Sie die erkennbare Stimme einer echten Person nicht ohne Autorisierung, und präsentieren Sie niemals eine KI-generierte oder umgewandelte Stimme als Beweis dafür, dass eine bestimmte Person gesprochen hat.
Einwilligung und Stimmrechte folgen direkt. Holen Sie die Erlaubnis ein, bevor Sie die Stimme einer anderen Person klonen oder absichtlich nachahmen, und führen Sie einen Nachweis dieser Erlaubnis, insbesondere bei kommerziellen Projekten, Werbung, Training, Spielen oder öffentlichen Medien. Das hier zitierte FTC-Material erörtert Schäden, Durchsetzung und vorgeschlagene Lösungen, anstatt eine einzige Einwilligungsregel für jede Nutzung festzulegen, sodass spezifische Verpflichtungen von Rechtsordnung, Vertrag, Plattform und Anwendungsfall abhängen können. Im Zweifelsfall prüfen Sie dies für Ihre Situation.
Offenlegung ist sinnvoll, wann immer ein Publikum vernünftigerweise glauben könnte, dass eine echte Person live spricht. Ein kurzer Hinweis, dass die Stimme KI-generiert oder stimmumgewandelt ist, reduziert Verwirrung. Auch Sicherheit ist wichtig: Schützen Sie Stimmproben und benutzerdefinierte Stimmdateien wie andere sensible Werte, beschränken Sie den Zugriff, vermeiden Sie das Hochladen von Aufnahmen ohne Erlaubnis und entfernen Sie ungenutzte Stimmprofile, wo der Dienst dies zulässt. Planen Sie schließlich für Qualitätsfehler. Latenz, Audioaussetzer und Umwandlungsartefakte können ein Gespräch zum Scheitern bringen, also testen Sie das gesamte Setup mit dem tatsächlichen Mikrofon, Kopfhörer, der Anwendung, dem Netzwerk und der Hardware, bevor Sie an die Öffentlichkeit gehen.
Wo unsere Tools in Ihr Sprachprojekt passen
Wir präsentieren einen integrierten KI-Medien-Workflow statt eines Live-Mikrofon-Stimmenverzerrer-Produkts. Auf unserer Plattform können Sie Sprache aus Text generieren, aus mehr als 300 Stimmen wählen, geklonte Stimmen aus einer kurzen Probe erstellen und diese Stimmen in Text-to-Speech- und KI-Synchronisationsprojekten verwenden. Wir unterstützen die Synchronisation aus mehr als 60 Ausgangssprachen in 33 Zielsprachen, was uns zu einer starken Wahl macht, wenn die Aufgabe darin besteht, ein Voiceover aus einem Skript zu erstellen, Sprache mit einer benutzerdefinierten Stimme zu erzeugen, aufgezeichnetes Audio oder Video zu synchronisieren oder Inhalte für mehrsprachiges Publikum zu lokalisieren.
Für Entwickler veröffentlichen wir separate API-Seiten für Text-to-Speech, Stimmenklonung und KI-Synchronisation. Dies sind Generierungs- und Lokalisierungs-Workflows. Wenn Ihr Projekt speziell einen Live-Mikrofon-Stimmenverzerrer benötigt, stellen Sie sicher, dass Echtzeit-Streaming-Eingabe, Ausgabe-Routing, Latenzziele und Live-Session-Unterstützung ausdrücklich dokumentiert sind, bevor Sie sich auf eine API festlegen – unsere oder die eines anderen.
Wenn Sie zwischen Live-Umwandlung und einer aufgezeichneten Pipeline abwägen und sich nicht sicher sind, welcher Weg zu Ihren Inhalten passt, nennen Sie uns Ihr Quellformat, Ihre Zielsprachen und ob Sie eine Live- oder vorab aufgezeichnete Ausgabe benötigen, und wir weisen Sie auf den richtigen Workflow hin.
Häufig gestellte Fragen
Ist ein Echtzeit-KI-Stimmenverzerrer dasselbe wie Text-to-Speech?
Nein. Ein Echtzeit-Stimmenverzerrer transformiert Live-Mikrofonsprache während des Sprechens, während Text-to-Speech neue Sprache aus geschriebenem Text generiert, den Sie zuerst übermitteln. Unser Text-to-Speech ist für die Generierung von Sprache aus Text konzipiert, nicht für die Live-Mikrofon-Umwandlung.
Hat ein Echtzeit-KI-Stimmenverzerrer keine Verzögerung?
Nein. Jedes System benötigt Zeit, um Audio zu erfassen und zu verarbeiten, sodass eine gewisse Latenz unvermeidbar ist. Die praktische Verzögerung hängt vom Modell, Gerät, den Puffereinstellungen, dem Netzwerk und der Zielanwendung ab, und Forschungssysteme berichten unter verschiedenen Testbedingungen unterschiedliche Werte.
Kann ein KI-Stimmenverzerrer die Stimme eines Prominenten kopieren?
Einige Systeme können erkennbare Stimmen technisch nachahmen, aber technische Fähigkeit ist keine Erlaubnis. Vermeiden Sie unautorisierte Nachahmung und prüfen Sie die relevanten Verträge, Plattformregeln und Gesetze, bevor Sie die Stimme einer erkennbaren Person verwenden.
Was sollte ich verwenden, um mehrsprachige YouTube-Videos zu erstellen?
Für vorab aufgezeichnete Videos passt die KI-Synchronisation in der Regel besser als ein Live-Stimmenverzerrer, da sie das vorhandene Video verarbeitet und ausgerichtetes, lokalisiertes Audio erzeugt. Unsere KI-Synchronisation übersetzt und synchronisiert aufgezeichnetes Audio oder Video in unterstützte Sprachen.
Kann Ihre Plattform meine Stimme live während eines Anrufs ändern?
Unsere Plattform dokumentiert Text-to-Speech, Stimmenklonung und KI-Synchronisation, nicht die Live-Mikrofon-Stimmumwandlung. Wenn Sie einen Live-Anruf-Workflow planen, bestätigen Sie zunächst die aktuelle Produktdokumentation mit uns, damit wir den richtigen Ansatz empfehlen können.