Die Wahl einer Stimme für Ihre Inhalte läuft selten auf einen einzelnen Gewinner hinaus. Die ehrliche Version von KI-Voiceover vs. professioneller Sprecher ist eine Sortierfrage: Welche Teile Ihrer Bibliothek brauchen echte menschliche Emotion und welche brauchen schnelle, skalierbare Erzählung, die Sie auf Abruf produzieren und lokalisieren können. Behandeln Sie es so, und die Debatte hört auf, philosophisch zu sein. Sie wird zu einer Routing-Entscheidung, die Sie Video für Video, Kampagne für Kampagne anwenden können.
Im Folgenden definieren wir die echten Alternativen, ohne eine zu krönen, vergleichen sie anhand der Kriterien, die tatsächlich Ergebnisse beeinflussen, und zeigen auf, wann jeder Weg passt — einschließlich der hybriden Setups, die die meisten erfahrenen Teams letztlich betreiben.
Inhaltsverzeichnis
Die echten Alternativen, ohne einen Gewinner zu wählen
Für einen US-basierten Creator oder ein Team gibt es drei praktische Wege, und jeder hat einen anderen Vorteil.
KI-Voiceover (synthetische Stimme). Audio, das durch Text-to-Speech- und neuronale Sprachmodelle erzeugt wird, die auf großen Datensätzen menschlicher Sprache trainiert wurden. Sie schreiben oder fügen ein Skript ein, wählen eine Stimme, passen Tempo, Ton und Betonung an und erzeugen in wenigen Minuten eine Erzählung. Auf unserer Plattform bündelt dieser Weg über 300 natürlich klingende Stimmen, Stimmklonen aus kurzen Proben, sodass Sie Ihre eigene Stimmidentität bewahren können, Synchronisation und Übersetzung in Dutzende Sprachen in einem Workflow sowie APIs zum Einbauen von Stimme in Apps und automatisierte Pipelines.
Professioneller Sprecher (menschliches Talent). Ein geschulter Darsteller, der Ihr Skript interpretiert, schauspielerisches Können einbringt und in einem professionellen oder akustisch behandelten Heimstudio aufnimmt. Menschliche Sprecher glänzen bei echter Emotion, feinem Timing und Mikro-Veränderungen im Ton, die Inhalte lebendig und vertrauenswürdig wirken lassen. Üblicherweise arbeiten Sie über Briefings, Live-Regie und Revisionen zusammen, bis die Darbietung den Anforderungen Ihrer Marke entspricht.
Sie als die Stimme (DIY-Aufnahme). Sie nehmen sich selbst mit einem anständigen Mikrofon und grundlegenden Bearbeitungswerkzeugen auf. Dies bewahrt Authentizität und spart das Casting, hängt aber stark von Ihrer Vertrautheit mit Performance und Postproduktion ab. Viele Creator kombinieren diesen Weg später mit Stimmklonen, damit ihre persönliche Stimme zu einem skalierbaren Asset für zukünftige Inhalte wird, statt zu einer wiederkehrenden Aufnahmearbeit.
Keiner davon ist allgemein besser. Die Arbeit besteht darin, zu entscheiden, welcher davon jeden Platz in Ihrem Content-Kalender verdient.
Kriterien, die die Entscheidung wirklich treffen
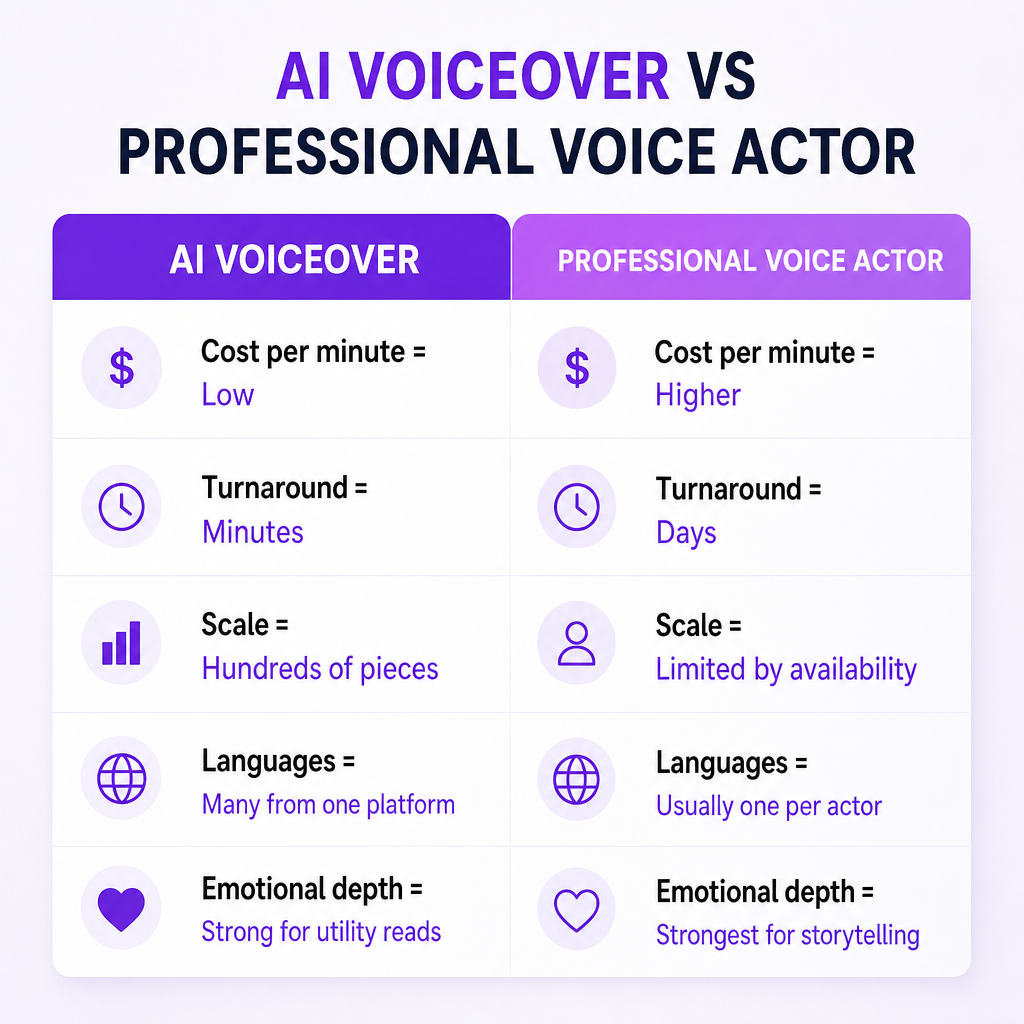
Der Vergleich wird klarer, wenn Sie jeden Weg anhand der Dimensionen bewerten, die Ergebnisse verändern, statt derjenigen, die beeindruckend klingen. Die folgende Tabelle verdichtet die Kompromisse; die Anmerkungen danach fügen die Nuance hinzu, die ein Raster nicht erfassen kann.
| Kriterium | KI-Voiceover | Professioneller Sprecher |
|---|---|---|
| Kosten pro Minute | Niedrig; passt zu großvolumigen Inhalten mit bescheidenem ROI | Höher; Session-, Studio- und Revisionskosten |
| Bearbeitungszeit | Minuten, sobald das Skript fertig ist | Ein Tag bis mehrere Tage; Eilauftrag gegen Aufpreis |
| Skalierbarkeit | Hunderte Stücke, konsistente Ausgabe | Begrenzt durch Verfügbarkeit und Ermüdung |
| Sprachabdeckung | Viele Sprachen von einer Plattform | Üblicherweise eine Hauptsprache pro Sprecher |
| Emotionale Tiefe | Stark für Nutzensprechertexte | Am stärksten für Überzeugung und Storytelling |
Kosten und Budgetflexibilität. KI-Voiceover ist durchgängig günstiger pro Minute, was es für lange Schulungsreihen, große Back-Kataloge und häufige Social-Clips rentabel macht, bei denen der Ertrag pro Stück bescheiden ist. Menschliches Talent kostet mehr, weil Sie Session-Sätze, Studiozeit und Regie bezahlen, und dieser Aufpreis erkauft emotionale Nuancen und ein unverwechselbares Stimmprofil, das eine Marke differenzieren kann.
Geschwindigkeit und Bearbeitungszeit. KI-Erzählung kann in Minuten erzeugt werden, sobald das Skript final ist, was sich für schnelles Testen, zeitkritische Erklärvideos und strenge Veröffentlichungspläne eignet. Menschliche Voiceover dauern typischerweise von einem Tag bis zu mehreren Tagen für Casting, Aufnahme und Revisionen, mit Eillieferung gegen Aufpreis — ein Kompromiss, der für geplante Launches angemessen ist, bei denen sich zusätzliche Verfeinerung auszahlt.
Skalierbarkeit und Volumen. Einmal konfiguriert, erzeugt KI große Mengen mit identischen Stimmmerkmalen über Hunderte von Assets hinweg, weshalb sie so gut zu E-Learning-Katalogen, mehrsprachigen Unternehmensschulungen und der Lokalisierung eines großen YouTube-Archivs passt. Menschliches Talent liefert ebenfalls konsistente Qualität, aber Verfügbarkeit, Terminplanung und Ermüdung begrenzen das Volumen, sodass die Skalierung auf viele Sprachen üblicherweise mehrere Sprecher und ein aufwändigeres Projektmanagement bedeutet.
Sprachabdeckung und Lokalisierung. KI-Engines bedienen viele Sprachen und Akzente von einer einzigen Plattform aus und ermöglichen es Ihnen, in Dutzende Sprachen zu lokalisieren, ohne separate Casts zusammenzustellen — der Kern unseres Ansatzes beim KI-Synchronisation für mehrsprachige Kanäle und globale Kampagnen. Jeder menschliche Sprecher deckt üblicherweise eine Hauptsprache ab, sodass vollständige Lokalisierung bedeutet, Talent pro Region zu beschaffen. Menschliche Casts gewinnen weiterhin, wenn tiefgreifende kulturelle Anpassung und idiomatische Darbietung Konversionen antreiben und das Publikum eine muttersprachlich klingende lokale Stimme erwartet.
Emotionale Tiefe und Vertrauen. Synthetische Stimmen sind sehr realistisch geworden und funktionieren gut für neutrale, informative Lesungen wie Tutorials und nachrichtenartige Erzählung. Vergleichende Bewertungen merken dennoch an, dass KI bei tiefen emotionalen Spannungsbögen, komplexem Charakterspiel und subtilem Humor oder Ironie zu kurz kommt. Menschliche Sprecher bleiben die bevorzugte Wahl für markenprägende Werbespots, Testimonials über echte Menschen und erzählende Hörbücher oder Podcasts, bei denen die Stimme das gesamte Erlebnis trägt.
Konsistenz und kreative Regie. KI-Ausgabe ist jedes Mal identisch, wenn Sie dasselbe Skript mit denselben Einstellungen ausführen, was für strenge Markenrichtlinien und lange Serien mächtig ist; Sie können sogar eine Markenstimme als geklontes Modell festlegen. Menschliche Darbietungen variieren leicht mit Stimmung und Umgebung — charmant für manche Marken, ein Risiko für streng kontrollierte Unternehmenserzählung. Auch die Regie unterscheidet sich: Bei KI steuern Sie über Einstellungen, Stilparameter und sofortige Neugenerierung, während ein menschlicher Sprecher Ihnen ein Live-Hin-und-Her, alternative Takes und Urteilsvermögen gibt, das ungeschickte Formulierungen auffangen oder ein Skript über eine wörtliche Lesung hinausheben kann.
Compliance und Publikumswahrnehmung. Mehrere Plattformen und Richtlinienzusammenfassungen erwarten mittlerweile, dass synthetische Medien gekennzeichnet werden, und einige Veröffentlichungsumgebungen markieren KI-Voiceover ausdrücklich als Inhalt, der offengelegt werden muss. Das Publikum neigt dazu, KI für Nutzinhalte zu akzeptieren und sich zu wehren, wenn emotionale Botschaften nicht eindeutig menschlich sind. Menschliche Voiceover benötigen in der Regel keine besondere Offenlegung, und viele Organisationen verbinden echte Stimmen weiterhin mit hochwertiger, vertrauenswürdiger Kommunikation.
Wo DubSmart AI auf dem KI-Voiceover-Weg passt
Für unsere Kernzielgruppen — YouTube-Creator, kleine Marketing-Teams, E-Learning-Produzenten, Indie-Filmemacher, Podcaster und Entwickler — ist die KI-Option kein einzelner Stimmgenerator. Es ist ein vernetzter Stack.
- Text-to-Speech verwandelt Skripte in wenigen Minuten in Erzählung über 300+ Stimmen.
- Stimmklonen wandelt Ihre Stimme oder die eines Talents in eine wiederverwendbare KI-Stimme um, sodass das Branding konsistent bleibt, ohne wiederholte Sessions.
- KI-Synchronisation übersetzt und vertont ganze Videos in 33+ Sprachen innerhalb eines Workflows.
- Speech-to-Text und der Speech Separator bereinigen Audio, transkribieren und bereiten Assets für Synchronisation oder Remixing vor.
- APIs ermöglichen es Entwicklerteams und Agenturen, Stimmgenerierung, Synchronisation und Klonen direkt in ihre Produkte einzubauen.
Zusammen behandelt dies KI-Voiceover als eine programmierbare Schicht in Ihrem Content-System statt als einmaligen Export. Diese Unterscheidung ist am wichtigsten, wenn Sie entscheiden, wie weit Sie ein einzelnes Master-Skript skalieren.
Wann KI-Voiceover die bessere Wahl ist
Greifen Sie zu KI-Voiceover, wenn Ihre Bedingungen so ausgerichtet sind:
- Sie produzieren großvolumige Informationsinhalte — Tutorials, Produkt-Walkthroughs, Erklär-Shorts —, bei denen Klarheit und Geschwindigkeit wichtiger sind als dramatische Darbietung.
- Fristen werden in Stunden oder Tagen gemessen, und Ihr Team benötigt sofortige Iteration.
- Sie möchten viele Versionen derselben Botschaft testen, mit variierenden Hooks, CTA-Formulierungen oder Länge, bevor Sie sich auf einen großen Mediaeinkauf festlegen.
- Sie benötigen viele Sprachen oder Regionen aus einem einzigen Master-Skript, ohne mehrere Sprecher zu koordinieren.
- Ihr Budget ist knapp oder variabel, und ein credit-basiertes, nutzungsorientiertes Modell passt besser zu Ihnen als menschliche Sätze pro Session.
Für Teams auf unserer Plattform lässt sich dies sauber auf die Nutzung von Text-to-Speech, Stimmklonen und KI-Synchronisation für Nutz- und skalierbare Inhalte abbilden, während Spielraum bleibt, um in menschliches Talent zu investieren, wo sich der Ertrag höher auszahlt.
Wann ein professioneller Sprecher die sicherere Wahl ist
Wählen Sie einen professionellen Sprecher, wenn die Einsätze in Richtung Emotion und Marke neigen:
- Das Ziel ist Konversion oder Überzeugung statt Information — Markenfilme, Launch-Kampagnen, Spendenvideos.
- Ihre Positionierung setzt auf Wärme, Empathie, Luxus oder hohes Vertrauen, wie im Gesundheitswesen, der Finanzbranche oder bei Premium-Konsumgütern.
- Das Skript verlangt komplexe schauspielerische Entscheidungen — Humor, Sarkasmus, Spannungsaufbau und -auflösung im Storytelling —, die KI immer noch Schwierigkeiten hat, überzeugend zu reproduzieren.
- Ihr Publikum oder Ihre Stakeholder stehen KI ausdrücklich skeptisch gegenüber, und Sie würden lieber jede Authentizitätsdebatte umgehen.
- Sie möchten Live-Zusammenarbeit, Improvisation und eine einzigartige stimmliche Persönlichkeit, die zum Synonym für Ihre Marke wird.
Selbst hier verdient KI noch eine Rolle hinter den Kulissen. Sobald die herausragende menschliche Darbietung existiert, können Sie Speech-to-Text für Untertitel und KI-Tools verwenden, um lokalisierte Varianten zu erstellen, ohne das Original neu aufzunehmen.
Wann keine der Optionen allein ausreicht
Die meisten erfahrenen Content-Teams behandeln dies nicht mehr als Entweder-oder und betreiben stattdessen eine Mischung.
Hybride Markenstrategie. Nehmen Sie wichtige Flaggschiff-Assets mit einem professionellen Sprecher oder Ihrer eigenen Stimme auf, klonen Sie dann diese Stimme, um in mehrere Sprachen zu lokalisieren und passende Spin-off-Shorts, Teaser und Schulungsmodule zu produzieren, die die ursprüngliche Stimmidentität bewahren.
Gestufte Content-Strategie. Legen Sie explizite Stufen fest und leiten Sie die Arbeit nach Wert weiter. Stufe A: menschliches Talent für Anzeigen, Launch-Trailer und Hero-Content. Stufe B: KI-Voiceover für immergrüne Tutorials, Onboarding und FAQ-Videos. Stufe C: KI-Synchronisation für internationale Varianten und neue Märkte.
Experiment-zuerst-Strategie. Prototypen Sie mit KI-Voiceover, um Wortwahl und Tempo zu verfeinern, und holen Sie dann einen professionellen Sprecher hinzu, sobald die Struktur kampferprobt ist. Das reduziert verschwendete Studiozeit und übergibt dem Sprecher ein ausgefeiltes Skript zur Darbietung.
Unser einheitlicher Workflow — Speech-to-Text, Stimmklonen, KI-Synchronisation sowie Bild- und Videowerkzeuge — ist für diese gemischten Setups gebaut, sodass Sie zwischen KI- und menschlichen Eingaben wechseln können, ohne Ihren Stack neu aufzubauen. Wenn Podcast-Lokalisierung Teil des Plans ist, zeigt unsere Anleitung dazu, wie man einen Podcast in eine andere Sprache übersetzt, dieses Routing in der Praxis.
Ihre nächste Entscheidung einordnen
Statt zu fragen, ob KI einen professionellen Sprecher übertrifft, sortieren Sie Ihre Bibliothek rund um drei Fragen: welche Projekte wirklich menschliche emotionale Tiefe erfordern, welche Kategorien mit KI standardisiert und skaliert werden können und wo eine starke menschliche Stimme durch Klonen und Synchronisation erweitert werden kann.
Für die technische Seite, wie synthetische Erzählung aufgebaut wird und wo sie neben menschlicher Darbietung steht, kombinieren Sie diesen Vergleich mit unserem Erklärstück dazu, wie KI-Voiceover erstellt werden, statt diesen Boden hier zu wiederholen.
Häufig gestellte Fragen
Wird KI-Voiceover professionelle Sprecher ersetzen?
KI hat Nutzensprechertexte und Produktion im großen Maßstab umgestaltet, aber es fehlt ihr immer noch die emotionale Nuance und interpretatorische Fähigkeit, die viele wirkungsvolle Projekte benötigen. Der praktische Ausblick lautet Koexistenz: KI übernimmt Volumen und mehrsprachige Reichweite, während menschliche Sprecher die emotional anspruchsvollste, markenkritische Arbeit tragen.
Verlangen Plattformen, dass ich KI-Voiceover offenlege?
Mehrere Plattformen und Richtlinienzusammenfassungen behandeln synthetisches Audio als Inhalt, der oft nach Regeln für synthetische Medien gekennzeichnet werden muss. Für US-Creator ist es ratsam, die aktuellen Richtlinien für YouTube, TikTok, Podcasts und OTT-Dienste zu prüfen und eine klare Offenlegung für sensible Themen oder Storytelling hinzuzufügen. Überprüfen Sie die Einzelheiten für Ihre Plattform, da sich Richtlinien ändern.
Wird KI-Erzählung meiner Marke schaden?
KI funktioniert tendenziell am besten, wenn das Markenversprechen auf Klarheit, Geschwindigkeit und Zugang ausgerichtet ist — Tutorials, E-Learning, FAQs — und der Inhalt informativ statt zutiefst emotional ist. Es kann die Wahrnehmung beeinträchtigen, wenn es für hochemotionale, Premium-Kampagnen verwendet wird, bei denen das Publikum eine einzigartig menschliche Darbietung erwartet.
Kann ich meine eigene Stimme behalten und trotzdem mit KI skalieren?
Ja. Mit Stimmklonen nehmen Sie eine kurze Probe auf, erstellen eine synthetische Version und nutzen diese über Text-to-Speech und Synchronisation. Sie behalten Ihre Identität und Persönlichkeit, während Sie die Geschwindigkeit und mehrsprachige Reichweite der KI gewinnen.
Wie sollte ich ohne eine detaillierte Preisaufschlüsselung budgetieren?
Behandeln Sie menschliche Erzählung als strategische Investition für eine begrenzte Reihe wirkungsvoller Assets und KI-Voiceover als variable Kosten, die sich an der Nutzung für alles andere orientieren. Planen Sie rund um eine feste Anzahl von menschlich geführten Flaggschiff-Projekten plus laufende KI-basierte Lokalisierung, Schulung und Social-Content, der wächst, während Ihr Kanal oder Ihre Organisation wächst.