إذا كنت تدرس استخدام تحويل النص إلى كلام من voiceforge لمشروع ما، فإن السؤال الحقيقي نادرًا ما يكون ما إذا كانت الأصوات تبدو مثيرة للاهتمام. السؤال هو ما إذا كانت الأداة تناسب طول النص الخاص بك، وحقوق النشر الخاصة بك، ونوع المحتوى الذي تصنعه فعليًا. VoiceForge هي خدمة تحويل نص إلى كلام تعمل عبر المتصفح ومبنية حول أصوات شخصيات مميزة. تحوّل النص إلى صوت قابل للتنزيل باستخدام محرك تخليق قائم على اختيار الوحدات، يجمع مقاطع كلام مسجلة من متحدثين بشريين بدلاً من توليد كل صوت من موجة رياضية واحدة. يتلخص القرار العملي في أربع احتياجات: صوت ممتع وقابل للتمييز للمشاريع الشخصية؛ أو صوت مرخّص للوسائط المربحة؛ أو تحكم دقيق في النطق والإيقاع؛ أو سير عمل متعدد اللغات قابل للتوسع. فقط الثلاثة الأولى تتوافق بسلاسة مع مولّد أصوات الشخصيات، وتلك الفجوة هي ما يتعثّر فيه معظم صنّاع المحتوى.
ننشر هذا الدليل لأن نفس الالتباس يظهر مرارًا وتكرارًا: يولّد الناس الصوت خلال فترة تجربة مجانية، ويفترضون أنه يمكنهم تحقيق الربح منه، ثم يكتشفون أن الترخيص مرتبط بخطة محددة. فيما يلي، نوضّح كيف يعمل المحرك، وما يمكنه وما لا يمكنه فعله، ومتى تكون أداة الصوت الواحد الطريفة هي الخيار الصحيح مقابل سير عمل التوطين الكامل.
جدول المحتويات
ما هو تحويل النص إلى كلام من VoiceForge فعليًا
يحوّل VoiceForge الكلمات المكتوبة إلى صوت منطوق: تُدخل نصًا، تختار صوتًا، تولّد المقطع، تعاينه، وتنزّل النتيجة عندما تسمح خطتك بذلك. ما يميّزه عن مكتبة سرد عامة هو توجّهه. يميل VoiceForge نحو الأصوات ذات الشخصية بدلاً من الأداء المؤسسي المحايد، مما يجعله مناسبًا بشكل طبيعي لمقاطع YouTube الكوميدية، ومقاطع الألعاب، والشخصيات المتحركة، والميمز، والإعلانات الطريفة، ومشاريع الموسيقى.
هذا التركيز على الشخصية أولاً هو ميزة لبعض المحتوى وعبء على محتوى آخر. يمكن لصوت كوميدي أو اصطناعي عن قصد أن يحمل محاكاة ساخرة أو شخصية غير لاعبة في لعبة، لكن الصوت نفسه يصبح مشتتًا في دورة تعليم إلكتروني، أو عرض منتج، أو إعلان علامة تجارية راقية. لذا فإن المرشّح الأول ليس "هل يبدو هذا بشريًا؟" بل "هل ينتمي هذا الصوت أمام جمهوري المحدد؟"
إذا كنت لا تزال تقرر ما إذا كان مولّد أصوات جاهز يناسب احتياجاتك على الإطلاق، فإن شرحنا حول ما يفعله مولّد الصوت بالذكاء الاصطناعي يغطي الفئة الأوسع وكيف تختلف هذه الأدوات عن الاستنساخ والدبلجة.
كيف يبني محرك اختيار الوحدات صوتًا
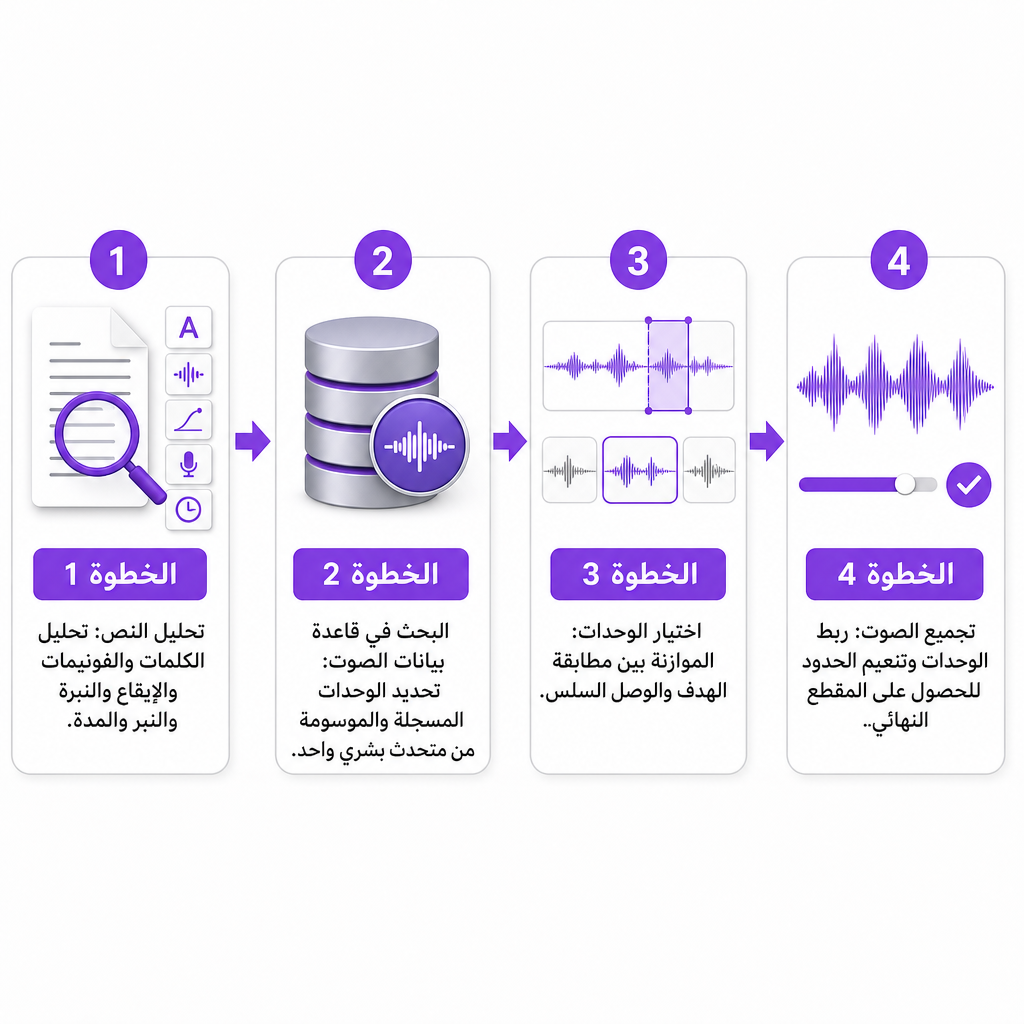
يستخدم VoiceForge تخليقًا قائمًا على اختيار الوحدات، ويُسمى أيضًا التخليق التسلسلي. بدلاً من توليد تسجيل كامل من موجة واحدة ينتجها النموذج، يبحث النظام في قاعدة بيانات من مقاطع الكلام المسجلة ويربط أنسب القطع في جملتك. فهم هذا المسار يفسّر لماذا تبدو الأصوات قابلة للتمييز ولماذا تتصرف بالطريقة التي تتصرف بها تحت الضغط.
تجري العملية عبر عدة مراحل. أولاً، تحليل النص: يحلّل المحرك الكلمات وبنية الجملة والفونيمات والإيقاع والنبرة والنبر والمدة لتحديد كيفية نطق السطر. بعد ذلك، بحث في قاعدة بيانات الصوت: كل صوت مبني من تسجيلات متحدث بشري، مُقسّمة إلى وحدات أصغر ومُصنّفة حسب الصوت والسياق. ثم اختيار الوحدات، حيث يوازن المحرك بين هدفين متنافسين في آن واحد — مطابقة الهدف، التي تختار وحدة ذات الصوت والنبرة والمدة والسياق الصحيح، والربط السلس، الذي يفضّل الوحدات المتجاورة التي تتصل دون وصلة واضحة. وأخيرًا، يجمّع تجميع الصوت التسلسل المختار معًا ويطبّق تنعيمًا خفيفًا عند الحدود.
لأن الناتج مُجمّع من تسجيلات حقيقية، يحتفظ كل صوت بهوية مميزة. والمقايضة هي أن هذه الطريقة لم تُصمّم لتقديم توجيه عاطفي غير محدود أو الأداء القابل للتعديل بالكامل المرتبط بالأنظمة التوليدية الأحدث. يمكن للصياغات غير المعتادة، أو التحولات السريعة، أو تركيبات النطق الصعبة أن تكشف الوصلات بين الوحدات، منتجةً نتائج تبدو أقل اتساقًا من أداء بشري متواصل. إذا كنت تريد معرفة كيف يختلف المسار التوليدي الكامل، فإن تفصيلنا حول كيف يعمل تحويل النص إلى كلام العصبي يستعرض نهج التعلّم العميق الذي يحل محل التسلسل.
الأصوات و SSML وحد الـ 500 حرف
يسرد VoiceForge 42 صوتًا فريدًا، كل منها مسجّل بواسطة متحدث مختلف بنبرة وأسلوب كلام خاصين به. وهذا كافٍ عندما يكون الصوت نفسه جزءًا من المفهوم الإبداعي — راوٍ كوميدي لمقطع قصير، أو شخصية غريبة لفيديو ألعاب، أو نبرة اصطناعية لميم. لكنه كتالوج أصغر بالنسبة للفرق التي تحتاج إلى العديد من المتغيرات الإقليمية أو راوٍ مطابق بعناية عبر عدة أسواق.
للتحكم في الأداء، يدعم VoiceForge مجموعة فرعية من لغة ترميز تخليق الكلام (SSML). بدلاً من الاعتماد على علامات الترقيم وحدها، تضمّن التعليمات مباشرة في النص.
| تحكم SSML | ما يفعله |
|---|---|
<break> |
يُدرج توقّفًا |
<emphasis> |
يشدّد على كلمة أو عبارة |
<prosody> |
يضبط النبرة أو سرعة الكلام أو مستوى الصوت |
<phoneme> |
يفرض نطقًا دقيقًا |
<sub> |
ينطق بديلاً للنص المرئي |
<p> / <s> |
يحدّد فقرة أو جملة |
تثبت هذه الوسوم جدواها عندما يسيء المحرك قراءة اسم منتج، أو اختصار، أو مصطلح تقني. إحاطة اختصار بـ <sub alias="application programming interface">API</sub> يجعله ينطق العبارة الكاملة، و <phoneme> يثبّت اسمًا صعبًا. وإضافة <break time="500ms"/> بين السطور تضيف وقفة مقصودة حيث لن تفعلها علامات الترقيم.
وهنا المشكلة التي تعيد تشكيل كيفية كتابتك له: إدخال النص محدود بـ 500 حرف، وترميز SSML يُحتسب ضمن هذا الحد. كل وسم تضيفه يلتهم من المساحة المتاحة للكلمات الفعلية. يجب تقسيم السرد الطويل إلى عمليات توليد متعددة، والترميز الكثيف يقلّص كل جزء أكثر. عمليًا، يعني ذلك التخطيط لنصك في مقاطع قصيرة ومكتفية ذاتيًا بدلاً من لصق صفحة كاملة.
التجربة المجانية مقابل الترخيص التجاري: القرار المهم
يقدّم VoiceForge تجربة مجانية محدودة، لكن التجربة ليست ترخيص نشر. تضع خططه خطًا واضحًا بين الاستخدام الشخصي والتجاري، وذلك الخط هو حيث تحدث معظم الأخطاء.
طبقة Fan Voice مخصصة للنكات، والفيديوهات، والألعاب، والرسوم المتحركة، والميمز غير المربحة. خطة Publisher هي الاشتراك الذي يمنح ترخيصًا تجاريًا لصوت TTS في المحتوى المربح أو التجاري — الفيديوهات المربحة، والألعاب المستقلة، والموسيقى — وتعلن عن تنزيلات غير محدودة. تُوجد التجربة المجانية لتتمكن من اختبار الخدمة قبل الالتزام.
القاعدة التشغيلية بسيطة: إذا كان المشروع يحقق مالًا، أو يروّج لعمل تجاري، أو يظهر في وسائط مربحة، أو يُنشر تجاريًا، فتحقق من الخطة المناسبة قبل أن تنشر. الصوت الذي تولّده أثناء التجربة المجانية لا يحمل تلقائيًا حقوقًا تجارية لمجرد أنه تم تنزيله. يمكن أيضًا أن تتغير صياغة الترخيص، لذا فإن صفحة الخطة هي نقطة بداية، وليست بديلاً عن مراجعة خاصة بالمشروع عندما تكون المخاطر عالية — تسليم للعميل، أو إعلان مدفوع، أو حملة تحمل علامة تجارية، أو إصدار تطبيق.
نقاط القوة والقيود للمشاريع الحقيقية
تتجمع نقاط قوة VoiceForge حول الشخصية والبساطة. تبرز أصوات الشخصيات عندما تكون النبرة جزءًا من النكتة أو هوية القناة. ولأن الأساس هو كلام بشري مسجّل، تحتفظ الأصوات بخصائص صوتية طبيعية وهوية قابلة للتمييز. وتمنحك عناصر التحكم في النطق عبر SSML سيطرة حقيقية على الاختصارات والأسماء والمصطلحات الغريبة. وتجعل خطة Publisher مسألة الاستخدام التجاري أكثر وضوحًا من الأدوات التي تفصل الوصول إلى التوليد عن تفاصيل الترخيص.
القيود ملموسة بالقدر نفسه. يفرض حد الـ 500 حرف على النصوص الطويلة أن تكون عمليات توليد صغيرة كثيرة، والترميز يجعل كلًا منها أقصر. وكتالوج الـ 42 صوتًا متواضع بجانب المكتبات الكبيرة، وهو ما يهم إذا كنت تحتاج إلى مئات الخيارات أو العديد من اللهجات الإقليمية. والأسلوب الذي يركز على الشخصية والذي يتألق في الترفيه قد يضعف المحتوى القانوني أو الطبي أو التعليمي أو محتوى العلامات التجارية الراقية. ومن السهل الوقوع في قيود الخطة، لأن القدرة على توليد الصوت ليست مثل الحق في تحقيق الربح منه. ولأن المحرك يربط وحدات مسجلة، يمكن لبعض الصياغات أن تُظهر عيوب الربط التي لن يُظهرها تسجيل متواصل.
لا شيء من هذه مُفسد بحد ذاته. إنها ببساطة تحدّد النقطة المثالية: مقاطع قصيرة، تقودها الشخصية، أحادية اللغة حيث يكون الصوت هو الهدف.
متى يناسب صوت الشخصية ومتى يتفوق سير عمل التوطين
VoiceForge هو الخيار الصحيح عندما تكون شخصية الصوت محورية، وتنقسم نصوصك بسلاسة إلى مقاطع قصيرة، وتحتاج إلى تحكم أساسي في النطق والإيقاع، وتنتج فيديوهات، أو ميمز، أو رسومًا متحركة، أو موسيقى، أو محتوى ألعاب مستقلة — سواء كان شخصيًا (Fan Voice) أو مربحًا بالاشتراك المناسب.
يخدمك سير عمل أوسع بشكل أفضل عندما تحتاج إلى راوٍ محايد مصقول، أو العديد من اللغات واللهجات، أو صوتك المستنسخ الخاص، أو سرد طويل، أو تحديثات تجارية متكررة، أو تكامل API، أو أصوات متسقة عبر كتالوج كبير حيث تكون الموثوقية أهم من الطرافة. تُوضّح قناة تتوسع دوليًا هذا الانقسام جيدًا: قد يوفّر VoiceForge صوت الشخصية لمقطع كوميدي باللغة الإنجليزية، بينما ينتج إعداد TTS ودبلجة متعدد اللغات النسخ المحلية لجماهير أخرى.
هذا السيناريو الثاني هو ما نركز عليه. تقدّم أداة تحويل النص إلى كلام لدينا أكثر من 300 صوت بالذكاء الاصطناعي، وتعليقات صوتية متعددة اللغات، وعناصر تحكم في سرعة الكلام، ومشاريع قابلة للتنزيل مبنية للإنتاج وليس للطرافة العابرة. يمكن لصنّاع المحتوى الذين يريدون الحفاظ على هويتهم الخاصة عبر كل فيديو استخدام استنساخ الصوت بدلاً من الاكتفاء بشخصية جاهزة، ويمكن للمطورين الذين يحتاجون إلى توليد الكلام داخل تطبيق البناء على واجهة برمجة تطبيقات تحويل النص إلى كلام الخاصة بنا. وعندما يكون الهدف تحويل مقطع واحد إلى إصدار محلي كامل، تنقل الدبلجة بالذكاء الاصطناعي النص نفسه عبر لغات إضافية في مكان واحد.
قائمة تحقق للجودة قبل النشر
قبل أن تنشر صوت VoiceForge، قم بمراجعة سريعة للأشياء التي تتعطل أكثر من غيرها. توليد مقاطع اختبار قصيرة أولاً يستحق الدقائق الإضافية القليلة، لأن الصوت الذي ينجح في جملة واحدة قد يصبح مُرهقًا أو مشتتًا عبر فيديو كامل.
- النطق: هل تُنطق الأسماء والاختصارات والأرقام والمصطلحات التقنية بشكل صحيح؟
- الإيقاع: هل تقع الوقفات بشكل طبيعي، وليس في منتصف العبارة؟
- اتساق الشخصية: هل يناسب الصوت نفسه كل مشهد، وليس فقط المقدمة؟
- الانتقالات الصوتية: هل توجد قفزات مسموعة بين المقاطع المولّدة بشكل منفصل؟
- الترخيص: هل تغطي خطتك الحالية فعليًا الاستخدام المربح أو التجاري؟
- ملاءمة الجمهور: هل أسلوب الشخصية مناسب للمنصة والموضوع؟
- المحاذاة: هل يتناسب الصوت بسلاسة مع فيديوك أو موسيقاك أو حوار لعبتك؟
- الحقوق: هل لديك إذن لأي نص أو اسم أو مرجع طرف ثالث مُقدّم في الصوت؟
الأسئلة الشائعة
ما هو تحويل النص إلى كلام من VoiceForge؟
إنه خدمة تعمل عبر المتصفح تحوّل النص المكتوب إلى صوت منطوق باستخدام مكتبة من أصوات الشخصيات المميزة. يعتمد على تخليق اختيار الوحدات، الذي يجمّع مقاطع كلام مسجلة من قواعد بيانات صوت بشري بدلاً من توليد الصوت من موجة نموذج واحدة.
هل VoiceForge مولّد بالذكاء الاصطناعي؟
إنه خدمة تخليق كلام، لكن طريقته الموثّقة هي اختيار الوحدات، وليست نظام صوت عصبي توليدي بالكامل. يختار المحرك ويربط وحدات كلام بشري مسجلة لإنتاج كل نطق.
كم عدد أصوات VoiceForge المتاحة؟
يسرد VoiceForge 42 صوتًا فريدًا، كل منها مرتبط بمتحدث مختلف وشخصية صوتية مختلفة.
ما هو حد الأحرف في VoiceForge؟
توثّق الخدمة حدًا قدره 500 حرف لكل إدخال نصي، وأي ترميز SSML تضيفه يُحتسب ضمن هذا الحد. تحتاج النصوص الأطول إلى تقسيمها إلى عمليات توليد متعددة.
هل يمكنني استخدام صوت VoiceForge على YouTube؟
يمكنك ذلك، لكن المحتوى المربح يتطلب الاشتراك التجاري المناسب. تُوصف خطة Publisher بأنها الترخيص لصوت TTS المستخدم في المحتوى المربح أو التجاري، لذا تحقق من خطتك قبل نشر فيديو مربح.
هل VoiceForge هو نفسه استنساخ الصوت؟
لا. يستخدم VoiceForge مكتبة الأصوات الموجودة لديه، بينما يُنشئ استنساخ الصوت صوتًا اصطناعيًا مخصصًا من تسجيلات مصرّح بها لمتحدث محدد. نشرح ذلك السير المنفصل في صفحة استنساخ الصوت.