يتلخّص الاختيار بين تحويل النص إلى كلام مقابل استنساخ الصوت للسرد في سؤال صريح واحد: هل تحتاج إلى صوت موثوق للمحتوى، أم إلى هوية متحدّث محدّد فيه؟ يمنحك تحويل النص إلى كلام القياسي سردًا سريعًا ومرنًا من مكتبة جاهزة. أما استنساخ الصوت فيعيد إنشاء صوت معروف بحيث يبدو أن الشخص نفسه يتحدث عبر نصوص وفيديوهات ولغات جديدة. بالنسبة لكثير من المبدعين والفرق، القرار الذكي هو كلاهما: ابنِ نموذجًا أوليًا بصوت جاهز من أجل السرعة، ثم انتقل بالعمل المعتمد إلى نسخة مستنسخة بموافقة بمجرد أن تبدأ هوية العلامة التجارية أو استمرارية المتحدّث بالتأثير. يوضّح باقي هذا الدليل بدقة أين يتفوق كل منهما.
جدول المحتويات
أسرع طريقة للتوقف عن الدوران في حلقة مفرغة بشأن هذا الاختيار هي فصل شيئين يخلط الناس بينهما باستمرار: أسلوب الصوت والهوية الكامنة خلفه. يمنحك صوت تحويل النص إلى كلام القياسي أسلوبًا جاهزًا للإنتاج. يمكنه القراءة بدفء أو سلطة أو حيوية أو بأسلوب حواري أو محايد، وتختاره لأنه يناسب النص. أما الصوت المستنسخ فيمنحك استمرارية مع شخص بعينه. يتعرف عليه المستمعون باعتباره مبدعًا أو مدرّبًا أو مؤسسًا أو راويًا، وتختاره لأن هذه الهوية جزء من المنتج.
هذا الفرق يغيّر أكثر من مجرد كيف يبدو المقطع. إنه يغيّر عبء عملك التشغيلي. الأسلوب شيء تبدّله بحرية؛ الهوية شيء تحميه وتوثّقه وتحافظ على اتساقه عبر كل ملف جديد. ضع هذا الانقسام في ذهنك وستجيب معظم القرارات أدناه عن نفسها.
كيف يعمل سرد تحويل النص إلى كلام فعليًا
يحوّل تحويل النص إلى كلام النص المكتوب إلى كلام مُركّب. يقرأ النظام نصك، ويفسّر النطق وبنية الجملة، ويُنتج مسارًا صوتيًا بصوت تختاره من كتالوج. أنت لا تلتقط شخصًا محددًا يقرأ الكلمات؛ بل تولّد كلامًا جديدًا بأسلوب صوت مُعدّ مسبقًا.
عمليًا، تتحكم في مجموعة من العوامل: اللغة، واللكنة، والملف الصوتي، والنبرة، وسرعة التحدث، وأسلوب الأداء. هذه المرونة هي الغاية بأكملها. عندما يتغير سعر أو اسم منتج أو إحصائية أو درس، تعدّل النص وتعيد توليد القسم المتأثر فقط بدلًا من حجز استوديو من جديد. تعمل أداة تحويل النص إلى كلام لدينا على تشغيل هذه الحلقة من البداية إلى النهاية: أدخل النص، اختر متحدثًا من أكثر من 300 صوت بالذكاء الاصطناعي، ولّد، وعدّل المشروع، ونزّل، مع عناصر تحكم في سرعة الكلام وإشارات نصية للتأكيد.
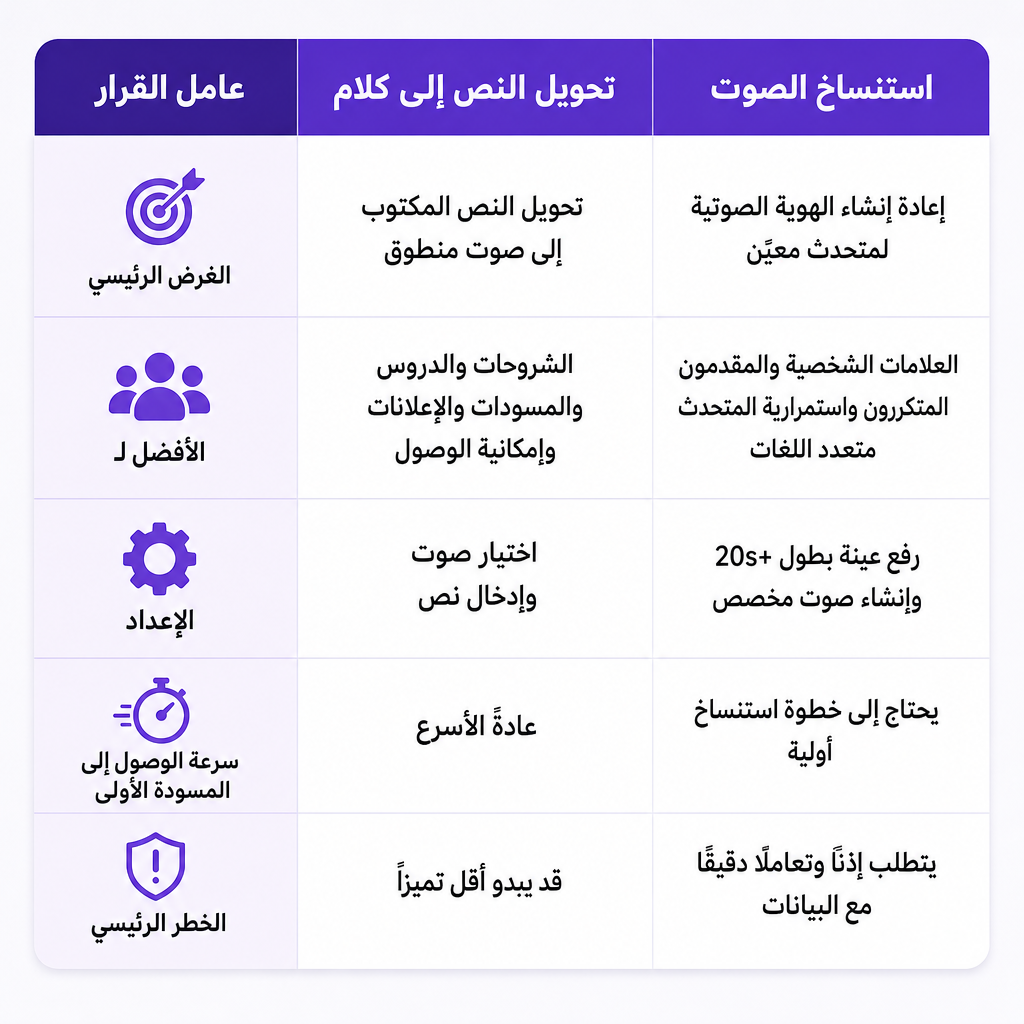
استخدم تحويل النص إلى كلام القياسي عندما لا يكون من الضروري أن يكون الصوت نفسه معروفًا. إنه يناسب المسودات الأولى والنسخ التجريبية، والقنوات التي تنشر بكثرة وتحتاج إلى تحديثات سريعة، وسير العمل حيث يكتب عدة أشخاص النصوص أو يديرونها، والمحتوى الذي يتطلب أصواتًا مختلفة عبر الشخصيات أو الأقسام. كما أنه الخيار الطبيعي عندما تريد اختبار عدة لغات أو لكنات أو أساليب أداء، أو عندما تنتج مواد تعليمية ومعلوماتية وموجهة لإمكانية الوصول. على سبيل المثال، يمكن لشركة صغيرة تنشر دروسًا أسبوعية عن المنتجات أن تحافظ على صوت جاهز متسق واحد وتحدّث الميزات ودعوات اتخاذ الإجراء دون الحاجة إلى تنسيق أي تسجيل.
كيف يعمل سرد استنساخ الصوت فعليًا
يبني استنساخ الصوت كلامًا مُركّبًا يشبه شخصًا محددًا. يحلل النظام عيّنة من حيث النطق ودرجة الصوت والإيقاع والنبرة وأسلوب التحدث، ثم يستخدم هذه الخصائص لتوليد كلام جديد من النص. هذا ليس قصّ تعليق صوتي جاهز ضمن خط زمني. بل ينتج نموذج صوت قابلًا لإعادة الاستخدام يمكنه نطق نصوص لم يسجّلها المتحدث قط.
تقوم العينة بمعظم العمل الشاق. تشير صفحة استنساخ الصوت لدينا إلى أنه يمكنك إنشاء صوت مخصص من ملف صوتي لا تقل مدته عن 20 ثانية، وأن التسجيل النظيف الخالي من الضوضاء الخلفية يعطي نتائج أفضل. ينتقل أسلوب التحدث في ذلك التحميل إلى المخرجات: المرجع الرتيب يميل إلى إنتاج سرد أكثر رتابة، بينما العينة المفعمة بالطاقة والعاطفة التي تريدها فعلًا تمنح النموذج هدفًا أقوى. بمجرد إنشائه، يمكن إعادة استخدام الصوت في مشاريع تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي على حد سواء.
اختر الاستنساخ عندما تكون هوية المتحدث جزءًا من العلامة التجارية أو المنتج. إنه يناسب مقدّم يوتيوب الذي يحتاج إلى النشر بشكل أكثر تكرارًا دون تسجيل كل سطر، ومقدّم بودكاست يصحّح أقسامًا صغيرة بدلًا من إعادة تسجيل حلقة، وشركة تريد صوت مؤسس أو مدرّب متسق واحد، ودورة يجب أن تحمل المدرّب نفسه عبر لغات متعددة. يمكن لمعلّم عبر الإنترنت أن يسجّل عينة نظيفة مرة واحدة، ثم يستخدم نسخة مستنسخة بموافقة لتحديث الدروس أو تصحيح الحقائق القديمة أو بناء نسخ للمتعلمين الدوليين. للاطلاع بتعمّق على إعادة استخدام هوية عبر الصيغ المختلفة، راجع دليلنا حول الدبلجة بالذكاء الاصطناعي مقابل استنساخ الصوت لإعادة توظيف المحتوى.
الانقسام الجوهري: أسلوب الصوت أم هوية الصوت
إذا لم تتذكر أي شيء آخر، فتذكّر هذا الإطار، لأنه يحسم معظم الحالات الحدية أسرع من أي جدول ميزات. تحويل النص إلى كلام القياسي مشكلة اختيار: أنت تختار أسلوبًا من على الرف، ويمكنك تغيير رأيك الأسبوع المقبل دون أي تكلفة. الاستنساخ التزام باستمرارية: أنت تثبّت هوية واحدة وتوافق على صيانتها وإدارتها والدفاع عنها مع مرور الوقت.
لهذا السبب تتصرف علامة تجارية يقودها مؤسس بشكل مختلف عن قناة شرح بلا وجه حتى عندما تبدو النصوص متطابقة. قناة الشرح تحتاج فقط إلى صوت كفؤ، لذا يتولى تحويل النص إلى كلام المهمة. أما علامة المؤسس فتعتمد على التعرف، لذا يصبح الصوت المستنسخ أصلًا يستحق الإعداد الإضافي والأوراق. عندما تشعر بأنك عالق، اسأل نفسك هل سيؤذي تبديل الصوت الشهر المقبل علاقة الجمهور بالمحتوى. إذا كان الجواب نعم، فأنت في منطقة الاستنساخ. للمقارنة الأدق بين هذين المسارين وجهًا لوجه، يفصّل شرحنا حول الاختيار بين صوت مستنسخ وصوت تحويل نص إلى كلام جاهز المعايير بمزيد من العمق.
أيهما تستخدم، حسب هدف الإنتاج
يتغير الجواب الصحيح بحسب ما تصنعه فعليًا. إليك كيف يستقر الاختيار عبر أكثر مهام السرد شيوعًا.
مبدعو يوتيوب. يناسب تحويل النص إلى كلام القنوات بلا وجه، ومقاطع الشرح، وفيديوهات القوائم، والمحتوى بأسلوب الأخبار حيث لا توجد هوية مقدّم على المحك. يناسب الاستنساخ القنوات التي يربطها المشاهدون بمقدّم محدد، مما يتيح لك الحفاظ على الصوت المعروف مع تجنّب إعادة التسجيل للتصحيحات والمقدمات والصيغ القصيرة. للتوسع متعدد اللغات، اقرن صوتًا مخصصًا مع الدبلجة بالذكاء الاصطناعي بدلًا من ابتكار هوية سرد منفصلة لكل لغة.
الشركات الصغيرة وفرق التسويق. اعتمد على تحويل النص إلى كلام لتنويعات الحملات، ومقاطع شرح المنتجات، والإعلانات الاجتماعية، والتغييرات المتكررة في النصوص. استعن بالاستنساخ عندما يكون المؤسس أو السفير أو المتحدث الرسمي محوريًا للثقة. يمكن لنسخة مستنسخة أن تنطق تنويعات نصوص معتمدة، لكنها لا تحلّ أبدًا محل مراجعة الادعاءات والنطق ونبرة العلامة التجارية.
التعلّم الإلكتروني والتدريب المؤسسي. يتألق تحويل النص إلى كلام عندما تمتد الدورات عبر وحدات أو مواضيع كثيرة أو تحديثات متكررة، لأن الأصوات الجاهزة تسهّل تعيين أصوات مختلفة لدورات أو أدوار مختلفة. يناسب الاستنساخ البرامج التي يتوقع فيها المتعلمون مدرّبًا واحدًا طوال الوقت، أو حيث تحدّث دورة قائمة دون فقدان الهوية الصوتية المألوفة. في كلتا الحالتين، تبقى المراجعة البشرية للأسماء والمصطلحات التقنية والاختصارات والأرقام ضرورية.
البودكاست والأفلام المستقلة. استخدم تحويل النص إلى كلام للمسارات التجريبية، واختبارات السرد، والعمل المؤقت قبل تثبيت المتحدث النهائي. استخدم الاستنساخ للّقطات الإضافية المتسقة، أو النسخ البديلة، أو التوطين المعتمد لمقدّم أو مؤدٍّ، مع توثيق الحقوق والاستخدام المقصود قبل بدء الإنتاج.
المطورون والوكالات. عادةً ما يكون تحويل النص إلى كلام نقطة دخول أبسط لواجهة البرمجة: أرسل النص، اختر صوتًا، استقبل الكلام. يناسب الاستنساخ التطبيقات التي تحتاج إلى أصوات مخصصة دائمة لكل عميل أو علامة تجارية أو شخصية. تقبل واجهة برمجة استنساخ الصوت لدينا التحميلات بصيغ MP3 وWAV وAAC وM4A وFLAC، وتُرجع صوتًا مخصصًا يمكنك الإشارة إليه في تحويل النص إلى كلام أو الدبلجة بالذكاء الاصطناعي، وتوفّر عمليات لسرد الأصوات المخصصة وحذفها.
أيهما يبدو أكثر طبيعية
ليس أي من الخيارين هو الخيار الطبيعي تلقائيًا. يمكن لصوت جاهز عالي الجودة أن يتفوق بسهولة على نسخة مستنسخة مبنية من صوت مشوّش، والعينة السيئة تعيد إنتاج عيوبها الخاصة: طنين خلفي، وأداء غير متسق، ونبرة عاطفية لا تطابق النص. الطبيعية هي مخرج تختبره، لا تسمية تفترضها.
احكم على النتيجة وفق معايير ملموسة بدلًا من الانطباع الأول:
- النطق: هل ينطق الأسماء والاختصارات والأرقام والمصطلحات التقنية بشكل صحيح؟
- التنغيم: هل يناسب الإيقاع النص؟
- الاتساق: هل يبقى الصوت ثابتًا عبر المقاطع واللغات؟
- العاطفة: هل يطابق الأداء الغرض من السرد؟
- الوضوح: هل هو مفهوم على الهواتف وأجهزة الكمبيوتر المحمولة وسماعات الرأس؟
- قابلية التحرير: هل يمكنك إعادة توليد جملة واحدة دون أن ينحرف المسار بأكمله؟
- التوطين: هل لا يزال يناسب عند تكييفه لسوق آخر؟
بالنسبة لتحويل النص إلى كلام، جرّب عدة أصوات جاهزة على الفقرة نفسها وقارن. بالنسبة للاستنساخ، اختبر نصًا تمثيليًا يحتوي على الكلمات الصعبة والنطاق العاطفي والإيقاع للمشروع النهائي، وليس مجرد تحية قصيرة. التحية تبدو جيدة دائمًا تقريبًا؛ العمل الحقيقي هو حيث تكشف النسخ المستنسخة عن نقاط ضعفها.
الحقوق والموافقة والإفصاح التي لا يمكنك تجاوزها
يحمل الاستنساخ مسؤولية لا يحملها تحويل النص إلى كلام العادي، لأنه قادر على إعادة إنتاج صوت شخص يمكن التعرف عليه. لا تستنسخ صوتًا إلا عندما تملك الإذن والحقوق للاستخدام المقصود، واجعل ذلك الإذن محددًا. الموافقة الجيدة تشمل من يملك التسجيل المصدر، وأين قد يظهر الصوت المركّب، وما إذا كان الاستخدام التجاري مسموحًا، وأي اللغات والأقاليم مشمولة، وما إذا كان الإعلان أو الدبلجة مسموحًا، وكم تدوم مدة الإذن، وكيف يُخزَّن النموذج والملفات المصدر، وماذا يحدث عند انتهاء الترخيص.
نحن نتعامل مع الموافقة والاستخدام الأخلاقي كجزء من نهجنا في استنساخ الصوت، وتدعم واجهة برمجتنا حذف الأصوات المخصصة وبياناتها الصوتية المرتبطة بها. تأكد من الشروط الحالية المطبقة على حسابك ومشروعك قبل تحميل عينة. الخلفية القانونية لا تزال متحركة أيضًا: حدّد مكتب حقوق التأليف والنشر الأمريكي النسخ الصوتية الواقعية باعتبارها نسخًا رقمية، وأوصى بحماية فيدرالية إضافية ضد النسخ غير المصرّح بها، كما هو موضح في تقريره حول حقوق التأليف والنشر والنسخ الرقمية.
هناك أيضًا طبقة إفصاح. إرشادات يوتيوب حول الإفصاح عن المحتوى المُولّد بالذكاء الاصطناعي تصنّف التوليد الاصطناعي لصوت شخص لسرد فيديو باعتباره محتوى معدّلًا أو مركّبًا واقعيًا يجب على المبدعين الإفصاح عنه. لذا لا تقدّم صوتًا مستنسخًا على أنه تسجيل غير معدّل إذا كان ذلك قد يضلّل المشاهدين. حذّرت لجنة التجارة الفيدرالية بشكل منفصل من أن استنساخ الصوت يجعل عمليات احتيال انتحال الشخصية أكثر مصداقية، وهو بالضبط سبب كون التصريح والاستخدام الشفاف ليسا رفاهيات اختيارية.
قاعدة قرار يمكنك تطبيقها اليوم
إذا كان الجمهور يحتاج إلى صوت جيد، اختر تحويل النص إلى كلام. إذا كان الجمهور يحتاج إلى هذا المتحدث بعينه، اختر استنساخ الصوت.
ابدأ بتحويل النص إلى كلام عندما تطغى السرعة والتنوع والتجريب والتغييرات المتكررة في النص. فهو أسرع في الاختبار وأسهل في المراجعة ويفتح نطاقًا واسعًا من الأصوات دون الحاجة إلى أي عينة. انتقل إلى الاستنساخ عندما يكون التعرف والاستمرارية وهوية المتحدث هي الغاية، مثل قناة يقودها مبدع، أو دورة يقودها مدرّب، أو علامة تجارية يقودها مؤسس، أو مقدّم بودكاست، أو متحدث رسمي متعدد اللغات. استخدم فقط عينة مصرّح بها، وراجع الصوت المُولّد عن كثب، واتبع قواعد الإفصاح حيثما تنطبق.
تستقر فرق كثيرة على كليهما، وعن عمد: ابنِ نموذجًا أوليًا بصوت جاهز، ثم انقل المحتوى المعتمد والمتكرر إلى صوت مخصص بمجرد أن يبرّر الإنتاج الإعداد. هذا النهج الهجين فعّال بشكل خاص لقنوات يوتيوب والدورات عبر الإنترنت والحملات ذات العلامة التجارية والمكتبات متعددة اللغات. نحن نجمع كليهما في سير عمل واحد، بحيث يمكنك البدء بسرد مرن من أكثر من 300 صوت، وإنشاء أصوات مخصصة من عينات صوتية، وإعادة استخدامها في تحويل النص إلى كلام أو الدبلجة بالذكاء الاصطناعي مع نضوج المشروع.
الأسئلة المتكررة
هل استنساخ الصوت هو نفسه تحويل النص إلى كلام؟
لا. يحوّل تحويل النص إلى كلام النص المكتوب إلى كلام باستخدام صوت مركّب مختار. أما استنساخ الصوت فيُنشئ نموذج صوت مخصصًا يُقصد به أن يشبه متحدثًا بعينه، والذي يمكنه بعد ذلك توليد سرد بتحويل النص إلى كلام.
هل تحويل النص إلى كلام أفضل من استنساخ الصوت؟
ليس على نحو مطلق. عادةً ما يتفوق تحويل النص إلى كلام في السرعة وتنوع الأصوات والاختبار والتحديثات المتكررة. يتفوق الاستنساخ عندما يجب أن تبقى هوية متحدث محدد متسقة عبر المحتوى الجديد.
كم مقدار الصوت المطلوب لاستنساخ صوت باستخدام DubSmart؟
تقول صفحة استنساخ الصوت لدينا إن التحميل يجب أن يحتوي على 20 ثانية من الصوت على الأقل. يُوصى بتسجيل نظيف بلا ضوضاء خلفية للحصول على نتائج أفضل.
هل يمكنني استخدام صوت مستنسخ للسرد متعدد اللغات؟
نعم. يمكن إعادة استخدام الأصوات المستنسخة في الدبلجة بالذكاء الاصطناعي عبر اللغات التي ندعمها. اختبر النطق والملاءمة الثقافية في كل سوق مستهدف قبل النشر.
هل ينبغي لمبدعي يوتيوب الإفصاح عن السرد بالذكاء الاصطناعي؟
تحقق من عناصر تحكم الإفصاح الحالية في يوتيوب. يصنّف يوتيوب التوليد الاصطناعي لصوت شخص للسرد باعتباره محتوى معدّلًا أو مركّبًا واقعيًا قد يتطلب الإفصاح.