نادراً ما تتطلب إعادة استخدام المحتوى لجمهور جديد تقنية الصوت نفسها مرتين، وهذا بالضبط هو سبب تكرار طرح سؤال الدبلجة بالذكاء الاصطناعي مقابل استنساخ الصوت لإعادة الاستخدام. إليك الإجابة المختصرة التي نقدمها للمبدعين والفرق كل أسبوع: الدبلجة بالذكاء الاصطناعي تُوطّن قطعة محتوى موجودة، بينما استنساخ الصوت يحافظ على هوية متحدث معين عندما تُنشئ كلاماً جديداً أو مترجماً. أحدهما سير عمل توطين. والآخر قدرة على هوية الصوت. وغالباً ما يتداخلان بما يكفي لدرجة أن الإعداد الإنتاجي الأكثر شيوعاً يستخدم كليهما فعلياً.
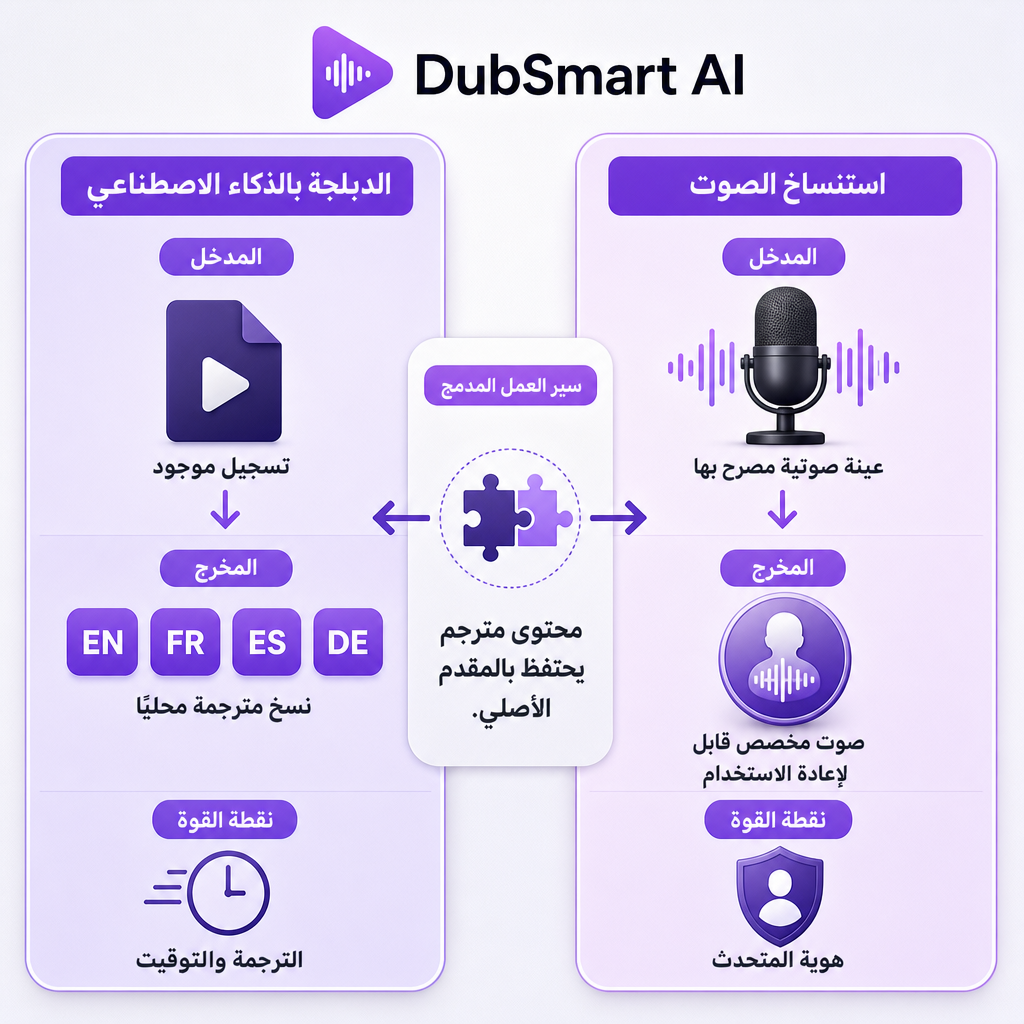
الدبلجة بالذكاء الاصطناعي تُوطّن قطعة محتوى موجودة. استنساخ الصوت يحافظ على هوية المتحدث عند إنشاء كلام جديد أو مترجم.
يحدد هذا التقسيم تقريباً كل شيء لاحقاً: جدولك الزمني، وعملية مراجعتك، وأوراق الحقوق الخاصة بك، وما إذا كنت ستلجأ إلى استوديو المتصفح أو واجهة برمجة التطبيقات. أدناه نعرّف كل تقنية، ونوضح أين تلتقيان، ونمنحك إطار قرار يمكنك تطبيقه على مهمة إعادة استخدام حقيقية اليوم.
جدول المحتويات
الفرق الجوهري، في نظرة واحدة
بعيداً عن التسويق، تجيب التقنيتان على أسئلة مختلفة. تسأل الدبلجة بالذكاء الاصطناعي: كيف أجعل هذا التسجيل الموجود مفهوماً بلغة أخرى؟ ويسأل استنساخ الصوت: كيف أجعل كلاماً جديداً يبدو كصوت هذا المتحدث المصرّح به؟ الجدول أدناه يبقي هذين المسارين واضحين قبل أن نتعمق أكثر.
| الدبلجة بالذكاء الاصطناعي | استنساخ الصوت |
|---|---|
| تحوّل المحتوى المنطوق الموجود إلى لغة أخرى أو نسخة موطّنة | تُنشئ كلاماً اصطناعياً جديداً يشبه متحدثاً معيناً |
| تبدأ بفيديو أو ملف صوتي أو تسجيل مصدر | تبدأ بعينة صوتية مصرّح بها |
| تجمع بين النسخ والترجمة وتوليد الصوت والتوقيت واستبدال الصوت | تجمع بين تحليل الصوت وإنشاء النموذج وتوليد النص إلى كلام |
| الأفضل للنسخ متعددة اللغات من المحتوى الموجود | الأفضل للحفاظ على هوية المتحدث عبر النصوص والصيغ الجديدة |
| قد تعيّن أو تستنسخ أصواتاً للمتحدثين أثناء الدبلجة | تُنتج صوتاً مخصصاً قابلاً لإعادة الاستخدام لمشاريع TTS أو الدبلجة |
التداخل في هذا الصف الأخير هو حيث يبدأ الالتباس. يمكن أن يعيش الصوت المستنسخ داخل سير عمل الدبلجة، مما يجعل الاستنساخ مكوناً محتملاً للدبلجة بدلاً من منافس لها. إذا كنت تريد المقارنة الكاملة من حيث التكلفة والسرعة والامتثال، فإن تحليلنا لـالدبلجة بالذكاء الاصطناعي مقابل الدبلجة البشرية يغطي جانب الطاقم في هذا الاختيار.
ما تفعله الدبلجة بالذكاء الاصطناعي فعلياً
الدبلجة بالذكاء الاصطناعي هي أكثر من مجرد تحويل النص إلى كلام موجّه إلى نص مكتوب. عليها أن تفهم تسجيلاً موجوداً وتنتج أداءً بديلاً يناسب المشهد الأصلي. يربط خط الإنتاج النموذجي عدة مراحل: تحويل الكلام إلى نص لالتقاط ما يقوله كل متحدث، واكتشاف المتحدثين أو فصلهم للحفاظ على تمييز الأصوات وعزل الحوار عن الصوت الخلفي، والترجمة الآلية للنص، وتوليف الصوت باللغة المستهدفة، وضبط التوقيت بحيث يناسب الحوار الجديد المونتاج، ومزج صوتي يوازن بين الكلام والموسيقى والأجواء المحيطة. استنساخ صوت المتحدث الأصلي هو مرحلة إضافية اختيارية، وليست متطلباً.
تخيّل مبدعاً أمريكياً لديه درس تعليمي لمنتج باللغة الإنجليزية ويريد نسخاً بالإسبانية والفرنسية والألمانية. الهدف ليس نصاً جديداً. بل هو الحفاظ على معنى الفيديو الأصلي وبنيته وتوقيته مع فتحه لجماهير جديدة. يقبل سير عمل الدبلجة بالذكاء الاصطناعي لدينا فيديو أو ملفاً صوتياً تم تحميله، أو رابط YouTube، ثم يتيح لك تحرير المتحدثين والنص والتوقيتات والصوت قبل التنزيل. يدعم الدبلجة من أكثر من 60 لغة مصدر إلى 33 لغة مستهدفة، ويمكنه تعيين صوت مستنسخ لكل متحدث أثناء العملية.
إذا كانت مهمة إعادة الاستخدام الخاصة بك تتعلق أساساً بالترجمة وسرعة الإصدار، فهذا هو المسار الذي يجب أن تبدأ به. نستعرض مسار الإنتاج الكامل في دليلنا حول كيفية تغيير لغة الصوت في الفيديو، ويمكن لأصحاب القنوات متعددة اللغات رسم الصورة الأكبر في كيفية إنشاء قناة YouTube متعددة اللغات.
ما يفعله استنساخ الصوت فعلياً
يبني استنساخ الصوت نموذجاً صوتياً اصطناعياً من تسجيلات لمتحدث حقيقي. يحلل النموذج النطق وإيقاع الكلام والنبرة والتنغيم والملمس الصوتي وأنماط التوقف والأسلوب التعبيري، ثم يُنشئ كلاماً جديداً من النص يشبه المتحدث المصدر دون مطالبته بتسجيل كل سطر يدوياً. مع استنساخ الصوت لدينا، يمكنك تحميل 20 ثانية على الأقل من صوت نظيف نسبياً لإنشاء نسخة مستنسخة، والاستنساخ متاح عبر 33 لغة.
هناك تفصيل واحد يهم أكثر مما يتوقعه الناس: الأسلوب العاطفي لعينتك ينتقل إلى المخرجات. يميل المقطع الرتيب إلى إنتاج كلام مسطح، بينما يمنح المقطع التعبيري النموذج معلومات أسلوبية أكثر للعمل بها. اختر العينة التي تطابق الأداء الذي تريده، وليس فقط أنظف ملف تمتلكه.
يُثبت الصوت المستنسخ جدواه عندما يحتاج المتحدث نفسه إلى الظهور باستمرار عبر العديد من الأصول، مثل مقدمات القنوات وتحديثاتها، وسرد الدورات متعددة اللغات، وتصحيحات البودكاست، وشروحات المنتجات، والنشرات الصوتية، والاختلافات التسويقية، ومحتوى التطبيقات المُنشأ عبر واجهة برمجة التطبيقات. ولأن هذا الصوت يمكن أن يعمل أيضاً داخل خط الدبلجة، فإن الاستنساخ يتصرف كلبنة بناء للدبلجة بدلاً من منافس لها. للحصول على خريطة أوسع لما يفعله المبدعون بصوت مخصص، راجع أفضل استخدامات استنساخ الصوت بالذكاء الاصطناعي.
كيف تعمل التقنيتان معاً
خذ مبدعاً لديه فيديو تعليمي إنجليزي منشور مدته 20 دقيقة. يقوم سير عمل الدبلجة بنسخه، وتحديد المتحدثين، وترجمة النص، وتوليد الكلام باللغة المستهدفة، ثم ضبط التوقيت ومزج الحوار الجديد مع الخلفية الصوتية الأصلية. إذا أراد هذا المبدع أيضاً أن تحتفظ النسخة المترجمة بهويته الصوتية، فإن النظام يُدخل نسخة مستنسخة من الصوت في مرحلة توليد الكلام. نفس خط الإنتاج، مكوّن إضافي واحد.
أنظف طريقة لاستيعاب الفرق في ذهنك هي من خلال السؤال الذي يجيب عليه كل منهما:
- الدبلجة بالذكاء الاصطناعي تجيب: كيف أجعل هذا المحتوى الموجود مفهوماً بلغة أخرى؟
- استنساخ الصوت يجيب: كيف أجعل كلاماً جديداً يبدو كصوت هذا المتحدث المصرّح به؟
- سير العمل المدمج يجيب: كيف أوطّن هذا المحتوى مع الحفاظ على نفس المقدّم المعروف؟
أصواتنا المستنسخة مصممة للاستخدام في كل من تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي، وهذا ما يجعل المسار المدمج عملياً بدلاً من كونه حلاً بديلاً. إعادة الاستخدام تلك هي الهدف بأكمله: صوت واحد مصرّح به، وجهات متعددة.
أيهما يناسب مهمة إعادة الاستخدام الخاصة بك
يعتمد الاختيار الصحيح على ما يتغير فعلاً: اللغة، أو النص، أو هوية المتحدث، أو الثلاثة جميعاً. المصفوفة أدناه تربط مهام إعادة الاستخدام الشائعة بالنهج الأنسب.
| متطلب إعادة الاستخدام | الأنسب | السبب |
|---|---|---|
| ترجمة فيديو موجود إلى الإسبانية | الدبلجة بالذكاء الاصطناعي | تسجيل المصدر والتوقيت موجودان بالفعل |
| نشر نفس المقدّم بعدة لغات | الدبلجة مع استنساخ الصوت | التوطين واستمرارية المتحدث كلاهما مهم |
| إنشاء عشرة فيديوهات جديدة من نص مقدّم واحد | استنساخ الصوت | تحتاج إلى كلام جديد، وليس تسجيلاً مترجماً |
| استبدال جملة واحدة في بودكاست منشور | استنساخ الصوت | يُنتج الصوت المخصص لقطة مطابقة دون إعادة تسجيل |
| توطين دورة بها عدة مدربين | الدبلجة، وربما عدة نسخ مستنسخة | يدير سير العمل المصدر والمتحدثين والترجمة والتوقيت |
| توليد ردود منطوقة تحمل علامة تجارية في تطبيق | واجهة برمجة تطبيقات الاستنساخ أو واجهة برمجة تطبيقات TTS | الحاجة الأساسية هي توليد الكلام برمجياً |
| دبلجة فيلم أو مقابلة أو حلقة نقاش | الدبلجة بالذكاء الاصطناعي | تعدد المتحدثين وتوقيت الحوار والمزج أمور محورية |
| إنتاج سرد محايد بلغات متعددة | الدبلجة أو TTS متعدد اللغات | قد يكون الصوت الأصلي المعروف غير ضروري |
اختر الدبلجة بالذكاء الاصطناعي عندما يكون المحتوى المصدر هو الأصل: لديك بالفعل فيديو أو بودكاست مكتمل، وحوار موجود للترجمة، وعدة متحدثين، وخلفية موسيقية للحفاظ عليها، وجدول إصدار متعدد اللغات. وهي مفيدة بشكل خاص لاختبار الطلب في سوق جديد دون إنتاج فيديو جديد تماماً.
اختر استنساخ الصوت عندما تكون هوية المتحدث هي الأصل: صوت مؤسس عبر فيديوهات المنتجات، أو مدرب يحدّث الدروس، أو مقدّم بودكاست يصحح خطأً وقائعياً، أو مقدمات وخاتمات موطّنة، أو صوت مخصص مُنشأ على نطاق واسع. يقلل الاستنساخ من عبء التسجيل، لكنه ليس بديلاً عن المراجعة التحريرية. يمكن للنموذج أن يعيد إنتاج الخصائص الصوتية ومع ذلك ينطق اسماً بشكل خاطئ، أو يفوّت السياق، أو ينقل العاطفة الخاطئة.
معايير الجودة التي تحدد المخرجات التجارية
المقارنة الجادة تتجاوز ما إذا كانت المخرجات "تبدو واقعية". بالنسبة للمحتوى المعاد استخدامه الذي يجب أن يؤدي أداءً جيداً، تفصل ستة معايير بين أصل قابل للاستخدام وآخر محرج.
دقة المعنى والترجمة. الصوت الطليق لا يمكنه إنقاذ رسالة مترجمة بشكل خاطئ. دقّق في أسماء المنتجات والمصطلحات التقنية والأرقام والقياسات والدعوات إلى اتخاذ إجراء واللغة القانونية أو المتعلقة بالسلامة والتعابير والفكاهة والإشارات الإقليمية. يمكن أن تكون الترجمة الحرفية صحيحة نحوياً وعديمة الفائدة تجارياً؛ وعادةً ما يحتاج المحتوى التسويقي والتدريبي إلى تكييف، وليس تحويلاً كلمة بكلمة.
اتساق المتحدث. قرّر ما إذا كان يجب أن يبدو الشخص نفسه متطابقاً عبر النسخ الأصلية والموطّنة، والحلقات المتعددة، وأصول الحملة، والمقاطع القصيرة، والتحديثات المستقبلية. إذا كان الجواب نعم، يضيف الاستنساخ قيمة. إذا كنت تحتاج فقط إلى سرد موطّن واضح، فإن صوتاً اصطناعياً جاهزاً غالباً ما يكون كافياً.
التوقيت وقابلية التحرير. نادراً ما يكون الكلام المترجم بنفس طول السطر المصدر. يجب أن تتيح أداة دبلجة عملية للمحررين ضبط توقيت المقاطع ومعدل الكلام والنص والأقسام المُعاد توليدها ومستويات الخلفية. يكشف استوديو الدبلجة لدينا بالضبط عن تلك الضوابط: تحرير النص والطوابع الزمنية، وتغيير معدل الكلام، وإعادة توليد مقاطع فردية، وضبط الصوت الخلفي.
الأداء العاطفي. هوية الصوت والأداء العاطفي مشكلتان منفصلتان. يمكن للنسخة المستنسخة أن تشبه المتحدث لكنها تفشل في نقل الإلحاح أو الفكاهة أو التعاطف أو السلطة أو التشويق أو الحماس. قدّم لها عينة تُظهر الأداء المقصود؛ عينة هادئة تناسب دورة تعليمية، وعينة حيوية تناسب فيديو إطلاق.
تزامن الشفاه والملاءمة البصرية. بالنسبة للفيديو الذي يقوده مقدّم أو شخصية، يجب أن يتناسب الصوت المترجم مع الأداء المرئي: حركة الفم، والتوقفات، وتغييرات اللقطات، وتوقيت ردود الفعل، ومحاذاة الترجمة، وانتقالات المتحدثين. السرد خارج الكاميرا يتحمل تزامناً فضفاضاً؛ أما الحوار عن قرب فلا.
سرعة الإنتاج والنطاق. يؤتي الذكاء الاصطناعي ثماره مع تضاعف الأصول واللغات، لذا قارن إجمالي عبء العمل بدلاً من وقت التوليد وحده. كم عدد اللغات والمتحدثين المعنيين؟ كم مرة سيتم تحديث المحتوى؟ هل يمكن للفريق إعادة توليد جملة واحدة دون إعادة بناء المشروع؟ هل تُطلب واجهة برمجة تطبيقات، وهل يمكن إعادة استخدام نفس الصوت بموجب الحقوق المناسبة؟ ننشر منتجات منفصلة لـالدبلجة بالذكاء الاصطناعي، وواجهة برمجة تطبيقات استنساخ الصوت، وواجهة برمجة تطبيقات تحويل النص إلى كلام، وواجهة برمجة تطبيقات الدبلجة بالذكاء الاصطناعي؛ راجع تلك الصفحات مباشرة للاطلاع على المصادقة الحالية وصيغ الإدخال والإخراج وحدود المعدل وتفاصيل الخطة قبل أن تبني.
الحقوق والإفصاح والحوكمة التي لا يمكنك تخطيها
السرعة تجعل من السهل تخطي الأوراق، وهذا حيث تقع المشاريع في مشكلة. استنسخ صوتاً فقط عندما تملك تصريح المتحدث والحقوق للاستخدام المقصود واللغات والقنوات والمدة والإقليم. الإذن بتسجيل شخص ما ليس إذناً ببناء نسخة اصطناعية قابلة لإعادة الاستخدام من صوته. للاستخدام التجاري، احتفظ بوثائق تغطي هوية مالك الصوت، والاستخدام المسموح به، وقنوات التوزيع، والأقاليم الجغرافية، ومدة العقد، وشروط التعويض، وما إذا كان يجوز تشغيل الصوت في الإعلانات، وما إذا كان يمكن استدعاء النموذج عبر واجهة برمجة تطبيقات، وكيف يعمل الحذف أو السحب. الموافقة والاستخدام المسؤول جزء من كيفية تعاملنا مع الاستنساخ، لكن تأمين الحقوق لموادك وعيناتك يبقى مسؤوليتك.
تعامل مع التسجيلات المُحمّلة على أنها حساسة. يمكن أن تحمل العينات الصوتية معلومات حيوية وشخصية، لذا قيّد الوصول إلى الملفات المصدر، ولا تحمّل أبداً مواد غير مصرّح لك باستخدامها، وتأكد من كيفية تخزين أي مزوّد لبيانات الصوت ومعالجتها وحذفها. تُشير NIST إلى الأصوات الاصطناعية كمجال خطر لأن الصوت المستنسخ يمكن أن يتيح انتحال الشخصية والاحتيال، وتؤكد إرشاداتها على تحديد الموافقة ومعالجة المخاطر المرتبطة بالمحتوى الاصطناعي.
قواعد المنصات تضيف طبقة أخرى. يتطلب YouTube حالياً من المبدعين الإفصاح عن المحتوى الواقعي المُنشأ بالذكاء الاصطناعي أو المُعدّل بشكل جوهري في الحالات ذات الصلة؛ وتشير أمثلته الخاصة إلى أن استنساخ صوتك الخاص للتعليقات الصوتية أو الدبلجة لا يتطلب إفصاحاً بموجب ذلك المثال، بينما قد يتطلب المحتوى الاصطناعي الواقعي الذي قد يضلل المشاهدين ذلك. تتغير السياسات، لذا تحقق من القواعد الحالية للمنصة المستهدفة قبل النشر، وتذكّر أن الإفصاح لا يحل أبداً محل إذن حقوق النشر أو حقوق الشخصية أو إجازة العلامة التجارية أو الامتثال الإعلاني. يمكنك قراءة سياسة YouTube الخاصة في مقال المساعدة حول الإفصاح.
أخيراً، احتفظ بعنصر بشري في العملية. راجع كل أصل موطّن بحثاً عن أخطاء الترجمة والأسماء الخاطئة والعلامات التجارية المنطوقة بشكل خاطئ والأرقام غير الصحيحة والصياغة غير الملائمة ثقافياً والتوقفات غير الطبيعية والمصطلحات غير المتسقة والعيوب الصوتية وقطع الصوت والمتحدثين المعيّنين بشكل خاطئ. بالنسبة للمحتوى المنظّم أو الحرج للسلامة أو السياسي أو الطبي أو القانوني، استعن بمراجعين مؤهلين وخبراء في الموضوع.
كيف تتعامل DubSmart مع كلا الجانبين
نجمع بين الدبلجة بالذكاء الاصطناعي واستنساخ الصوت وتحويل النص إلى كلام وتحويل الكلام إلى نص وفاصل الكلام وأدوات وسائط أخرى في منصة واحدة، مما يوفر على المبدع أو الفريق الصغير نقل الملفات بين تطبيقات نسخ وترجمة وصوت وتحرير منفصلة. تنص صفحات منتجاتنا العامة على أن الدبلجة بالذكاء الاصطناعي تدعم الدبلجة من أكثر من 60 لغة إلى 33 لغة، وأنها يمكن أن تستخدم أصواتاً مستنسخة للمتحدثين وتوفر ضوابط تحرير المشروع، وأن استنساخ الصوت يعمل من 20 ثانية على الأقل من الصوت النظيف، وأن الأصوات المستنسخة تعمل في كل من تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي، وأن واجهات برمجة تطبيقات استنساخ الصوت والدبلجة بالذكاء الاصطناعي متاحة كمنتجات مطوّرين منفصلة.
بالنسبة لمشروع صغير، عادةً ما يكون سير عمل المتصفح كافياً. يجب على الوكالات والمنصات وفرق التطوير تقييم وثائق واجهة برمجة التطبيقات وحدود الاستخدام ومعالجة البيانات والحقوق التجارية ومعالجة الأخطاء وشروط الرصيد أو الخطة الحالية قبل الالتزام بتكامل آلي. لست متأكداً من المسار الذي تنتمي إليه مهمة إعادة الاستخدام التالية؟ أخبرنا بصيغة المصدر واللغات المستهدفة وعدد المتحدثين وتكرار التحديث، ويمكننا توجيهك إلى الإعداد الصحيح.
الأسئلة الشائعة
هل الدبلجة بالذكاء الاصطناعي هي نفسها استنساخ الصوت؟
لا. تُوطّن الدبلجة بالذكاء الاصطناعي المحتوى المنطوق الموجود من خلال الجمع بين النسخ والترجمة وتوليد الكلام والتوقيت والمزج. يُنشئ استنساخ الصوت صوتاً اصطناعياً قابلاً لإعادة الاستخدام من عينة متحدث مصرّح بها. يمكن استخدام الاستنساخ داخل سير عمل الدبلجة، لكنهما غير قابلين للتبادل.
هل استنساخ الصوت أفضل من الدبلجة بالذكاء الاصطناعي لـ YouTube؟
يعتمد ذلك على الهدف. استخدم الدبلجة بالذكاء الاصطناعي لترجمة الفيديوهات الموجودة إلى لغات جديدة. استخدم استنساخ الصوت عندما تحتاج إلى صوت نفس المقدّم لنصوص جديدة أو تصحيحات أو مقدمات موطّنة. لنمو القناة متعددة اللغات، غالباً ما يكون الجمع بين الاثنين هو الأقوى.
هل يمكنني استخدام الدبلجة بالذكاء الاصطناعي دون استنساخ صوتي؟
نعم. يمكن لسير عمل الدبلجة استخدام صوت اصطناعي جاهز أو صوت آخر معتمد بدلاً من استنساخ المتحدث الأصلي. الاستنساخ اختياري عندما لا تكون هوية المتحدث ضرورية للقطعة.
ما مقدار الصوت المطلوب لاستنساخ صوت باستخدام DubSmart؟
تنص صفحة استنساخ الصوت لدينا على أنه يمكنك تحميل ملف صوتي لا تقل مدته عن 20 ثانية. نوصي بصوت خالٍ من الضوضاء الخلفية، وأسلوب الكلام في عينتك يؤثر على الجودة العاطفية للصوت المُنشأ.
هل تحتاج الدبلجة المُنشأة بالذكاء الاصطناعي إلى الإفصاح عنها على YouTube؟
أحياناً. تتطلب إرشادات YouTube الحالية الإفصاح عن المحتوى الواقعي المُنشأ بالذكاء الاصطناعي أو المُعدّل بشكل جوهري في الحالات ذات الصلة. وتسرد استنساخ صوتك الخاص للتعليقات الصوتية أو الدبلجة كمثال لا يتطلب إفصاحاً، بينما قد يتطلب المحتوى الاصطناعي الواقعي الآخر ذلك. تحقق من السياسة الحالية قبل النشر.