اختر صوت TTS جاهزًا عندما تحتاج إلى سرد سريع ومرن ولا يحتاج أحد إلى التعرف على المتحدث. اختر صوتًا مستنسخًا عندما يحمل صوت شخص معين الثقة أو الاستمرارية أو التعرف على العلامة التجارية. هذه المفاضلة الوحيدة بين السرعة والهوية تقع في قلب قرار الصوت المستنسخ مقابل صوت TTS الجاهز، ويفرط معظم المبدعين في التفكير فيها لأنهم يعاملون الاثنين كمتنافسين بدلاً من كونهما أدوات لمهام مختلفة.
هنا في DubSmart AI نبني كليهما في سير عمل واحد، لذا يركز هذا الدليل على القرار نفسه: ما هو كل خيار فعليًا، وكيف يعمل، والمعايير الملموسة التي تخبرك أيهما يناسب مشروعًا معينًا. بحلول النهاية يجب أن تكون قادرًا على النظر إلى أي نص ومعرفة في غضون ثوانٍ ما إذا كنت بحاجة إلى صوت جاهز أو مخصص.
جدول المحتويات
ما الذي يفصل الصوت المستنسخ عن صوت TTS الجاهز
يعود الفرق إلى شيء واحد: هوية الصوت.
صوت TTS الجاهز هو صوت صناعي جاهز تختاره من مكتبة. تلصق نصًا، وتختار صوتًا ولغة، وتولّد الصوت. إنه مصمم ليُعاد استخدامه عبر العديد من المشاريع والجماهير، وهذا بالضبط هو سبب شعوره بالحياد بدلاً من الطابع الشخصي.
الصوت المستنسخ هو نسخة صناعية من متحدث معين واحد. يحلل النظام تسجيلًا لهذا الشخص ويعيد إنتاج نبرته ونطقه وإيقاعه وطابعه الصوتي في كلام جديد. يرتبط المخرج بفرد مُصرّح به وليس بإعداد افتراضي للمنصة.
هذا التمييز يقود كل قرار لاحق حول الإعداد والمرونة والاستمرارية والحوكمة.
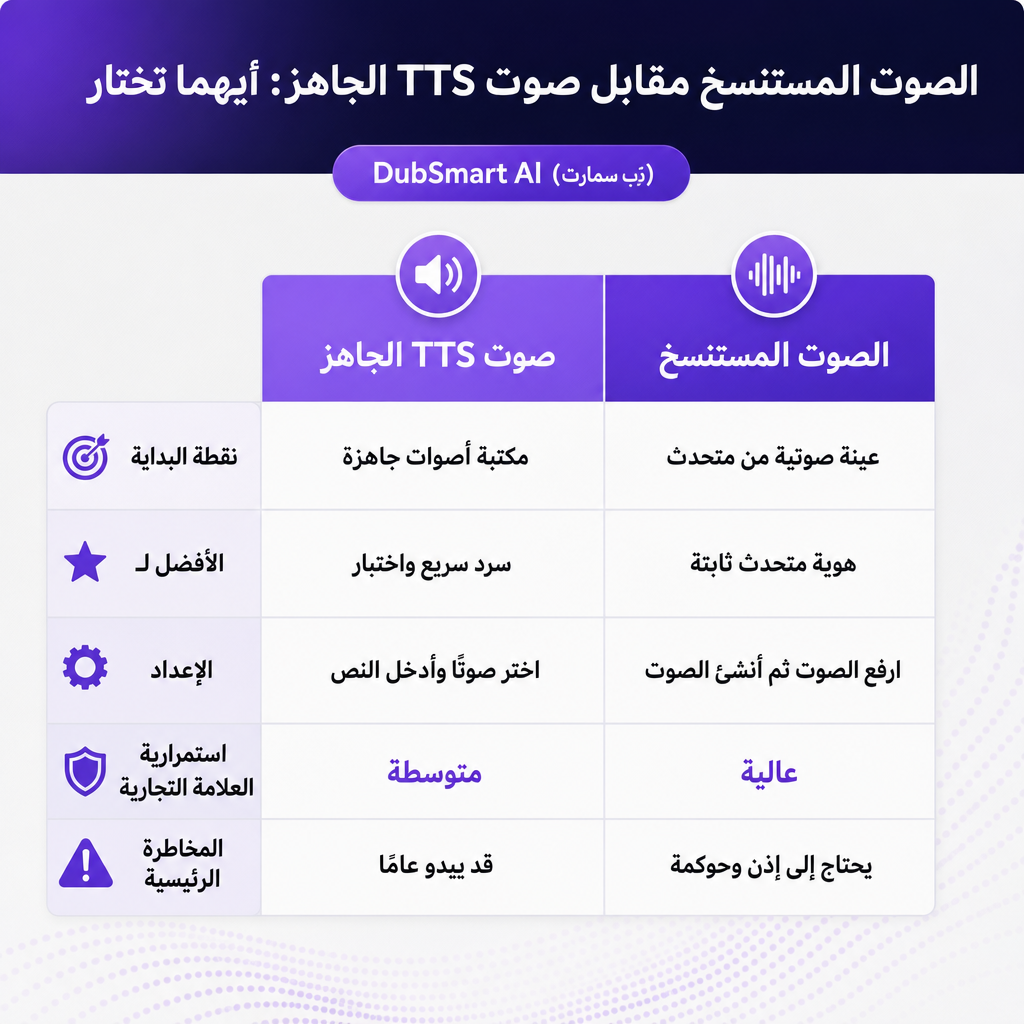
| العامل | صوت TTS الجاهز | الصوت المستنسخ |
|---|---|---|
| نقطة البداية | مكتبة أصوات جاهزة | عينة صوتية من متحدث |
| الأفضل لـ | السرد السريع والاختبار | هوية متحدث متسقة |
| الإعداد | اختر صوتًا، أدخل النص | ارفع الصوت، ثم أنشئ الصوت |
| استمرارية العلامة التجارية | متوسطة | عالية |
| الخطر الرئيسي | قد يبدو عامًا | يتطلب إذنًا وحوكمة |
إذا كنت تريد تفصيلاً أعمق لكيفية اختلاف الأدوات الأساسية، فإن شرحنا حول استنساخ الصوت مقابل تحويل النص إلى كلام يقارن الهوية والإعداد والنطاق والحوكمة بالتفصيل.
كيف يعمل كل خيار فعليًا
فهم الآليات يجعل القرار واضحًا، لأن كل مسار يحمّل الجهد في مكان مختلف.
يحوّل TTS الجاهز النص إلى كلام بصوت موجود بالفعل. تكتب أو تلصق نصًا، وتختار صوتًا ولغة، وتعدّل الأداء إذا لزم الأمر، وتصدّر. لا توجد مجموعة بيانات للصيانة ولا متحدث تستدعيه مرة أخرى لإجراء تغيير بسيط في النص. أداة تحويل النص إلى كلام لدينا تقدم أكثر من 300 صوت شبيه بالبشر وعناصر تحكم مثل معدل الكلام وموجهات العاطفة وتنسيق التأكيد، حتى تتمكن من تجربة عدة اتجاهات في دقائق.
يحمّل استنساخ الصوت الجهد مقدمًا بدلاً من ذلك. يبدأ بتسجيل للمتحدث؛ يحلل النظام خصائصه الصوتية ويُنشئ صوتًا مخصصًا قابلاً لإعادة الاستخدام يمكنك بعد ذلك تشغيله بنص جديد. على DubSmart يمكنك رفع ملف صوتي لا يقل عن 20 ثانية لإنشاء نسخة، والتسجيل النظيف الخالي من ضوضاء الخلفية ينتج نتائج أفضل. يهم أيضًا أسلوب التحدث في العينة: المقطع الرتيب يميل إلى توليد كلام أكثر انبساطًا، بينما العينة التي تحمل العاطفة التي تريدها تساعد في إعادة إنتاج ذلك الأسلوب. أداة استنساخ الصوت لدينا تجعل ذلك الصوت المخصص متاحًا بعد ذلك لكل من تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي.
النتيجة العملية هي التوقيت. يمنحك TTS الجاهز الصوت اليوم بدون أي إعداد. يطلب الاستنساخ تسجيلاً وإذنًا وفحصًا للجودة مقدمًا، ثم يعوّض ذلك الجهد عبر كل توليد مستقبلي.
المعايير الستة التي تحسم الأمر
مرر مشروعًا عبر هذه الأسئلة الستة وعادة ما تحل الإجابة نفسها.
1. هل يحمل الصوت نفسه معنى؟ إذا كان المشاهدون يهتمون بمن يتحدث، يفوز الاستنساخ. المعلم على يوتيوب أو مضيف البودكاست أو المؤسس الذي بنى الثقة من خلال صوته يفقد شيئًا عندما يحل راوٍ عام محله. إذا كان الصوت يقدم معلومات فقط، مثل برنامج تعليمي للبرمجيات أو إعلان داخلي، فإن TTS الجاهز كافٍ.
2. كم من المحتوى ستنتج؟ بالنسبة لإعلان واحد مدته 30 ثانية، فإن الحصول على صوت جاهز أسرع من إعداد نسخة مستنسخة. بالنسبة لمئات مقاطع الفيديو أو الدروس أو الحلقات، يزيل الصوت المستنسخ العمل المتكرر للتسجيل ويحافظ على الاستمرارية عبر المكتبة بأكملها.
3. هل تحتاج إلى توطين متعدد اللغات؟ كلاهما يتعامل مع لغات متعددة، لكنهما يحلان مشاكل مختلفة. مع TTS الجاهز تختار صوتًا مناسبًا لكل لغة مستهدفة، وهو ما يساعد عندما يكون النمط الإقليمي أهم من المتحدث الأصلي. مع الاستنساخ يكون الهدف الحفاظ على المتحدث الأصلي عبر اللغات. يدعم استنساخ الصوت لدينا 33 لغة، وتقوم خدمة الدبلجة بالذكاء الاصطناعي لدينا بدبلجة المحتوى من أكثر من 60 لغة مصدر إلى 33 لغة مستهدفة.
4. كم من التحكم العاطفي تحتاج؟ النسخة المستنسخة لا تخترع عاطفة لم تسمعها قط. إذا كان المقطع المصدر منبسطًا، يميل المخرج إلى أن يكون منبسطًا، وهذا هو سبب توصيتنا بتسجيل العاطفة وأسلوب التحدث الذي تريد إعادة إنتاجه. الأصوات الجاهزة أسهل في الاختبار عبر عدة نبرات عندما تحتاج إلى شرح هادئ يومًا وإعلان مفعم بالطاقة في اليوم التالي. أيهما تميل إليه، اختبر كليهما بنفس النص واستمع إلى نطق الأسماء والمصطلحات التقنية، وإيقاع الجملة، والمصداقية العاطفية، والتأكيد، والاتساق عبر المقاطع الطويلة.
5. ما مدى سرعة احتياجك للمسودة الأولى؟ TTS الجاهز لديه أقصر مسار من النص إلى الصوت لأن الصوت جاهز. يضيف الاستنساخ خطوة تحضير، ثم يصبح فعّالاً للإنتاج المتكرر. لموعد نهائي لمرة واحدة، ابدأ بـ TTS الجاهز؛ لنظام محتوى مستمر، استثمر في نسخة مستنسخة عندما تكون للهوية قيمة دائمة.
6. من يتحكم في هوية المتحدث؟ يتطلب الاستنساخ حوكمة. استنسخ صوتًا فقط عندما يكون لديك إذن المتحدث والحق في استخدام التسجيل والمخرج للغرض المقصود. احتفظ بوثائق تغطي صوت من تم تسجيله، وما أذنوا به، وأين يمكن استخدام الصوت، وما إذا كان الاستخدام التجاري والإعلاني مسموحًا به، وكيف يجب تعطيل الصوت إذا انتهى التفويض. هذا يهم أكثر للوكالات والمطورين الذين ينتجون محتوى للعملاء، والصوت الذي يبدو كشخص حقيقي يمكن أن يضلل الجماهير إذا لم يتم الإفصاح أبدًا عن السرد الصناعي.
ما الذي يجب أن يختاره المبدعون المختلفون
تقع المفاضلة نفسها بشكل مختلف اعتمادًا على ما تصنعه.
مبدعو يوتيوب: استنسخ صوتك إذا كانت القناة مبنية حول شخصيتك، حتى تبقى المقدمات والتصحيحات والمقاطع القصيرة والنسخ متعددة اللغات قابلة للتعرف عليها. استعن بـ TTS الجاهز في القنوات بدون وجه، أو التجارب المتخصصة، أو التنسيقات التي تحتاج إلى أصوات شخصيات مميزة.
الشركات الصغيرة وفرق التسويق: ابدأ بـ TTS الجاهز لمقاطع فيديو المنتجات والإعلانات الاجتماعية وتمكين المبيعات والمسودات الداخلية، لأنه سريع وسهل لاختبار A/B من حيث النبرة والإيقاع. انتقل إلى صوت مؤسس أو علامة تجارية مستنسخ عندما يظهر نفس الراوي عبر الحملات وتثقيف العملاء.
فرق التعلم الإلكتروني والتدريب المؤسسي: استخدم TTS الجاهز للمحتوى المعياري الذي يتغير كثيرًا أو يحتاج إلى عدة أصوات تعليمية. استخدم صوتًا مستنسخًا عندما يتوقع المتعلمون استمرارية من مدرب واحد عبر مكتبة كبيرة، حتى تبدو الوحدات المنفصلة كدورة واحدة.
صانعو الأفلام ومبدعو البودكاست: استنسخ عندما يكون الحفاظ على هوية المضيف أو الشخصية أمرًا أساسيًا؛ تم تصميم سير عمل الدبلجة بالذكاء الاصطناعي لدينا لاستنساخ صوت كل متحدث للتوطين متعدد اللغات. استخدم TTS الجاهز للمسارات الأولية، والمعاينات، والأدوار الثانوية، أو التعديلات المبكرة قبل الاختيار النهائي للممثلين.
المطورون والوكالات: اختر واجهة برمجة تطبيقات تحويل النص إلى كلام جاهزة عندما يحتاج تطبيقك إلى مجموعة من الأصوات والنماذج الأولية السريعة دون تسجيل المتحدثين. اختر واجهة برمجة تطبيقات استنساخ الصوت عندما يحتاج منتجك إلى أصوات مخصصة مُصرّح بها تم إنشاؤها من عينات صوتية.
متى يكون استخدام كليهما الخيار الأذكى
TTS الجاهز واستنساخ الصوت ليسا متنافيين، وأقوى أنظمة الإنتاج تمزجهما عن قصد.
قد يقترن إعداد واقعي بصوت مضيف مستنسخ للسرد الرئيسي على يوتيوب مع أصوات جاهزة للشخصيات الداعمة. يمكن لدورة أن تشغّل صوت مدرب مستنسخ في الدروس الأساسية وأصوات جاهزة في حوار لعب الأدوار. قد يصيغ فريق النصوص المبكرة في TTS الجاهز، ثم يولّد النسخة النهائية المعتمدة في نسخة مستنسخة. للتوطين، تحافظ الأصوات المستنسخة على الراوي عبر اللغات بينما تتدخل الأصوات الإقليمية الجاهزة عندما يكون الراوي المحلي أنسب.
هذا النهج الهجين يحافظ على المرونة الإبداعية حيث تهم السرعة ويحمي الهوية حيث يهم التعرف، دون فرض حل وسط واحد عبر المشروع بأكمله.
القاعدة الواحدة التي تحسم معظم الاختيارات
عندما تبدو المعايير متوازنة، تحسم هذه القاعدة التعادل:
إذا كان المتحدث جزءًا من المنتج، اختر صوتًا مستنسخًا. إذا كان الكلام هو المنتج، اختر صوت TTS جاهزًا.
يكون المتحدث جزءًا من المنتج عندما تبني هويته الثقة أو التعرف أو الاستمرارية: المبدعون والمدربون والمؤسسون والمضيفون والشخصيات الخيالية. يكون الكلام هو المنتج عندما تكون الأولوية سردًا واضحًا وميسور التكلفة وقابلاً للتعديل السريع: الشروحات، وتحديثات المنتجات، والتدريب الداخلي، والنماذج الأولية، والاختلافات عالية الحجم.
تبدأ معظم المشاريع الأولى بشكل أفضل مع TTS الجاهز لأنه فوري وسهل التغيير. انتقل إلى صوت مستنسخ بمجرد أن يصبح صوت الراوي أصلاً حقيقيًا في علامتك التجارية أو قناتك أو دورتك أو محتواك الموطّن. للفرق التي تحتاج إلى السرعة والاستمرارية معًا، تتعامل مكتبتنا الجاهزة مع السرد المرن بينما تتعامل أدوات استنساخ الصوت والدبلجة لدينا مع الاتساق المُصرّح به ومتعدد اللغات.
الأسئلة الشائعة
هل الصوت المستنسخ أفضل من صوت TTS الجاهز؟
ليس بشكل عام. يفوز الصوت المستنسخ من حيث الهوية والاتساق؛ يفوز صوت TTS الجاهز من حيث السرعة والتنوع والإنتاج منخفض الالتزام. الاختيار الصحيح يعتمد على ما إذا كانت هوية المتحدث مهمة لذلك المشروع.
كم من الصوت مطلوب لاستنساخ صوت باستخدام DubSmart؟
الحد الأدنى للعينة هو 20 ثانية. للحصول على جودة أفضل نوصي بتسجيل نظيف بدون ضوضاء خلفية، وعينة تحمل العاطفة والأسلوب الذي تريد إعادة إنتاجه.
هل يمكن لصوت مستنسخ أن يتحدث لغة أخرى؟
نعم. يدعم استنساخ الصوت لدينا 33 لغة، وتقوم خدمة الدبلجة بالذكاء الاصطناعي لدينا بدبلجة المحتوى من أكثر من 60 لغة مصدر إلى 33 لغة مستهدفة مع الحفاظ على هوية المتحدث الأصلي.
هل يمكنني استخدام صوت مستنسخ للدبلجة بالذكاء الاصطناعي؟
نعم. يمكن استخدام الصوت المستنسخ في كل من تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي، ويمكن لأداة الدبلجة لدينا أيضًا استنساخ صوت كل متحدث تلقائيًا أثناء التوطين متعدد اللغات.
ما هي أكثر طريقة آمنة لاستخدام استنساخ الصوت؟
استنسخ متحدثًا مُصرّحًا به فقط، ووثّق الاستخدام المسموح به، واحمِ الصوت المصدر، وراجع كل مخرج تم توليده، وأفصح عن السرد الصناعي أينما تتطلب منصتك أو عميلك أو القواعد المعمول بها ذلك.