عندما يبحث الناس عن تحويل نص غوست فيس إلى كلام، فإنهم عادةً ما يريدون شيئًا واحدًا: تحويل نص مكتوب إلى صوت مظلم ومهدِّد يذكّر بالمتصل المقنّع من أفلام Scream. وما نادرًا ما يدركونه هو أن هذا لا يعني تقريبًا أبدًا توليد صوت الشخصية الرسمي. ففي الأفلام، يعود هذا الأداء إلى ممثل الصوت روجر إل. جاكسون، ويُقدَّم عبر جهاز تغيير صوت داخل القصة. أما أداة تحويل النص إلى كلام فتقوم بشيء مختلف: إذ تولّد كلامًا جديدًا تمامًا من نصك باستخدام نموذج صوتي اصطناعي أو مرخّص. لذا فإن السؤال الحقيقي ليس "كيف أحصل على صوت غوست فيس؟" بل "هل أحتاج إلى أداء مرخّص، أم إلى صوت رعب أصلي يتمتع بالصفات المزعجة نفسها—نبرة منخفضة، وإيقاع متأنٍّ، وسكتات محمّلة بالمعنى، وأداء مهدِّد؟"
هذا التمييز يحدد كل خيار يأتي بعده، من الصوت الذي تختاره إلى ما يمكنك نشره قانونيًا. سنستعرض كيف يُبنى الصوت فعليًا، وأين يندرج DubSmart AI، وكيف تبقى في الجانب الصحيح من قواعد حقوق الصوت في الولايات المتحدة.
جدول المحتويات
ماذا يعني تحويل نص غوست فيس إلى كلام فعليًا
في جوهره، يُعد تحويل نص غوست فيس إلى كلام حالة استخدام للسرد في أعمال الرعب لمحرّك صوت ذكاء اصطناعي عام الغرض. يلجأ المبدعون إليه للتعليق الصوتي على مقاطع الهالوين، والقصص المرعبة الخيالية، ومقاطع عروض الألعاب الترويجية، والمشاهد الكوميدية الرعبية، وبودكاست التشويق، والشخصيات المتحركة، والأفلام القصيرة بطاقم أصلي.
يقرأ نظام تحويل النص إلى كلام نصك المكتوب، ويحوّل الكلمات إلى معلومات نطق ولغة، ويتنبأ بخصائص الكلام مثل الإيقاع والنغمة والتشديد والسكتات، ثم يُركّب هذه الخصائص في موجة صوتية. والمخرَج هو تسجيل جديد مولّد من النص، لا سطور مُلتقطة واحدةً تلو الأخرى من ممثل بشري. تؤدي أداة تحويل النص إلى كلام لدينا هذه العملية بالضبط، باستخدام خوارزميات تحاكي التنغيم البشري عبر أكثر من 300 صوت، وعدة لغات ولهجات، مع عناصر تحكم في سرعة الكلام والعاطفة والتشديد، إضافةً إلى صوت قابل للتنزيل.
الشخصية المهدِّدة التي تسعى إليها ليست زرًّا واحدًا. فهي تنشأ من كيفية دمجك للصوت الذي تختاره مع الطريقة التي تكتب بها النص وتعالجه. إذا كنت جديدًا على التقنية الأساسية، فإن شرحنا حول كيفية عمل تحويل النص العصبي إلى كلام يغطي مسار العملية بمزيد من التفصيل.
هل هو صوت غوست فيس الحقيقي؟
عادةً، لا—وهذا يهم أكثر مما يبدو للوهلة الأولى. إن "صوت غوست فيس" الذي يقدّمه مولّد عبر الإنترنت يميل إلى أن يكون واحدًا من أربعة أشياء: صوت رعب عام مصمّم ليبدو مظلمًا ومسرحيًا؛ أو إعداد تقليد أسلوبي يهدف إلى استحضار إيقاع الشخصية وطبيعتها؛ أو تأثير تحويل صوتي يعيد تشكيل تسجيل بالنغمة والتشويه؛ أو نسخة غير مرخّصة مدرَّبة على تقليد مؤدٍّ معروف دون إذن واضح.
وهذه الخيارات ليست قابلة للتبادل، سواء قانونيًا أو تقنيًا. فالصوت الأصلي المستوحى من الرعب لا بأس به لشخصية ابتكرتها أنت. أما التقليد الواقعي لممثل معروف أو شخصية خيالية ذات علامة تجارية فيجر إلى مسائل حقوق وترخيص لا علاقة لها بمدى جودة الصوت.
تسرد صفحة تحويل النص إلى كلام العامة لدينا أصواتًا جاهزة وميزات استنساخ صوتي؛ وهي لا تقدّم صوت غوست فيس الرسمي من Scream ولا صوت روجر إل. جاكسون. لذا تعامل مع أي صفحة من طرف ثالث تلصق وصف "غوست فيس" على إعداد مسبق على أنها تسويق، لا دليل على الترخيص. ولا تقدّم الصوت المولّد على أنه رسمي أو معتمد أو مؤدًّى من جاكسون ما لم تمتلك تصريحًا منفصلًا.
كيف يُهندَس الصوت المهدِّد
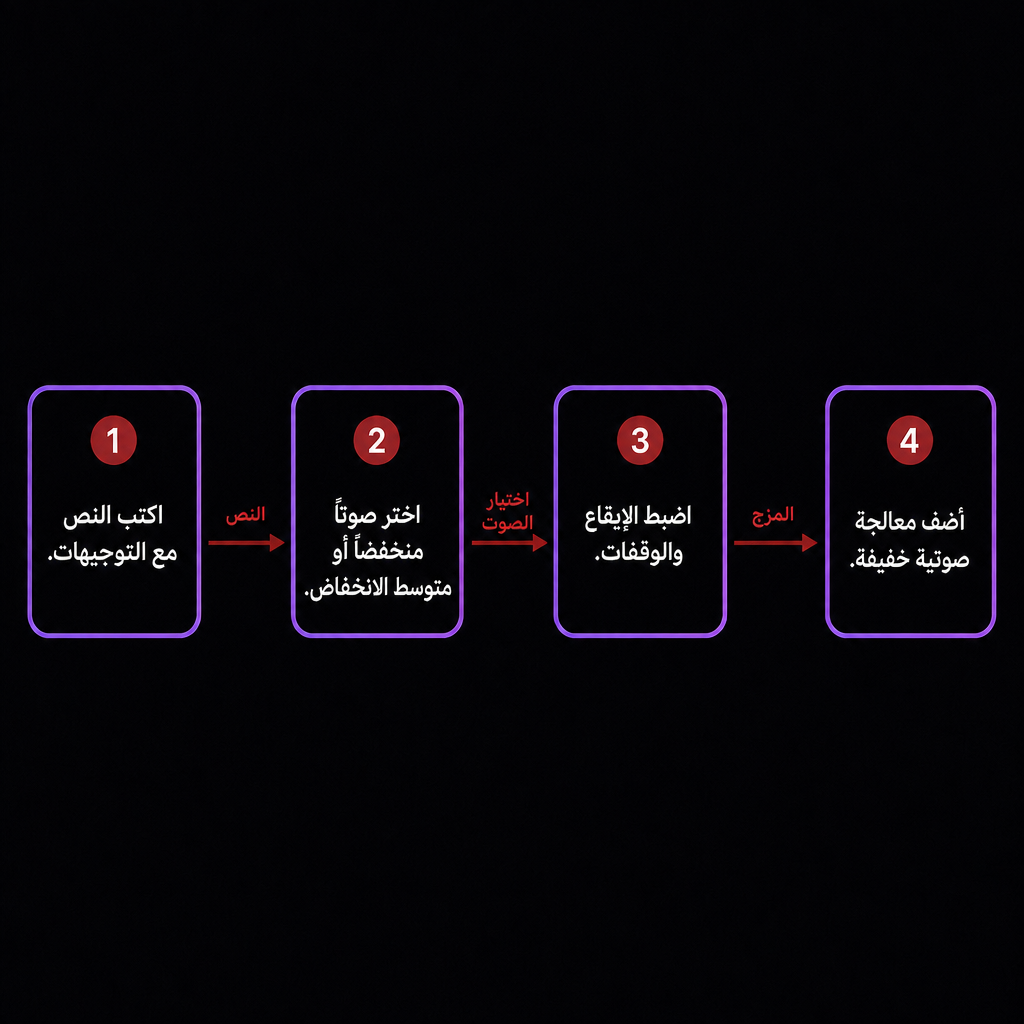
ينتج التأثير المميّز عن خيارات متراكبة، لا عن شريط تمرير واحد. وكل طبقة هي رافعة يمكنك اختبارها بشكل مستقل.
نبرة الصوت. تضيف النغمة المنخفضة ثقلًا وتهديدًا، لكن النزول إلى أدنى إعداد متاح يُنتج عادةً نتيجة غير طبيعية ومشوَّهة. استهدف خفضًا معتدلًا يُبقي الكلمات مفهومة على مكبرات الهاتف ومكبرات الحاسوب المحمول والسماعات على حدٍّ سواء.
الإيقاع المضبوط. يبدو الحوار بأسلوب غوست فيس متأنّيًا. فالأداء الأبطأ يتيح للمستمعين توقّع السطر التالي ويجعل الجمل القصيرة تقع كمواجهات. سرعة الكلام قابلة للتعديل في سير عملنا، حيث يمكن ضبط القيمة الافتراضية 1.00x لكل مشروع. والحركة الذكية هي إبطاء الأسطر المهدِّدة فقط؛ فإبطاء كل شيء يُسطّح التوتر ويبدو مصطنعًا.
السكتات. يخلق الصمت رهبةً أكبر من التشويه المستمر. أدرج علامات الترقيم أو فواصل الأسطر أو مقاطع حوار منفصلة حيث ينبغي للمتحدث أن يتردّد. فجملة "هل تحب أفلام الرعب؟" تصبح أكثر إزعاجًا بكثير إذا كانت "هل تحب… أفلام الرعب؟" تعمل السكتات القصيرة بأفضل شكل قبل اسم، أو كشف، أو تهديد، أو سؤال مباشرة.
التشديد عبر التوجيه المكتوب. تستجيب الأصوات الاصطناعية للتعليمات الواضحة أفضل من المبهمة. يمكنك استخدام وسوم الحوار مثل "قال بسعادة" أو "صرخ بغضب" للإشارة إلى النبرة العاطفية، واستخدام الأحرف الكبيرة لتشديد حرف علّة. أما للرعب، فصِف الأداء داخل النص نفسه:
[هادئ، مضبوط، مهدِّد] ما كان ينبغي لك أن تُجيب.
قاوم الرغبة في الصراخ بأحرف كبيرة في كل مكان. فالتشديد المبالغ فيه يُقرأ كصياح، لا كتهديد.
طول الجملة. تمنح الأسطر القصيرة النموذج مساحة أكبر للتحكم الدرامي. قارن بين "لقد كنت أراقبك لعدة دقائق، وأعرف تمامًا ما فعلته الليلة الماضية" وبين:
رأيتك. أعرف ما فعلته.
تمنح النسخة المقطّعة الصوت فرصًا أكثر للتوقف وتغيير الحدّة.
معالجة الصوت. يولّد تحويل النص إلى كلام الصوت؛ أما التحرير فيشكّل الرعب. بعد حصولك على تسجيل نظيف، أضِف صدى غرفة خفيفًا، وترشيحًا بنطاق الهاتف، وتشبعًا خفيفًا، وضغطًا مضبوطًا، وأجواءً خلفية، وموسيقى أو مؤثرات ممزوجة بعناية. طبّق هذه العناصر أخيرًا. فالمعالجة الثقيلة في البداية تُخفي مشكلات النطق وتدفن الكلمات.
صوت جاهز، أو استنساخ صوتي، أو مؤدٍّ بشري
يحل تحويل النص إلى كلام والاستنساخ الصوتي مشكلات مختلفة، والاختيار الخاطئ يخلق إما أداءً ضعيفًا أو صداعًا في الحقوق. يرسم هذا الجدول المقارنات والمفاضلات.
| الخيار | الأنسب لـ | المدخل الرئيسي | الخطر الرئيسي |
|---|---|---|---|
| صوت ذكاء اصطناعي جاهز | السرد السريع، الشخصيات الأصلية | نص | قد لا يتطابق الصوت مع الشخصية المقصودة |
| الاستنساخ الصوتي | إعادة استخدام هوية راوٍ مرخّص | عيّنة صوتية نظيفة ونص | مخاوف الموافقة وانتحال الهوية |
| التحويل الصوتي | تحويل أداء موجود مسبقًا | كلام مُسجَّل | قد يُقلّد شخصًا حقيقيًا بشكل مفرط التشابه |
| ممثل صوت بشري | عمل الشخصيات المرخّص، التمثيل الدقيق | النص والتوجيه | تكلفة أعلى ووقت إنتاج أطول |
نُبقي تحويل النص إلى كلام والاستنساخ الصوتي كأداتين منفصلتين لهذا السبب. يدعم منتج تحويل النص إلى كلام لدينا الأصوات الجاهزة ويتيح لك استنساخ الأصوات لاستخدامها عبر اللغات، لكن صفحاتنا العامة لا تُنشئ أي حق في استنساخ أحد المشاهير أو شخصية خيالية أو أداء محمي بحقوق الطبع والنشر دون إذن. بالنسبة لشخصية رعب مبتكرة، يكون الصوت الجاهز مع توجيه مكتوب دقيق عادةً المسار الأكثر أمانًا والأسرع. وبالنسبة لراوي قناة متكرر، استنسخ صوتك الخاص أو استخدم مؤدّيًا منح إذنًا واضحًا.
بناء صوت رعب أصلي في DubSmart AI
يحوّل سير عمل تحويل النص إلى كلام لدينا نصًّا إلى صوت مولّد: افتح تحويل النص إلى كلام، وأدخِل نصك، واختر متحدثًا، ووَلِّد الكلام، وحرّر المشروع، ونزّل النتيجة. وللحصول على مخرَج مستوحى من غوست فيس لكنه أصلي، تصنع بضع عادات الفرق بين شرير مقنع وروبوت واضح.
اختر الصوت حسب السلوك، لا حسب الاسم. ابحث عن صوت هادئ لا نشيط، منخفض أو متوسط-منخفض في النبرة، واضح النطق في السرعات الأبطأ، قادر على أداء عاطفي مضبوط، ومناسب لعمر شخصيتك وهويتها. تجنّب اختيار صوت لمجرد أن صفحةً ما وسمته بـ"غوست فيس"؛ فذلك الوسم كثيرًا ما يصف تقليدًا، لا أداءً مرخّصًا.
اكتب الأداء داخل النص باستخدام توجيهات متحفّظة:
[منخفض، هادئ، متسلٍّ تقريبًا] لقد أجبت. [سكتة] كان ذلك خطأً.
الهدف هو توجيه النبرة دون مطالبة النظام بإعادة إنتاج الأداء الدقيق لممثل معروف بالاسم.
صحّح النطق قبل إضافة المؤثرات. إذا خرج اسم أو رقم بشكل خاطئ، فأعِد كتابته صوتيًا أو اهجِئه—كتابة الأرقام ككلمات تساعد عندما ينطقها النظام بشكل خاطئ. وَلِّد عدة نسخ من الأسطر الصعبة؛ فالتسجيل النظيف الدقيق يتفوّق على تسجيل مُعالَج بكثافة لا يستطيع أحد فهمه.
أخيرًا، قارن عيّنات اختبار قصيرة قبل الالتزام بحلقة كاملة. مرّر الأسطر الثلاثة نفسها عبر عدة أصوات وسرعات: جملة محايدة، وسطر مهموس أو هادئ، وتهديد مفاجئ. اختر الصوت الذي يبقى مقنعًا في الثلاثة جميعًا. فالصوت الذي يبهر في جملة واحدة قد يتحوّل إلى صوت آلي على مدى نص أطول. وإذا كانت قصتك تنتقل عبر اللغات، فإن الدبلجة بالذكاء الاصطناعي لدينا يمكنها حمل الصوت إلى لغات أخرى—فقط راجع كل واحدة منها، إذ تغيّر الترجمة إيقاع التهديد وثقله الثقافي.
حقوق الصوت والأخلاقيات في الولايات المتحدة
ينطوي تقليد الصوت على ما هو أكثر من حقوق الطبع والنشر. فتقرير مكتب حقوق الطبع والنشر الأمريكي حول النسخ الرقمية يتناول التقنية التي تُعيد إنتاج صوت شخص أو مظهره بشكل واقعي؛ ويشير إلى أن قانون حقوق الطبع والنشر لا يُلغي القوانين التي تقيّد النسخ الصوتية غير المرخّصة، ويناقش حقوق الشهرة، خصوصًا حيث تُستخدم هوية شخص تجاريًا. يمكنك قراءة المصدر الأساسي في تقرير النسخ الرقمية الصادر عن مكتب حقوق الطبع والنشر.
الممارسات الأكثر أمانًا واضحة ومباشرة: لا تستنسخ صوت شخص آخر دون إذن؛ ولا تصف التقليد بأنه الصوت الرسمي؛ ولا تستخدم صوت ممثل معروف لبيع منتجات دون تصريح؛ ولا تستخدم أبدًا صوتًا مولّدًا للاحتيال أو التحرش أو التهديد أو الخداع. أفصح عن تدخّل الذكاء الاصطناعي عندما قد يسبّب السياق إرباكًا للمشاهدين، واحتفظ بسجلات الموافقة والاستخدامات المسموح بها لأي عيّنة صوتية، وراجع بشكل منفصل الحقوق المرتبطة بالموسيقى ومقاطع الأفلام والنصوص وأسماء الشخصيات.
هناك سبب واقعي لأخذ انتحال الهوية على محمل الجد. فقد حذّرت لجنة التجارة الفيدرالية من أن الاستنساخ الصوتي يجعل عمليات الاحتيال أكثر مصداقية، بما في ذلك المخططات التي تنتحل شخصية أقارب أو مديرين تنفيذيين لطلب أموال أو معلومات؛ وإرشاداتها حول الاستنساخ الصوتي الضار تستحق القراءة. حتى في الترفيه، تجنّب التقليد الواقعي الذي قد يُضلّل مستمعًا. هذه معلومات عامة وليست استشارة قانونية؛ أما المشاريع التجارية التي تشمل شخصية أو مؤدّيًا معروفًا فينبغي أن يراجعها محامٍ مؤهّل أو أصحاب الحقوق المعنيون.
يُبقيك إطار قرار بسيط على وضوح: اختر صوت ذكاء اصطناعي جاهزًا عندما تكون الشخصية أصلية، أو تحتاج إلى سرد سريع، أو تنتج محتوى متكررًا. اختر استنساخًا صوتيًا مرخّصًا عندما تملك الصوت المصدر أو لديك إذن مكتوب، وتحتاج إلى سرد متسق عبر الحلقات، ويمكنك توثيق الاستخدامات المسموح بها. وظّف مؤدّيًا بشريًا أو رخّصه عندما يعتمد المشروع على تمثيل شخصية معروفة، أو عندما يكون الفارق العاطفي الدقيق محوريًا، أو عندما لا يكون الخط الفاصل بين الإلهام والتقليد مقبولًا لإصدار تجاري.
قبل أن تنشر، طبّق فحصًا سريعًا: هل يُقدَّم الصوت على أنه أصلي لا رسمي؟ هل يمكن فهم كل كلمة دون سماعات؟ هل تخلق السكتات تشويقًا بدلًا من فجوات محرجة؟ هل يبدو صوت الشخصية مستقرًا عبر المشاهد؟ هل الأسماء والأرقام والكلمات الأجنبية صحيحة؟ هل الصوت أعلى وأوضح من الموسيقى؟ هل يمكن أن يخلط مشاهد بين الصوت وتسجيل رسمي؟ هل لديك إذن لكل عيّنة صوتية ومقطوعة ومقطع ونص ومرجع شخصية؟ وهل ما زال يؤدّي بشكل جيد على الهاتف المحمول ومنصات المحتوى القصير؟
الأسئلة الشائعة
هل تحويل نص غوست فيس إلى كلام مجاني؟
تقدّم بعض الأدوات تجارب مجانية أو توليدًا محدودًا، لكن التوفّر وحقوق الاستخدام تختلف. نحن نوفّر تحويل النص إلى كلام مع أصوات ذكاء اصطناعي جاهزة ووظيفة استنساخ صوتي؛ تحقّق من شروط حسابك الحالي ورصيدك قبل إنتاج مشروع تجاري.
هل يمكنني استخدام صوت غوست فيس بالذكاء الاصطناعي على يوتيوب؟
يمكنك استخدام صوت رعب أصلي مستوحى بالذكاء الاصطناعي ما دامت نصوصك وصوتك وموسيقاك ومرئياتك مرخّصة بشكل سليم ولا يوحي العرض زورًا بمشاركة رسمية من Scream. فالتقليد المعروف قد يخلق مخاطر إضافية في الحقوق والمنصات.
هل يستطيع DubSmart AI توليد صوت غوست فيس الرسمي؟
لا تحدّد صفحة تحويل النص إلى كلام العامة لدينا صوت غوست فيس الرسمي أو صوت روجر إل. جاكسون. استخدم الخدمة لإنشاء سرد رعب أصلي أو استنساخ صوتي مرخّص بدلًا من افتراض أن وسم "غوست فيس" العام رسمي.
هل يمكنني استنساخ صوت روجر إل. جاكسون؟
ليس دون تصريح صريح من صاحب الحقوق المعني والمؤدّي. فالنسخة الواقعية لصوت شخص قد تثير مسائل حقوق الشهرة والنسخ الرقمية، خصوصًا في الاستخدام التجاري.
ما الذي يجعل الصوت مرعبًا؟
الإيقاع المضبوط، والسكتات ذات المعنى، والتشديد المتحفّظ، والنطق الواضح، والنبرة المناسبة تهم عادةً أكثر من التغيير المتطرف في النغمة. فالأداء النظيف المفهوم يتفوّق على الأداء المشوَّه بكثافة.