مُغيّر الصوت بالذكاء الاصطناعي للدبلجة يفعل ما هو أكثر بكثير من مجرد استبدال صوت بآخر: فهو ينسخ الحوار الأصلي نصيًا، ويترجمه، ويولّد أداءً جديدًا باللغة المستهدفة، بل يمكنه الحفاظ على هوية المتحدث الأصلي وتوقيته وأسلوبه العاطفي كما هي. هذا النطاق الواسع من المهام هو بالضبط سبب عدم وجود إجابة واحدة لسؤال "أي خيار يجب أن أستخدمه؟". فالاختيار الصحيح يعتمد على ما تحتاج إلى الحفاظ عليه.
إذا كنت بحاجة إلى أن يبقى المتحدث قابلًا للتمييز، فإن الدبلجة باستنساخ الصوت هي المناسبة. وإذا كنت تريد سردًا سريعًا ومرنًا، فإن الصوت الجاهز بالذكاء الاصطناعي أبسط في الإدارة. وإذا كنت تريد صوتًا واحدًا متكررًا للعلامة التجارية عبر العديد من المشاريع، فإن استنساخ الصوت المخصص هو الأصل الذي ينبغي بناؤه. وإذا كانت حالة الاستخدام هي محادثة حية، فإن مُغيّر الصوت الفوري ينتمي إلى فئة مختلفة عن أي أداة دبلجة لمرحلة ما بعد الإنتاج. بالنسبة لمعظم منشئي محتوى يوتيوب وفرق التعلّم الإلكتروني والمسوّقين والمنتجين المستقلين، تُعد الدبلجة المسجّلة بالذكاء الاصطناعي نقطة البداية العملية لأنها تمنح تحكمًا أكبر بكثير من المُغيّر الفوري ويمكنها إخراج عدة نسخ محلية من ملف رئيسي واحد.
جدول المحتويات
ما الذي يفعله مُغيّر الصوت بالذكاء الاصطناعي للدبلجة فعليًا
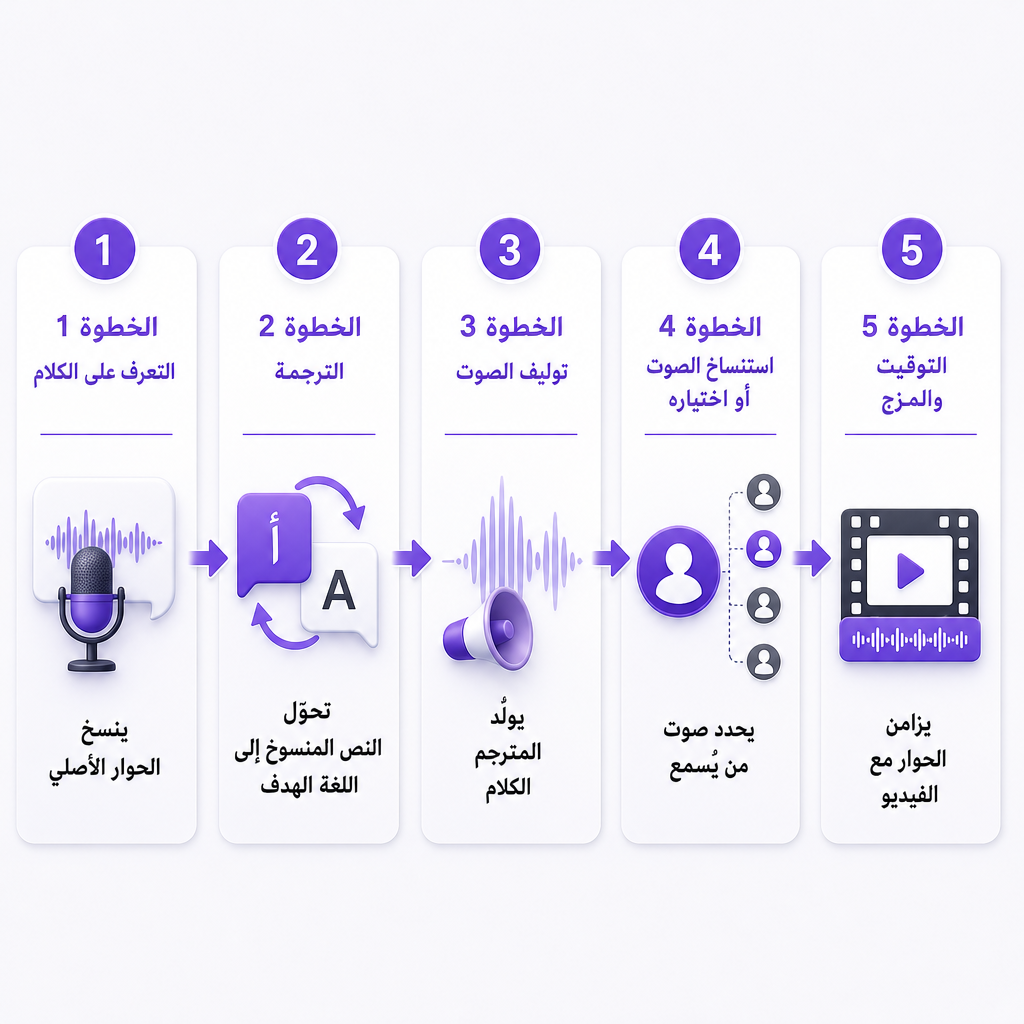
يُغيّر مُغيّر الصوت بالذكاء الاصطناعي للدبلجة كلًّا من اللغة المنطوقة وصوت الصوت أو الفيديو المسجّل. وهذه سلسلة من التقنيات المميزة التي تعمل بالتتابع، وليست تأثيرًا واحدًا. يقوم التعرّف على الكلام بنسخ الحوار الأصلي نصيًا. وتحوّل الترجمة ذلك النص إلى اللغة المستهدفة. ويولّد تركيب الكلام الحوار المترجم. وتحدد خطوة الاستنساخ أو الاختيار الصوت الذي يسمعه الجمهور. وأخيرًا، يقوم التوقيت والمزج بملاءمة الحوار الجديد مع الفيديو والمتحدثين والصوت الخلفي.
هذه السلسلة هي ما يميّزها عن مُغيّر الصوت التقليدي. فالمُغيّر الأساسي يعدّل طبقة الصوت أو جرسه أو طابعه أثناء مكالمة حية ولا يغادر مجال الصوت أبدًا. أما نظام الدبلجة فعليه أن يفهم الكلام، ويترجمه، ويُسنِد المتحدث الصحيح لكل سطر، ويبني مسارًا بديلًا متزامنًا يستقر داخل المشهد الأصلي.
يقبل سير عمل الدبلجة بالذكاء الاصطناعي لدينا ملف صوت أو فيديو مرفوعًا، أو رابط يوتيوب، ثم يتيح لك تحرير المتحدثين والنص والتوقيتات قبل تنزيل النتيجة. فهو يتعامل مع محتوى من أكثر من 60 لغة مصدر إلى 33 لغة مستهدفة، لذا فإن اتجاه الترجمة الذي تحتاجه عادةً ما يكون مغطىً قبل اتخاذ أي قرار بشأن الصوت. وإذا كنت جديدًا على المفهوم الأساسي، فإن دليل المبتدئين الكامل للدبلجة بالذكاء الاصطناعي يشرح سلسلة العمل بمزيد من التفصيل.
الخيارات الأربعة، ومن يخدمه كلٌّ منها
هناك أربعة أساليب واقعية، وهي تتباعد على محور واحد قبل كل شيء: ما إذا كنت تحافظ على المتحدث الأصلي وما إذا كانت الترجمة جزءًا من المهمة أصلًا.
الدبلجة بالذكاء الاصطناعي باستنساخ الصوت تحلّل خصائص مثل طبقة الصوت والنبرة واللكنة وأسلوب الكلام، ثم تولّد كلامًا مترجمًا باستخدام نسخة اصطناعية من الصوت الأصلي. وهي الخيار الأنسب عندما يحمل شخص معروف المحتوى: قنوات يوتيوب المبنية حول مقدّم، ومدرّبو الدورات، والمتحدثون الرسميون للعلامات التجارية، ومضيفو البودكاست المنتظمون، والأفلام ذات الشخصيات المتكررة، وعروض المنتجات حيث يهم استمرار المتحدث. ونقطة قوتها هي الحفاظ على الهوية عبر اللغات وصوت متسق لمكتبة متعددة اللغات، مما يقلل الحاجة إلى توظيف وتنسيق ممثلي الأداء الصوتي. لكن قيودها حقيقية أيضًا. فالتسجيل المصدري الرديء يُنتج استنساخًا رديئًا، واللكنات والعاطفة والحوار المتداخل والموسيقى والضوضاء الخلفية تضعف الجودة جميعها. ويجب تسوية إذن المتحدث والحقوق التجارية أولًا، وقد يبدو الصوت المستنسخ أقل طبيعية عندما يحمل السطر المترجم توقيتًا أو نية عاطفية مختلفة جدًا.
الدبلجة بالذكاء الاصطناعي بالصوت الجاهز تُسنِد صوتًا اصطناعيًا مُختارًا لكل متحدث أو مسار سردي بدلًا من استنساخ المصدر. وهي تناسب الحالات التي لا يحتاج فيها المتحدث الأصلي أن يبقى قابلًا للتمييز: علامة تجارية تريد راويًا واحدًا متسقًا عبر العديد من الفيديوهات، أو صوت مصدري مزعج جدًا بحيث لا يمكن استنساخه بنظافة، أو محتوى شرح وتهيئة، أو اختبار مبكر لعدة أنماط صوتية قبل الالتزام. وهي أيضًا المسار الأكثر أمانًا عندما لا تملك ببساطة إذنًا لتكرار صوت شخص ما. والمقايضة هي أن النسخة المحلية قد تبدو أقل ارتباطًا بالمحتوى الأصلي.
استنساخ الصوت المخصص يُنشأ مرة واحدة ويُعاد استخدامه عبر السرد بتحويل النص إلى كلام، والدبلجة، والمواد التدريبية، وغيرها من المحتوى المعتمد. وخلافًا لاستنساخ صوت بشكل منفصل لكل فيديو، فإن هذا يبني أصلًا صوتيًا قابلًا لإعادة الاستخدام. وهو يناسب فريق تسويق يريد نفس صوت العلامة التجارية في فيديوهات المنتجات، ومحتوى مركز المساعدة، ووحدات التعلّم الإلكتروني، والتكييفات الاجتماعية، والإعلانات متعددة اللغات، والنسخ الصوتية للمحتوى المكتوب. ويحتاج الاستنساخ المخصص إلى قواعد ملكية واضحة: من يجوز له استخدامه، وأي لغات وقنوات مسموح بها، وما إذا كانت الوكالات الخارجية تحصل على حق الوصول، وماذا يحدث إذا سحب المتحدث موافقته.
تغيير الصوت الفوري بالذكاء الاصطناعي يعدّل الكلام أثناء إنتاجه أو نقله، مُعطيًا الأولوية لزمن الاستجابة المنخفض بحيث يسمع الجمهور الصوت المُغيّر بشكل حي. وهو الأداة الصحيحة للمكالمات الحية والبث والألعاب والفعاليات الافتراضية والعروض التفاعلية، لكنه نادرًا ما يكون الأداة الصحيحة للترجمة المحلية متعددة اللغات المصقولة. فالأنظمة الفورية لديها مجال ضئيل لمراجعة الترجمات أو تصحيح التوقيت أو إزالة الأخطاء أو ضبط الأجزاء الفردية بدقة، ويمكنها إدخال زمن استجابة أو تشوهات. ويغطي شرحنا حول مُغيّر الصوت الفوري بالذكاء الاصطناعي أين تصبح مقايضة زمن الاستجابة هذه حدًا صارمًا.
| الخيار | الأفضل لـ | يحافظ على الهوية الأصلية؟ | الترجمة مشمولة؟ | الخطر الرئيسي |
|---|---|---|---|---|
| الدبلجة باستنساخ الصوت | المحتوى متعدد اللغات بقيادة مقدّم | نعم | نعم | نسخ غير مصرّح به أو غير طبيعي |
| الدبلجة بالصوت الجاهز | الشروحات والتدريب وسرد العلامة التجارية | لا | نعم | قد يبدو الصوت منفصلًا عن المصدر |
| استنساخ الصوت المخصص | صوت علامة تجارية أو منشئ قابل لإعادة الاستخدام | نعم | عادةً، حسب سير العمل | الموافقة والترخيص والتحكم في الوصول |
| مُغيّر الصوت الفوري | البث الحي والمكالمات والألعاب | أحيانًا | ليس بالضرورة | زمن الاستجابة والتشوهات والتصحيح المحدود |
| الدبلجة البشرية بمساعدة الذكاء الاصطناعي | الأفلام والإعلانات عالية المخاطر | يمكن ترتيبه | نعم | تكلفة أعلى وجداول زمنية أطول |
كيف تختار دون المبالغة في التركيز على واقعية الصوت
الخطأ الأكثر شيوعًا هو اختيار أداة لأن معاينة صوتية قصيرة تبدو مبهرة. فالعيّنة الواقعية لا تعني الكثير إذا كان الحوار النهائي لا يلائم المشهد. تعامل مع القرار بالترتيب.
ابدأ بمتطلب الهوية. اسأل ما إذا كان المشاهدون بحاجة إلى سماع صوت المتحدث الأصلي القابل للتمييز. إذا كان الجواب نعم، فاستخدم الدبلجة باستنساخ الصوت أو صوتًا مخصصًا مُعتمدًا مسبقًا. وإذا كان الجواب لا، فالصوت الجاهز أسرع وأبسط وأسهل في الإدارة. فمعلّم لغة يوسّع قناة يوتيوب يستفيد من استنساخ صوت المدرّب؛ أما شركة برمجيات تترجم درسًا تعليميًا عامًا لمنتج فعادةً ما تفضّل راويًا جاهزًا احترافيًا.
طابِق الأداة مع صيغة المحتوى. المحتوى القصير والبودكاست والدروس التعليمية وفيديوهات المنتجات غالبًا ما تعمل جيدًا مع الدبلجة الآلية. ويكون التدقيق الأقرب مبرَّرًا عندما يتضمّن المشروع متحدثين متعددين، أو مقاطعات متكررة، أو نكات أو تعبيرات اصطلاحية، أو لكنات إقليمية قوية، أو موسيقى فوق الحوار، أو تمثيلًا عاطفيًا، أو حوارًا سريعًا، أو مصطلحات قانونية وطبية ومالية.
قيّم تغطية اللغات حسب الاتجاه بدلًا من العدد الإجمالي المعلن. فقد تُدرج أداة الإنجليزية والإسبانية والفرنسية كلغات مستهدفة بينما تقدّم جودة صوت أو تغطية لهجات مختلفة في كل اتجاه. أكّد ما إذا كانت المنصة تكتشف لغتك المصدرية تلقائيًا، وتدعم اللكنة الإقليمية التي تحتاجها، وتحافظ على الأسماء والمصطلحات، وتتعامل مع الكلام مختلط اللغات، وتنتج ترجمات نصية أو صوتًا فقط، وتسمح بعدة لغات مستهدفة في مشروع واحد. تدعم الدبلجة بالذكاء الاصطناعي الموجّهة للمستهلك لدينا أكثر من 60 لغة مصدر و33 لغة مستهدفة، بينما توثّق وثائق واجهة برمجة التطبيقات لدينا بشكل منفصل أكثر من 33 لغة مستهدفة ومعالجة من أكثر من 99 لغة مصدر، لذا تحقّق من المنتج أو الخطة المطبّقة قبل الالتزام بمهمة كبيرة.
تحقّق من التوقيت والتزامن. نادرًا ما تكون الجملة المترجمة بنفس طول الأصل، لذا ينبغي لنظام الجودة أن يتيح لك ضبط أوقات بداية ونهاية الأجزاء ومعدّل الكلام والتوقفات وإسناد المتحدث ومستوى الصوت الخلفي والأسطر المعاد توليدها بشكل فردي. وبالنسبة للمحتوى المركّز على حركة الشفاه، افحص حركات الفم وتوقيت المشهد يدويًا؛ فقد يبدو الصوت الطبيعي غير متطابق إذا كانت الترجمة طويلة جدًا أو انحرفت التوقفات المولّدة عن الصورة.
ضع في اعتبارك حجم الإنتاج. فيديو واحد عرضي يكون مناسبًا في استوديو عبر الإنترنت. أما قناة أو وكالة أو منتج برمجي يترجم محليًا بشكل مستمر فينبغي أن يبحث عن دعم الدفعات أو تعدد اللغات، والأصوات المخصصة القابلة لإعادة الاستخدام، وتحرير المشاريع، والوصول إلى واجهة برمجة التطبيقات، والأجزاء القابلة للتنزيل، ومراقبة الاستخدام، وشروط الاستخدام التجاري، والدعم الموثوق. وإذا كنت تقرّر بين صوت جاهز والاستنساخ للسرد تحديدًا، فإن مقارنتنا بين تحويل النص إلى كلام مقابل استنساخ الصوت للسرد ترسم ذلك الخيار بالتفصيل.
مخاطر الجودة والحقوق التي يجب التحقق منها قبل النشر
الدبلجة الآلية مُسرِّع للإنتاج، وليست بديلًا عن الحكم التحريري. وهناك عدد قليل من المخاطر تستحق تحققًا مباشرًا في كل مشروع.
قد تكون الترجمة دقيقة كلمة بكلمة ومع ذلك تفوتها السياق أو الفكاهة أو المراجع الثقافية أو مستوى الرسمية المقصود. راجع الأسماء والمقاييس ونداءات التحرك ومصطلحات المنتج وتعليمات السلامة مع متحدث طليق. وقد يتباعد الصوت والعاطفة أيضًا: فقد يحتفظ الصوت المستنسخ بالخصائص الصوتية دون إعادة إنتاج الأداء التمثيلي الدقيق، لذا تأكّد من أن التشديد والإلحاح والدفء والتوقفات ما تزال تلائم المشهد.
الظروف الخلفية مهمة للدقة. فالاستنساخ والنسخ النصي أكثر موثوقية مع متحدث واحد واضح، بينما تقلّل الموسيقى وصدى الغرفة والمؤثرات الصوتية والحوار المتداخل جودة النسخ النصي وإسناد المتحدث. وعلى جانب الحقوق، لا تستنسخ صوتًا أبدًا لمجرد أنه يمكنك الوصول إلى تسجيل. احصل على إذن من المتحدث ووثّق الاستخدام المقصود واللغات والقنوات والمدة والحقوق التجارية، وهو أمر مهم بشكل خاص للممثلين والموظفين والشخصيات العامة والعملاء والأشخاص المتوفين.
العيّنة الصوتية الواقعية هي أسهل شيء يمكن تقييمه وأقل مؤشر موثوق على نتيجة قابلة للاستخدام.
ثقة الجمهور هي الطبقة الأخيرة. فبعض المنصات والجماهير تتوقع الإفصاح عند استخدام وسائط اصطناعية واقعية، وحتى حيث لا يكون مطلوبًا بشكل صارم، فإن الشفافية تقلّل الالتباس وتحمي المصداقية. قبل الإصدار، اجعل مراجعًا يستمع إلى المسار النهائي، ويقارنه بالمصدر، ويؤكّد الترجمة، ويفحص التزامن.
أين يناسب DubSmart في سير العمل هذا
نحن نجمع بين الدبلجة بالذكاء الاصطناعي واستنساخ الصوت وتحويل النص إلى كلام في منصة واحدة بدلًا من فرض أداة منفصلة في كل مرحلة. يدعم منتج الدبلجة بالذكاء الاصطناعي لدينا الترجمة المحلية الآلية والمتحدثين المستنسخين والأجزاء القابلة للتحرير وتغييرات التوقيت وإعادة التوليد على مستوى السطر، لذا يمكنك تصحيح جملة واحدة خاطئة بدلًا من إعادة بناء مشروع كامل.
يقبل سير عمل استنساخ الصوت لدينا عيّنة صوتية مدتها 20 ثانية كحد أدنى، ويصبح الصوت الناتج متاحًا لكل من تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي، وهو ما يجعل صوت علامة تجارية واحدًا مُعتمدًا قابلًا لإعادة الاستخدام عبر العديد من اللغات والصيغ. والتسجيل النظيف الخالي من الضوضاء الخلفية يُنتج أفضل استنساخ، ونحن نعامل الموافقة والاستخدام المسؤول كمتطلب وليس كفكرة لاحقة.
بالنسبة للفرق التي تبني الترجمة المحلية داخل برمجيات أو نظام إنتاج داخلي، نقدّم أيضًا واجهة برمجة تطبيقات للدبلجة بالذكاء الاصطناعي مع مشاريع متعددة اللغات وأصوات مخصصة وعناصر تحكم بالمتحدثين وتحرير على مستوى الأجزاء، إلى جانب رفع الملفات وإنشاء المشاريع واختيار اللغة المستهدفة وإعادة التوليد وتنزيل النتائج. ولا يُحدَّد الخيار الأقوى أبدًا بأكثر تأثير صوتي إثارة. بل يتلخّص في ما إذا كان سير العمل يمكنه تقديم اتجاه اللغة والهوية والتزامن والتحكم التحريري وإدارة الحقوق وحجم الإنتاج الذي يحتاجه محتواك فعلًا. فإذا كنت تعرف لغتك المصدرية ولغاتك المستهدفة وما إذا كنت بحاجة إلى الحفاظ على الصوت الأصلي، فإن تلك الإجابة عادةً ما تصبح واضحة بسرعة.
الأسئلة الشائعة
هل مُغيّر الصوت بالذكاء الاصطناعي للدبلجة هو نفسه مُغيّر الصوت العادي بالذكاء الاصطناعي؟
لا. مُغيّر الصوت العادي بالذكاء الاصطناعي عادةً ما يعدّل صوتًا في الوقت الفعلي أو يغيّر الخصائص الصوتية. أما مُغيّر الصوت بالذكاء الاصطناعي للدبلجة فيترجم الكلام المسجّل ويبني أداءً بديلًا يجب أن يلائم المحتوى الأصلي والمتحدثين والتوقيت.
ما هو الخيار الأفضل لمنشئي محتوى يوتيوب؟
الدبلجة بالذكاء الاصطناعي باستنساخ الصوت عادةً ما تكون الأقوى عندما تكون هوية المنشئ محورية للقناة. والصوت الجاهز غالبًا ما يكون أفضل للسرد المجهول أو الشروحات أو المحتوى الذي تهم فيه السرعة والاتساق أكثر من هوية المتحدث.
هل يمكن لـ DubSmart استنساخ صوت من تسجيل قصير؟
نعم. يتطلب استنساخ الصوت 20 ثانية على الأقل من الصوت، والتسجيل النظيف الخالي من الضوضاء الخلفية يُنتج أفضل نتيجة. ويمكن بعد ذلك استخدام الصوت المستنسخ في تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي.
هل ينبغي أن أستخدم تغيير الصوت الفوري للترجمة المحلية للفيديو؟
عادةً لا. التغيير الفوري يلائم المكالمات الحية والبث والتجارب التفاعلية. أما للفيديوهات متعددة اللغات، فإن الدبلجة المسجّلة بالذكاء الاصطناعي تمنح مجالًا أكبر بكثير للترجمة والتحرير والتزامن ومراجعة النتيجة النهائية.
هل أحتاج إلى إذن لاستنساخ صوت شخص ما؟
نعم. احصل على الإذن المناسب وأكّد الحقوق التجارية قبل استنساخ أو توزيع صوت شخص قابل للتمييز، وتأكّد من أن الموافقة تغطي اللغات والمحتوى والقنوات ومدة الاستخدام المقصودة.