يُحوّل مُغيّر الصوت بالذكاء الاصطناعي في الوقت الفعلي صوتك إلى صوت مختلف أثناء تحدثك، حيث يلتقط صوت الميكروفون ويحلله ويُحوّل هوية المتحدث ويُعيد تشغيل الصوت المُحوّل مع تأخير قصير. وعلى خلاف مُرشّح تغيير طبقة الصوت الأساسي، فإنه قادر على الحفاظ على الكثير من كلماتك وتوقيتك وتعبيرك سليمًا مع تغيير خصائص مثل جرس الصوت، والعمر المُدرَك، والتعبير الجندري، أو طابع الشخصية. وعلى خلاف تحويل النص إلى كلام، فإنه يبدأ من الكلام الحيّ وليس من نص مكتوب.
القرار الحقيقي للمبدعين والبثاثين والمعلمين والشركات ليس ببساطة ما إذا كانت النتيجة تبدو واقعية. بل هو ما إذا كانت الأداة تتوافق مع نوع المدخلات لديك، وتحمّلك لزمن التأخير، واحتياجاتك للتحكم بالصوت، وعمليات التكامل، والتزامات الحقوق، وجودة الإنتاج المستهدفة. يشرح هذا الدليل كيف تعمل التقنية، وأين تندرج مقارنة بأدوات الصوت الأخرى القائمة على الذكاء الاصطناعي، ومتى يخدمك سير العمل المُسجَّل بشكل أفضل.
جدول المحتويات
ماذا تعني "الوقت الفعلي" فعليًا
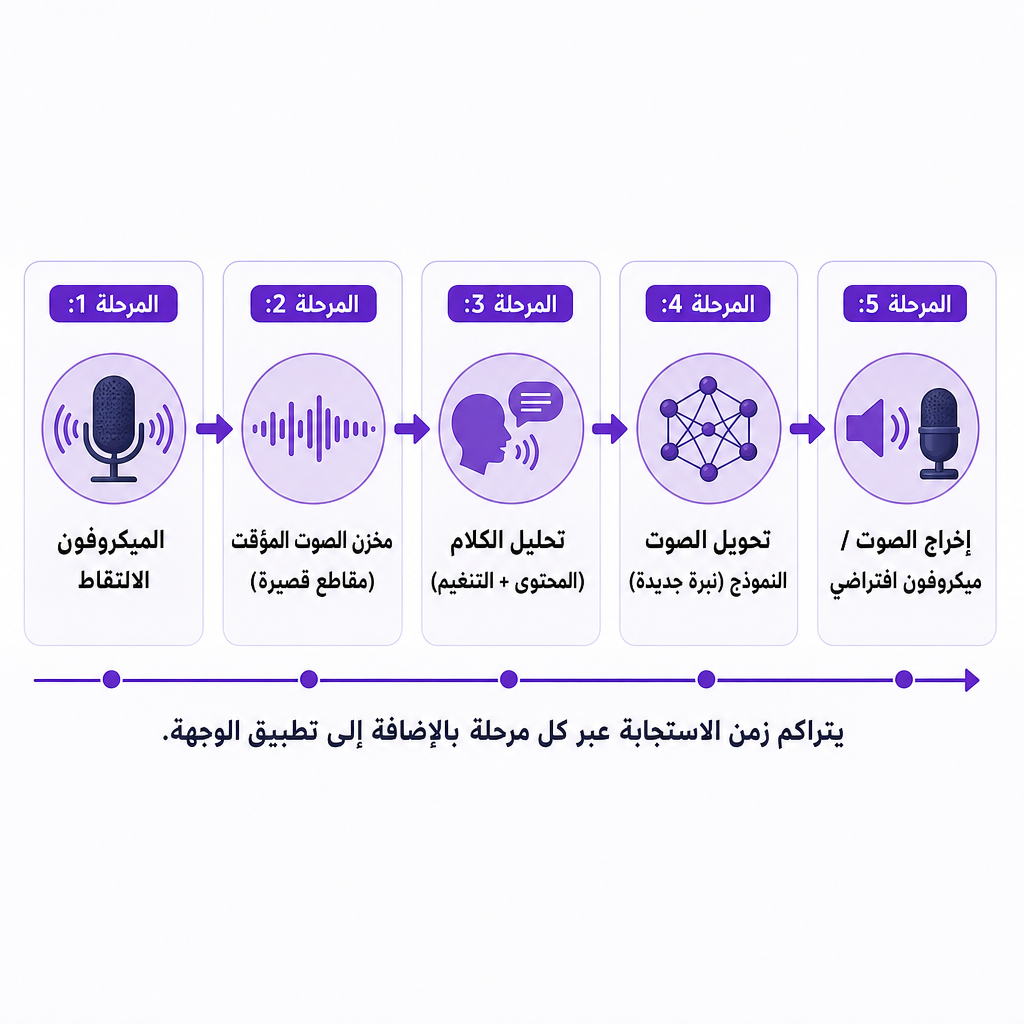
تعني "الوقت الفعلي" أن النظام يعالج تدفق الصوت الوارد أثناء تحدثك بدلًا من انتظار تسجيل كامل أو نص جاهز. تسير الإشارة في مسار مستمر: الميكروفون، ذاكرة الصوت المؤقتة، تحليل الكلام، نموذج تحويل الصوت، مخرج الصوت. ولأن المُحوّل يعمل على مقاطع قصيرة بدلًا من جمل كاملة، فإن تحويل الصوت المتدفق يختلف تقنيًا عن تصيير تعليق صوتي جاهز يكون فيه النص بأكمله معروفًا مسبقًا.
بعض التأخير لا مفرّ منه. يحتاج النظام إلى وقت لالتقاط كل جزء من الصوت وتحليله وتوليفه وإخراجه. تُظهر الأبحاث أن التحويل منخفض زمن التأخير قابل للتحقيق، رغم أن الأرقام تعتمد بشكل كبير على النموذج والعتاد وحجم الذاكرة المؤقتة وجودة الصوت. يُبلّغ نموذج بحث LLVC عن زمن تأخير أقل من 20 ميلي ثانية على معالج مركزي استهلاكي، بينما يُبلّغ StreamVC عن زمن تأخير شامل من طرف إلى طرف قدره 70.8 ميلي ثانية في بيئة تقييمه. هذه نتائج بحثية في ظل ظروف محددة، وليست ضمانات أداء لأي أداة تجارية قد تُنزّلها.
كيف يعمل مُغيّر الصوت بالذكاء الاصطناعي في الوقت الفعلي
تعمل العملية كحلقة أثناء حديثك، وليست كعملية تصيير واحدة. فهم المراحل الأربع يساعدك على الحكم على سبب شعورك بأن أداة ما تبدو طبيعية وأخرى تبدو آلية أو متأخرة.
أولًا، يلتقط النظام كلامك. يستقبل الصوت من ميكروفون أو مدخل حيّ آخر ويقسّمه إلى مقاطع قصيرة حتى يتمكن النموذج من معالجته باستمرار. جودة المدخلات تهم أكثر مما يتوقع كثير من المستخدمين. فالضوضاء الخلفية وصدى الغرفة وطقطقة لوحة المفاتيح والتقطيع والإشارة غير المستقرة كلها تدفع بالتحويل نحو تشوهات غير طبيعية.
ثانيًا، يفصل محتوى الكلام عن هوية المتحدث. يحمل الصوت عدة طبقات متداخلة في آنٍ واحد: المحتوى اللغوي، أي الكلمات؛ والبروزودي، ويعني الإيقاع والتشديد والتنغيم؛ وطبقة الصوت؛ وجرس الصوت الذي يجعل الصوت مميزًا؛ وهوية المتحدث الأوسع. تحاول أنظمة التحويل الحفاظ على المحتوى والتعبير مع استبدال خصائص المتحدث. تصف أبحاث البث الحديثة ذلك بأنه الحفاظ على محتوى الكلام المصدري والبروزودي مع مطابقة جرس صوت المتحدث المستهدف. هذا الفصل هو السبب في أن المُحوّل الجيد يتيح لك التحدث بعفوية بصوت مُحوّل بدلًا من فرض مُرشّح "روبوت" ثابت على الموجة الصوتية.
ثالثًا، يُوَلِّد النموذج صوتًا جديدًا. يعيد بناء الصوت باستخدام ملف صوت مستهدف، قد يكون شخصية مدمجة، أو صوتًا من مكتبة، أو صوتًا مخصصًا أُنشئ من تسجيلات مُصرَّح بها، أو ملفًا مصممًا لإخفاء الهوية بدلًا من المحاكاة. يُنتج المخرج باستمرار مع ذاكرة استشرافية مؤقتة صغيرة. يمكن أن يُحسّن السياق الأكبر الاستقرار، لكنه يضيف أيضًا تأخيرًا، وهو المقايضة الجوهرية للتحويل الحيّ.
رابعًا، تُوجَّه الإشارة المُحوّلة إلى تطبيق. تكشف الأداة المكتبية عادةً المخرج كميكروفون افتراضي، فتستقبله البرامج الأخرى كأنه ميكروفون عادي. هذا التوجيه هو ما يجعل البثوث الحية والألعاب عبر الإنترنت ومكالمات الفيديو والدردشات الصوتية والفعاليات الافتراضية ممكنة. ولذلك يتعين على المُغيّر في الوقت الفعلي أن يعمل على مستوى نظام التشغيل والتطبيق، وليس فقط داخل النموذج. يمكن أن يكون التوافق مع برامج البث وDiscord وZoom والمتصفحات والأجهزة المحمولة بأهمية جودة الصوت ذاتها. إذا أردت استخراج نص نظيف من نفس الصوت الملتقط للتسميات التوضيحية أو إعادة الاستخدام، فإن خطوة منفصلة لـتحويل الكلام إلى نص تتولى النسخ النصي بدلًا من التحويل.
التحويل في الوقت الفعلي مقابل أدوات الصوت الأخرى بالذكاء الاصطناعي
تتداخل هذه التقنيات في أذهان الناس لكنها تحل مشكلات مختلفة حقًا. يوضح الجدول أدناه ما تتخذه كل تقنية كمدخل ومتى تصل المخرجات.
| التقنية | المدخلات | توقيت المخرجات | الأنسب لـ |
|---|---|---|---|
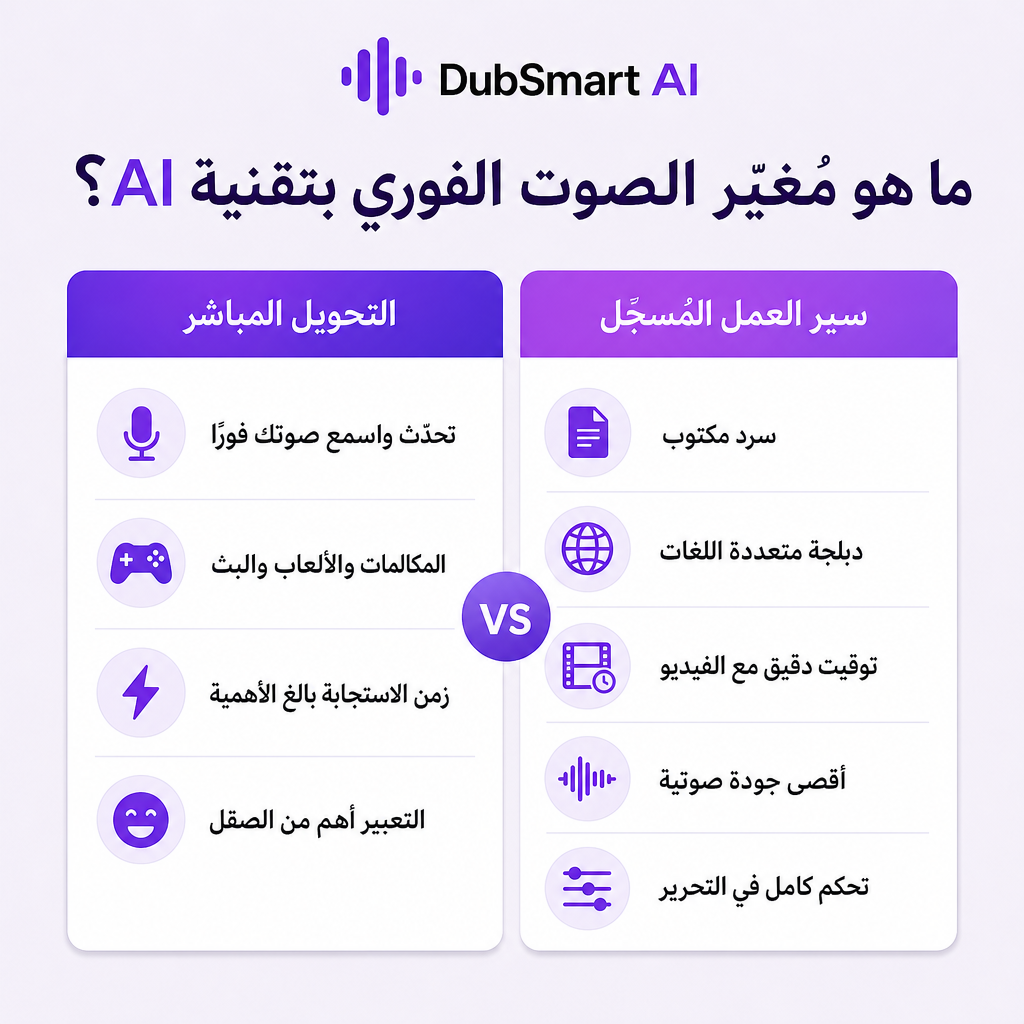
| مُغيّر الصوت في الوقت الفعلي | الكلام الحيّ من الميكروفون | أثناء المحادثة | المكالمات الحية والألعاب والبث والأداء |
| تحويل النص إلى كلام | نص مكتوب | بعد إرسال النص | السرد والدروس التعليمية والإعلانات والتعلم الإلكتروني |
| استنساخ الصوت | عيّنات صوتية | يُولَّد عند الطلب | صوت اصطناعي قابل لإعادة الاستخدام للسرد أو الدبلجة |
| الدبلجة بالذكاء الاصطناعي | صوت أو فيديو موجود | بعد المعالجة | ترجمة وتوطين المحتوى المُسجَّل |
| تأثير طبقة الصوت أو الفورمانت | صوت حيّ أو مُسجَّل | حيّ أو شبه حيّ | تعديل صوتي إبداعي بسيط |
هذا التمييز عملي وليس أكاديميًا. قد تقدّم منصة ما توليدًا قويًا للصوت بالذكاء الاصطناعي أو استنساخًا للصوت دون أن تقدّم مُغيّر ميكروفون حيّ للمكالمات والبثوث. تركّز أدواتنا على الوسائط المُولَّدة والمُوطَّنة: نوفّر تحويل النص إلى كلام، واستنساخ الصوت، والدبلجة بالذكاء الاصطناعي، وتحويل الكلام إلى نص، وفاصل الكلام، وتحويل النص إلى صورة، وتحويل الصورة إلى فيديو داخل سير عمل واحد. هذه مصممة لإنتاج صوت من نص أو لبناء صوت قابل لإعادة الاستخدام للمحتوى المُولَّد، لذا فهي تنتمي إلى جانب سير العمل المُسجَّل من هذا الجدول وليس إلى تحويل الميكروفون الحيّ.
فيمَ يصلح تحويل الصوت الحيّ
يلجأ البثاثون واللاعبون إلى تحويل الصوت للحفاظ على شخصية، أو حماية الخصوصية، أو الحفاظ على طابع قناة ثابت. يهم انخفاض زمن التأخير أكثر ما يهم هنا، لأنك تتفاعل مع لاعبين آخرين وتتحدث مع جمهور. يمكن تحمّل تأخير صغير في مونولوج بأسلوب البث، لكنه يصبح صارخًا أثناء المزاح السريع، أو اللعب التنافسي، أو التوقيت الكوميدي.
في الاجتماعات عبر الإنترنت والفعاليات الافتراضية، يمكن للصوت المُحوّل أن يدعم أداء الأدوار، أو العروض التوضيحية، أو سيناريوهات إمكانية الوصول، أو المشاركة الواعية بالخصوصية. في الإعدادات المهنية، ينبغي أن يتفوق الوضوح والموثوقية على الطرافة، وينبغي إخبار المشاركين عند تحويل صوت ما إذا كان الصمت قد يُضللهم.
أداء الشخصيات استخدام حيّ آخر. يمكن لصانعي الأفلام المستقلين ومطوّري الألعاب ومُعدّي البودكاست اختبار أصوات الشخصيات أو أداء حوار مؤقت على الفور. أما للتسليم النهائي، فإن تعليقًا صوتيًا مُسجَّلًا بالذكاء الاصطناعي أو أداءً بشريًا يمنح عادةً تحكمًا أفضل في التحرير وثباتًا من جلسة إلى أخرى.
خصوصية الصوت وإخفاء الهوية هدف مختلف عن المحاكاة. يحاول إخفاء الهوية إخفاء من المتحدث، بينما تحاول المحاكاة إعادة إنتاج هوية مستهدفة محددة. ولا أيٌّ منهما مضمون، ويمكن للصوت المُحوّل أن يُسرّب عادات الحديث، أو الصياغة، أو الأصوات الخلفية التي تساعد على تحديد المتحدث.
وأخيرًا، تدعم تقنية الصوت الاصطناعي إمكانية الوصول والتواصل المساعد لمن فقدوا القدرة على الكلام. تُقر لجنة التجارة الفيدرالية بهذه الفائدة الطبية والمتعلقة بإمكانية الوصول، بينما تحذّر أيضًا من أن استنساخ الصوت يمكن أن يُساء استخدامه للاحتيال وإساءة استخدام البيانات الحيوية.
معايير القرار التي تهم فعلًا
يأتي زمن التأخير أولًا، وينبغي أن تطلب زمن التأخير المقاس من طرف إلى طرف، وليس سرعة استدلال النموذج وحدها. التأخير الذي تشعر به فعليًا يشمل التقاط الميكروفون، والتخزين المؤقت، واستخراج الميزات، واستدلال النموذج، والتوليف، وتوجيه المخرجات، وأي شيء يضيفه تطبيق الاتصال أو البث فوق ذلك. يمكن لنموذج يُحقق أداءً مرجعيًا سريعًا بمفرده أن يبدو بطيئًا بمجرد تجميع المسار الكامل.
الطبيعية هي الاختبار التالي. استمع إلى التشوهات المعدنية، والقفزات النغمية المفاجئة، ومشاكل التنفس والنطق، والتوقفات غير الطبيعية، والحروف الساكنة المشوهة، والأعطال عند حدود الجمل، وفقدان التعبير العاطفي. ينبغي أن يبقى الصوت المُقنِع مفهومًا أثناء الكلام العفوي، وليس فقط أثناء جمل العرض المقروءة بعناية.
الحفاظ على محتوى الكلام من السهل تجاهله حتى يفشل. اختبر الكلام السريع، والمقاطعات، والأرقام، والأسماء، واللهجات، والضحك، والأسئلة، وتغيرات الصوت. الأداة التي تُغيّر الهوية لكنها تُسطّح إيقاعك وتنغيمك تكون خيارًا سيئًا للأداء أو التفاعل الحيّ.
تحديد الصوت والتخصيص يحددان مدى قدرتك على تشكيل النتيجة. تحقق من الأصوات المدمجة، وإنشاء الصوت المخصص، وأدوات التحكم في طبقة الصوت والنبرة، وخيارات العاطفة أو الأسلوب، وخيارات اللهجة، والثبات عبر الجلسات، وأي قيود للاستخدام التجاري. ينبغي أن يتطلب إنشاء الصوت المخصص دائمًا تصريحًا واضحًا: فعيّنة الصوت ليست إذنًا بمحاكاة الشخص الذي أتت منه.
يحدد دعم العتاد والمنصة ما إذا كانت الأداة تناسب إعدادك من الأساس. تأكد مما إذا كانت تعمل محليًا على المعالج المركزي أو وحدة معالجة الرسومات، أو في متصفح، أو عبر تطبيق مكتبي، أو على الهاتف المحمول، أو عبر ميكروفون افتراضي، أو عبر واجهة برمجة تطبيقات. يمكن أن تُبسّط المعالجة السحابية الإعداد لكنها تُدخل زمن تأخير شبكي وأسئلة حوكمة البيانات، بينما يمكن أن تقلل المعالجة المحلية تأخير الشبكة لكنها تتطلب عتادًا أكثر قدرة. وبشكل منفصل، تحقق من توجيه الصوت: فالنموذج القوي عديم الفائدة إن لم يكن من الممكن تحديد مخرجه كميكروفون في التطبيق المقصود.
تختتم معالجة البيانات القائمة. قبل رفع أي عيّنات صوتية، راجع ما إذا كانت التسجيلات محفوظة، وما إذا كانت تُغذّي تحسين النموذج، وكيف تُحذف الأصوات المخصصة، ومن يمكنه الوصول إلى الملفات، وما إذا كانت ضوابط الأعمال أو المؤسسات موجودة، وماذا يحدث للصوت المُولَّد بعد ذلك. يمكن أن تكون التسجيلات الصوتية بيانات شخصية حساسة أو متعلقة بالبيانات الحيوية بحسب السياق والقانون المعمول به، لذا تعامل معها على هذا النحو.
متى يتفوق سير العمل المُسجَّل على الوقت الفعلي
التحويل الحيّ هو الخيار الصحيح عندما يحتاج شخص إلى التحدث بطبيعية وسماع صوته المُحوّل على الفور. وهو الخيار الخاطئ عندما تكون أولويتك أقصى جودة للصوت، أو نطقًا دقيقًا، أو سردًا متعدد اللغات، أو توقيتًا مضبوطًا مقابل الفيديو، أو تحريرًا مفصّلًا، أو تعليقًا صوتيًا تجاريًا ثابتًا، أو دبلجة عالية الجودة.
لتلك الأهداف، يفوز خط الأنابيب المُسجَّل. مع تحويل النص إلى كلام، تتحكم في النص وتُنقّحه قبل توليد أي صوت، مما يزيل مشكلة زمن التأخير الحيّ تمامًا. مع الدبلجة بالذكاء الاصطناعي، يعالج النظام فيديو موجودًا ويُحاذي الكلام المُترجَم مقابل المصدر، وهو ما لا يستطيع أي مُغيّر حيّ القيام به. إذا كان ملفك المصدري يمزج الحوار بالموسيقى أو الضوضاء، فإن فاصل الكلام يمكنه عزل مسار صوتي نظيف قبل معالجته. صُممت الدبلجة بالذكاء الاصطناعي لدينا لترجمة الصوت أو الفيديو المُسجَّل إلى اللغات المستهدفة المدعومة، وليس لتحويل تغذية ميكروفون حيّة.
المخاطر والاستخدام المسؤول
انتحال الشخصية والاحتيال هما الخطر الأبرز. يمكن للصوت المُحوّل الواقعي أن يجعل هوية زائفة أكثر قابلية للتصديق، وتحذّر لجنة التجارة الفيدرالية من أن أنظمة استنساخ الصوت تُستخدم في عمليات احتيال عائلية، وانتحال شخصيات تجارية، وابتزاز، وأشكال احتيال أخرى، إلى جانب مخاطر على فناني الأداء الصوتي الذين قد تُستولى على أصواتهم. لا تستخدم صوت شخص حقيقي يمكن التعرف عليه دون تصريح، ولا تقدّم أبدًا صوتًا مُولَّدًا أو مُحوّلًا بالذكاء الاصطناعي كدليل على أن شخصًا بعينه تحدّث.
الموافقة وحقوق الصوت تتبع مباشرة. احصل على إذن قبل استنساخ أو محاكاة صوت شخص آخر عمدًا، واحتفظ بسجل لذلك الإذن، خاصة للمشاريع التجارية، والإعلانات، والتدريب، والألعاب، أو الوسائط العامة. تناقش مواد لجنة التجارة الفيدرالية المذكورة هنا الأضرار والإنفاذ والحلول المقترحة بدلًا من إرساء قاعدة موافقة واحدة لكل استخدام، لذا يمكن أن تعتمد الالتزامات المحددة على الولاية القضائية، والعقد، والمنصة، وحالة الاستخدام. عند الشك، تحقق بما يناسب وضعك.
الإفصاح معقول كلما كان من المعقول أن يصدّق الجمهور أن شخصًا حقيقيًا يتحدث مباشرة. إشعار قصير بأن الصوت مُولَّد بالذكاء الاصطناعي أو مُحوّل الصوت يقلل الالتباس. الأمن يهم أيضًا: احمِ العيّنات الصوتية وملفات الصوت المخصصة مثل سائر الأصول الحساسة، وقيّد الوصول، وتجنب رفع التسجيلات دون إذن، وأزل ملفات الصوت غير المستخدمة حيثما تسمح الخدمة بذلك. وأخيرًا، خطط لإخفاقات الجودة. يمكن لزمن التأخير والصوت المفقود وتشوهات التحويل أن تُخرج محادثة عن مسارها، لذا اختبر الإعداد الكامل بالميكروفون وسماعات الرأس والتطبيق والشبكة والعتاد الفعلية قبل الظهور للعلن.
أين تندرج أدواتنا في مشروعك الصوتي
نقدّم سير عمل متكاملًا للوسائط بالذكاء الاصطناعي بدلًا من منتج مُغيّر صوت ميكروفون حيّ. على منصتنا يمكنك توليد كلام من نص، والاختيار من أكثر من 300 صوت، وإنشاء أصوات مستنسخة من عيّنة قصيرة، واستخدام تلك الأصوات عبر مشاريع تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي. ندعم الدبلجة من أكثر من 60 لغة مصدرية إلى 33 لغة مستهدفة، مما يجعلنا خيارًا قويًا عندما تكون المهمة إنشاء تعليق صوتي من نص، أو إنتاج كلام بصوت مخصص، أو دبلجة صوت أو فيديو مُسجَّل، أو توطين المحتوى لجماهير متعددة اللغات.
للمطوّرين، ننشر صفحات واجهة برمجة تطبيقات منفصلة لـتحويل النص إلى كلام، واستنساخ الصوت، والدبلجة بالذكاء الاصطناعي. هذه عمليات توليد وتوطين. إذا كان مشروعك يحتاج تحديدًا إلى مُغيّر صوت ميكروفون حيّ، فتأكد من أن مدخلات البث في الوقت الفعلي، وتوجيه المخرجات، وأهداف زمن التأخير، ودعم الجلسات الحية مُوثَّقة صراحةً قبل الالتزام بأي واجهة برمجة تطبيقات، سواء كانت لنا أو لأي جهة أخرى.
إذا كنت تزن التحويل الحيّ مقابل خط أنابيب مُسجَّل ولست متأكدًا أي مسار يناسب محتواك، فأخبرنا بصيغة مصدرك، واللغات المستهدفة، وما إذا كنت تحتاج مخرجات حية أم مُسجَّلة مسبقًا، وسنوجّهك إلى سير العمل الصحيح.
الأسئلة الشائعة
هل مُغيّر الصوت بالذكاء الاصطناعي في الوقت الفعلي هو نفسه تحويل النص إلى كلام؟
لا. يُحوّل مُغيّر الصوت في الوقت الفعلي الكلام الحيّ من الميكروفون أثناء حديثك، بينما يُولِّد تحويل النص إلى كلام كلامًا جديدًا من نص مكتوب تُرسله أولًا. صُمم تحويل النص إلى كلام لدينا لتوليد الكلام من نص، وليس للتحويل الحيّ من الميكروفون.
هل مُغيّر الصوت بالذكاء الاصطناعي في الوقت الفعلي خالٍ من التأخير؟
لا. يحتاج كل نظام إلى وقت لالتقاط الصوت ومعالجته، لذا لا مفرّ من بعض زمن التأخير. يعتمد التأخير العملي على النموذج والجهاز وإعدادات الذاكرة المؤقتة والشبكة والتطبيق الوجهة، وتُبلّغ الأنظمة البحثية عن أرقام مختلفة في ظل ظروف اختبار مختلفة.
هل يمكن لمُغيّر الصوت بالذكاء الاصطناعي نسخ صوت أحد المشاهير؟
يمكن لبعض الأنظمة تقنيًا محاكاة أصوات يمكن التعرف عليها، لكن القدرة التقنية ليست إذنًا. تجنّب انتحال الشخصية غير المصرّح به وتحقق من العقود ذات الصلة وقواعد المنصة والقوانين قبل استخدام صوت أي شخص يمكن التعرف عليه.
ماذا ينبغي أن أستخدم لإنشاء مقاطع فيديو متعددة اللغات على يوتيوب؟
بالنسبة للفيديوهات المُسجَّلة مسبقًا، تتناسب الدبلجة بالذكاء الاصطناعي عمومًا بشكل أفضل من مُغيّر الصوت الحيّ لأنها تعالج الفيديو الموجود وتُنتج صوتًا مُحاذى ومُوطَّنًا. تُترجم الدبلجة بالذكاء الاصطناعي لدينا وتدبلج الصوت أو الفيديو المُسجَّل إلى اللغات المدعومة.
هل يمكن لمنصتكم تغيير صوتي مباشرة أثناء مكالمة؟
توثّق منصتنا تحويل النص إلى كلام، واستنساخ الصوت، والدبلجة بالذكاء الاصطناعي بدلًا من تحويل الصوت الحيّ من الميكروفون. إذا كنت تخطط لسير عمل مكالمات حية، فتأكد من وثائق المنتج الحالية معنا أولًا حتى نتمكن من التوصية بالنهج الصحيح.