Nếu micro của bạn thu cả tiếng xe cộ, tiếng ồn quán cà phê, hay một nền nhạc chồng ngay lên lời thoại, thì câu hỏi không phải là bản ghi có dùng được hay không—mà là làm sao tách giọng nói ra thật sạch. Đó chính xác là những gì một bộ tách giọng nói (speech separator) làm. Nói đơn giản, bộ tách giọng nói là một công cụ âm thanh chạy bằng AI, cô lập giọng nói con người khỏi mọi thứ khác trong bản ghi—tiếng ồn nền, âm nhạc và các âm thanh khác—để bạn còn lại một bản giọng sạch có thể phiên âm, lồng tiếng, nhân bản hay phối lại. Với bất kỳ ai sản xuất nội dung đa ngôn ngữ, bản giọng sạch đó chính là ranh giới giữa lồng tiếng nghe chuyên nghiệp và lồng tiếng nghe "tạm được".
Hướng dẫn này giải thích bộ tách giọng nói thực sự là gì, nó hoạt động ra sao ở tầng sâu, khi nào bạn thật sự cần đến nó, và cần cân nhắc gì trước khi quyết định chọn một công cụ. Chúng tôi tích hợp Bộ Tách Giọng Nói vào quy trình DubSmart AI chính vì giọng nói sạch là nền tảng mà mọi thứ khác đứng trên đó.
Mục lục
Bộ tách giọng nói thực sự là gì
Trong nghiên cứu âm thanh, tách giọng nói được định nghĩa là tác vụ tách giọng nói mục tiêu khỏi nhiễu nền trong một bản ghi hỗn hợp. Các hệ thống tiên tiến hơn còn đi xa hơn, tách nhiều người nói ra khỏi nhau, tạo ra một bản riêng biệt cho từng giọng.
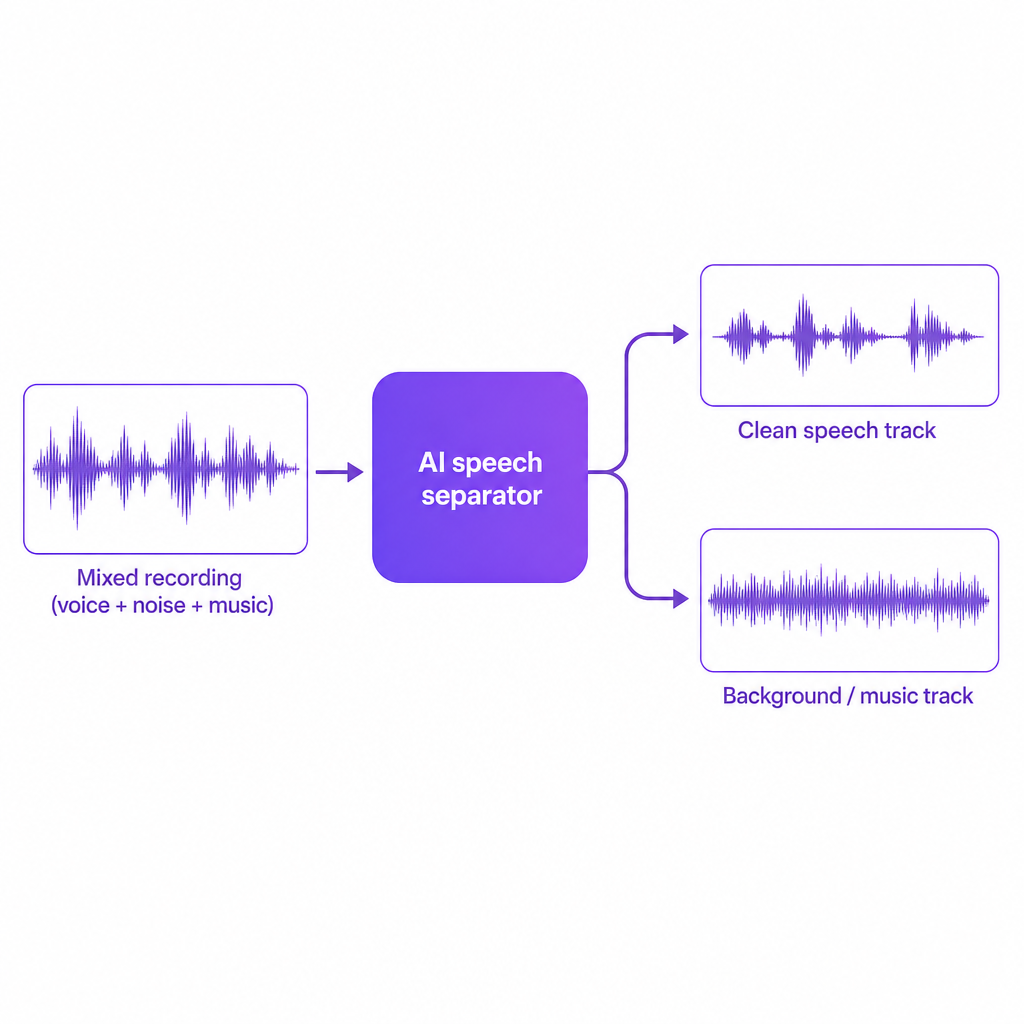
Chuyển sang công việc sản xuất hàng ngày, bộ tách giọng nói nhận một tệp âm thanh hỗn hợp—lời thoại cùng tiếng ồn hoặc âm nhạc—và cho ra một hoặc nhiều bản chỉ chứa giọng nói, cộng thêm một bản tùy chọn giữ lại phần âm thanh nền còn lại. Bộ Tách Giọng Nói của chúng tôi được xây dựng để loại bỏ tiếng ồn nền và cô lập giọng nói khỏi bất kỳ bản ghi nào, khiến nó rất phù hợp với khâu hậu kỳ của phim, podcast và phỏng vấn. Nó hoạt động trên cả tệp âm thanh lẫn video: có thể khử nhiễu các bản ghi từ môi trường ồn ào và tách giọng hát khỏi bản nhạc nền để bạn có được các stem giọng và nền riêng biệt.
Đây là chỗ một quan niệm sai lầm phổ biến khiến nhiều người vấp phải. Bộ tách giọng nói không giống với giảm nhiễu truyền thống. Giảm nhiễu hạ âm lượng của âm thanh không mong muốn. Bộ tách giọng nói chủ động nhận diện nơi giọng nói xuất hiện trong tín hiệu và tái dựng nó thành một luồng riêng biệt, sạch hơn. Chính sự khác biệt đó lý giải vì sao một bộ tách có thể cứu vãn một giọng nói bị chôn vùi dưới âm nhạc, trong khi một cổng khử nhiễu (noise gate) hầu như chỉ làm cả bản ghi trở nên êm hơn.
Bạn có thật sự cần đến nó không?
Quyết định thực sự nằm ở chỗ công việc của bạn có phụ thuộc vào âm thanh giọng nói đáng tin cậy, sạch sẽ hay không, thay vì chỉ dựa vào bất cứ gì micro tình cờ thu được. Nếu có, một bộ tách chuyên dụng không còn là thứ "có thì tốt" mà trở thành một bước nền tảng.
Có vài tình huống khiến việc nâng cấp này trở nên hiển nhiên. Các nhà sáng tạo YouTube và doanh nghiệp nhỏ thường tái sử dụng những đoạn phim cũ được quay trong phòng vọng âm, quán cà phê, hoặc ngoài đường phố, nơi tiếng ồn khiến giọng nói khó nghe và khó phiên âm. Các đội ngũ e-learning và đào tạo xây dựng khóa học đa ngôn ngữ từ các buổi webinar và bài giảng trực tiếp, nơi mọi bản phiên âm và bản lồng tiếng phía sau đều thừa hưởng chất lượng của giọng nói gốc. Các nhà làm phim và nhà sản xuất podcast thường xuyên cần cứu vãn một màn trình diễn tuyệt vời được thu trong điều kiện không hoàn hảo trước khi phối lại với âm nhạc và thiết kế âm thanh. Còn các lập trình viên hay đại lý đưa âm thanh người dùng vào các quy trình phiên âm, nhân bản giọng nói hoặc lồng tiếng đều biết rằng đầu vào ồn ào trực tiếp kéo giảm độ chính xác của mô hình.
Một vài dấu hiệu cụ thể cho thấy đáng để áp dụng một bộ tách:
- Bạn đang bản địa hóa sang nhiều ngôn ngữ và muốn lồng tiếng cùng phụ đề nhất quán, rõ ràng. Giọng nói sạch cung cấp cho các động cơ Lồng Tiếng AI và Chuyển Giọng Nói Thành Văn Bản của chúng tôi đáng tin cậy hơn nhiều so với một bản hỗn hợp ồn ào.
- Bạn dựa vào nhân bản giọng nói cho một giọng thương hiệu hay giọng nhân vật và muốn có kết quả tốt nhất có thể bằng cách huấn luyện trên các mẫu đã khử nhiễu, không có nhiễu tạp âm.
- Bạn thường xuyên nhận được các bản ghi do người dùng tạo hoặc thu ngoài hiện trường mà bạn không kiểm soát, nhưng vẫn cần chúng sẵn sàng phát sóng. Một bộ tách mang lại cho bạn một khâu làm sạch lặp lại được thay vì phải chỉnh tay từng tệp.
Ngoại lệ thẳng thắn: nếu âm thanh của bạn vốn đã được thu trong một phòng thu đã xử lý âm học, với các stem riêng cho lời thoại và âm nhạc, thì một bộ tách chỉ là tiện lợi chứ không phải bắt buộc. Với tất cả những ai khác đang làm việc với âm thanh đời thực, nó xứng đáng có một chỗ đứng lâu dài trong quy trình.
Tách giọng nói hoạt động ra sao ở tầng sâu
Tách giọng nói hiện đại được xây dựng trên học sâu và nghiên cứu tách nguồn, chứ không phải EQ và bộ lọc đơn giản. Tác vụ nền tảng dễ phát biểu nhưng khó giải: cho một tín hiệu hỗn hợp chứa nhiều nguồn, hãy khôi phục các tín hiệu giọng nói riêng lẻ mà không biết trước chúng là gì.
Hầu hết các hệ thống hiện tại đi theo quy trình bộ mã hóa–bộ tách–bộ ước lượng–bộ giải mã. Bộ mã hóa ánh xạ dạng sóng thô hoặc phổ đồ vào một không gian đặc trưng nhiều chiều, nơi các mẫu liên quan đến giọng nói như formant và hài âm trở nên dễ phát hiện hơn. Bộ tách—một mạng nơ-ron—xử lý các đặc trưng đó và học cách tách rời thông tin thuộc về các nguồn âm thanh khác nhau, dù đó là giọng nói với tiếng ồn hay một người nói với một người khác. Sau đó, giai đoạn ước lượng hoặc dự đoán các mặt nạ lọc bỏ các thành phần không phải giọng nói, hoặc trực tiếp ước lượng biểu diễn đặc trưng của từng nguồn. Cuối cùng, bộ giải mã chuyển các biểu diễn đã tách này trở lại âm thanh miền thời gian, tạo ra một hoặc nhiều bản giọng nói sạch và tùy chọn một bản nền còn lại.
Các mô hình này được huấn luyện trên các tập dữ liệu lớn đầy các hỗn hợp giọng nói-và-nhiễu, học các mẫu phân biệt của giọng nói, người nói và nhiễu từ các ví dụ được gán nhãn. Nghiên cứu mới hơn điều kiện hóa bộ tách theo các embedding người nói hoặc lời nhắc (prompt), giúp có thể nhắm việc tách vào một giọng cụ thể bên trong âm thanh đông đúc.
Điều rút ra thực tiễn cho nhà sáng tạo là một bộ tách hiện đại không phải là một cổng khử nhiễu được thổi phồng. Nó là một mô hình đã học được giọng nói trông và nghe ra sao trong nhiều điều kiện, và có thể tái dựng một giọng nói ngay cả khi nó bị chôn vùi dưới âm nhạc, tiếng ồn đám đông, hay tiếng vọng phòng.
Hai tác vụ tách chính
Trên thực tế, bạn sẽ gặp hai dạng tách giọng nói, và các nền tảng thường kết hợp cả hai.
Thứ nhất là giọng nói một người nói so với nền: trích xuất một bản giọng mạch lạc khỏi tiếng ồn, âm nhạc, hoặc âm thanh môi trường. Đây là tác vụ mà Bộ Tách Giọng Nói của chúng tôi tập trung vào cho phim, podcast và phỏng vấn, vì nó ánh xạ trực tiếp vào điều mà đa số nhà sáng tạo cần hàng ngày.
Thứ hai là tách nhiều người nói, nơi hệ thống tạo ra một bản riêng cho từng người nói trong một cuộc trò chuyện. Điều đó đặc biệt hữu ích cho việc phân biệt người nói (diarization) và phân tích trong các cuộc họp hay thảo luận dạng dài, nơi biết ai nói gì cũng quan trọng như biết đã nói gì.
Các công cụ dành cho người tiêu dùng thường đóng gói những thứ này trong các giao diện đơn giản—tải lên một bài hát để nhận các bản giọng và nhạc cụ riêng biệt, hoặc cô lập lời thoại trong một video để chỉnh sửa. Cách triển khai của chúng tôi nhấn mạnh việc tách giọng nói khỏi nền vì đó là tác vụ có giá trị tức thời nhất cho các quy trình lồng tiếng, phiên âm và nhân bản.
Cần cân nhắc gì trước khi chọn một bộ tách
Khi bạn đánh giá liệu một bộ tách có đáp ứng nhu cầu chuyên nghiệp hay không, có một số ít tiêu chí quan trọng hơn lời quảng cáo tiếp thị.
Hãy bắt đầu với chất lượng giọng nói và tạp âm nhân tạo. Một bộ tách tốt giữ lại âm sắc tự nhiên của giọng nói thay vì làm nó nghe kim loại, như dưới nước, hay bị lệch pha (phasey), và nó tránh tạo ra nhiễu dạng nhạc (musical noise) hoặc méo tiếng chói tai khi lột bỏ các thành phần nền mạnh như âm nhạc. Các khảo sát học thuật chỉ ra nhiễu còn sót lại và tạp âm nhân tạo là những thách thức chính, đặc biệt trong nhiễu không tĩnh. Phép thử đáng tin cậy nhất vẫn là kiểm tra các đầu ra mẫu trên chính chất liệu của bạn.
Tiếp theo là khả năng chịu đựng tiếng ồn đời thực. Các mô hình được huấn luyện trên dữ liệu phòng thí nghiệm sạch có thể gặp khó với tiếng xe cộ, tiếng gió, tiếng lầm rầm đám đông, các phòng vang vọng, và nội dung mà giọng nói chồng lên âm nhạc hoặc hiệu ứng lớn. Các công trình tiên tiến nhắm chính xác vào những hỗn hợp phức tạp này, nhưng hiệu năng vẫn thay đổi theo điều kiện thu—vì vậy hãy thử nghiệm trên các môi trường mà bạn thực sự thu âm, từ văn phòng đến đường phố đến phòng thu tại nhà.
Xử lý âm nhạc và nội dung hỗn hợp là một nhu cầu thường xuyên, cụ thể. Loại bỏ một nhạc nền để lồng tiếng lại, hoặc cô lập lời dẫn khỏi cảnh B-roll, đòi hỏi một công cụ hỗ trợ rõ ràng việc tách âm nhạc-và-giọng nói và cho ra hai tệp dùng được thay vì một kết quả bị bóp nghẹt duy nhất. Quy trình tách của chúng tôi phát hiện các tần số giọng hát, cô lập chúng khỏi âm nhạc, và tạo ra các tệp chất lượng cao riêng biệt: một với giọng hát sạch và một với nhạc nền. Điều đó đặc biệt hữu ích khi bạn dự định phối lại, soạn nhạc lại, hoặc lồng tiếng lại sang các ngôn ngữ khác.
Sự tích hợp với các công cụ phía sau quyết định bộ tách thực sự tiết kiệm bao nhiêu thời gian. Việc tách hiếm khi đứng một mình—nó cung cấp cho các mô hình phiên âm nơi đầu vào sạch hơn làm giảm tỷ lệ lỗi từ, các động cơ nhân bản giọng nói tưởng thưởng các mẫu không nhiễu, và các hệ thống lồng tiếng căn chỉnh giọng nói gốc với các bản đã dịch. Nền tảng của chúng tôi được xây dựng quanh một quy trình hợp nhất giữ Bộ Tách Giọng Nói, Chuyển Giọng Nói Thành Văn Bản, Chuyển Văn Bản Thành Giọng Nói, Nhân Bản Giọng Nói, và Lồng Tiếng AI ở cùng một nơi, để một bản ghi đã làm sạch có thể trở thành nội dung đa ngôn ngữ, giọng nhân bản, được bản địa hóa hoàn toàn mà không cần xây lại quy trình mỗi lần.
Độ trễ, quy mô, và tự động hóa quan trọng với bất kỳ ai có tồn đọng công việc. Podcast, khóa học và kho lưu trữ dạng dài cần xử lý theo lô có thể xử lý các tệp dài nhiều giờ, thời gian xử lý mỗi tệp hợp lý, và các móc nối tự động hóa để việc tách nằm bên trong hệ thống của chính bạn. Chúng tôi cung cấp các API Chuyển Văn Bản Thành Giọng Nói, Nhân Bản Giọng Nói, và Lồng Tiếng AI để các lập trình viên có thể đấu nối việc xử lý giọng nói vào các quy trình đầu-cuối.
Cuối cùng, quyền riêng tư và tuân thủ không biến mất một khi âm thanh đã sạch. Việc tách giọng nói khỏi nền không loại bỏ trách nhiệm của bạn đối với các bản ghi có thể chứa những cuộc trò chuyện nhạy cảm, hoặc đối với việc tôn trọng quyền khi bạn trích xuất và tái sử dụng giọng nói từ tài liệu được cấp phép. Các đội ngũ doanh nghiệp nên xác nhận các chính sách rõ ràng về việc lưu giữ và sử dụng dữ liệu, và căn chỉnh mọi quy trình tách với các hướng dẫn tuân thủ nội bộ.
Những hạn chế của nó
Một bộ tách giọng nói có thể biến đổi một bản ghi, nhưng nó không phải phép màu, và giả vờ ngược lại sẽ dẫn đến những quyết định sai lầm.
Khử nhiễu quá mức là cái bẫy phổ biến nhất. Tách quá mạnh tay có thể lột bỏ các tín hiệu giọng nói tinh tế—các phụ âm nhẹ, âm sắc phòng tự nhiên—và để lại một giọng nói nghe không tự nhiên hoặc gây mệt khi nghe. Tạp âm nhân tạo còn sót lại là mặt trái: trong điều kiện khó, một mô hình có thể để lại dấu vết âm nhạc hoặc tiếng ồn trong bản giọng nói, hoặc tạo ra nhiễu dạng nhạc, đặc biệt khi nhiễu mạnh và liên tục thay đổi.
Cũng cần tính đến thiên lệch về người nói và ngôn ngữ. Các mô hình được huấn luyện chủ yếu trên một số ngôn ngữ, giọng địa phương, hay phong cách nói nhất định có thể hoạt động kém hơn trên những giọng nói ít được đại diện. Và một dạng sóng trông sạch có thể tạo cảm giác an toàn giả tạo: nó không đảm bảo âm thanh phù hợp cho các tác vụ then chốt như phân tích pháp y hay các bối cảnh tuân thủ nghiêm ngặt.
Với công việc sáng tạo và bản địa hóa, những hạn chế này có thể quản lý được, nhưng chúng là một lập luận mạnh mẽ cho việc thử nghiệm với các mẫu tiêu biểu từ chính chất liệu của bạn thay vì tin vào các bản demo của nhà cung cấp.
Bộ Tách Giọng Nói trong quy trình của chúng tôi
Chúng tôi xem Bộ Tách Giọng Nói như một cách triển khai công nghệ này thực tế, thân thiện với nhà sáng tạo, được tích hợp chặt chẽ với phần còn lại của nền tảng DubSmart AI thay vì được gắn thêm vào.
Khi sử dụng, nó loại bỏ tiếng ồn nền và cô lập giọng nói khỏi bất kỳ bản ghi nào, tạo ra giọng nói sạch phù hợp cho hậu kỳ trong phim, podcast và phỏng vấn. Nó trích xuất giọng hát rõ ràng từ các bản hỗn hợp và tạo ra các tệp chất lượng cao riêng biệt cho giọng nói và nhạc nền, để bạn có thể chỉnh sửa, lồng tiếng lại, hoặc phối lại mà không phải vật lộn với bản mix gốc. Nó hoạt động trên cả nguồn âm thanh lẫn video—bạn tải tệp lên hoặc dùng liên kết, cho chúng chạy qua quy trình, và tải về các bản đã hoàn thành. Và quan trọng nhất, các đầu ra đó được tối ưu để cung cấp cho các công cụ khác của chúng tôi, để một bản ghi đã làm sạch có thể được biến thành nội dung đa ngôn ngữ, giọng nhân bản, được bản địa hóa hoàn toàn.
Đối với các nhà sáng tạo YouTube, doanh nghiệp nhỏ, người làm đào tạo, nhà làm phim, người làm podcast, và các đội ngũ lập trình viên, sự tích hợp đó thay đổi vai trò của chính việc tách. Nó không còn là một công việc "sửa âm thanh" đơn lẻ mà trở thành bước chuẩn hóa đầu tiên trong một vòng đời sáng tạo và bản địa hóa nội dung tự động, lớn hơn. Nếu bạn đang xây dựng một kênh hay thư viện khóa học đa ngôn ngữ, đó là nơi khoản tiết kiệm thời gian thực sự cộng dồn.
Câu hỏi thường gặp
Bộ tách giọng nói, nói đơn giản, là gì?
Đó là một công cụ AI nhận một bản ghi ồn ào, hỗn hợp và cho ra một bản mà bạn hầu như chỉ nghe thấy giọng nói con người, cộng thêm các bản nền tùy chọn mà bạn có thể giữ hoặc bỏ.
Bộ tách giọng nói có giống với giảm nhiễu không?
Không. Giảm nhiễu chỉ đơn giản hạ thấp các âm thanh không mong muốn. Tách giọng nói nhận diện và tái dựng giọng nói một cách rõ ràng như một nguồn riêng biệt, thường với độ rõ cao hơn và kiểm soát kết quả tốt hơn.
Bộ tách giọng nói có xử lý được nhiều hơn một người nói không?
Nhiều hệ thống cấp nghiên cứu và một số sản phẩm có thể tách nhiều người nói thành các bản riêng lẻ, dù chất lượng thay đổi theo mức độ chồng lấn và điều kiện thu. Bộ Tách Giọng Nói của chúng tôi tập trung chủ yếu vào việc cô lập giọng nói khỏi nền cho các quy trình phổ biến của nhà sáng tạo.
Việc dùng bộ tách giọng nói có cải thiện kết quả lồng tiếng và nhân bản giọng nói của tôi không?
Có. Âm thanh đầu vào sạch hơn nhìn chung cải thiện nhận dạng giọng nói, căn chỉnh, và chất lượng nhân bản giọng nói, khiến việc lồng tiếng đa ngôn ngữ và các giọng nhân bản trở nên tự nhiên và nhất quán hơn.
Tách giọng nói có hoạt động bất kể ngôn ngữ không?
Hầu hết các mô hình tách vận hành trên các mẫu âm học chứ không phải văn bản, nên chúng có thể xử lý nhiều ngôn ngữ. Hiệu năng vẫn phụ thuộc vào dữ liệu huấn luyện và mức độ giọng địa phương của bạn được đại diện tốt đến đâu.