Nếu bạn đang cân nhắc voiceforge text to speech cho một dự án, câu hỏi thực sự hiếm khi là liệu các giọng nói nghe có thú vị hay không. Mà là liệu công cụ có phù hợp với độ dài kịch bản, quyền xuất bản, và loại nội dung mà bạn thực sự tạo ra hay không. VoiceForge là một dịch vụ chuyển văn bản thành giọng nói dựa trên trình duyệt được xây dựng xoay quanh những giọng nhân vật đặc trưng. Nó chuyển đổi một kịch bản thành âm thanh có thể tải xuống bằng cách sử dụng một công cụ tổng hợp lựa chọn đơn vị (unit-selection) ghép nối các đoạn giọng nói được ghi âm từ những người nói thật, thay vì tạo ra từng âm thanh từ một dạng sóng toán học duy nhất. Quyết định thực tế quy về bốn nhu cầu: một giọng nói vui nhộn, dễ nhận biết cho các dự án cá nhân; âm thanh có bản quyền cho truyền thông kiếm tiền; kiểm soát chính xác cách phát âm và nhịp độ; hoặc một quy trình đa ngôn ngữ có thể mở rộng. Chỉ ba nhu cầu đầu tiên là phù hợp hoàn hảo với một trình tạo giọng nhân vật, và khoảng cách đó chính là nơi hầu hết các nhà sáng tạo bị vấp.
Chúng tôi xuất bản hướng dẫn này vì cùng một sự nhầm lẫn xuất hiện lặp đi lặp lại: người ta tạo âm thanh trên bản dùng thử miễn phí, cho rằng họ có thể kiếm tiền từ nó, rồi phát hiện ra giấy phép bị ràng buộc với một gói cụ thể. Dưới đây, chúng tôi phân tích cách công cụ hoạt động, nó có thể và không thể làm gì, và khi nào một công cụ giọng nói đơn lẻ mới lạ là lựa chọn đúng so với một quy trình bản địa hóa hoàn chỉnh.
Mục lục
VoiceForge text to speech thực sự là gì
VoiceForge biến các từ ngữ viết thành âm thanh nói: bạn nhập một kịch bản, chọn một giọng nói, tạo đoạn clip, xem trước, và tải kết quả xuống khi gói của bạn cho phép. Điều khiến nó khác biệt so với một thư viện thuyết minh thông thường là định hướng của nó. VoiceForge thiên về các giọng nói có cá tính thay vì cách thể hiện kiểu doanh nghiệp trung tính, điều này khiến nó trở nên phù hợp tự nhiên với các tiểu phẩm YouTube, clip chơi game, nhân vật hoạt hình, meme, các thông báo mới lạ, và dự án âm nhạc.
Sự tập trung đặt cá tính lên hàng đầu đó là một ưu điểm với một số nội dung và là một điểm bất lợi với nội dung khác. Một giọng hài hước hoặc giọng tổng hợp có chủ đích có thể gánh vác một màn nhại hoặc một NPC trong game, nhưng chính giọng nói đó lại trở nên gây mất tập trung trong một khóa học e-learning, một bản demo sản phẩm, hoặc một quảng cáo thương hiệu cao cấp. Vì vậy, bộ lọc đầu tiên không phải là "giọng này nghe có giống người không?" Mà là "giọng này có thuộc về trước mặt khán giả cụ thể của tôi không?"
Nếu bạn vẫn đang quyết định liệu một trình tạo giọng nói có sẵn có phù hợp với nhu cầu của mình hay không, bài giải thích của chúng tôi về trình tạo giọng nói AI làm gì bao quát danh mục rộng hơn và cách các công cụ này khác với sao chép giọng nói và lồng tiếng.
Cách công cụ lựa chọn đơn vị xây dựng một giọng nói
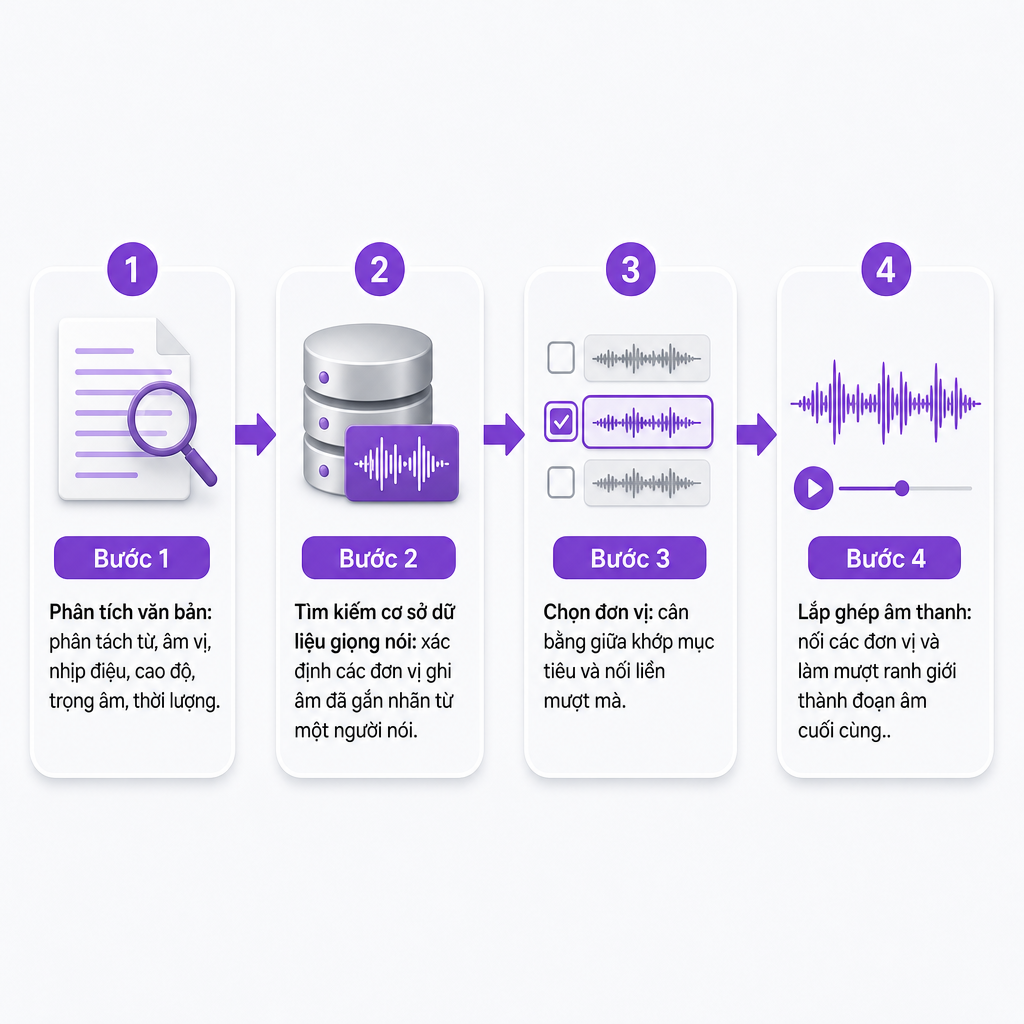
VoiceForge sử dụng tổng hợp lựa chọn đơn vị, còn gọi là tổng hợp ghép nối (concatenative synthesis). Thay vì tạo ra toàn bộ bản ghi từ một dạng sóng do mô hình sản xuất, hệ thống tìm kiếm trong một cơ sở dữ liệu các đoạn giọng nói được ghi âm và ghép những mảnh phù hợp nhất vào câu của bạn. Hiểu được quy trình này giải thích vì sao các giọng nói nghe dễ nhận biết và vì sao chúng hoạt động theo cách của chúng khi bị đặt dưới áp lực.
Quá trình này diễn ra qua vài giai đoạn. Đầu tiên, phân tích văn bản: công cụ phân tích từ ngữ, cấu trúc câu, âm vị, nhịp điệu, cao độ, trọng âm, và thời lượng để quyết định một dòng nên được nói như thế nào. Tiếp theo, tìm kiếm trong cơ sở dữ liệu giọng nói: mỗi giọng được xây dựng từ các bản ghi của một người nói thật, được cắt thành các đơn vị nhỏ hơn và gắn nhãn theo âm thanh và ngữ cảnh. Sau đó là lựa chọn đơn vị, nơi công cụ cân bằng hai mục tiêu đối nghịch cùng lúc — khớp mục tiêu, tức chọn một đơn vị có âm thanh, cao độ, thời lượng, và ngữ cảnh phù hợp, và ghép nối mượt mà, tức ưu tiên các đơn vị liền kề kết nối với nhau mà không có mối nối rõ ràng. Cuối cùng, lắp ghép âm thanh ghép chuỗi đã chọn lại với nhau và áp dụng làm mượt nhẹ ở các ranh giới.
Vì đầu ra được lắp ghép từ các bản ghi thật, mỗi giọng nói giữ được một bản sắc đặc trưng. Đánh đổi là phương pháp này không được thiết kế để cung cấp định hướng cảm xúc không giới hạn hoặc cách thể hiện có thể điều chỉnh hoàn toàn như các hệ thống sinh tạo (generative) mới hơn. Cách diễn đạt bất thường, những chuyển đổi nhanh, hoặc các tổ hợp phát âm khó xử có thể làm lộ các mối nối giữa các đơn vị, tạo ra kết quả nghe kém nhất quán hơn so với một đoạn thu liên tục của con người. Nếu bạn muốn xem một quy trình sinh tạo hoàn toàn khác như thế nào, bài phân tích của chúng tôi về cách chuyển văn bản thành giọng nói bằng mạng nơ-ron hoạt động sẽ dẫn dắt qua phương pháp học sâu thay thế cho việc ghép nối.
Giọng nói, SSML, và giới hạn 500 ký tự
VoiceForge liệt kê 42 giọng nói độc đáo, mỗi giọng được ghi âm bởi một người nói khác nhau với âm sắc và phong cách nói riêng. Con số đó là nhiều khi bản thân giọng nói là một phần của ý tưởng sáng tạo — một người kể chuyện hài cho một video ngắn, một cá tính kỳ lạ cho video chơi game, một âm điệu tổng hợp cho một meme. Tuy nhiên, đó là một danh mục nhỏ hơn đối với các nhóm cần nhiều biến thể theo vùng miền hoặc một người thuyết minh được phối hợp cẩn thận trên nhiều thị trường.
Để kiểm soát cách thể hiện, VoiceForge hỗ trợ một tập con của Ngôn ngữ Đánh dấu Tổng hợp Giọng nói (SSML). Thay vì chỉ dựa vào dấu câu, bạn nhúng các chỉ dẫn trực tiếp vào kịch bản.
| Điều khiển SSML | Chức năng |
|---|---|
<break> |
Chèn một khoảng dừng |
<emphasis> |
Nhấn mạnh một từ hoặc cụm từ |
<prosody> |
Điều chỉnh cao độ, tốc độ nói, hoặc âm lượng |
<phoneme> |
Buộc một cách phát âm chính xác |
<sub> |
Đọc một cách thay thế cho văn bản hiển thị |
<p> / <s> |
Đánh dấu một đoạn văn hoặc câu |
Những thẻ này phát huy giá trị khi công cụ đọc sai tên sản phẩm, từ viết tắt, hoặc thuật ngữ kỹ thuật. Bọc một từ viết tắt trong <sub alias="application programming interface">API</sub> khiến nó đọc đầy đủ cụm từ, và <phoneme> cố định một cái tên khó đọc. Một <break time="500ms"/> giữa các dòng thêm một nhịp dừng có chủ đích ở nơi mà dấu câu không có.
Đây là điều đáng lưu ý làm thay đổi cách bạn viết cho nó: đầu vào văn bản bị giới hạn ở 500 ký tự, và mã đánh dấu SSML được tính vào giới hạn đó. Mỗi thẻ bạn thêm vào đều ngốn bớt không gian dành cho từ ngữ thực tế. Thuyết minh dài phải được chia thành nhiều lần tạo, và mã đánh dấu nặng sẽ thu nhỏ từng phần hơn nữa. Trên thực tế, điều đó có nghĩa là lên kế hoạch cho kịch bản của bạn thành các đoạn ngắn, khép kín thay vì dán vào cả một trang.
Dùng thử miễn phí so với giấy phép thương mại: quyết định quan trọng
VoiceForge cung cấp một bản dùng thử miễn phí có giới hạn, nhưng bản dùng thử không phải là giấy phép xuất bản. Các gói của nó vạch ra một ranh giới rõ ràng giữa sử dụng cá nhân và thương mại, và ranh giới đó chính là nơi hầu hết các sai lầm xảy ra.
Gói Fan Voice dành cho các trò đùa, video, game, hoạt hình, và meme không kiếm tiền. Gói Publisher là gói đăng ký cấp giấy phép thương mại cho âm thanh TTS trong nội dung kiếm tiền hoặc thương mại — video kiếm tiền, game độc lập, và âm nhạc — và quảng cáo tải xuống không giới hạn. Bản dùng thử miễn phí tồn tại để bạn có thể kiểm tra dịch vụ trước khi cam kết.
Quy tắc vận hành rất đơn giản: nếu một dự án kiếm ra tiền, quảng bá một doanh nghiệp, xuất hiện trong truyền thông kiếm tiền, hoặc được phát hành thương mại, hãy xác nhận gói áp dụng trước khi bạn xuất bản. Âm thanh bạn tạo ra trong lúc dùng thử miễn phí không tự động mang theo quyền thương mại chỉ vì nó đã được tải xuống. Ngôn ngữ cấp phép cũng có thể thay đổi, vì vậy trang gói là một điểm khởi đầu, không phải là sự thay thế cho việc xem xét cụ thể cho dự án khi rủi ro cao — một sản phẩm giao cho khách hàng, một quảng cáo trả phí, một chiến dịch gắn thương hiệu, hoặc một bản phát hành ứng dụng.
Điểm mạnh và hạn chế cho các dự án thực tế
Điểm mạnh của VoiceForge tập trung quanh cá tính và sự đơn giản. Các giọng nhân vật nổi bật khi âm sắc là một phần của trò đùa hoặc là thương hiệu của một kênh. Vì nền tảng là giọng nói con người được ghi âm, các giọng nói giữ được những đặc điểm giọng nói tự nhiên và một bản sắc dễ nhận biết. Các điều khiển phát âm SSML cho bạn quyền quyết định thực sự với các từ viết tắt, tên gọi, và các thuật ngữ kỳ lạ. Và gói Publisher làm cho vấn đề sử dụng thương mại rõ ràng hơn so với các công cụ tách biệt quyền truy cập tạo nội dung với các chi tiết cấp phép.
Các hạn chế cũng cụ thể không kém. Giới hạn 500 ký tự buộc các kịch bản dài thành nhiều lần tạo nhỏ, và mã đánh dấu làm mỗi lần ngắn hơn. Danh mục 42 giọng nói là khiêm tốn so với các thư viện lớn, điều này quan trọng nếu bạn cần hàng trăm lựa chọn hoặc nhiều giọng địa phương. Phong cách đặt cá tính lên hàng đầu tỏa sáng trong giải trí có thể làm suy yếu nội dung pháp lý, y tế, hướng dẫn, hoặc thương hiệu cao cấp. Các hạn chế của gói rất dễ bị vấp phải, vì khả năng tạo âm thanh không giống như quyền kiếm tiền từ nó. Và vì công cụ ghép nối các đơn vị được ghi âm, một số cách diễn đạt nhất định có thể làm lộ ra các dấu vết ghép nối mà một bản ghi liên tục sẽ không có.
Không điều nào trong số này tự nó là yếu tố loại trừ. Chúng chỉ đơn giản xác định điểm phù hợp nhất: các clip ngắn, mang tính cá tính, đơn ngôn ngữ nơi giọng nói mới là điều cốt lõi.
Khi nào giọng nhân vật phù hợp và khi nào quy trình bản địa hóa thắng thế
VoiceForge là lựa chọn đúng khi cá tính của giọng nói là trung tâm, các kịch bản của bạn chia gọn gàng thành các đoạn ngắn, bạn cần kiểm soát phát âm và nhịp độ cơ bản, và bạn đang sản xuất video, meme, hoạt hình, âm nhạc, hoặc nội dung game độc lập — dù là cá nhân (Fan Voice) hay kiếm tiền với gói đăng ký phù hợp.
Một quy trình rộng hơn sẽ phục vụ bạn tốt hơn khi bạn cần một người thuyết minh trung tính trau chuốt, nhiều ngôn ngữ và giọng địa phương, giọng nói được sao chép của riêng bạn, thuyết minh dạng dài, các bản cập nhật thương mại thường xuyên, tích hợp API, hoặc các giọng nói nhất quán trên một danh mục lớn nơi sự mới lạ ít quan trọng hơn độ tin cậy. Một kênh mở rộng ra quốc tế minh họa sự phân chia này rất rõ: VoiceForge có thể cung cấp giọng nhân vật cho một tiểu phẩm bằng tiếng Anh, trong khi một thiết lập TTS và lồng tiếng đa ngôn ngữ tạo ra các phiên bản bản địa hóa cho các khán giả khác.
Kịch bản thứ hai đó là nơi chúng tôi tập trung. Công cụ Text to Speech của chúng tôi cung cấp hơn 300 giọng AI, thuyết minh đa ngôn ngữ, điều khiển tốc độ nói, và các dự án có thể tải xuống được xây dựng cho sản xuất thay vì sự mới lạ dùng một lần. Các nhà sáng tạo muốn giữ bản sắc riêng của mình trên mọi video có thể sử dụng Sao chép Giọng nói thay vì chấp nhận một nhân vật có sẵn, và các nhà phát triển cần tạo giọng nói bên trong một ứng dụng có thể xây dựng trên API Text to Speech của chúng tôi. Khi mục tiêu là biến một đoạn clip đơn lẻ thành một bản phát hành bản địa hóa đầy đủ, AI Dubbing chuyển cùng một kịch bản qua các ngôn ngữ bổ sung ở cùng một nơi.
Danh sách kiểm tra chất lượng trước khi xuất bản
Trước khi bạn phát hành âm thanh VoiceForge, hãy chạy một lượt kiểm tra nhanh những thứ hay bị lỗi nhất. Việc tạo các đoạn thử nghiệm ngắn trước là xứng đáng với vài phút thêm vào, vì một giọng nói ổn trong một câu có thể trở nên mệt mỏi hoặc gây mất tập trung xuyên suốt cả một video.
- Phát âm: Tên gọi, từ viết tắt, con số, và thuật ngữ kỹ thuật có được đọc chính xác không?
- Nhịp độ: Các khoảng dừng có rơi vào chỗ tự nhiên không, chứ không phải giữa cụm từ?
- Sự nhất quán của nhân vật: Cùng một giọng nói có phù hợp với mọi cảnh không, không chỉ phần mở đầu?
- Chuyển cảnh âm thanh: Có những bước nhảy nghe thấy được giữa các clip được tạo riêng biệt không?
- Cấp phép: Gói hiện tại của bạn có thực sự bao gồm việc sử dụng kiếm tiền hoặc thương mại không?
- Sự phù hợp với khán giả: Phong cách nhân vật có phù hợp với nền tảng và chủ đề không?
- Căn chỉnh: Âm thanh có khớp gọn gàng với video, âm nhạc, hoặc lời thoại game của bạn không?
- Quyền: Bạn có quyền sử dụng bất kỳ kịch bản, tên gọi, hoặc tham chiếu bên thứ ba nào được cung cấp trong âm thanh không?
Câu hỏi thường gặp
VoiceForge text to speech là gì?
Đó là một dịch vụ dựa trên trình duyệt chuyển đổi văn bản viết thành âm thanh nói bằng cách sử dụng một thư viện các giọng nhân vật đặc trưng. Nó dựa vào tổng hợp lựa chọn đơn vị, lắp ghép các đoạn giọng nói được ghi âm từ cơ sở dữ liệu giọng nói con người thay vì tạo âm thanh từ một dạng sóng mô hình duy nhất.
VoiceForge có phải do AI tạo ra không?
Đó là một dịch vụ tổng hợp giọng nói, nhưng phương pháp được ghi nhận của nó là lựa chọn đơn vị, không phải một hệ thống giọng nói nơ-ron sinh tạo hoàn toàn. Công cụ chọn và ghép các đơn vị giọng nói con người được ghi âm để tạo ra từng câu nói.
Có bao nhiêu giọng VoiceForge khả dụng?
VoiceForge liệt kê 42 giọng nói độc đáo, mỗi giọng gắn với một người nói và một cá tính giọng nói khác nhau.
Giới hạn ký tự của VoiceForge là bao nhiêu?
Dịch vụ ghi nhận giới hạn 500 ký tự cho mỗi đầu vào văn bản, và bất kỳ mã đánh dấu SSML nào bạn thêm vào đều được tính vào giới hạn đó. Các kịch bản dài hơn cần được chia thành nhiều lần tạo.
Tôi có thể sử dụng âm thanh VoiceForge trên YouTube không?
Bạn có thể, nhưng nội dung kiếm tiền yêu cầu gói đăng ký thương mại phù hợp. Gói Publisher được mô tả là giấy phép cho âm thanh TTS được sử dụng trong nội dung kiếm tiền hoặc thương mại, vì vậy hãy xác nhận gói của bạn trước khi xuất bản một video kiếm tiền.
VoiceForge có giống với sao chép giọng nói không?
Không. VoiceForge sử dụng thư viện giọng nói hiện có của nó, trong khi sao chép giọng nói tạo ra một giọng nói tổng hợp tùy chỉnh từ các bản ghi được cho phép của một người nói cụ thể. Chúng tôi giải thích quy trình riêng biệt đó trên trang Sao chép Giọng nói của chúng tôi.