Cách nhanh nhất để tích hợp một API chuyển văn bản thành giọng nói là xem nó như một dịch vụ REST: xác thực bằng khóa API, gửi văn bản của bạn cùng với cài đặt giọng nói dưới dạng JSON, để dịch vụ tạo giọng nói ở chế độ nền, sau đó lấy và lưu trữ các tệp âm thanh kết quả để phát ở bất cứ nơi nào người dùng của bạn cần. API Chuyển Văn Bản Thành Giọng Nói của chúng tôi tuân theo đúng mô hình này trong khi cung cấp hơn 300 giọng nói tự nhiên và khả năng nhân bản giọng nói không giới hạn, để bạn có thể đưa giọng nói sống động vào các trang web, ứng dụng, quy trình xử lý video và nền tảng học tập. Hướng dẫn này sẽ đi qua những gì bạn thực sự đang kết nối, cách công cụ của chúng tôi hoạt động, và những quyết định xác định liệu việc tích hợp có phù hợp với sản phẩm của bạn hay không.
Mục lục
API chuyển văn bản thành giọng nói làm gì trong DubSmart
API chuyển văn bản thành giọng nói biến văn bản có cấu trúc thành âm thanh nói theo yêu cầu, để mã của bạn có thể yêu cầu lời tường thuật hoặc hội thoại ngay khi kịch bản sẵn sàng thay vì phải chờ ghi âm thủ công. Công cụ Chuyển Văn Bản Thành Giọng Nói của chúng tôi cung cấp sức mạnh cho cả công cụ Chuyển Văn Bản Thành Giọng Nói trên trình duyệt và API, cho phép truy cập vào hơn 300 giọng nói AI qua nhiều ngôn ngữ, giới tính và phong cách, với ngữ điệu được tinh chỉnh cho lời tường thuật, video giải thích và hội thoại.
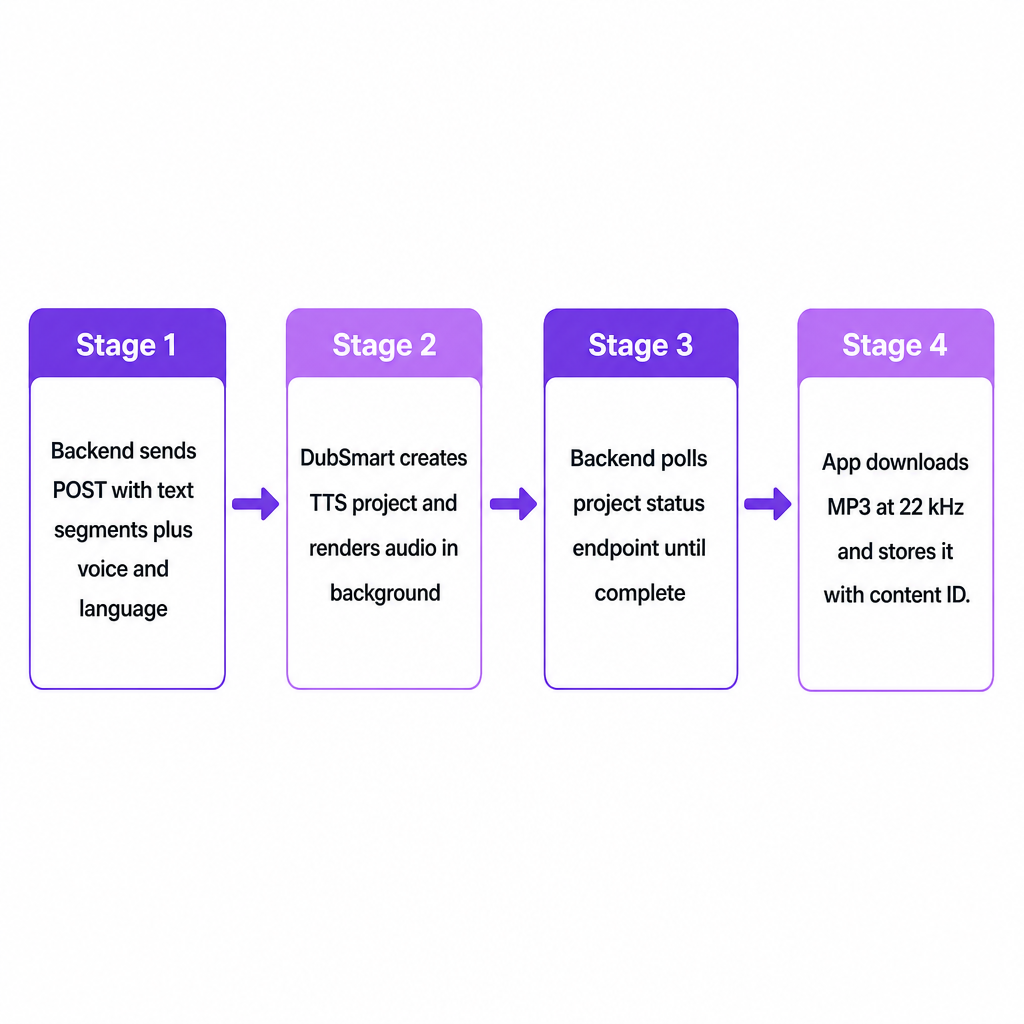
Ở lớp API, chúng tôi cung cấp công cụ này như một dịch vụ RESTful: backend của bạn gửi một yêu cầu POST chứa các đoạn văn bản và tham số giọng nói, và dịch vụ trả về một đối tượng dự án mà bạn có thể theo dõi trạng thái cho đến khi âm thanh sẵn sàng để tải xuống. Kết quả được cung cấp dưới dạng các tệp âm thanh chất lượng cao, thường là MP3 ở 22 kHz, phù hợp để sử dụng trực tiếp trong các trình chỉnh sửa video, quy trình podcast, hoặc trình phát web mà không cần chuyển đổi thêm.
Đối với những nhà sáng tạo và đội nhóm mà chúng tôi phục vụ—YouTuber, doanh nghiệp nhỏ, nhà sản xuất e-learning, nhà làm phim và các agency lập trình—API kết nối việc lập kế hoạch nội dung với việc xuất bản. Ngay khi một kịch bản được đưa vào CMS hoặc nền tảng học tập, backend có thể tạo lời thuyết minh tự động, giúp loại bỏ nút thắt của việc ghi âm thủ công lặp đi lặp lại.
Quyết định tích hợp: bạn thực sự đang kết nối những gì?
"Tích hợp một API chuyển văn bản thành giọng nói" nghe có vẻ chung chung, nhưng trên thực tế bạn đang quyết định ba điều: nơi nào trong quy trình làm việc của bạn cần tạo giọng nói, giọng nói và ngôn ngữ nào sẽ đại diện cho thương hiệu của bạn, và bạn tự động hóa việc tạo và truy xuất âm thanh chặt chẽ đến mức nào.
Đối với một nhà sáng tạo YouTube mở rộng sang nội dung đa ngôn ngữ, việc tích hợp thường có nghĩa là kết nối API của chúng tôi vào một công cụ lập kế hoạch video hoặc cơ sở dữ liệu kịch bản để mỗi kịch bản hoàn thiện trở thành một lời thuyết minh với ngôn ngữ và phong cách phù hợp. Đối với doanh nghiệp nhỏ và đội nhóm tiếp thị, API thường nằm sau một CMS hoặc nền tảng tự động hóa tiếp thị, biến các bài blog, video giải thích sản phẩm và bài viết mạng xã hội thành các tài sản âm thanh có thể tái sử dụng. Các nhà cung cấp e-learning và đào tạo doanh nghiệp thường kết nối API vào các công cụ soạn thảo để các mô-đun bài học có thể yêu cầu lời tường thuật cho từng slide hoặc từng chủ đề và tạo lại ngay lập tức khi tài liệu cập nhật.
Các lập trình viên và agency tích hợp AI giọng nói sâu hơn thường chọn giữa hai mô hình. Mô hình theo lô thu thập các kịch bản và xử lý chúng qua các công việc theo lịch trình. Mô hình giao dịch kích hoạt một yêu cầu ngay lập tức mỗi khi có nội dung mới hoặc hành động của người dùng. API dựa trên dự án của chúng tôi hoạt động gọn gàng cho cả hai, vì mỗi dự án TTS đóng gói văn bản, lựa chọn giọng nói, ngôn ngữ và âm thanh kết quả theo cách ánh xạ với các đơn vị nội dung của riêng bạn—video, bài học, hoặc tập podcast. Nếu bạn vẫn đang cân nhắc chính khái niệm này, bài giải thích đồng hành của chúng tôi về API chuyển văn bản thành giọng nói là gì và cách nó hoạt động sẽ trình bày những kiến thức cơ bản trước khi bạn cam kết với một thiết kế.
Cách API Chuyển Văn Bản Thành Giọng Nói của chúng tôi hoạt động bên trong
API Chuyển Văn Bản Thành Giọng Nói của chúng tôi được xây dựng xoay quanh các dự án và đoạn, điều này làm cho nó linh hoạt hơn một điểm cuối "văn bản vào, âm thanh ra" đơn lẻ. Một dự án TTS nhóm một hoặc nhiều đoạn văn bản dưới một tiêu đề và cấu hình chung như ngôn ngữ và giọng nói mặc định. Mỗi đoạn mang văn bản riêng, định danh giọng nói và thẻ ngôn ngữ, cho phép bạn kết hợp các phong cách tường thuật hoặc ngôn ngữ trong một kết quả đầu ra duy nhất.
Một payload JSON điển hình gửi đến điểm cuối dự án TTS bao gồm tiêu đề dự án dễ đọc cho bảng điều khiển và nhật ký của bạn, cùng với một mảng các đoạn. Mỗi đoạn thiết lập text (kịch bản hoặc câu để nói), voice (một ID giọng nói tích hợp sẵn hoặc một ID giọng nói tùy chỉnh được tạo qua API Nhân Bản Giọng Nói), và language (một mã cho biết ngôn ngữ của đoạn).
Khi backend của bạn gửi payload này đến điểm cuối TTS với một khóa API hợp lệ trong tiêu đề Authorization, chúng tôi tạo dự án và bắt đầu xử lý âm thanh ở chế độ nền. API cung cấp một điểm cuối trạng thái dự án báo cáo liệu quá trình xử lý vẫn đang diễn ra hay đã hoàn tất, cùng với các tham chiếu đến các tệp âm thanh đã tạo khi sẵn sàng. Thiết kế bất đồng bộ này giúp các yêu cầu của bạn nhanh chóng: ghi lại ID dự án, trả lại quyền điều khiển cho người dùng, và để một worker nền kiểm tra hoàn tất và tải âm thanh xuống khi có sẵn.
Giọng nói được tạo ra đến dưới dạng các tệp có thể tải xuống theo các định dạng tiêu chuẩn, đáng chú ý là MP3 ở 22 kHz, dễ dàng đưa vào trình phát web, ứng dụng di động và dòng thời gian chỉnh sửa video. Vì cùng một công cụ cung cấp sức mạnh cho công cụ trên trình duyệt của chúng tôi, các lập trình viên có thể tạo mẫu giọng nói và kịch bản một cách tương tác rồi sau đó chuyển các kết hợp thắng cuộc sang các lệnh gọi API tự động. Tài liệu tham khảo đầy đủ về điểm cuối nằm trên trang API Chuyển Văn Bản Thành Giọng Nói.
Kết nối nhân bản giọng nói và lồng tiếng AI với chuyển văn bản thành giọng nói
Đặc điểm nổi bật của chúng tôi là Chuyển Văn Bản Thành Giọng Nói, Nhân Bản Giọng Nói và Lồng Tiếng AI đều chia sẻ một công cụ giọng nói và quy trình làm việc nền tảng duy nhất. Điều đó có nghĩa là API TTS không tách biệt—nó là cốt lõi của một quy trình bản địa hóa rộng hơn.
API Nhân Bản Giọng Nói cho phép bạn tải lên các mẫu âm thanh của một người nói, tạo một giọng nói AI tùy chỉnh, và tham chiếu giọng nói đó trong các dự án TTS. Một khi giọng nói tùy chỉnh tồn tại, định danh của nó trở thành trường voice trong các đoạn Chuyển Văn Bản Thành Giọng Nói của bạn, để lời tường thuật phát bằng giọng đã nhân bản thay vì một giọng nói kho chung. Sự liền mạch đó quan trọng đối với những người dẫn chương trình, podcaster và người phát ngôn thương hiệu muốn có một bản sắc âm thanh nhất quán qua các ngôn ngữ và định dạng. Nếu bạn dự định thêm nhân bản, hướng dẫn của chúng tôi về việc tích hợp API nhân bản giọng nói vào ứng dụng của bạn sẽ trình bày các chi tiết cụ thể.
API Lồng Tiếng AI mở rộng điều này hơn nữa bằng cách kết hợp phiên âm, dịch thuật và chuyển văn bản thành giọng nói trong một quy trình duy nhất lồng tiếng cho video sang hơn 33 ngôn ngữ đích. Ở đây công cụ TTS chuyển đổi các kịch bản đã dịch thành giọng nói bằng cách sử dụng cùng thư viện hơn 300 giọng nói hoặc giọng nói đã nhân bản của bạn, để các phiên bản lồng tiếng giữ nguyên giọng điệu và thời gian. Đối với các nhà sáng tạo và doanh nghiệp đa ngôn ngữ, API Chuyển Văn Bản Thành Giọng Nói trở thành khối xây dựng cho cả lời thuyết minh đơn ngữ và nội dung lồng tiếng được bản địa hóa hoàn toàn. Tổng quan của chúng tôi về cách bản địa hóa AI hoạt động cho thấy các mảnh ghép này khớp với nhau từ đầu đến cuối như thế nào.
Các tiêu chí quyết định chính khi tích hợp API TTS của chúng tôi
Tích hợp "bất kỳ" API TTS nào là không đủ; các lựa chọn xung quanh việc triển khai quyết định nó phù hợp với quy trình sản xuất, thương hiệu và ngăn xếp kỹ thuật của bạn tốt như thế nào.
Nhu cầu về quy mô và tự động hóa. Nếu khối lượng nội dung thấp và rời rạc, công cụ trên trình duyệt có thể đủ. Một khi các kịch bản được tạo ra thường xuyên hoặc gắn với lịch nội dung, hệ thống quản lý học tập, hoặc tự động hóa tiếp thị, API trở thành lớp phù hợp vì nó có thể được kích hoạt theo chương trình và mở rộng cùng với backend của bạn.
Chiến lược giọng nói và ngôn ngữ. Nền tảng của chúng tôi hỗ trợ lồng tiếng từ hơn 60 ngôn ngữ nguồn sang 33 ngôn ngữ đích, được cung cấp bởi cùng công cụ giọng nói mà API TTS sử dụng. Nếu thương hiệu của bạn cần một giọng nói người phát ngôn đặc trưng, việc ghép API Nhân Bản Giọng Nói với TTS giữ cho giọng nói đó nhất quán qua các ngôn ngữ và kênh. Nếu bạn ưu tiên tốc độ hơn cá nhân hóa, các giọng nói tích hợp sẵn giúp việc triển khai đơn giản hơn.
Điểm tích hợp trong ngăn xếp của bạn. Đối với các kênh YouTube, một điểm tự nhiên là quy trình xử lý video: kịch bản được lưu trữ trong một công cụ lập kế hoạch, gửi đến API TTS khi hoàn thiện, và trả về dưới dạng âm thanh sẵn sàng cho người chỉnh sửa. Các nền tảng e-learning có thể tích hợp ở cấp độ bài học hoặc slide, nơi mỗi khối nội dung ánh xạ với một đoạn và các dự án đại diện cho toàn bộ khóa học. Các đội nhóm tiếp thị thường tích hợp ở cấp độ CMS để mỗi bài viết hoặc trang sản phẩm có thể yêu cầu một phiên bản âm thanh cho khả năng tiếp cận.
Quản trị, tuân thủ và rủi ro. Vì nhân bản giọng nói có thể tái tạo các giọng nói dễ nhận biết, sự đồng thuận, cấp phép và chính sách sử dụng rất quan trọng. Các giọng nói đã nhân bản được xác định bằng ID và có thể được gắn thẻ với metadata, giúp dễ dàng thực thi các quy tắc nội bộ về nơi các giọng nói cụ thể có thể được sử dụng. Quyết định trước những môi trường nào có thể kích hoạt giọng nói đã nhân bản so với giọng nói chung, và thêm ghi nhật ký trong hệ thống của riêng bạn.
Kỳ vọng về độ trễ và trải nghiệm người dùng. Xử lý bất đồng bộ mang lại sự linh hoạt nhưng thêm một yếu tố về thời gian. Đối với các quy trình mà người dùng mong đợi phát ngay lập tức—chẳng hạn như một trình chỉnh sửa kịch bản với xem trước tức thì—hãy tạo các dự án hoặc đoạn nhỏ hơn và hiển thị các chỉ báo tiến trình trong khi âm thanh đang được xử lý. Đối với bản địa hóa theo lô trên toàn bộ thư viện, độ trễ ít quan trọng hơn, và các công việc có thể chạy theo lịch trình với âm thanh đã hoàn thành được đính kèm vào bản ghi nội dung sau đó.
| Lĩnh vực quyết định | Mô hình theo lô | Mô hình giao dịch |
|---|---|---|
| Kích hoạt | Công việc theo lịch trình | Theo từng mục nội dung hoặc hành động của người dùng |
| Khả năng chịu độ trễ | Cao | Thấp |
| Phù hợp nhất | Danh mục khóa học, thư viện video | Trình chỉnh sửa kịch bản, xem trước trực tiếp |
| Chiến lược giọng nói | Giọng nói được phê duyệt cho mỗi ngôn ngữ | Giọng nói được phê duyệt cho mỗi ngôn ngữ |
Rủi ro và các biện pháp bảo vệ thực tế
Tích hợp một API chuyển văn bản thành giọng nói mang lại một vài rủi ro có thể dự đoán được mà thiết kế thấu đáo có thể giảm thiểu.
Chọn giọng nói mà không thử nghiệm có thể tạo ra giọng nói cảm thấy không phù hợp với tính cách của một thương hiệu hoặc người dẫn chương trình. Hãy thử nghiệm giọng nói trong giao diện tương tác trước, và duy trì một danh mục giọng nói đã phê duyệt bên trong hệ thống của riêng bạn, được tổ chức theo từng ngôn ngữ và loại nội dung, trước khi mã hóa các ID giọng nói trong các lệnh gọi API.
Tự động hóa quá mức đối với nội dung nhạy cảm là một cái bẫy khác. Tạo giọng nói tự động cho tài liệu tuân thủ, y tế, hoặc pháp lý có thể không phù hợp. Vì API của chúng tôi hoạt động trên các dự án và đoạn riêng biệt, bạn có thể duy trì các quy tắc định tuyến chỉ gửi các danh mục được phê duyệt vào TTS trong khi giữ nội dung nhạy cảm trong các quy trình ghi âm bởi con người.
Lỗi vận hành—các dự án thất bại hoặc thiếu tệp tải xuống—xảy ra khi các vấn đề mạng hoặc payload không hợp lệ làm gián đoạn xử lý. Các điểm cuối trạng thái dự án và các phản hồi có cấu trúc cho phép bạn xác nhận một dự án đã hoàn tất và các kết quả đầu ra của nó có sẵn trước khi xuất bản. Hãy ghép mỗi ID dự án TTS với ID nội dung của riêng bạn, và triển khai các cơ chế thử lại hoặc dự phòng khi các kiểm tra trạng thái báo cáo lỗi.
Việc lạm dụng các giọng nói đã nhân bản xứng đáng có các biện pháp kiểm soát rõ ràng. Các giọng nói tùy chỉnh phải được tạo qua các điểm cuối chuyên dụng và sau đó được tham chiếu bằng ID trong các dự án TTS, điều này cung cấp cho bạn một ranh giới kỹ thuật rõ ràng để giám sát. Hãy hạn chế ai có thể tạo hoặc gán các ID giọng nói đã nhân bản, và ghi nhật ký nơi chúng được sử dụng.
Một lộ trình khởi đầu thực tế là tích hợp TTS cho các lời thuyết minh tiêu chuẩn trước, xác thực các giọng nói và xử lý lỗi trong môi trường sản xuất, sau đó thêm Nhân Bản Giọng Nói và Lồng Tiếng AI một khi việc tích hợp cốt lõi ổn định. Hãy cho chúng tôi biết khối lượng nội dung, các ngôn ngữ đích của bạn, và nơi API nên nằm trong ngăn xếp của bạn, và chúng tôi có thể hướng dẫn bạn đến các điểm cuối phù hợp và lập kế hoạch cho quy trình của bạn.
Câu hỏi thường gặp
API Chuyển Văn Bản Thành Giọng Nói khác với công cụ trên trình duyệt như thế nào?
Công cụ trên trình duyệt là một giao diện trực quan nơi bạn dán văn bản, chọn giọng nói và tải âm thanh xuống thủ công. API cung cấp cùng công cụ đó thông qua các điểm cuối REST để backend của bạn có thể tạo và truy xuất âm thanh tự động để đáp ứng các kịch bản, lịch trình hoặc hành động của người dùng.
API có thể nói bằng giọng của riêng tôi, không chỉ các giọng nói kho không?
Có. Bằng cách tích hợp API Nhân Bản Giọng Nói, bạn tải lên các mẫu âm thanh của một người nói, tạo một giọng nói AI tùy chỉnh, và sau đó tham chiếu ID của giọng nói đó trong các đoạn Chuyển Văn Bản Thành Giọng Nói của bạn để tất cả giọng nói được tạo ra phát bằng giọng đã nhân bản.
Điều này giúp ích gì cho các kênh YouTube hoặc podcast đa ngôn ngữ?
Nền tảng của chúng tôi biến giọng nói hoặc kịch bản từ hơn 60 ngôn ngữ nguồn thành kết quả đầu ra được lồng tiếng qua 33 ngôn ngữ đích, với TTS tạo âm thanh cuối cùng bằng cách sử dụng hơn 300 giọng nói hoặc giọng nói đã nhân bản của bạn. Kết nối các API TTS và Lồng Tiếng AI vào quy trình xuất bản của bạn cho phép các video hoặc tập mới nhận lời thuyết minh hoặc lồng tiếng đầy đủ một khi các kịch bản hoặc âm thanh nguồn sẵn sàng.
Ứng dụng hoặc trình chỉnh sửa của tôi sẽ nhận được các định dạng âm thanh nào?
API TTS cung cấp các tệp âm thanh chất lượng cao, bao gồm MP3 ở 22 kHz, phù hợp với hầu hết các môi trường web, di động và chỉnh sửa video mà không cần chuyển đổi thêm.
Tôi có thể tích hợp Chuyển Văn Bản Thành Giọng Nói ngay bây giờ và thêm Lồng Tiếng AI sau không?
Có. Chuyển Văn Bản Thành Giọng Nói, Nhân Bản Giọng Nói và Lồng Tiếng AI chia sẻ một hệ sinh thái API chung, vì vậy bạn có thể bắt đầu với TTS cho lời thuyết minh và sau đó thêm Nhân Bản Giọng Nói và Lồng Tiếng AI để tự động hóa lồng tiếng đa ngôn ngữ mà không cần xây dựng lại việc tích hợp cốt lõi của bạn.