Câu trả lời trung thực cho câu hỏi cần bao nhiêu âm thanh để nhân bản một giọng nói thường ngắn hơn hầu hết mọi người nghĩ: với DubSmart AI, bạn cần ít nhất 20 giây bản thu sạch từ một người nói. Mức tối thiểu đó đủ để khởi động một bản nhân bản dùng được, nhưng nó hiếm khi phản ánh toàn bộ câu chuyện. Độ dài bạn thực sự nên thu phụ thuộc vào nơi giọng nói sẽ được dùng—một clip mạng xã hội đơn lẻ, một người dẫn chuyện định kỳ cho kênh, một thư viện khóa học đa ngôn ngữ, hay một người phát ngôn thương hiệu phải nghe giống nhau qua hàng chục video. Dưới đây, chúng tôi tách bạch mức tối thiểu bắt buộc với mục tiêu thực tế, giải thích mô hình thực sự đang "lắng nghe" điều gì, và đưa ra một quy tắc quyết định mà bạn có thể áp dụng trước khi bấm ghi.
Mục lục
Mức tối thiểu so với mục tiêu thực tế
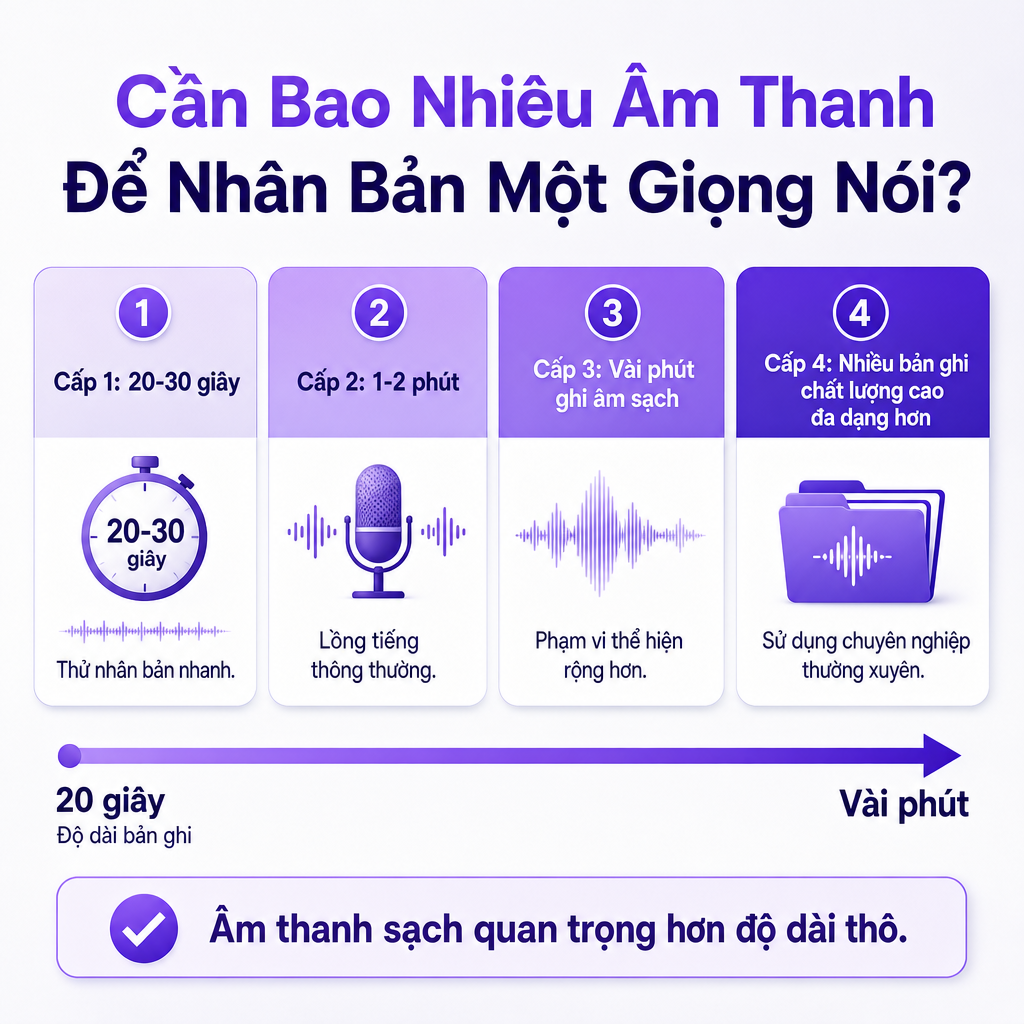
Hai mươi giây là mức sàn, không phải vạch đích. Một mẫu có độ dài tối thiểu nắm bắt được bản sắc cơ bản của người nói, điều này thường ổn cho một bài kiểm tra nhanh hoặc một clip dùng một lần. Nhưng lượng tư liệu bạn cung cấp cho mô hình trực tiếp định hình mức độ bản nhân bản xử lý tốt các kịch bản đa dạng ra sao. Mục tiêu phù hợp sẽ co giãn theo mức độ đòi hỏi và lặp lại của đầu ra.
| Mục tiêu của bạn | Mục tiêu âm thanh thực tế |
|---|---|
| Kiểm tra bản nhân bản nhanh chóng | 20–30 giây |
| Tạo lồng tiếng thường xuyên | 1–2 phút |
| Nắm bắt dải thể hiện rộng hơn | Vài phút âm thanh sạch |
| Xây dựng giọng nói cho mục đích chuyên nghiệp thường xuyên | Bản thu đa dạng, chất lượng cao hơn |
Nguyên tắc nền tảng của toàn bộ bảng này rất thẳng thắn: âm thanh sạch, nhất quán thường có giá trị hơn một bản thu dài đầy tạp âm, tiếng vọng, nhạc nền, hoặc nhiều người nói. Một clip 30 giây gọn gàng có thể vượt trội hơn một clip 10 phút lộn xộn. Nếu bạn muốn hiểu rõ hơn về cơ chế rộng hơn của việc một mẫu trở thành một giọng nói tái sử dụng được, bài giải thích của chúng tôi về cách nhân bản giọng nói tái tạo một giọng trình bày toàn bộ quy trình.
“Đủ âm thanh” thực sự có nghĩa là gì
“Đủ” thực ra không phải là một con số trên đồng hồ bấm giờ—đó là câu hỏi liệu mô hình có đủ lời nói hữu ích để tái tạo giọng nói bạn muốn hay không. Khi bạn nhân bản một giọng nói, AI phân tích bản thu để xác định một tập hợp các đặc điểm rồi dùng chúng để tạo ra lời nói mới từ văn bản hoặc hội thoại đã dịch.
Những đặc điểm đó bao gồm:
- Âm sắc và chất giọng
- Cao độ và nhịp điệu nói
- Cách phát âm và giọng vùng miền
- Khoảng ngừng và nhịp điệu
- Năng lượng, sự nhấn mạnh và cách thể hiện cảm xúc
Một mẫu ngắn cố định bản sắc cốt lõi của người nói. Một mẫu dài hơn, đa dạng hơn bổ sung thông tin về cách người đó nghe ra sao khi giải thích, đặt câu hỏi, nhấn mạnh, ngừng nghỉ, hay chuyển đổi sắc thái cảm xúc. Vậy nên mục tiêu thực sự là âm thanh có tính đại diện: tư liệu cho mô hình thấy giọng nói đang làm những việc mà về sau nó sẽ được yêu cầu làm.
Khi nào nên thu nhiều hơn 20 giây
Hãy vượt quá mức tối thiểu bất cứ khi nào giọng nói nhân bản sẽ xuất hiện lặp đi lặp lại, đại diện cho một thương hiệu, hoặc chứa nội dung dạng dài. Với những trường hợp đó, điểm khởi đầu thực tế là một đến hai phút lời nói sạch, bổ sung thêm nếu bạn cần giọng nói tái hiện dải phong cách thể hiện rộng hơn.
Mẫu dài hơn mang lại hiệu quả cho công việc nhiều lời dẫn: video YouTube, podcast, khóa học trực tuyến, đào tạo doanh nghiệp, nội dung kiểu sách nói, video giới thiệu sản phẩm, lồng tiếng đa ngôn ngữ, hội thoại nhân vật, và các chiến dịch tiếp thị lặp lại. Một nhà sáng tạo chỉ thu một đoạn giới thiệu bình tĩnh thường nhận được bản nhân bản thể hiện tốt nhất ở đúng cái giọng điệu bình tĩnh đó. Một nhà sáng tạo thu các đoạn giải thích, câu hỏi, sự nhấn mạnh, và khoảng ngừng tự nhiên sẽ cung cấp cho mô hình nhiều ví dụ hơn hẳn về giọng nói đang hoạt động. Mục tiêu không bao giờ là đổ vào số phút tối đa—mà là cung cấp âm thanh đại diện cho cách giọng nói thực sự vận hành.
Vì sao âm thanh sạch thắng âm thanh dài
Nhiều âm thanh hơn chỉ hữu ích khi tư liệu bổ sung có chất lượng cao và liên quan. Một bản thu 10 phút với tiếng vọng trong phòng, tiếng gõ bàn phím, nhạc nền, micro thay đổi, hoặc nhiều người nói có thể kém hữu ích hơn một clip ngắn, sạch. Tạp âm to hơn vẫn là tạp âm, nên việc tăng âm lượng không bao giờ cứu được một mẫu kém.
Âm thanh bổ sung chỉ xứng đáng khi nó:
- Được nói rõ ràng bởi một người
- Nhất quán về âm lượng và khoảng cách micro
- Không có nhạc, hiệu ứng âm thanh, và giọng nói chồng lấn
- Được thu trong môi trường yên tĩnh, ít tiếng vọng
- Được truyền tải với tốc độ tự nhiên
- Đại diện cho phong cách bạn muốn tạo ra
Một vài thói quen thu âm bảo vệ chất lượng hơn bất kỳ mục tiêu độ dài nào. Giữ một người nói duy nhất trong clip; các giọng khác làm rối phân tích. Ưu tiên một phòng nhỏ có đồ đạc hơn một phòng lớn trống trải để giảm phản âm, và duy trì khoảng cách micro ổn định suốt quá trình. Đừng thu một đoạn ở sát và một đoạn khác từ phía bên kia phòng, và bỏ qua việc chèn vào tệp những khoảng im lặng dài hay âm thanh không liên quan. Nếu nguồn duy nhất của bạn là một video nhiều tạp âm, hãy làm sạch nó trước thay vì hy vọng độ dài sẽ bù đắp—hướng dẫn của chúng tôi về loại bỏ nhạc nền khỏi âm thanh trình bày cách làm sạch đó.
Mẫu của bạn thực sự nên nói gì
Nội dung quan trọng không kém điều kiện. Bản thu nên chứa lời nói rõ ràng, tự nhiên thay vì các âm thanh rời rạc hay những cụm bị cắt vụn nhiều. Một mẫu tốt kết hợp câu ngắn và câu dài, một dải các âm nguyên âm và phụ âm, số và ngày tháng, tên và thuật ngữ thông dụng, câu hỏi, câu khẳng định dứt khoát, và khoảng ngừng tự nhiên—lý tưởng nhất là cùng loại ngôn ngữ mà nội dung cuối cùng sẽ dùng.
Điều đó trông như thế nào trong thực tế thì khác nhau tùy nhà sáng tạo. Một YouTuber có thể thu một đoạn giới thiệu ngắn, một đoạn giải thích, một lời kêu gọi hành động, và vài câu ở các mức nhấn mạnh khác nhau. Một nhà sản xuất e-learning có thể bao gồm cách diễn đạt hướng dẫn, định nghĩa, danh sách, và chuyển tiếp. Một người phát ngôn doanh nghiệp hưởng lợi từ việc lồng vào thuật ngữ thương hiệu và phong cách trò chuyện dùng trong nội dung hướng tới khách hàng. Việc quyết định liệu bạn có thực sự cần một bản nhân bản ở đây là một câu hỏi hợp lý; phần phân tích của chúng tôi về giọng nhân bản so với giọng TTS có sẵn giúp ích khi một giọng thư viện có thể hoàn thành công việc nhanh hơn.
Nhân bản đa ngôn ngữ và âm thanh nguồn có tạp âm
Với các dự án đa ngôn ngữ, yêu cầu khởi đầu vẫn là chất lượng của mẫu giọng gốc. Việc dịch lời nói đã tạo sang các ngôn ngữ khác không loại bỏ nhu cầu về một bản thu nguồn rõ ràng—một clip tiếng Anh đục ngầu tạo ra một bản nhân bản đục ngầu trong mọi ngôn ngữ đích.
Khi bạn dự định bản địa hóa, hãy chú ý đến độ rõ của giọng gốc, cách phát âm tên và thuật ngữ thương hiệu, giọng điệu mong muốn trong mỗi ngôn ngữ, liệu phong cách của người nói nên giữ trang trọng, thân thiện, sôi nổi, hay đàm thoại, và liệu các kịch bản đã dịch có được rà soát trước khi lồng tiếng hay không. Trong một dự án bản địa hóa lớn hơn, hãy thử một đoạn ngắn trong mỗi ngôn ngữ đích trước khi xử lý toàn bộ video; điều đó phát hiện sớm các vấn đề về phát âm, nhịp độ, và thích ứng văn hóa. Quy trình AI Dubbing của DubSmart có thể dùng một giọng nhân bản cho nội dung đã dịch, và các giọng nhân bản có thể được dùng trong cả Text to Speech lẫn AI Dubbing.
Chất lượng nguồn là nửa còn lại của vấn đề này. Bạn thường có thể trích xuất lời nói từ một video, nhưng nhạc nền, hiệu ứng âm thanh, âm thanh môi trường phòng, gió, tiếng khán giả, lời nói chồng lấn, và các tạp vật do nén đều khiến một clip trở thành điểm khởi đầu kém. Nếu nguồn có giá trị nhưng nhiều tạp âm, hãy tách lời nói ra trước. Công cụ Speech Separator của chúng tôi kéo một bản giọng nói ra khỏi các thành phần âm thanh khác, và bản đó càng sạch thì bản nhân bản càng đáng tin cậy.
Sự đồng ý và quyền nhân bản giọng nói
Bạn chỉ có thể nhân bản giọng nói của người khác khi bạn có sự cho phép và quyền hợp lệ. Nhân bản giọng nói mang theo những rủi ro pháp lý, đạo đức, quyền riêng tư, và mạo danh thực sự, nên trước khi tải lên bản thu của người khác, hãy có được sự đồng ý trên cơ sở hiểu biết của họ và xác nhận giọng nói có thể được sử dụng, phân phối, và lưu giữ như thế nào. Quy tắc của Voice Cloning Challenge thuộc Ủy ban Thương mại Liên bang Hoa Kỳ yêu cầu người tham gia chỉ nhân bản giọng nói khi có sự đồng ý của người có giọng nói được nhân bản.
Đối với công việc thương mại, hãy ghi chép lại ai sở hữu hoặc kiểm soát giọng nói, những bản thu nào có thể dùng, những loại nội dung và ngôn ngữ nào được phép, liệu có được dùng cho mục đích thương mại hay không, sự cho phép kéo dài bao lâu, liệu người đó có thể rút lại hay không, và nội dung tổng hợp sẽ được tiết lộ ra sao khi thích hợp. Đừng nhân bản một nhân vật của công chúng, nhân viên, khách hàng, diễn viên, hay người thân chỉ vì bạn có thể tiếp cận một bản thu của họ. Tiếp cận không phải là sự cho phép.
Nên thu bao nhiêu theo từng loại nhà sáng tạo
Mức tối thiểu giống nhau áp dụng cho tất cả mọi người, nhưng mục tiêu thực tế thay đổi theo rủi ro sản xuất. Dùng mức tối thiểu khi tốc độ quan trọng—thử nghiệm sáng tạo giai đoạn đầu, clip dạng ngắn, bản mẫu nội bộ, thông báo đơn giản—và thu nhiều hơn bất cứ khi nào giọng nói phải giữ nhất quán qua nhiều video hoặc ngôn ngữ.
| Nhà sáng tạo | Mẫu được khuyến nghị |
|---|---|
| Nhà sáng tạo YouTube | 20 giây để thử; 1–2 phút sạch, giàu biểu cảm cho người dẫn chuyện định kỳ |
| Doanh nghiệp nhỏ / tiếp thị | Clip người phát ngôn nhất quán với thuật ngữ và năng lượng chiến dịch; thử một đoạn lồng tiếng ngắn trước |
| E-learning / đào tạo | Mẫu dài hơn, đa dạng bao gồm định nghĩa, hướng dẫn, câu hỏi, chuyển tiếp |
| Người làm podcast | Mẫu phản ánh nhịp độ bình thường của người dẫn; kiểm tra cách phát âm tên và nhà tài trợ |
| Nhà làm phim | Mẫu khớp với định hướng nhân vật, bao gồm thì thầm, cường độ, hoặc các phẩm chất kịch tính khác |
| Nhà phát triển / agency | Một tiêu chuẩn âm thanh có thể lặp lại được áp dụng trước khi nhận mẫu của khách hàng |
Hai lưu ý thực tế nằm sau bảng đó. Một mẫu trung tính sẽ không tái hiện một màn thể hiện phụ thuộc vào thì thầm, sự mỉa mai, hoặc nỗi sợ, nên nhà làm phim nên nắm bắt nhân vật, không chỉ giọng nói. Và với các quy trình vận hành bằng API, một tiêu chuẩn tiếp nhận cố định ngăn ngừa kết quả không nhất quán giữa các khách hàng; Voice Cloning API của chúng tôi tạo giọng nói tùy chỉnh từ các mẫu âm thanh và cung cấp chúng cho Text to Speech và AI Dubbing.
Một bài kiểm tra ngắn trước khi tải lên giúp kết quả dự đoán được. Hãy xác nhận mẫu chạy ít nhất 20 giây, có một người nói, không có nhạc hoặc giọng nói chồng lấn, có tiếng vọng và tạp âm nền tối thiểu, giữ vị trí và mức micro ổn định, chứa lời nói tự nhiên thay vì khoảng im lặng dài, khớp với phong cách dự định, và đến từ một người nói đã đồng ý với mục đích sử dụng dự định.
Dùng 20 giây để thử nghiệm ý tưởng, một đến hai phút cho lời dẫn hằng ngày đáng tin cậy, và nhiều âm thanh sạch đa dạng hơn khi giọng nói phải thể hiện nhất quán qua nội dung dạng dài hoặc đa ngôn ngữ.
Mức tối thiểu giúp bạn bắt đầu. Chất lượng bản thu, sự nhất quán của người nói, dải biểu cảm, và sự cho phép quyết định liệu kết quả có sẵn sàng để công bố hay không.
Câu hỏi thường gặp
Bạn cần bao nhiêu âm thanh để nhân bản một giọng nói?
Với DubSmart bạn cần ít nhất 20 giây âm thanh. Để bao phủ tốt hơn cách thể hiện của người nói, hãy nhắm tới một đến hai phút lời nói sạch, tự nhiên.
10 giây có đủ để nhân bản một giọng nói không?
Nó có thể đủ cho một số hệ thống, nhưng nằm dưới mức tối thiểu đã nêu của DubSmart. Hãy tải lên ít nhất 20 giây cho một bản nhân bản DubSmart.
Một phút có đủ để nhân bản giọng nói không?
Thường là có, cho lời dẫn hằng ngày, miễn là nó sạch, nhất quán, và được nói tự nhiên. Một mẫu lớn hơn, đa dạng hơn giúp ích cho mục đích giàu biểu cảm hoặc chuyên nghiệp.
Bản thu dài hơn có làm cho bản nhân bản chính xác hơn không?
Không tự động. Độ dài thêm chỉ giúp ích khi nó bổ sung các ví dụ sạch, liên quan về giọng nói. Tạp âm, tiếng vọng, nhạc, và nhiều người nói làm giảm giá trị của âm thanh thêm vào.
Tôi có cần sự cho phép để nhân bản một giọng nói không?
Có. Hãy có được sự đồng ý và xác nhận các quyền áp dụng trước khi nhân bản giọng nói của người khác, bao gồm mục đích sử dụng, phân phối, và hoạt động thương mại. Quy tắc của thử thách nhân bản giọng nói của FTC cũng yêu cầu sự đồng ý từ người có giọng nói được nhân bản.
Tôi có thể dùng một bản nhân bản giọng nói cho AI dubbing không?
Có. Các giọng nói đã tạo có thể được dùng trong cả Text to Speech lẫn AI Dubbing.