Hãy chọn giọng TTS có sẵn khi bạn cần thuyết minh nhanh, linh hoạt và không cần ai nhận ra người nói. Hãy chọn giọng nhân bản khi âm thanh của một người cụ thể mang lại sự tin tưởng, tính liên tục hoặc nhận diện thương hiệu. Sự đánh đổi duy nhất giữa tốc độ và danh tính nằm ở trung tâm của quyết định giọng nhân bản so với giọng TTS có sẵn, và hầu hết nhà sáng tạo nghĩ quá nhiều về nó vì họ coi hai lựa chọn này là đối thủ thay vì công cụ cho những công việc khác nhau.
Tại DubSmart AI, chúng tôi tích hợp cả hai vào một quy trình làm việc, vì vậy hướng dẫn này tập trung vào chính quyết định đó: mỗi tùy chọn thực sự là gì, nó hoạt động như thế nào, và các tiêu chí cụ thể cho bạn biết lựa chọn nào phù hợp với một dự án nhất định. Đến cuối bài, bạn sẽ có thể nhìn vào bất kỳ kịch bản nào và biết trong vài giây rằng bạn cần giọng có sẵn hay giọng tùy chỉnh.
Mục lục
Điều gì phân biệt giọng nhân bản với giọng TTS có sẵn
Sự khác biệt quy về một điều: danh tính giọng nói.
Giọng TTS có sẵn là một giọng tổng hợp làm sẵn mà bạn chọn từ thư viện. Bạn dán kịch bản, chọn giọng và ngôn ngữ, rồi tạo âm thanh. Nó được thiết kế để tái sử dụng cho nhiều dự án và nhiều đối tượng, và đó chính là lý do nó cảm thấy trung tính chứ không mang tính cá nhân.
Giọng nhân bản là phiên bản tổng hợp của một người nói cụ thể. Hệ thống phân tích bản ghi âm của người đó và tái tạo tông giọng, cách phát âm, nhịp điệu và đặc điểm giọng của họ trong lời nói mới. Đầu ra gắn với một cá nhân được ủy quyền chứ không phải thiết lập mặc định của nền tảng.
Sự phân biệt đó chi phối mọi quyết định về thiết lập, tính linh hoạt, tính liên tục và quản trị sau này.
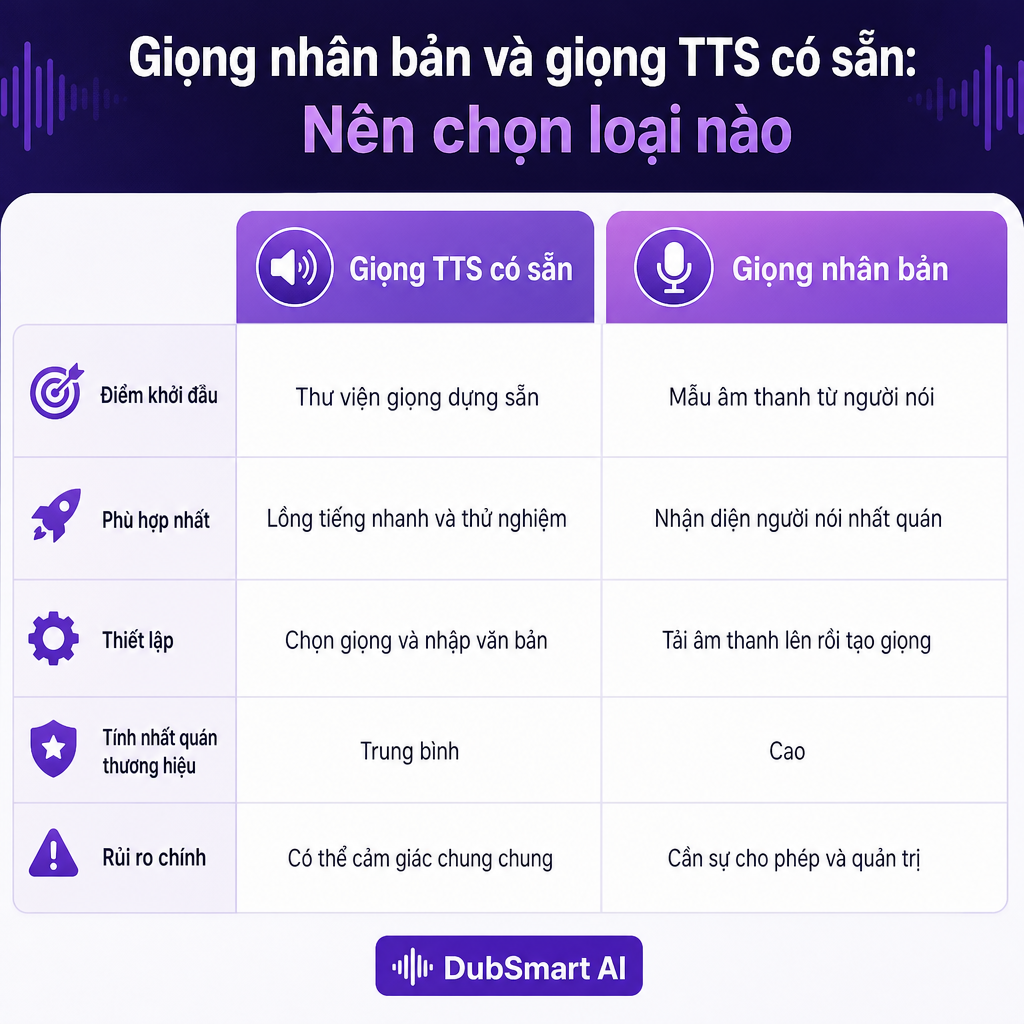
| Yếu tố | Giọng TTS có sẵn | Giọng nhân bản |
|---|---|---|
| Điểm khởi đầu | Thư viện giọng làm sẵn | Mẫu âm thanh từ người nói |
| Phù hợp nhất cho | Thuyết minh nhanh và thử nghiệm | Danh tính người nói nhất quán |
| Thiết lập | Chọn giọng, nhập văn bản | Tải lên âm thanh, rồi tạo giọng |
| Tính liên tục thương hiệu | Vừa phải | Cao |
| Rủi ro chính | Có thể cảm thấy chung chung | Cần sự cho phép và quản trị |
Nếu bạn muốn phân tích sâu hơn về cách các công cụ nền tảng khác nhau, bài giải thích của chúng tôi về nhân bản giọng nói so với chuyển văn bản thành giọng nói so sánh chi tiết về danh tính, thiết lập, quy mô và quản trị.
Mỗi tùy chọn thực sự hoạt động như thế nào
Hiểu cơ chế làm cho quyết định trở nên rõ ràng, vì mỗi hướng đi dồn công sức vào một chỗ khác nhau.
TTS có sẵn chuyển văn bản thành giọng nói với một giọng đã tồn tại. Bạn viết hoặc dán kịch bản, chọn giọng và ngôn ngữ, điều chỉnh cách thể hiện nếu cần, và xuất ra. Không có tập dữ liệu nào cần duy trì và không cần gọi lại người nói cho một thay đổi nhỏ trong kịch bản. Công cụ Text to Speech của chúng tôi cung cấp hơn 300 giọng giống người thật cùng các điều khiển như tốc độ nói, gợi ý cảm xúc và định dạng nhấn mạnh, để bạn có thể thử nghiệm nhiều hướng khác nhau trong vài phút.
Nhân bản giọng nói thì dồn công sức lên trước. Nó bắt đầu với bản ghi âm của người nói; hệ thống phân tích đặc điểm giọng của họ và tạo ra một giọng tùy chỉnh có thể tái sử dụng mà sau đó bạn có thể điều khiển bằng văn bản mới. Trên DubSmart, bạn có thể tải lên một tệp âm thanh dài ít nhất 20 giây để tạo bản nhân bản, và một bản ghi âm sạch không có tiếng ồn nền sẽ cho kết quả tốt hơn. Phong cách nói trong mẫu cũng quan trọng: một đoạn đều đều có xu hướng tạo ra lời nói nhạt nhẽo hơn, trong khi một mẫu mang cảm xúc bạn muốn sẽ giúp tái tạo phong cách đó. Công cụ Nhân bản giọng nói của chúng tôi khiến giọng tùy chỉnh đó khả dụng sau đó cho cả Text to Speech và Lồng tiếng AI.
Hệ quả thực tế là về thời gian. TTS có sẵn cho bạn âm thanh ngay hôm nay mà không cần thiết lập. Nhân bản đòi hỏi một bản ghi âm, sự cho phép và kiểm tra chất lượng trước, rồi hoàn trả công sức đó qua mọi lần tạo trong tương lai.
Sáu tiêu chí quyết định
Hãy đưa một dự án qua sáu câu hỏi này và câu trả lời thường tự hiện ra.
1. Bản thân giọng nói có mang ý nghĩa không? Nếu người xem quan tâm ai đang nói, nhân bản thắng. Một nhà giáo dục YouTube, người dẫn podcast, hoặc nhà sáng lập đã xây dựng niềm tin qua giọng nói của mình sẽ mất đi điều gì đó khi một người thuyết minh chung chung thay thế họ. Nếu giọng nói chỉ truyền tải thông tin, chẳng hạn như hướng dẫn phần mềm hoặc thông báo nội bộ, thì TTS có sẵn là đủ.
2. Bạn sẽ sản xuất bao nhiêu nội dung? Đối với một quảng cáo 30 giây duy nhất, lấy một giọng có sẵn nhanh hơn chuẩn bị một bản nhân bản. Đối với hàng trăm video, bài học hoặc tập, một giọng nhân bản loại bỏ công việc ghi âm lặp đi lặp lại và giữ tính liên tục trên toàn bộ thư viện.
3. Bạn có cần bản địa hóa đa ngôn ngữ không? Cả hai đều xử lý nhiều ngôn ngữ, nhưng chúng giải quyết các vấn đề khác nhau. Với TTS có sẵn, bạn chọn một giọng phù hợp cho mỗi ngôn ngữ đích, điều này hữu ích khi phong cách vùng miền quan trọng hơn người nói gốc. Với nhân bản, mục tiêu là bảo tồn người nói gốc qua các ngôn ngữ. Công cụ nhân bản giọng nói của chúng tôi hỗ trợ 33 ngôn ngữ, và dịch vụ Lồng tiếng AI của chúng tôi lồng tiếng nội dung từ hơn 60 ngôn ngữ nguồn sang 33 ngôn ngữ đích.
4. Bạn cần kiểm soát cảm xúc đến mức nào? Một bản nhân bản không tự tạo ra cảm xúc mà nó chưa từng nghe. Nếu đoạn gốc nhạt nhẽo, đầu ra có xu hướng nhạt nhẽo, đó là lý do chúng tôi khuyên bạn nên ghi âm cảm xúc và phong cách nói mà bạn muốn tái tạo. Giọng có sẵn dễ thử nghiệm qua nhiều tông giọng hơn khi hôm nay bạn cần một giọng giải thích điềm tĩnh và ngày mai cần một quảng cáo đầy năng lượng. Dù bạn nghiêng về cái nào, hãy thử cả hai với cùng một kịch bản và lắng nghe cách phát âm tên và thuật ngữ kỹ thuật, nhịp điệu câu, độ tin cậy cảm xúc, sự nhấn mạnh, và tính nhất quán qua các đoạn dài.
5. Bạn cần bản nháp đầu tiên nhanh đến mức nào? TTS có sẵn có con đường ngắn nhất từ kịch bản đến âm thanh vì giọng đã sẵn sàng. Nhân bản thêm một bước chuẩn bị, rồi trở nên hiệu quả cho sản xuất lặp lại. Đối với một hạn chót một lần, hãy bắt đầu với TTS có sẵn; đối với một hệ thống nội dung liên tục, hãy đầu tư vào một bản nhân bản khi danh tính có giá trị lâu dài.
6. Ai kiểm soát danh tính của người nói? Nhân bản đòi hỏi quản trị. Chỉ nhân bản một giọng khi bạn có sự cho phép của người nói và quyền sử dụng bản ghi âm cùng đầu ra cho mục đích dự định. Hãy lưu giữ tài liệu ghi rõ giọng của ai đã được ghi âm, họ đã cho phép gì, giọng đó có thể được dùng ở đâu, có được phép sử dụng thương mại và quảng cáo không, và cách vô hiệu hóa giọng đó nếu sự ủy quyền kết thúc. Điều này quan trọng nhất đối với các agency và nhà phát triển sản xuất nội dung cho khách hàng, và một giọng nghe giống người thật có thể gây hiểu lầm cho khán giả nếu thuyết minh tổng hợp không bao giờ được tiết lộ.
Những nhà sáng tạo khác nhau nên chọn gì
Cùng một sự đánh đổi lại khác nhau tùy vào những gì bạn tạo ra.
Nhà sáng tạo YouTube: Hãy nhân bản giọng của bạn nếu kênh được xây dựng xung quanh cá tính của bạn, để các đoạn mở đầu, chỉnh sửa, short, và phiên bản đa ngôn ngữ vẫn giữ được sự nhận diện. Hãy dùng TTS có sẵn cho các kênh không lộ mặt, thử nghiệm ngách, hoặc các định dạng cần giọng nhân vật riêng biệt.
Doanh nghiệp nhỏ và đội ngũ marketing: Bắt đầu với TTS có sẵn cho video sản phẩm, quảng cáo mạng xã hội, hỗ trợ bán hàng, và bản nháp nội bộ, vì nó nhanh và dễ thử nghiệm A/B về tông giọng và nhịp độ. Chuyển sang giọng nhân bản của nhà sáng lập hoặc giọng thương hiệu khi cùng một người thuyết minh xuất hiện qua các chiến dịch và giáo dục khách hàng.
Đội ngũ học trực tuyến và đào tạo doanh nghiệp: Dùng TTS có sẵn cho nội dung dạng mô-đun thay đổi thường xuyên hoặc cần nhiều giọng giảng dạy. Dùng giọng nhân bản khi học viên mong đợi tính liên tục từ một giảng viên trên một thư viện lớn, để các mô-đun riêng lẻ có cảm giác như một khóa học duy nhất.
Nhà làm phim và nhà sáng tạo podcast: Nhân bản khi việc bảo tồn danh tính của người dẫn hoặc nhân vật là thiết yếu; quy trình Lồng tiếng AI của chúng tôi được thiết kế để nhân bản giọng của từng người nói cho bản địa hóa đa ngôn ngữ. Dùng TTS có sẵn cho bản nháp âm thanh, bản xem trước, vai phụ, hoặc các bản chỉnh sửa ban đầu trước khi chọn vai cuối cùng.
Nhà phát triển và agency: Chọn một API Text to Speech có sẵn khi ứng dụng của bạn cần một tuyển chọn giọng và tạo mẫu nhanh mà không cần đưa người nói vào. Chọn API Nhân bản giọng nói khi sản phẩm của bạn cần các giọng tùy chỉnh được ủy quyền tạo ra từ các mẫu âm thanh.
Khi nào dùng cả hai là lựa chọn thông minh hơn
TTS có sẵn và nhân bản giọng nói không loại trừ lẫn nhau, và các hệ thống sản xuất mạnh nhất kết hợp chúng một cách có chủ đích.
Một thiết lập thực tế có thể ghép một giọng người dẫn nhân bản cho thuyết minh YouTube chính với các giọng có sẵn cho nhân vật phụ. Một khóa học có thể chạy một giọng giảng viên nhân bản cho các bài học cốt lõi và các giọng có sẵn cho hội thoại nhập vai. Một đội ngũ có thể soạn các kịch bản ban đầu bằng TTS có sẵn, rồi tạo phiên bản cuối cùng đã được phê duyệt bằng một bản nhân bản. Đối với bản địa hóa, các giọng nhân bản bảo tồn người thuyết minh qua các ngôn ngữ trong khi các giọng vùng miền có sẵn vào cuộc khi một người thuyết minh địa phương phù hợp hơn.
Cách kết hợp này giữ được sự linh hoạt sáng tạo nơi tốc độ quan trọng và bảo vệ danh tính nơi sự nhận diện quan trọng, mà không ép buộc một sự thỏa hiệp duy nhất cho toàn bộ dự án.
Một quy tắc giải quyết hầu hết các lựa chọn
Khi các tiêu chí cảm thấy cân bằng, quy tắc này phá vỡ thế hòa:
Nếu người nói là một phần của sản phẩm, hãy chọn giọng nhân bản. Nếu lời nói chính là sản phẩm, hãy chọn giọng TTS có sẵn.
Người nói là một phần của sản phẩm khi danh tính của họ xây dựng niềm tin, sự nhận diện hoặc tính liên tục: nhà sáng tạo, giảng viên, nhà sáng lập, người dẫn, và nhân vật hư cấu. Lời nói chính là sản phẩm khi ưu tiên là thuyết minh rõ ràng, giá cả phải chăng, dễ chỉnh sửa nhanh: các video giải thích, cập nhật sản phẩm, đào tạo nội bộ, bản mẫu, và các biến thể số lượng lớn.
Hầu hết các dự án đầu tiên khởi đầu tốt hơn với TTS có sẵn vì nó tức thì và dễ thay đổi. Hãy nâng cấp lên giọng nhân bản khi âm thanh của người thuyết minh trở thành một tài sản thực sự trong thương hiệu, kênh, khóa học, hoặc nội dung bản địa hóa của bạn. Đối với các đội ngũ cần cả tốc độ và tính liên tục, thư viện có sẵn của chúng tôi xử lý thuyết minh linh hoạt trong khi các công cụ nhân bản giọng nói và lồng tiếng của chúng tôi xử lý tính nhất quán đa ngôn ngữ đã được ủy quyền.
Câu hỏi thường gặp
Giọng nhân bản có tốt hơn giọng TTS có sẵn không?
Không phải lúc nào cũng vậy. Giọng nhân bản thắng về danh tính và tính nhất quán; giọng TTS có sẵn thắng về tốc độ, sự đa dạng và sản xuất ít cam kết. Lựa chọn đúng phụ thuộc vào việc danh tính của người nói có quan trọng đối với dự án đó hay không.
Cần bao nhiêu âm thanh để nhân bản một giọng với DubSmart?
Mẫu tối thiểu là 20 giây. Để có chất lượng tốt hơn, chúng tôi khuyên dùng một bản ghi âm sạch không có tiếng ồn nền, và một mẫu mang cảm xúc và phong cách mà bạn muốn tái tạo.
Giọng nhân bản có thể nói ngôn ngữ khác không?
Có. Công cụ nhân bản giọng nói của chúng tôi hỗ trợ 33 ngôn ngữ, và dịch vụ Lồng tiếng AI của chúng tôi lồng tiếng nội dung từ hơn 60 ngôn ngữ nguồn sang 33 ngôn ngữ đích trong khi bảo tồn danh tính của người nói gốc.
Tôi có thể dùng giọng nhân bản cho lồng tiếng AI không?
Có. Một giọng nhân bản có thể được dùng trong cả Text to Speech và Lồng tiếng AI, và công cụ lồng tiếng của chúng tôi cũng có thể tự động nhân bản giọng của từng người nói trong quá trình bản địa hóa đa ngôn ngữ.
Cách an toàn nhất để sử dụng nhân bản giọng nói là gì?
Chỉ nhân bản một người nói được ủy quyền, lập tài liệu về việc sử dụng được cho phép, bảo vệ âm thanh nguồn, xem xét mọi đầu ra được tạo ra, và tiết lộ thuyết minh tổng hợp ở bất cứ nơi nào nền tảng, khách hàng, hoặc các quy tắc áp dụng của bạn yêu cầu.