Hỏi cách tạo ra lồng tiếng AI thực chất là hỏi làm thế nào một kịch bản viết trở thành lời nói mà không cần ai bước vào phòng thu. Câu trả lời ngắn gọn: một mô hình chuyển văn bản thành giọng nói (text-to-speech) dạng nơ-ron chuyển đổi kịch bản của bạn thành âm thanh tổng hợp, một giọng nói được nhân bản tùy chọn làm cho âm thanh đó nghe giống một người cụ thể, và một lớp lồng tiếng căn chỉnh mọi thứ khớp với video của bạn qua các ngôn ngữ. Tại DubSmart AI, chúng tôi chạy toàn bộ chuỗi này trong một không gian làm việc, để bạn có thể đi từ một đoạn văn bản đến một bản lồng tiếng đa ngôn ngữ hoàn chỉnh mà không cần chuyển đổi công cụ hay đặt lịch phòng thu.
Quá trình đó trông ra sao đối với bạn phụ thuộc vào một quyết định, và phần còn lại của hướng dẫn này sẽ đi qua các cơ chế, các lựa chọn, và cách để chọn.
Mục lục
Quyết định đằng sau cách tạo ra lồng tiếng AI
Trước khi bất kỳ âm thanh nào được tạo ra, bạn thực hiện hai lựa chọn định hình mọi thứ ở phía sau. Lựa chọn thứ nhất là bạn muốn một giọng nói dựng sẵn từ thư viện hay một bản nhân bản giọng của chính mình. Lựa chọn thứ hai là bạn cần lồng tiếng bằng một ngôn ngữ duy nhất hay một phiên bản được bản địa hóa hoàn toàn qua nhiều ngôn ngữ.
Đối với một nhà sáng tạo YouTube hoặc một doanh nghiệp nhỏ, điều đó thường được giải quyết nhanh chóng: chọn một giọng nói có sẵn để nhanh gọn, nhân bản giọng khi tính nhất quán thương hiệu quan trọng, và chỉ dùng đến lồng tiếng khi bạn chuyển sang đa ngôn ngữ. Đối với các nhà phát triển và agency, cùng ngã rẽ đó trở thành một câu hỏi về kiến trúc — bạn gọi một điểm cuối chuyển văn bản thành giọng nói cho âm thanh riêng lẻ, hay kết nối nhân bản giọng và lồng tiếng lại với nhau thành một quy trình tự vận hành?
Chúng tôi xây dựng DubSmart xoay quanh chính những ngã rẽ này. Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image, Image to Video, và AI Dubbing đều nằm trong một nền tảng, để bạn có thể tăng hoặc giảm mức độ tự động hóa và cá nhân hóa mà không cần ghép nối các nhà cung cấp riêng lẻ lại với nhau.
Các cơ chế: lồng tiếng AI thực sự được tạo ra như thế nào
Chuyển văn bản thành giọng nói: biến kịch bản thành âm thanh
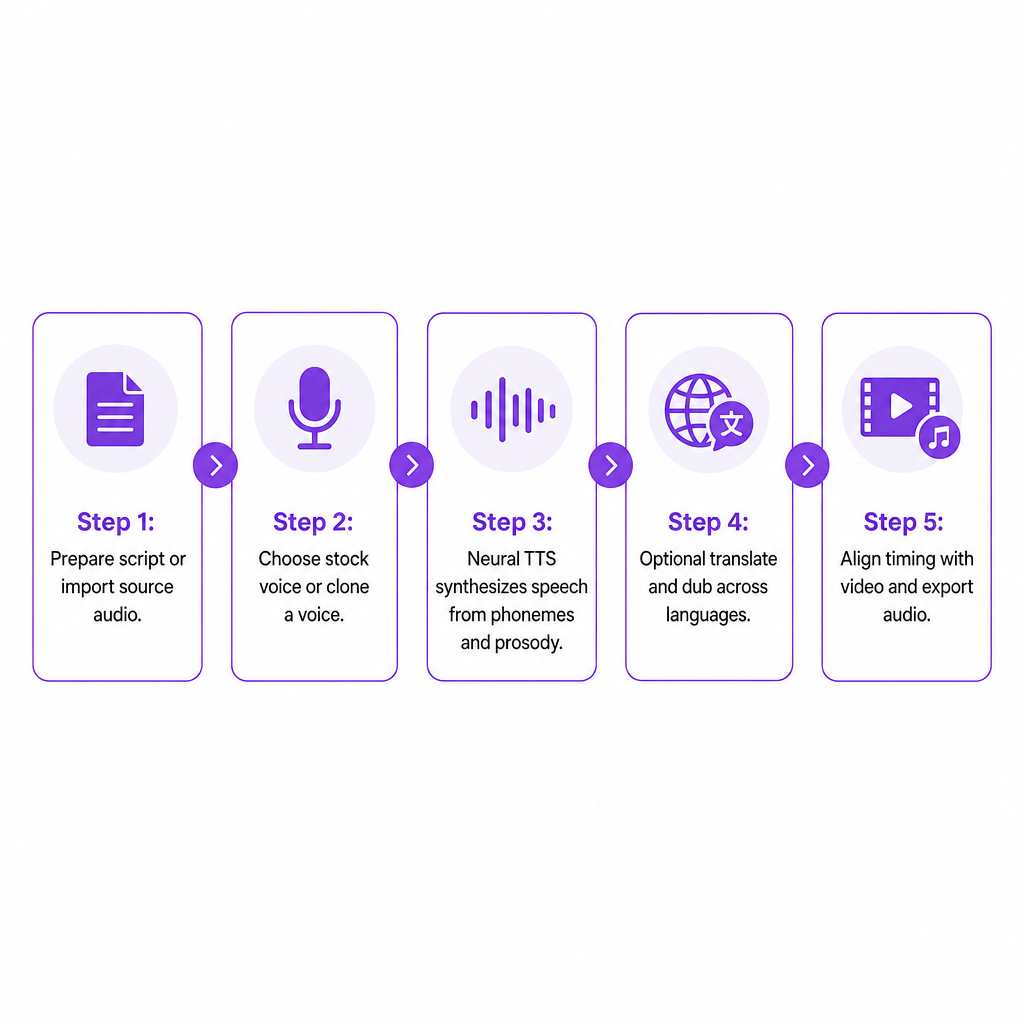
Chuyển văn bản thành giọng nói (TTS) nằm ở trung tâm của mọi bản lồng tiếng AI. Trước tiên, công cụ phân tích kịch bản của bạn — chia văn bản thành các âm vị, đọc dấu câu và cấu trúc, và suy ra ngữ điệu, tức là nhịp điệu, sự nhấn mạnh và ngữ điệu giúp lời nói không nghe đơn điệu. Sau đó, các mô hình nơ-ron tổng hợp những âm vị đó thành âm thanh và áp dụng các mẫu ngữ điệu để cách truyền đạt nghe trôi chảy thay vì máy móc.
Công cụ Text to Speech của chúng tôi cho phép bạn dán văn bản bằng bất kỳ ngôn ngữ nào, chọn một giọng nói từ thư viện hơn 300 giọng, và tạo lời nói chân thực trong vài giây. Các giọng nói nghe tự nhiên và giống người thật, và chúng được phân loại theo ngôn ngữ, giới tính và phong cách để bạn có thể khớp với tông giọng của nội dung mình đang sản xuất. Đối với các nhà phát triển, cùng công cụ đó được cung cấp qua một Text to Speech API theo chuẩn RESTful: gửi một yêu cầu POST với văn bản và các tham số giọng nói của bạn, nhận lại các tệp âm thanh sẵn sàng sử dụng. Văn bản có cấu trúc đi vào, âm thanh sống động đi ra, không cần ghi âm thủ công.
Mô hình giọng nói và thư viện giọng nói
Lồng tiếng AI dựa vào các mô hình giọng nói đã được huấn luyện — các mạng nơ-ron học cách một giọng nói cụ thể nên nghe ra sao qua các từ, ngôn ngữ và cảm xúc khác nhau. Thư viện giọng nói đơn giản là một danh mục các mô hình đó. Chúng tôi duy trì một thư viện hơn 300 giọng nói nghe tự nhiên bao gồm nhiều giới tính, giọng vùng miền và phong cách nói qua nhiều ngôn ngữ, và nó có sẵn cả trong ứng dụng web lẫn qua API để các công cụ nội bộ có thể tạo lời nói theo yêu cầu.
Nhân bản giọng nói: làm cho AI nghe giống bạn
Nhân bản là cơ chế làm cho một bản lồng tiếng nghe giống một người cụ thể thay vì một người dẫn chung chung. Hệ thống phân tích một bản ghi mẫu, học âm sắc, dải cao độ và các mẫu phát âm của người nói, rồi áp dụng những đặc điểm đó vào lời nói tổng hợp mới.
Trên thực tế, bạn tải lên một tệp âm thanh dài ít nhất 20 giây tới Voice Cloning — lý tưởng là sạch và không có tiếng ồn nền. Chúng tôi xử lý mẫu đó thành một hồ sơ giọng nói tùy chỉnh mà bạn có thể đặt tên và tái sử dụng, với việc nhân bản thường chỉ mất vài giây. Sau khi được tạo, giọng nói nhân bản trở nên khả dụng trong Text to Speech và AI Dubbing, để bạn có thể tạo kịch bản hoặc các phiên bản lồng tiếng bằng chính giọng của mình. Về mặt lập trình, Voice Cloning API phản ánh điều này: lấy một URL tải lên, gửi âm thanh của bạn ở định dạng được hỗ trợ, tạo một giọng nói tùy chỉnh từ khóa tệp thu được, rồi sử dụng nó trong các dự án TTS hoặc lồng tiếng.
Lồng tiếng và lồng tiếng đa ngôn ngữ
Chuyển từ một bản lồng tiếng đơn ngôn ngữ sang nội dung đa ngôn ngữ bổ sung việc bản địa hóa lên trên TTS cơ bản. Quy trình chung là nhất quán:
- Ghi lại hoặc nhập lời nói gốc.
- Phiên âm nó thành văn bản.
- Dịch văn bản đó.
- Tạo lời nói mới bằng ngôn ngữ đích.
- Căn chỉnh thời gian khớp với video hoặc âm thanh gốc.
Quy trình AI Dubbing của chúng tôi tuân theo đúng mô hình này, kết hợp chuyển giọng nói thành văn bản, dịch máy, và chuyển văn bản thành giọng nói, tùy chọn tái sử dụng một giọng nói nhân bản để bản lồng tiếng khớp với người nói gốc. Nó biến nội dung nói từ hơn 60 ngôn ngữ nguồn thành các phiên bản lồng tiếng qua 33 ngôn ngữ đích. Lồng tiếng speech-to-speech nhằm giữ tông giọng và thời gian gần với màn trình diễn gốc, điều quan trọng nhất đối với nội dung đào tạo trực tuyến, huấn luyện, và phim ảnh, nơi đồng bộ khẩu hình và nhịp độ mang tính quyết định cho trải nghiệm.
API và quy trình tự động hóa
Đối với các nhóm sản xuất lồng tiếng ở quy mô lớn, API là thứ đưa việc tạo giọng nói vào các hệ thống hiện có. TTS API xử lý văn bản vào, âm thanh ra; Voice Cloning API bổ sung việc tạo và quản lý giọng nói tùy chỉnh bằng lập trình; và AI Dubbing API mở rộng cả hai để dịch và lồng tiếng tự động qua hơn 33 ngôn ngữ với quyền truy cập vào các giọng nói nhân bản. Cùng nhau, chúng cho phép bạn xây dựng các quy trình trong đó kịch bản, phụ đề, hoặc bản phiên âm được lấy từ một hệ thống nội dung tự động trở thành bản lồng tiếng hoặc bản dịch tiếng, không cần xử lý tệp thủ công.
Ba cách để bạn tạo lồng tiếng AI trong DubSmart
Bên trong nền tảng của chúng tôi, câu hỏi này quy về ba điểm khởi đầu thực tế.
Bắt đầu từ một kịch bản với Text to Speech. Dán văn bản của bạn, chọn một giọng nói có sẵn hoặc nhân bản, thiết lập ngôn ngữ và các điều khiển cơ bản, và tạo lời nói mà bạn có thể tải xuống ở các định dạng chuẩn. Điều này phù hợp với video đào tạo, nội dung giải thích, các quảng cáo tiếp thị, và phần mở đầu podcast, nơi bạn sở hữu kịch bản ngay từ đầu.
Bắt đầu từ media hiện có với AI Dubbing. Tải lên một tệp video hoặc âm thanh nguồn, để hệ thống phiên âm và dịch, rồi tạo các bản lồng tiếng ở những ngôn ngữ bạn chọn — tái sử dụng các giọng nói nhân bản để giữ âm thanh nhất quán. Đây là con đường cho các kênh mở rộng sang khán giả đa ngôn ngữ và cho các doanh nghiệp tái sử dụng hội thảo trực tuyến hoặc bản demo sản phẩm.
Bắt đầu từ hệ thống của riêng bạn với việc tạo dựa trên API. Ứng dụng của bạn gửi văn bản và các tham số giọng nói đến TTS API, tùy chọn gắn nội dung với một giọng nói cụ thể qua Voice Cloning API, và truy xuất âm thanh sẵn sàng để gắn vào video hoặc lồng tiếng đào tạo trực tuyến cho các mô-đun đào tạo. Điều này phù hợp với các nhà phát triển, agency, và nhà cung cấp LMS cần đầu ra nhất quán, bằng lập trình.
Tiêu chí quyết định: chọn thiết lập lồng tiếng AI của bạn
Độ tự nhiên và chất lượng âm thanh
Độ tự nhiên là điều không thể thỏa hiệp. Các công cụ mạnh mô hình hóa ngữ điệu và cách phát âm để lời nói trôi chảy với những khoảng dừng và sự nhấn mạnh phù hợp. Vì việc tạo diễn ra nhanh, bạn có thể tinh chỉnh kịch bản và tạo lại âm thanh cho đến khi cách truyền đạt cảm thấy đúng thay vì chấp nhận lần thử đầu tiên.
Phạm vi ngôn ngữ và độ sâu bản địa hóa
Nếu các kênh đa ngôn ngữ hoặc đào tạo quốc tế nằm trong lộ trình của bạn, phạm vi bao phủ quyết định bạn có thể vươn xa đến đâu. Biến nội dung từ hơn 60 ngôn ngữ nguồn thành 33 ngôn ngữ đích từ một quy trình xác định những thị trường bạn có thể phục vụ, và lồng tiếng speech-to-speech giúp giữ tông giọng và thời gian nhất quán qua mọi phiên bản.
Xây dựng thương hiệu giọng nói và khả năng nhân bản
Một giọng nói dễ nhận diện là điều quan trọng đối với các công ty, nhà sáng tạo, và podcast. Nhân bản cho phép bạn mang cùng một giọng nói qua các ngôn ngữ và kênh. Việc có thể nhân bản từ khoảng 20 giây âm thanh sạch và tái sử dụng hồ sơ đó trong Text to Speech và AI Dubbing khiến việc thiết lập và duy trì một giọng nói đặc trưng trở nên thực tế.
Sự đơn giản của quy trình so với tích hợp kỹ thuật
Các nhà sáng tạo thường muốn việc tải lên, chỉnh sửa và tải xuống được xử lý ở cùng một nơi. Các nhóm kỹ thuật thường cần API. Chúng tôi cung cấp cả hai: các công cụ hướng đến người dùng trong một ứng dụng thống nhất và các API dành cho nhà phát triển cho phép truy cập cùng những công cụ đó. Lựa chọn phụ thuộc vào việc nhóm của bạn làm việc chủ yếu trong trình duyệt hay xây dựng trên các hệ thống nội bộ.
Tốc độ, khả năng mở rộng, và tính nhất quán
Một công cụ lồng tiếng nên rút ngắn quá trình sản xuất và mở rộng quy mô mà không làm giảm chất lượng. Việc tạo TTS gần như tức thì và nhân bản hoàn tất trong vài giây cho phép tinh chỉnh nhanh và đầu ra hàng loạt, trong khi API cho phép hàng nghìn kịch bản hoặc phân đoạn được xử lý tự động với giọng nói và thiết lập nhất quán.
Cơ cấu ngân sách và quyền kiểm soát
Thay vì phí phòng thu theo buổi, các công cụ lồng tiếng AI thường sử dụng định giá theo mức sử dụng. Mô hình dựa trên tín dụng của chúng tôi cho bạn quyền truy cập vào AI Dubbing, Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image, và Image to Video trong một tài khoản, với một gói miễn phí và các gói doanh nghiệp. Tín dụng cung cấp giới hạn sử dụng có thể dự đoán được trong khi việc chuyển tiếp và mở rộng vẫn khả dụng khi khối lượng tăng lên. Nếu bạn muốn định lượng tín dụng theo thời lượng, phần phân tích chi phí lồng tiếng AI mỗi phút của chúng tôi sẽ đi qua cách tính toán.
Tuân thủ, sự đồng ý, và xử lý dữ liệu
Nhân bản và lời nói tổng hợp mang trọng lượng đạo đức và pháp lý. Chúng tôi yêu cầu bạn tải lên âm thanh mà bạn có quyền sử dụng và khuyến nghị các bản ghi sạch để có kết quả tốt nhất, điều này giữ sự đồng ý và quyền kiểm soát làm trọng tâm. Tài liệu API của chúng tôi sử dụng các URL tải lên được ký trước, an toàn và các định dạng âm thanh chuẩn, cung cấp cho các nhà phát triển một mô hình rõ ràng để sử dụng tuân thủ bên trong các ứng dụng.
Những rủi ro đáng để lên kế hoạch phòng tránh
Ngay cả với các công cụ có năng lực, một vài chế độ lỗi vẫn đáng được lường trước.
Âm thanh không tự nhiên hoặc máy móc thường bắt nguồn từ các kịch bản có dấu câu kém hoặc một giọng nói không khớp với nội dung. Chọn từ một thư viện giọng nói tự nhiên và tạo lại cho đến khi cách truyền đạt phù hợp là giải pháp thực tế, và việc tạo nhanh khiến thử nghiệm đó ít tốn kém.
Phát âm sai có xu hướng xuất hiện với tên riêng, thuật ngữ kỹ thuật, và nội dung bản địa hóa. Một quy trình chạy phiên âm, dịch, và rà soát — thay vì chuyển đổi âm thanh sang âm thanh một cách mù quáng — bắt được nhiều lỗi hơn trước khi chúng được xuất bản.
Sự không khớp thời gian giữa lời nói tổng hợp và hình ảnh trên màn hình làm tổn hại trải nghiệm người xem. Lồng tiếng speech-to-speech giữ gần với tông giọng và thời gian gốc, kết hợp với việc chỉnh sửa bên trong môi trường dự án, cho bạn quyền kiểm soát tốt hơn đối với việc căn chỉnh.
Về mặt đạo đức, nhân bản một giọng nói mà không có quyền phù hợp sẽ mời gọi những vấn đề nghiêm trọng. Yêu cầu một mẫu sạch dưới sự kiểm soát của bạn, và định vị nhân bản như một công cụ cho các nhà sáng tạo và doanh nghiệp thay vì mạo danh ẩn danh, là điều giữ cho việc thực hành này có trách nhiệm. Khi bạn bản địa hóa cảnh quay hiện có, hướng dẫn của chúng tôi về cách thay đổi ngôn ngữ giọng nói trong video sẽ chỉ ra con đường thuận tiện cho việc rà soát.
Cách các nhà sáng tạo khác nhau áp dụng điều này vào thực tế
Một nhà sáng tạo YouTube mở rộng ra nước ngoài có thể biến một video tiếng Anh thành các phiên bản tiếng Tây Ban Nha, tiếng Bồ Đào Nha, và tiếng Đức với AI Dubbing và một giọng nói nhân bản, để người dẫn vẫn dễ nhận diện qua mọi thị trường — tất cả bên trong quy trình hơn 60 ngôn ngữ nguồn và 33 ngôn ngữ đích.
Một doanh nghiệp nhỏ hoặc nhóm tiếp thị có thể soạn thảo một kịch bản giải thích sản phẩm hoặc quảng cáo trong một tài liệu, chuyển đổi nó thành âm thanh với Text to Speech, và chọn một giọng nói khớp với tông giọng thương hiệu — năng động, trang trọng, hoặc thân thiện. Chính những kịch bản đó có thể được bản địa hóa sau này qua AI Dubbing bằng cách sử dụng một giọng nói thương hiệu nhân bản.
Một nhà sản xuất đào tạo trực tuyến hoặc đào tạo doanh nghiệp có thể tự động hóa việc thuyết minh cho các bộ slide và gói SCORM bằng cách gửi văn bản bài học qua TTS API và gắn âm thanh được trả về vào mỗi mô-đun, với việc nhân bản giữ giọng nói của giảng viên nhất quán ngay cả qua các phiên bản khu vực.
Một nhà làm phim độc lập hoặc nhà sáng tạo podcast có thể sản xuất trailer, quảng cáo, hoặc lời thoại đã dịch mà không cần đặt phòng thu ở mọi ngôn ngữ, kết hợp Speech to Text, AI Dubbing, và các giọng nói nhân bản để giữ vững danh tính nhân vật.
Các nhà phát triển và agency có thể nhúng các API TTS, Voice Cloning, và AI Dubbing vào các công cụ nội bộ hoặc nền tảng của khách hàng, tự động hóa mọi thứ từ lồng tiếng mạng xã hội dạng ngắn đến các tác nhân giọng nói tương tác.
Câu hỏi thường gặp
Lồng tiếng AI khác gì với lồng tiếng thu âm truyền thống?
Lồng tiếng truyền thống cần một diễn viên lồng tiếng con người, thời gian phòng thu, và nhiều buổi thu. Lồng tiếng AI được tạo ra bởi các công cụ chuyển văn bản thành giọng nói và nhân bản giọng nói, biến kịch bản trực tiếp thành âm thanh bằng các mô hình nơ-ron đã được huấn luyện thay vì một màn trình diễn trực tiếp.
Lồng tiếng AI có thể nghe giống một người cụ thể không?
Có. Nhân bản giọng nói phân tích một mẫu ngắn giọng nói của một người và xây dựng một mô hình tùy chỉnh có thể nói bất kỳ kịch bản nào bằng giọng đó, có sẵn trong công cụ và API Voice Cloning của chúng tôi.
Cần bao nhiêu âm thanh để nhân bản một giọng nói?
Chúng tôi yêu cầu ít nhất 20 giây âm thanh sạch, không có tiếng ồn nền, để tạo một hồ sơ giọng nói nhân bản đáng tin cậy, với việc nhân bản thường hoàn tất trong vài giây.
Tôi có thể tạo lồng tiếng bằng nhiều ngôn ngữ từ một video nguồn không?
Có. Chúng tôi kết hợp chuyển giọng nói thành văn bản, dịch, và chuyển văn bản thành giọng nói để biến nội dung từ hơn 60 ngôn ngữ nguồn thành đầu ra lồng tiếng qua 33 ngôn ngữ đích, để một video gốc có thể tạo ra nhiều bản lồng tiếng được bản địa hóa.
Có cách nào để tự động hóa việc tạo lồng tiếng thay vì sử dụng giao diện không?
TTS API và Voice Cloning API của chúng tôi cho phép các ứng dụng và công cụ nội bộ gửi văn bản và mẫu âm thanh, tạo giọng nói tùy chỉnh, và nhận lời nói tổng hợp bằng lập trình, để lồng tiếng có thể được tạo tự động ở quy mô lớn.