Tách giọng nói bằng AI là một quy trình học sâu (deep learning) giúp trích xuất giọng nói con người ra khỏi một bản âm thanh hỗn tạp và trả về một bản giọng nói sạch, sẵn sàng cho việc phiên âm, lồng tiếng hoặc nhân bản giọng nói. Khả năng đơn lẻ đó trả lời câu hỏi mà hầu hết các nhà sáng tạo thực sự đặt ra: liệu tôi có thể cứu vãn bản ghi âm này mà không cần quay lại từ đầu không? Hiểu cách tách giọng nói bằng AI hoạt động sẽ giúp bạn quyết định khi nào nên dựa vào nó, khi nào nên ghi âm sạch hơn ngay từ đầu, và làm thế nào một bản giọng nói sạch âm thầm cải thiện mọi thứ ở các bước phía sau. Hướng dẫn này sẽ đi qua cơ chế hoạt động, sự khác biệt giữa việc tăng cường một người nói và việc tách nhiều người nói, vị trí của quy trình này trong một pipeline bản địa hóa, và những gì nó vẫn chưa thể khắc phục.
Mục lục
Quyết định đằng sau việc tách giọng nói
Bất kỳ bản ghi âm thực tế nào cũng thu được nhiều hơn nhiều so với chỉ mỗi người nói. Vlog, hội thảo trực tuyến, video đào tạo và podcast đều thu tiếng ồn đường phố, âm thanh môi trường phòng, nhạc nền, tiếng gõ bàn phím và tiếng nói chồng chéo, những thứ có thể chôn vùi những từ quan trọng. Một công cụ tách giọng nói tồn tại để gỡ rối mớ hỗn hợp đó: nó lấy một tệp trộn lẫn và trả về một bản chủ yếu chứa giọng nói con người, cộng thêm một bản tùy chọn giữ phần âm thanh nền còn lại.
Bản giọng nói sạch đó trở thành nền tảng cho bất cứ điều gì tiếp theo: chuyển giọng nói thành văn bản chính xác, lồng tiếng đa ngôn ngữ, nhân bản giọng nói độ trung thực cao, hoặc đơn giản là một bản gốc nghe hay hơn. Vì vậy quyết định thực sự không phải mang tính kỹ thuật, mà mang tính thực tiễn. Bạn có tin tưởng âm thanh hiện tại của mình đủ để xây dựng nội dung đa ngôn ngữ trên đó không, hay bạn muốn AI làm sạch và tách giọng nói trước? Và bạn muốn một tiện ích làm sạch độc lập, hay một công cụ tách được tích hợp trong một nền tảng sáng tạo và bản địa hóa rộng hơn để bạn không phải xoay xở giữa nhiều ứng dụng?
Chúng tôi đã thiết kế Speech Separator của mình để đóng vai trò là cổng AI đầu tiên trong một quy trình làm việc thống nhất. Nó nằm trước chuyển giọng nói thành văn bản, chuyển văn bản thành giọng nói, nhân bản giọng nói và lồng tiếng, để mọi hệ thống ở các bước sau đều nhận được tín hiệu giọng nói rõ ràng nhất có thể thay vì kế thừa bất kỳ tiếng ồn nào có trong phòng.
Cơ chế: từ dạng sóng đến giọng nói sạch
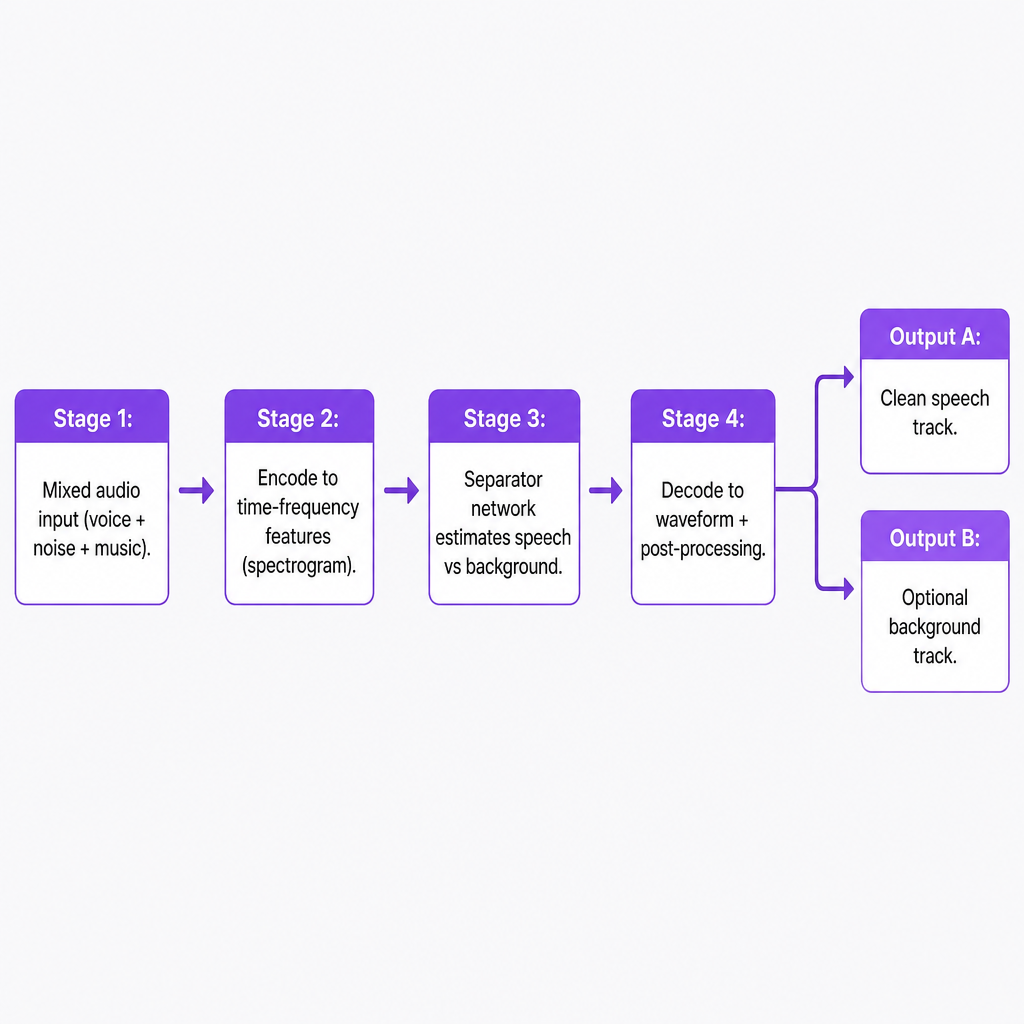
Việc tách giọng nói bằng AI hiện đại tuân theo một pipeline bốn giai đoạn: mã hóa tín hiệu, tách các nguồn trong một không gian đặc trưng đã học, ước lượng giọng nói sạch, và giải mã nó trở lại thành âm thanh.
Từ dạng sóng đến đặc trưng
Hầu hết các hệ thống trước tiên chuyển đổi dạng sóng thô từ micro của bạn thành một biểu diễn thời gian-tần số như spectrogram, biểu diễn này cho thấy năng lượng ở các dải tần số khác nhau thay đổi theo thời gian như thế nào. Cách nhìn đó giúp mạng nơ-ron dễ dàng nhận ra các mẫu tương ứng với giọng nói con người so với tiếng ồn hoặc âm nhạc. Sau đó một mạng mã hóa ánh xạ đầu vào vào một không gian đặc trưng nhiều chiều nơi các nguồn âm thanh khác nhau trở nên dễ phân biệt hơn, nhấn mạnh các đặc điểm giọng nói như formant, hài âm và cấu trúc thời gian trong khi ức chế nội dung nền không liên quan.
Mạng tách và mặt nạ (mask)
Cốt lõi của quy trình là mạng tách, một mô hình sâu được huấn luyện để đánh giá cái gì thuộc về giọng nói và cái gì không tại mỗi điểm thời gian-tần số. Hai chiến lược chiếm ưu thế. Tách dựa trên mặt nạ dự đoán một mặt nạ cho spectrogram giữ lại năng lượng giọng nói và làm suy giảm mọi thứ khác; khi áp dụng vào spectrogram gốc, tiếng ồn nền và âm nhạc giảm mạnh trong khi giọng nói vẫn còn. Ước lượng nguồn trực tiếp thay vào đó dự đoán chính spectrogram giọng nói sạch, và đôi khi một phần nền còn lại, sau đó được giải mã trở lại thành âm thanh.
Các phương pháp chuyên biệt hơn tồn tại cho các trường hợp khó hơn. Deep clustering học một embedding cho mỗi bin thời gian-tần số để các bin từ cùng một nguồn được nhóm lại với nhau, sau đó phân cụm tiêu chuẩn tách giọng nói khỏi các nguồn khác. Các mô hình khác sử dụng huấn luyện bất biến hoán vị (permutation-invariant training) để chúng có thể tách nhiều người nói mà không cần giả định người nói nào là đầu ra một so với đầu ra hai.
Huấn luyện với các ví dụ có giám sát
Các mô hình này học từ các hỗn hợp ví dụ được ghép cặp với giọng nói sạch chuẩn (ground-truth), tự điều chỉnh để giảm thiểu khoảng cách giữa đầu ra của chúng và bản tham chiếu. Mục tiêu huấn luyện có thể là mặt nạ, spectrogram sạch, hoặc dạng sóng được tái tạo, và các hàm mất mát thường gắn với các thước đo chất lượng cảm nhận như tỷ lệ tín hiệu trên nhiễu biến dạng (signal-to-distortion ratio). Được cung cấp nhiều mẫu đa dạng qua các giọng, micro và môi trường khác nhau, mạng nội hóa các dấu hiệu vững chắc phân biệt giọng nói con người khỏi nội dung nền và khái quát hóa cho những bản ghi mà nó chưa từng thấy.
Giải mã trở lại thành âm thanh
Cuối cùng hệ thống ánh xạ biểu diễn giọng nói đã tách trở lại thành dạng sóng miền thời gian thông qua một phép biến đổi ngược, tiếp theo là hậu xử lý như khử nhiễu và chuẩn hóa độ lớn. Kết quả là một bản mà giọng nói chiếm ưu thế, có thể đứng độc lập hoặc được kết hợp lại với một lượng nền được kiểm soát để tạo sự tự nhiên. Speech Separator của chúng tôi tuân theo đúng mẫu này: nó tiếp nhận âm thanh hoặc video bạn tải lên, chạy pipeline tách, và trả về một bản tập trung vào giọng nói cùng phần nền tùy chọn để bạn quyết định bản trộn cuối cùng nên khô hay có âm thanh môi trường đến mức nào.
Tăng cường một người nói so với tách nhiều người nói
Có một ranh giới quan trọng giữa việc tăng cường một người nói chiếm ưu thế và việc thực sự tách nhiều giọng nói chồng chéo, và nó định hình những gì bạn có thể thực tế mong đợi.
Tăng cường một người nói cô lập một giọng chính khỏi tiếng ồn nền, tiếng vang và âm thanh không phải giọng nói để độ dễ hiểu tăng vọt. Điều này hoạt động đặc biệt tốt cho vlog, hội thảo trực tuyến, bài giảng và nội dung dạng người nói trước camera, nơi vấn đề là tiếng ồn môi trường hoặc nhạc nền chứ không phải tiếng nói chồng chéo. Speech Separator của chúng tôi được tối ưu cho trường hợp này: nó coi giọng nói con người là nguồn chính và mọi thứ khác là nền, cung cấp một bản giọng nói đã làm sạch và một bản nền tùy chọn.
Tách nhiều người nói là một nhiệm vụ khác: tách một hỗn hợp nhiều người nói cùng lúc thành các luồng riêng biệt, mỗi luồng cho một giọng. Các mô hình nghiên cứu đã tách được đến năm giọng từ một micro duy nhất bằng cách huấn luyện các mạng khác nhau cho các số lượng người nói khác nhau và chọn mô hình phù hợp nhất cho mỗi mẫu. Các kỹ thuật như deep clustering và định dạng chùm nơ-ron đa micro (multi-microphone neural beamforming) đẩy hiệu suất xa hơn trong các thiết lập trường xa và đa kênh, nhưng chúng phức tạp hơn và nặng về tính toán. Trong thực tế, các hệ thống này vẫn nhắm đến các kịch bản chuyên biệt như phiên âm cuộc họp, tổng đài chăm sóc khách hàng và thiết bị thông minh chứ không phải quy trình làm việc hàng ngày của nhà sáng tạo. Đối với hầu hết người dùng của chúng tôi, những người vận hành kênh YouTube, đội ngũ marketing, hoặc thư viện khóa học, lợi ích thực tế lớn nhất đến từ việc tăng cường một người nói mạnh mẽ và tách giọng nói khỏi nền, chứ không phải tách nhiều giọng đầy đủ.
Vị trí của việc tách giọng trong quy trình bản địa hóa
Tách giọng là cầu nối giữa các bản ghi âm thực tế ồn ào và công việc giọng nói AI chất lượng cao. Một lộ trình điển hình chạy trơn tru qua nhiều công cụ.
Một nhà sáng tạo tải lên một tệp âm thanh hoặc video, và công cụ tách cô lập bản giọng nói và tùy chọn phần nền. Giọng nói sạch đó đưa vào chuyển giọng nói thành văn bản, để việc phiên âm và dịch thuật hoạt động trên một tín hiệu rõ ràng, giúp cải thiện độ chính xác và giảm những từ bị "ảo giác" gây ra bởi âm nhạc nặng hoặc tiếng ồn. Văn bản và bản dịch thu được sau đó chuyển sang chuyển văn bản thành giọng nói và lồng tiếng AI, tạo ra các phiên bản ngôn ngữ mới bằng giọng nói được nhân bản hoặc tổng hợp; vì giọng nói nguồn đã sạch, việc căn chỉnh thời gian chính xác hơn và các hiện tượng nhiễu khi trộn như pumping được giảm bớt.
Nhân bản giọng nói phụ thuộc vào cùng một đầu vào sạch. Các mô hình cần các ví dụ tương đối không có tiếng ồn để học một cách đáng tin cậy âm sắc, ngữ điệu và cách phát âm của người nói, và việc tách giảm bớt sự nhiễm bẩn từ nền vốn có thể làm biến dạng một giọng được nhân bản. Hướng dẫn tiếng Tây Ban Nha của chúng tôi về việc tách nắm bắt tốt trải nghiệm hàng ngày: tải lên một tệp, để AI tách giọng nói khỏi nền, sau đó tải xuống bản giọng nói sạch hoặc phần nền được cô lập để chỉnh sửa, lồng tiếng hoặc thuyết minh thêm, tất cả trong một quy trình làm việc. Sự hợp nhất đó chính là điểm mấu chốt đối với các đội nhóm nhỏ, những người mà nếu không sẽ phải nhảy qua nhảy lại giữa các plugin giảm nhiễu riêng biệt, công cụ phiên âm, dịch vụ lồng tiếng và nền tảng nhân bản.
Lựa chọn và sử dụng tách giọng nói bằng AI
Khi bạn quyết định cách áp dụng việc tách giọng, một số ít tiêu chí thực tế đảm nhận hầu hết công việc.
Điều kiện âm thanh và loại nội dung. Với một người nói chính duy nhất và tiếng ồn nền hoặc âm nhạc ở mức vừa phải, việc tách rất hiệu quả và ít rủi ro. Với sự chồng chéo nặng, micro trường xa, hoặc đầu vào chất lượng rất thấp, hãy kỳ vọng lợi ích giảm dần và kết hợp AI với việc ghi âm tốt hơn thay vì dựa vào nó để cứu vãn mọi thứ.
Tích hợp với các công cụ ở bước sau. Một công cụ tách chảy trực tiếp vào phiên âm, chuyển văn bản thành giọng nói và lồng tiếng sẽ giảm ma sát và nhiễu tích lũy so với việc xuất và nhập lại giữa các ứng dụng. Chúng tôi kết nối Speech Separator với phần còn lại của các công cụ bản địa hóa của mình chính vì lý do này, điều đó càng quan trọng hơn khi mục tiêu của bạn là xuất bản đa ngôn ngữ chứ không phải giảm nhiễu một lần.
Kiểm soát âm thanh nền. Đối với việc kể chuyện thương hiệu, bạn thường muốn giữ lại một chút âm thanh môi trường hoặc âm nhạc để tạo tác động cảm xúc. Các hệ thống xuất ra cả một bản giọng nói sạch và một bản nền được cô lập cho các biên tập viên nhiều không gian hơn so với các công cụ chỉ tạo ra một bản trộn đã khử nhiễu duy nhất. Công cụ tách của chúng tôi hỗ trợ mô hình giọng-nói-cộng-nền-tùy-chọn này để bạn có thể phối lại một cách có chủ đích.
Tốc độ, sự đơn giản và khả năng mở rộng. Đối với các nhà sáng tạo và đội nhóm nhỏ, tính dễ sử dụng cạnh tranh với hiệu suất thô. Tách một cú nhấp chuột thông qua trình duyệt hoặc API, với việc tự động xử lý các định dạng phổ biến, vượt trội hơn các chuỗi plugin phức tạp giả định người dùng có chuyên môn kỹ thuật âm thanh. Một khi bạn đang quản lý hàng trăm video hoặc mô-đun khóa học, xử lý hàng loạt và tự động hóa không còn là thứ xa xỉ.
Độ tin cậy và hiện tượng nhiễu. Một mô hình mạnh cải thiện độ dễ hiểu mà không thêm biến dạng rõ ràng, tiếng vang kim loại, hoặc hiện tượng thở. Các bản demo có thể tâng bốc một hệ thống, vì vậy hãy thử nghiệm với các bản ghi âm đại diện của chính bạn trước khi biến bất kỳ công cụ tách nào thành một phần cố định trong pipeline của bạn.
Quyền riêng tư và tuân thủ. Việc tách hoạt động trực tiếp trên dữ liệu giọng nói có thể bao gồm thông tin nhạy cảm. Các đội nhóm doanh nghiệp nên xác nhận cách âm thanh được lưu trữ, liệu nó có được sử dụng để huấn luyện mô hình hay không, và những biện pháp kiểm soát nào tồn tại cho việc lưu giữ và truy cập, đặc biệt đối với các ngành được quản lý và nội dung đào tạo nội bộ.
Cân nhắc các tiêu chí này với các trường hợp sử dụng thực tế của bạn, dù là mở rộng kênh, đào tạo, marketing, công việc kể chuyện, hay một sản phẩm API, sẽ cho bạn biết liệu một công cụ tách được tích hợp với các công cụ giọng nói ở bước sau có phù hợp với cách bạn vận hành hay không.
Rủi ro, giới hạn và những gì nó không thể khắc phục
Ngay cả các mô hình mạnh cũng có những giới hạn khó khăn đáng biết trước khi bạn cam kết.
- Tiếng ồn cực lớn hoặc tỷ lệ tín hiệu trên nhiễu rất thấp. Khi giọng nói bị chôn vùi dưới tiếng ồn hoặc âm nhạc lớn, mô hình có thể không khôi phục được mọi từ, tạo ra hiện tượng mất tiếng hoặc đầu ra bị nghẹt.
- Sự chồng chéo người nói nặng. Người nói vào đúng cùng một thời điểm thách thức ngay cả các hệ thống tách nhiều người nói tiên tiến và có thể khiến giọng nói bị rò rỉ giữa các luồng đã tách.
- Hiện tượng tách quá mức. Việc che mặt nạ quá mạnh mẽ có thể tạo ra nhiễu âm nhạc hoặc âm sắc robot, dễ nhận thấy nhất ở các âm thanh kéo dài và âm xuýt.
- Sự không khớp giữa huấn luyện và thực tế. Các mô hình được tinh chỉnh trên một số micro, ngôn ngữ hoặc môi trường nhất định có thể hoạt động kém trên các bản ghi rất khác biệt, điều này sau đó kéo tụt độ chính xác của phiên âm và lồng tiếng.
- Đạo đức và quyền lợi. Giọng nói được tách sạch dễ phiên âm, phân tích và phối lại hơn, vì vậy các đội nhóm phải tôn trọng sự đồng ý và quyền lợi khi tái sử dụng giọng nói trong các ngôn ngữ hoặc bối cảnh mới.
Kết luận thẳng thắn là việc tách giọng là một sự tăng cường mạnh mẽ, không phải sự thay thế cho thói quen ghi âm hợp lý. Micro tốt, mức âm thanh hợp lý và lựa chọn địa điểm cẩn thận vẫn có giá trị, và sau đó AI nhân lên những lựa chọn đó bằng cách làm cho nội dung linh hoạt hơn nhiều cho việc bản địa hóa và tái sử dụng. Nếu bạn đang khám phá cách kết hợp điều này vào một thiết lập xuất bản lớn hơn, bài giải thích của chúng tôi về công cụ tách giọng nói là gì đề cập đến các nền tảng cơ bản một cách chi tiết hơn.
Câu hỏi thường gặp
Tách giọng nói bằng AI là gì nói một cách đơn giản?
Đó là một quy trình AI lấy một bản ghi âm trộn lẫn và cô lập giọng nói con người, cho bạn một bản giọng nói sạch và, tùy chọn, một bản nền riêng biệt mà bạn có thể giữ lại hoặc loại bỏ.
Speech Separator của chúng tôi khác gì so với giảm nhiễu cơ bản?
Giảm nhiễu truyền thống chủ yếu làm suy giảm tiếng ồn ổn định. Công cụ tách của chúng tôi sử dụng học sâu để nhận ra các mẫu giọng nói và trích xuất chúng khỏi một loạt các âm thanh nền và âm nhạc, điều này thường mang lại lời thoại sạch hơn và tự nhiên hơn.
Nó có thể xử lý nhiều người nói không?
Speech Separator của chúng tôi được tối ưu để cô lập giọng nói con người khỏi các nền không phải giọng nói, hoạt động tốt nhất với một người nói chính trong bản trộn. Việc tách nhiều giọng nói chồng chéo là một lĩnh vực nghiên cứu đang phát triển, và các mô hình chuyên biệt tồn tại, nhưng chúng thường nhắm đến các cuộc họp hoặc tổng đài chăm sóc khách hàng chứ không phải quy trình làm việc chung của nhà sáng tạo.
Tại sao việc tách giọng nói lại quan trọng đối với lồng tiếng đa ngôn ngữ?
Bản địa hóa dựa vào phiên âm và căn chỉnh thời gian chính xác. Một bản giọng nói sạch giảm lỗi nhận dạng và giúp các bản lồng tiếng đã dịch căn khớp với video gốc, cắt giảm các hiện tượng nhiễu nghe thấy được khi các giọng nói mới được trộn với âm nhạc và hiệu ứng được giữ lại.
Tôi cần bao nhiêu kiến thức kỹ thuật để sử dụng nó?
Rất ít. Bạn tải lên một tệp âm thanh hoặc video, để AI xử lý nó, và tải xuống các bản giọng nói và nền đã tách để chỉnh sửa, lồng tiếng hoặc tự động hóa, mà không cần điều chỉnh tham số thủ công.