Bir metin okuma API'sini entegre etmenin en hızlı yolu, onu bir REST servisi gibi ele almaktır: bir API anahtarıyla kimlik doğrulaması yapın, metninizi ses ayarlarınızla birlikte JSON olarak gönderin, servisin arka planda konuşmayı işlemesine izin verin, ardından ortaya çıkan ses dosyalarını kullanıcılarınızın ihtiyaç duyduğu her yerde oynatmak için alın ve saklayın. Metin Okuma API'miz tam olarak bu deseni izlerken 300'den fazla doğal ses ve sınırsız ses klonlama sunar, böylece web sitelerine, uygulamalara, video hatlarına ve öğrenme platformlarına gerçekçi konuşmayı ekleyebilirsiniz. Bu rehber, aslında neyi entegre ettiğinizi, motorumuzun nasıl çalıştığını ve entegrasyonun ürününüze uygun olup olmadığını belirleyen kararları adım adım anlatır.
İçindekiler
DubSmart'ta bir metin okuma API'si ne yapar
Bir metin okuma API'si, yapılandırılmış metni talep üzerine sesli sese dönüştürür, böylece kodunuz manuel kayıt için beklemek yerine bir betik hazır olduğu anda anlatı veya diyalog talep edebilir. Metin Okuma motorumuz hem tarayıcı tabanlı Metin Okuma aracını hem de API'yi çalıştırır ve diller, cinsiyetler ve stiller genelinde 300'den fazla yapay zeka sesine erişim sağlar; prozodi anlatı, açıklayıcı içerikler ve diyaloglar için ayarlanmıştır.
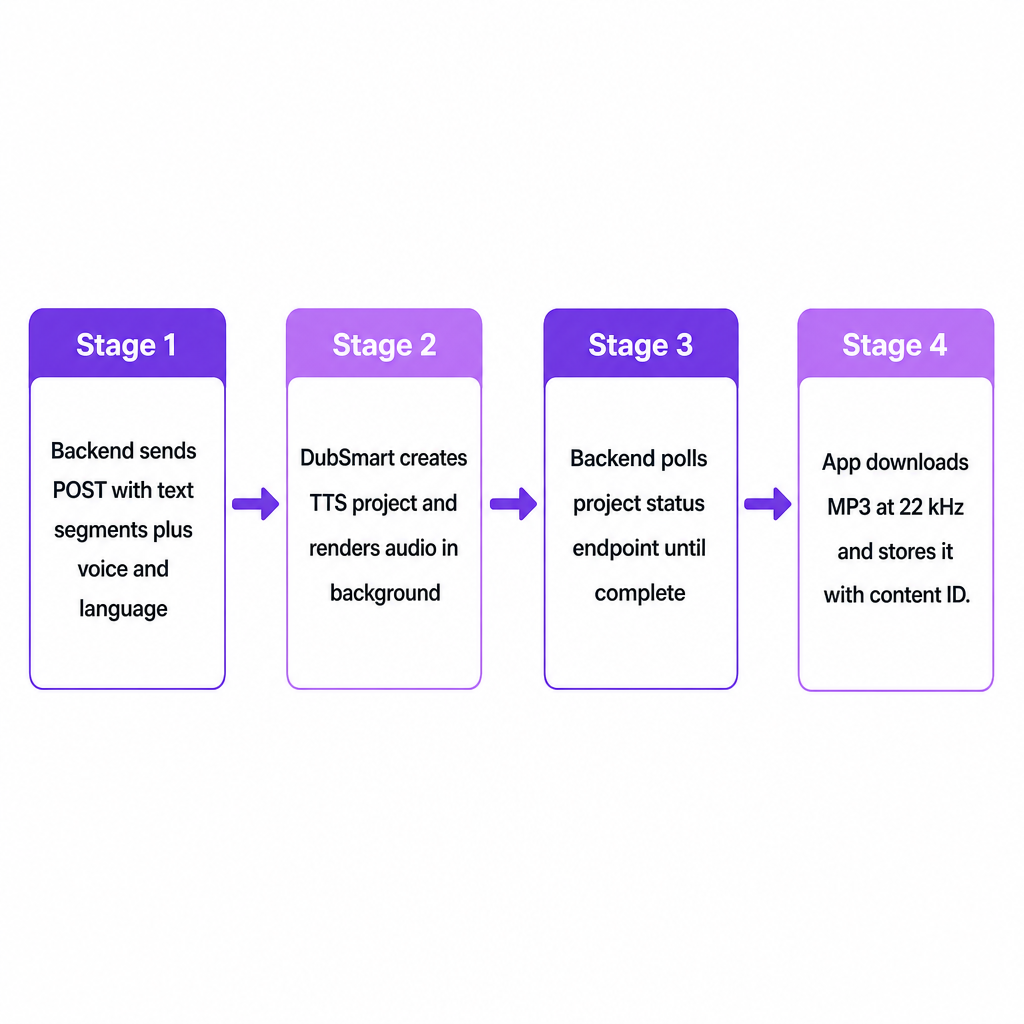
API katmanında bu motoru RESTful bir servis olarak sunuyoruz: arka ucunuz metin segmentleri ve ses parametreleri içeren bir POST isteği gönderir ve servis, ses indirmeye hazır olana kadar durumunu sorgulayabileceğiniz bir proje nesnesi döndürür. Çıktı, genellikle 22 kHz'de MP3 olarak yüksek kaliteli ses dosyaları olarak teslim edilir ve ekstra dönüştürme olmadan video düzenleyicilerde, podcast iş akışlarında veya web oynatıcılarında doğrudan kullanıma uygundur.
Hizmet verdiğimiz içerik üreticiler ve ekipler için—YouTuber'lar, küçük işletmeler, e-öğrenme üreticileri, film yapımcıları ve geliştirici ajansları—API, içerik planlaması ile yayınlama arasında köprü kurar. Bir betik bir CMS'ye veya öğrenme platformuna ulaştığı anda, arka uç seslendirmeleri otomatik olarak oluşturabilir, bu da tekrarlayan manuel kaydın darboğazını ortadan kaldırır.
Entegrasyon kararı: aslında neyi entegre ediyorsunuz?
"Bir metin okuma API'sini entegre etmek" genel gibi görünür, ancak pratikte üç şeye karar verirsiniz: iş akışınızda konuşmanın nerede oluşturulması gerektiği, hangi seslerin ve dillerin markanızı temsil edeceği ve sesin oluşturulması ile alınmasını ne kadar sıkı bir şekilde otomatikleştirdiğiniz.
Çok dilli içeriğe genişleyen bir YouTube içerik üreticisi için entegrasyon, genellikle API'mizi bir video planlama aracına veya betik veritabanına bağlamak anlamına gelir, böylece her tamamlanan betik doğru dil ve stilde bir seslendirmeye dönüşür. Küçük işletmeler ve pazarlama ekipleri için API tipik olarak bir CMS veya pazarlama otomasyon platformunun arkasında yer alır ve blog gönderilerini, ürün açıklayıcılarını ve sosyal medya metinlerini yeniden kullanılabilir ses varlıklarına dönüştürür. E-öğrenme ve kurumsal eğitim sağlayıcıları, API'yi yazma araçlarına bağlama eğilimindedir, böylece ders modülleri her slayt veya konu başına anlatı talep edebilir ve materyal güncellendiğinde onu anında yeniden oluşturabilir.
Sesli yapay zekayı daha derinlemesine entegre eden geliştiriciler ve ajanslar genellikle iki desen arasında seçim yapar. Bir toplu model betikleri toplar ve bunları zamanlanmış işler aracılığıyla işler. Bir işlemsel model, yeni içerik veya bir kullanıcı eylemi geldiğinde her seferinde anında bir istek tetikler. Proje tabanlı API'miz her ikisi için de temiz bir şekilde çalışır, çünkü her TTS projesi metni, ses seçimini, dili ve ortaya çıkan sesi kendi içerik birimlerinize—videolar, dersler veya podcast bölümlerine—eşlenen bir şekilde kapsüller. Hâlâ kavramın kendisini değerlendiriyorsanız, bir metin okuma API'sinin ne olduğu ve nasıl çalıştığına dair yardımcı açıklamamız, bir tasarıma bağlanmadan önce temelleri kapsar.
Metin Okuma API'miz kaputun altında nasıl çalışır
Metin Okuma API'miz projeler ve segmentler etrafında oluşturulmuştur, bu da onu tek bir "metin girer, ses çıkar" uç noktasından daha esnek yapar. Bir TTS projesi, bir veya daha fazla metin segmentini bir başlık ve dil ile varsayılan ses gibi paylaşılan bir yapılandırma altında gruplar. Her segment kendi metnini, ses tanımlayıcısını ve dil etiketini taşır, bu da tek bir çıktı içinde anlatı stillerini veya dilleri karıştırmanıza olanak tanır.
TTS proje uç noktasına gönderilen tipik bir JSON yükü, panolarınız ve günlükleriniz için insan tarafından okunabilir bir proje başlığı ile bir segment dizisi içerir. Her segment text (söylenecek betik veya cümle), voice (yerleşik bir ses ID'si veya Ses Klonlama API'si aracılığıyla oluşturulan özel bir ses ID'si) ve language (segmentin dilini gösteren bir kod) belirler.
Arka ucunuz bu yükü Authorization başlığında geçerli bir API anahtarıyla TTS uç noktasına gönderdiğinde, projeyi oluşturur ve arka planda ses işlemeye başlarız. API, işlemenin hâlâ devam edip etmediğini veya tamamlandığını bildiren bir proje durumu uç noktası sunar ve hazır olduğunda oluşturulan ses dosyalarına referanslar sağlar. Bu eşzamansız tasarım, kendi isteklerinizi hızlı tutar: proje ID'sini günlüğe kaydedin, kontrolü kullanıcıya geri döndürün ve bir arka plan çalışanının tamamlanmayı kontrol etmesine ve müsait olduğunda sesi indirmesine izin verin.
Oluşturulan konuşma, standart formatlarda, özellikle 22 kHz'de MP3 olarak indirilebilir dosyalar olarak gelir ve web oynatıcılarına, mobil uygulamalara ve video düzenleme zaman çizelgelerine kolayca oturur. Aynı motor tarayıcı tabanlı aracımızı çalıştırdığından, geliştiriciler sesleri ve betikleri etkileşimli olarak prototipleyebilir ve ardından kazanan kombinasyonları otomatik API çağrılarına taşıyabilir. Tam uç nokta referansı Metin Okuma API'si sayfasında bulunur.
Ses klonlama ve yapay zeka dublajını metin okumaya bağlama
Bizi tanımlayan özellik, Metin Okuma, Ses Klonlama ve Yapay Zeka Dublajının tek bir temel ses motorunu ve iş akışını paylaşmasıdır. Bu, TTS API'sinin izole olmadığı anlamına gelir—o, daha geniş bir yerelleştirme hattının çekirdeğidir.
Ses Klonlama API'si, bir konuşmacının ses örneklerini yüklemenize, özel bir yapay zeka sesi oluşturmanıza ve o sese TTS projelerinde referans vermenize olanak tanır. Özel bir ses var olduğunda, tanımlayıcısı Metin Okuma segmentlerinizde voice alanı olur, böylece anlatı genel bir stok ses yerine klonlanmış seste oynatılır. Bu süreklilik, diller ve formatlar genelinde tutarlı bir işitsel kimlik isteyen sunucular, podcaster'lar ve marka sözcüleri için önemlidir. Klonlama eklemeyi planlıyorsanız, uygulamanızda bir ses klonlama API'si entegre etme rehberimiz ayrıntıları kapsar.
Yapay Zeka Dublaj API'si, bunu transkripsiyon, çeviri ve metin okumayı videoları 33'ten fazla hedef dile dublajlayan tek bir hatta birleştirerek daha da genişletir. Burada TTS motoru, çevrilmiş betikleri aynı 300'den fazla ses kitaplığını veya klonlanmış sesinizi kullanarak sese dönüştürür, böylece dublajlanmış sürümler tonu ve zamanlamayı korur. Çok dilli içerik üreticileri ve işletmeler için Metin Okuma API'si hem tek dilli seslendirmeler hem de tamamen yerelleştirilmiş dublajlı içerik için yapı taşı haline gelir. Yapay zeka yerelleştirmesinin nasıl çalıştığına dair genel bakışımız, bu parçaların baştan sona nasıl bir araya geldiğini gösterir.
TTS API'mizi entegre ederken temel karar kriterleri
"Herhangi bir" TTS API'sini entegre etmek yeterli değildir; uygulama etrafındaki seçimler, üretiminize, markanıza ve teknik yığınınıza ne kadar iyi uyduğunu belirler.
Ölçek ve otomasyon ihtiyaçları. İçerik hacmi düşük ve düzensizse, tarayıcı tabanlı araç yeterli olabilir. Betikler düzenli olarak oluşturulduğunda veya içerik takvimlerine, öğrenme yönetim sistemlerine veya pazarlama otomasyonuna bağlandığında, API doğru katman haline gelir çünkü programatik olarak tetiklenebilir ve arka ucunuzla ölçeklenebilir.
Ses ve dil stratejisi. Platformumuz, TTS API'sinin kullandığı aynı ses motoruyla çalışan, 60'tan fazla kaynak dilden 33 hedef dile dublajı destekler. Markanızın ayırt edici bir sözcü sesine ihtiyacı varsa, Ses Klonlama API'sini TTS ile eşleştirmek, o sesi diller ve kanallar genelinde tutarlı tutar. Kişiselleştirme yerine hızı önceliklendiriyorsanız, yerleşik sesler uygulamayı daha basit tutar.
Yığınınızdaki entegrasyon noktası. YouTube kanalları için doğal bir nokta video hattıdır: betikler bir planlama aracında saklanır, tamamlandığında TTS API'sine gönderilir ve düzenleyiciler için hazır ses olarak döndürülür. E-öğrenme platformları ders veya slayt düzeyinde entegre olabilir, burada her içerik bloğu bir segmente eşlenir ve projeler tüm kursları temsil eder. Pazarlama ekipleri genellikle CMS düzeyinde entegre olur, böylece her makale veya ürün sayfası erişilebilirlik için bir ses sürümü talep edebilir.
Yönetişim, uyumluluk ve risk. Ses klonlama tanınabilir sesleri kopyalayabildiğinden, onay, lisanslama ve kullanım politikaları önemlidir. Klonlanmış sesler ID'lerle tanımlanır ve meta verilerle etiketlenebilir, bu da belirli seslerin nerede kullanılabileceğine dair dahili kuralları uygulamayı kolaylaştırır. Hangi ortamların klonlanmış sesleri mi yoksa genel sesleri mi tetikleyebileceğine önceden karar verin ve kendi sistemlerinize günlük kaydı ekleyin.
Gecikme ve kullanıcı deneyimi beklentileri. Eşzamansız işleme esneklik sunar ancak bir zamanlama düşüncesi ekler. Kullanıcıların anında oynatma beklediği iş akışları için—anında önizlemeli bir betik düzenleyicisi gibi—daha küçük projeler veya segmentler oluşturun ve ses işlenirken ilerleme göstergeleri gösterin. Tüm kitaplıklarda toplu yerelleştirme için gecikme daha az önemlidir ve işler zamanlamalar üzerinde çalışabilir ve tamamlanan ses daha sonra içerik kayıtlarına eklenebilir.
| Karar alanı | Toplu model | İşlemsel model |
|---|---|---|
| Tetikleyici | Zamanlanmış işler | İçerik öğesi veya kullanıcı eylemi başına |
| Gecikme toleransı | Yüksek | Düşük |
| En uygun | Kurs katalogları, video kitaplıkları | Betik düzenleyicileri, canlı önizlemeler |
| Ses stratejisi | Dil başına onaylı ses | Dil başına onaylı ses |
Riskler ve pratik önlemler
Bir metin okuma API'sini entegre etmek, düşünceli tasarımın azaltabileceği birkaç öngörülebilir risk getirir.
Sesleri test etmeden seçmek, bir marka veya sunucu için karakter dışı hissettiren konuşma üretebilir. Önce sesleri etkileşimli arayüzde deneyin ve API çağrılarında ses ID'lerini kodlamadan önce, kendi sistemlerinizde dil ve içerik türü başına düzenlenmiş onaylı bir ses kataloğu tutun.
Hassas içeriğin aşırı otomasyonu başka bir tuzaktır. Uyumluluk, tıbbi veya yasal materyal için konuşmayı otomatik olarak oluşturmak uygun olmayabilir. API'miz ayrı projeler ve segmentler üzerinde çalıştığından, hassas içeriği insan tarafından kaydedilen iş akışlarında tutarken yalnızca onaylı kategorileri TTS'ye gönderen yönlendirme kuralları sürdürebilirsiniz.
Operasyonel hatalar—başarısız projeler veya eksik indirmeler—ağ sorunları veya geçersiz yükler işlemeyi kesintiye uğrattığında meydana gelir. Proje durumu uç noktaları ve yapılandırılmış yanıtlar, yayınlamadan önce bir projenin tamamlandığını ve çıktılarının mevcut olduğunu onaylamanıza olanak tanır. Her TTS proje ID'sini kendi içerik ID'nizle eşleştirin ve durum kontrolleri hata bildirdiğinde yeniden denemeler veya yedekler uygulayın.
Klonlanmış seslerin kötüye kullanımı açık kontroller gerektirir. Özel sesler özel uç noktalar aracılığıyla oluşturulmalı ve ardından TTS projelerinde ID ile referans verilmelidir, bu da izlemeniz için net bir teknik sınır sağlar. Klonlanmış ses ID'lerini kimin oluşturabileceğini veya atayabileceğini kısıtlayın ve nerede kullanıldıklarını günlüğe kaydedin.
Pratik bir başlangıç yolu, önce standart seslendirmeler için TTS'yi entegre etmek, üretimde sesleri ve hata işlemeyi doğrulamak, ardından temel entegrasyon kararlı hale geldiğinde Ses Klonlama ve Yapay Zeka Dublajını katmanlar halinde eklemektir. İçerik hacminizi, hedef dillerinizi ve API'nin yığınınızda nerede yer alması gerektiğini bize söyleyin, biz de sizi doğru uç noktalara yönlendirebilir ve iş akışınız için plan yapabiliriz.
Sıkça sorulan sorular
Metin Okuma API'si tarayıcı aracından nasıl farklıdır?
Tarayıcı aracı, metin yapıştırdığınız, bir ses seçtiğiniz ve sesi manuel olarak indirdiğiniz görsel bir arayüzdür. API, aynı motoru REST uç noktaları aracılığıyla sunar, böylece arka ucunuz betiklere, zamanlamalara veya kullanıcı eylemlerine yanıt olarak sesi otomatik olarak oluşturabilir ve alabilir.
API yalnızca stok seslerde değil, kendi sesimde de konuşabilir mi?
Evet. Ses Klonlama API'sini entegre ederek, bir konuşmacının ses örneklerini yüklersiniz, özel bir yapay zeka sesi oluşturursunuz ve ardından o sesin ID'sine Metin Okuma segmentlerinizde referans verirsiniz, böylece oluşturulan tüm konuşma klonlanmış seste oynatılır.
Bu, çok dilli YouTube kanallarına veya podcast'lere nasıl yardımcı olur?
Platformumuz, TTS'nin 300'den fazla ses veya klonlanmış sesinizi kullanarak son sesi oluşturmasıyla, 60'tan fazla kaynak dilden gelen konuşma veya betikleri 33 hedef dilde dublajlanmış çıktıya dönüştürür. TTS ve Yapay Zeka Dublaj API'lerini yayınlama hattınıza bağlamak, betikler veya kaynak ses hazır olduğunda yeni videoların veya bölümlerin seslendirmeler veya tam dublajlar almasını sağlar.
Uygulamam veya düzenleyicim hangi ses formatlarını alacak?
TTS API'si, çoğu web, mobil ve video düzenleme ortamı için ekstra dönüştürme olmadan uygun olan, 22 kHz'de MP3 dahil yüksek kaliteli ses dosyaları sunar.
Şimdi Metin Okumayı entegre edip daha sonra Yapay Zeka Dublajı ekleyebilir miyim?
Evet. Metin Okuma, Ses Klonlama ve Yapay Zeka Dublajı ortak bir API ekosistemini paylaşır, böylece seslendirmeler için TTS ile başlayabilir ve çekirdek entegrasyonunuzu yeniden oluşturmadan çok dilli dublajı otomatikleştirmek için daha sonra Ses Klonlama ve Yapay Zeka Dublajı ekleyebilirsiniz.