การแปลเสียงเป็นเสียงจะเปลี่ยนคำพูดในภาษาหนึ่งให้เป็นเสียงพูดในอีกภาษาหนึ่ง ดังนั้นผู้ชมของคุณจะได้ยินคำแปลแทนที่จะอ่านมัน ลองนึกภาพผู้สอนที่บันทึกบทเรียนเป็นภาษาอังกฤษไว้ และตอนนี้ต้องการเวอร์ชันภาษาสเปนโดยไม่ต้องบันทึกใหม่: ระบบจะถอดความภาษาอังกฤษ แปลความหมาย และสร้างเสียงภาษาสเปนขึ้นมาแทนที่ การเปลี่ยนจากการอ่านไปสู่การฟังนี้คือประเด็นสำคัญทั้งหมด และมันเปลี่ยนวิธีที่คุณวางแผน ตรวจสอบ และเผยแพร่เนื้อหาหลายภาษา
คำถามที่แท้จริงแทบไม่ใช่ว่าเทคโนโลยีนี้ใช้งานได้หรือไม่ แต่เป็นว่าคุณต้องการเวอร์ชันไหน: การแปลแบบบันทึกไว้สำหรับวิดีโอ คอร์สเรียน และพอดแคสต์; การแปลแบบเกือบเรียลไทม์สำหรับการประชุมและงานอีเวนต์; เอาต์พุตที่รักษาเสียงซึ่งคงอัตลักษณ์ของผู้พูดต้นฉบับไว้; หรือ API ที่คุณสามารถเชื่อมต่อเข้ากับแอปพลิเคชันของคุณเองได้ แต่ละเส้นทางเหล่านั้นมีข้อแลกเปลี่ยนที่แตกต่างกันในด้านคุณภาพ ความหน่วง และความพยายามในการตรวจสอบ และคู่มือนี้จะชี้แนะเพื่อให้คุณเลือกได้อย่างรู้เท่าทัน
สารบัญ
การแปลเสียงเป็นเสียงทำงานอย่างไร
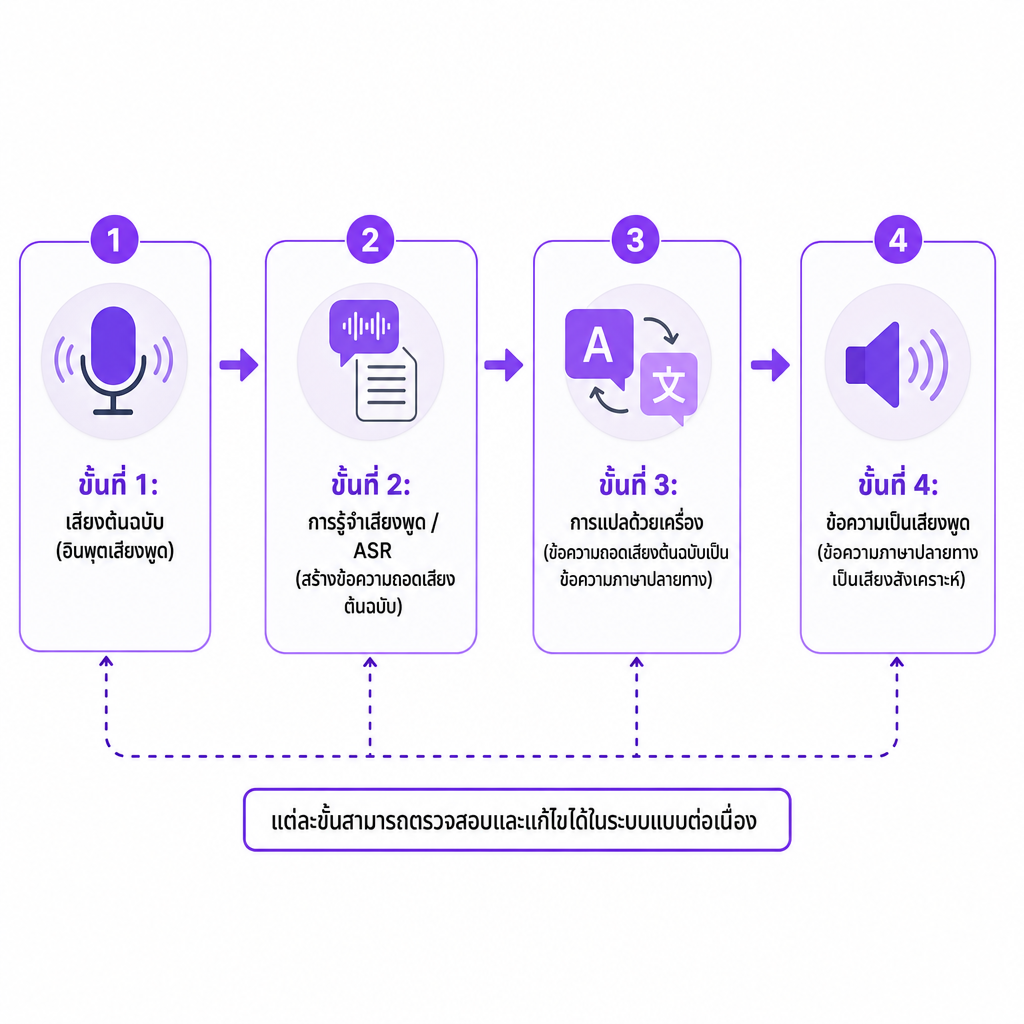
ระบบส่วนใหญ่ทำงานผ่านไปป์ไลน์ที่เชื่อมต่อกันของสามเทคโนโลยี ขั้นแรก การรู้จำเสียงพูดอัตโนมัติ (ASR) จะวิเคราะห์เสียงต้นฉบับและสร้างข้อความถอดความ ถัดมา การแปลด้วยเครื่องจะเปลี่ยนข้อความภาษาต้นฉบับนั้นให้เป็นภาษาเป้าหมาย สุดท้าย การแปลงข้อความเป็นเสียงจะเปลี่ยนข้อความที่แปลแล้วให้เป็นเสียงพูด กระบวนการนี้อ่านได้อย่างชัดเจนว่า เสียงต้นฉบับ แล้วการรู้จำ แล้วข้อความที่แปลแล้ว แล้วเสียงพูดที่สังเคราะห์ขึ้น
เสียงต้นฉบับ → การรู้จำเสียงพูด → ข้อความที่แปลแล้ว → เสียงพูดที่สังเคราะห์ขึ้น
การออกแบบแบบเป็นชั้นนี้เรียกว่าการแปลเสียงเป็นเสียงแบบต่อเนื่อง (cascaded) และสิ่งพิมพ์ของ NIST เกี่ยวกับการประเมินการแปลเสียงพูดอธิบายโครงสร้างเดียวกันนี้: ASR สร้างข้อความถอดความต้นฉบับ การแปลด้วยเครื่องสร้างข้อความภาษาเป้าหมาย และการแปลงข้อความเป็นเสียงสร้างเอาต์พุตเป็นเสียงพูด ข้อดีของระบบต่อเนื่องคือแต่ละขั้นตอนสามารถตรวจสอบได้ ดังนั้นคุณจึงสามารถแก้ไขข้อความถอดความหรือคำแปลก่อนที่จะสร้างเสียงได้เลย
แนวทางที่ใหม่กว่าจะฝึกโมเดลแบบ end-to-end ให้แมปเสียงต้นฉบับไปยังเสียงภาษาเป้าหมายโดยตรงโดยไม่เปิดเผยขั้นตอนการถอดความและการสังเคราะห์ที่แยกจากกัน งานวิจัยที่แบ่งปันผ่านรายงานทางเทคนิคของ DTIC เกี่ยวกับการแปลเสียงพูดโดยตรงนำเสนอสิ่งนี้เป็นวิธีลดความล่าช้าและรักษาเสียงของผู้พูดต้นฉบับได้มากขึ้น ขณะที่ระบุว่ามันยังคงมีข้อแลกเปลี่ยนในด้านความเร็ว บริบท ความครอบคลุมของภาษา และคุณภาพของเอาต์พุต ในทางปฏิบัติ ระบบต่อเนื่องให้การควบคุมด้านบรรณาธิการแก่คุณมากกว่า ส่วนแนวทาง end-to-end มุ่งเน้นความหน่วงที่ต่ำลงและความต่อเนื่องของเสียง
การแปลเสียงเป็นเสียงเทียบกับงานที่เกี่ยวข้อง
ผู้คนมักสับสนการแปลเสียงเป็นเสียงกับการถอดความ การแปลข้อความ และการพากย์เสียง แต่แต่ละอย่างจบลงด้วยผลลัพธ์ที่แตกต่างกัน การแปลข้อความหยุดอยู่ที่เอาต์พุตแบบลายลักษณ์อักษร การแปลเสียงเป็นเสียงจบลงด้วยเอาต์พุตเป็นเสียงพูด แม้ว่าระบบแบบต่อเนื่องจะยังคงใช้ข้อความภายในเป็นตัวแทนขั้นกลางก็ตาม การแยกแยะอินพุตและเอาต์พุตจะช่วยให้คุณไม่เลือกเครื่องมือผิดสำหรับงาน
| เทคโนโลยี | อินพุต | เอาต์พุต | การใช้งานทั่วไป |
|---|---|---|---|
| เสียงเป็นข้อความ | เสียงพูด | ข้อความถอดความ | คำบรรยาย บันทึก เนื้อหาที่ค้นหาได้ |
| การแปลข้อความ | ข้อความลายลักษณ์อักษร | ข้อความที่แปลแล้ว | เอกสาร คำบรรยายใต้ภาพ หน้าเว็บ |
| ข้อความเป็นเสียง | ข้อความลายลักษณ์อักษร | เสียงพูดสังเคราะห์ | การบรรยาย การเข้าถึง อินเทอร์เฟซด้วยเสียง |
| การแปลเสียงเป็นเสียง | เสียงพูด | เสียงพูดที่แปลแล้ว | บทสนทนา การพากย์เสียง สื่อหลายภาษา |
การพากย์เสียงสมควรได้รับการแยกแยะเป็นของตัวเอง การแปลเสียงเป็นเสียงมุ่งเน้นเฉพาะการเปลี่ยนภาษาพูด การพากย์เสียงเป็นเวิร์กโฟลว์การแปลสื่อให้เป็นท้องถิ่นที่กว้างกว่าซึ่งห่อหุ้มรอบมัน: การแปลบทสนทนา การกำหนดผู้พูด การสร้างเสียงใหม่ การปรับจังหวะเวลา การผสมเสียงที่แปลแล้วกับเพลงและเสียงพื้นหลัง และการส่งออกโปรเจกต์ที่เสร็จสมบูรณ์ สำหรับวิดีโอ YouTube ที่บันทึกไว้ คอร์สเรียนออนไลน์ พอดแคสต์ หรือภาพยนตร์ การพากย์เสียงมักเป็นรูปแบบที่ใช้งานได้จริงมากกว่า เพราะมันเพิ่มการควบคุมด้านบรรณาธิการเหล่านั้นเข้าไปบนตัวการแปล หากคุณกำลังชั่งน้ำหนักระหว่างเสียงกับข้อความบนหน้าจอ บทความอธิบายของเราเกี่ยวกับการพากย์เสียงเทียบกับคำบรรยายใต้ภาพสำหรับวิดีโอจะพาคุณผ่านการเลือกเฉพาะนั้น และกลไกที่กว้างกว่าอยู่ในคู่มือของเราเกี่ยวกับการพากย์เสียงด้วย AI คืออะไรและทำงานอย่างไร
สามองค์ประกอบที่ตัดสินคุณภาพ
คุณภาพของเอาต์พุตไม่ใช่ตัวเลขเพียงตัวเดียว มันเป็นผลลัพธ์ของสามขั้นตอน แต่ละขั้นตอนมีรูปแบบความล้มเหลวของตัวเอง ดังนั้นจึงเป็นประโยชน์ที่จะประเมินแต่ละขั้นแยกกันแทนที่จะเชื่อความประทับใจโดยรวม
การรู้จำเสียงพูดอัตโนมัติจะระบุคำในการบันทึกต้นฉบับ และความแม่นยำของมันจะลดลงเมื่อมีเสียงเพลงพื้นหลัง ผู้พูดที่พูดทับกัน สำเนียงที่หนัก การพูดที่เร็วหรือไม่สมบูรณ์ คำศัพท์เฉพาะทาง ไมโครโฟนที่ไม่ดี และการสลับภาษา (code-switching) ตัวชี้วัดที่พบบ่อยในที่นี้คืออัตราความผิดพลาดของคำ (WER) ซึ่งเปรียบเทียบข้อความถอดความอัตโนมัติกับข้อความอ้างอิงจากมนุษย์โดยการนับการแทนที่ การลบ และการแทรก สิ่งพิมพ์ของ NISTฉบับเดียวกันใช้ WER เป็นเกณฑ์มาตรฐานการรู้จำ แม้ว่า WER ที่ต่ำจะไม่ยืนยันว่าการแปลในภายหลังได้รักษาความหมายหรือน้ำเสียงไว้ หากเสียงต้นฉบับของคุณมีเสียงรบกวน การแยกเสียงพูดที่สะอาดออกมาก่อนด้วยเครื่องมืออย่างตัวแยกเสียงพูดของเราสามารถเพิ่มความแม่นยำในการรู้จำได้ก่อนที่การแปลจะเริ่มต้นเสียด้วยซ้ำ
การแปลด้วยเครื่องต้องตีความมากกว่าคำแต่ละคำ มันจัดการกับโครงสร้างประโยค บริบท คำสรรพนามและเพศ สำนวน อารมณ์ขัน ความเป็นทางการ การอ้างอิงทางวัฒนธรรม คำศัพท์ทางเทคนิค และความแตกต่างของลำดับคำ การแปลตามตัวอักษรอาจถูกต้องตามหลักไวยากรณ์แต่ฟังดูไม่เป็นธรรมชาติหรือเปลี่ยนความหมายที่ตั้งใจไว้อย่างเงียบ ๆ ซึ่งเสี่ยงเป็นพิเศษสำหรับข้อความโฆษณา คำสั่งทางกฎหมาย ข้อมูลทางการแพทย์ เนื้อหาทางการเงิน และสื่อการศึกษา
การสังเคราะห์เสียงพูดจะสร้างเสียงภาษาเป้าหมายขั้นสุดท้าย ควบคุมการออกเสียง การหยุดพัก อัตราการพูด น้ำเสียง การเน้น น้ำเสียงทางอารมณ์ อัตลักษณ์ของเสียง และสำเนียงหรือภาษาถิ่น ผลิตภัณฑ์ Text to Speech ของเรามีเสียง AI มากกว่า 300 เสียง การสร้างเสียงหลายภาษา และการโคลนเสียงใน 33 ภาษา พร้อมการควบคุมอัตราการพูด การเน้น การอ่านตัวเลข และการถ่ายทอดอารมณ์ การแปลที่ถูกต้องในทางเทคนิคก็ยังอาจได้ผลไม่ดีหากการถ่ายทอดไม่เหมาะกับแบรนด์ คอร์สเรียน หรือสารคดีที่มันเป็นส่วนหนึ่ง
การโคลนเสียงในคำพูดที่แปลแล้ว
การโคลนเสียงเป็นทางเลือก แต่มันคือสิ่งที่ทำให้เนื้อหาที่แปลแล้วรู้สึกเหมือนผู้สร้างคนเดิมแทนที่จะเป็นคนแปลกหน้าที่อ่านสคริปต์ แทนที่จะกำหนดเสียงสำเร็จรูปที่ไม่เกี่ยวข้องให้ทุกภาษา ระบบสามารถสร้างการแสดงภาษาเป้าหมายที่จำลองตามอัตลักษณ์เสียงของผู้พูดต้นฉบับได้ ความต่อเนื่องนั้นสำคัญสำหรับช่องที่ต้องการเสียงที่จดจำได้หนึ่งเสียงในทุกภาษา บริษัทที่มีผู้นำเสนอที่เป็นที่รู้จัก คอร์สเรียนที่นำโดยผู้สอนยาว ๆ ผู้สร้างภาพยนตร์ที่ต้องการความสม่ำเสมอข้ามเวอร์ชันพากย์เสียง หรือผู้จัดพอดแคสต์ที่คงเสียงที่คุ้นเคยไว้ในตอนที่แปลแล้ว
มันไม่ใช่การรับประกัน การโคลนรักษาอัตลักษณ์เสียงไว้ แต่อารมณ์ อารมณ์ขัน จังหวะ การออกเสียง และบริบททางวัฒนธรรมยังคงต้องการการตรวจทานจากมนุษย์ก่อนที่คุณจะเผยแพร่ สิ่งที่สำคัญเท่าเทียมกันคือการอนุญาต: เวิร์กโฟลว์ที่มีความรับผิดชอบจะยืนยันว่าผู้ที่จัดหาการบันทึกได้ยินยอมให้โคลน และเสียงที่ได้อาจถูกนำไปใช้สำหรับการจัดจำหน่ายเชิงพาณิชย์ สาธารณะ หรือทางภูมิศาสตร์ที่ตั้งใจไว้ หากคุณสงสัยเกี่ยวกับกลไกเบื้องหลังสิ่งนี้ ภาพรวมของเราเกี่ยวกับการโคลนเสียงทำงานอย่างไรจะเจาะลึกยิ่งขึ้น และเครื่องมือ Voice Cloning แสดงด้านการผลิต
การแปลแบบบันทึกไว้เทียบกับการแปลแบบเรียลไทม์
นี่คือการตัดสินใจที่ทีมส่วนใหญ่ต้องเผชิญจริง ๆ และทั้งสองโหมดไม่ควรถูกตัดสินด้วยไม้บรรทัดเดียวกัน
การแปลแบบบันทึกไว้มักเหมาะกับการผลิตสื่อมากกว่าเพราะมันให้เวลาคุณทำงาน คุณสามารถแก้ไขข้อความถอดความ ปรับแต่งคำศัพท์ ตรวจสอบคำแปล ระบุผู้พูด ปรับจังหวะเวลา สร้างเสียงใหม่ ผสมเสียงพื้นหลัง และดำเนินการประกันคุณภาพโดยมนุษย์ก่อนที่อะไรก็ตามจะถูกส่งออก สิ่งนี้ทำให้มันเหมาะอย่างยิ่งกับช่อง YouTube การเรียนรู้ออนไลน์ การฝึกอบรมองค์กร พอดแคสต์ วิดีโอผลิตภัณฑ์ และภาพยนตร์อิสระ
การแปลแบบเรียลไทม์ทำงานภายใต้ข้อจำกัดที่หนักกว่า: มันต้องเริ่มสร้างเอาต์พุตก่อนที่ผู้พูดจะพูดประโยคจบ บริบทที่มากขึ้นช่วยปรับปรุงคุณภาพการแปลแต่เพิ่มความล่าช้า ในขณะที่ความล่าช้าที่สั้นกว่าบังคับให้ต้องคาดเดาหรือแปลบางส่วน และข้อผิดพลาดยากที่จะเพิกถอนเมื่อเสียงได้เล่นไปแล้ว รายงานของ DTICระบุว่าระบบต่อเนื่องก่อนหน้านี้มักทำงานโดยมีความล่าช้าสี่ถึงห้าวินาที สะสมข้อผิดพลาดข้ามขั้นตอน และจำกัดการปรับแต่งเฉพาะบุคคล และการเพิ่มการมองไปข้างหน้า (lookahead) ของโมเดลสามารถเพิ่มคุณภาพได้ในขณะที่ทำให้การโต้ตอบรู้สึกฉับไวน้อยลง ฟีเจอร์การประชุมสดกับการพากย์เสียงหลายภาษาที่ขัดเกลาแล้วกำลังแก้ปัญหาที่แตกต่างกัน ดังนั้นจงวัดมันด้วยมาตรฐานที่ต่างกัน
วิธีประเมินเวิร์กโฟลว์การแปลเสียงเป็นเสียง
ทดสอบด้วยตัวอย่างที่เป็นตัวแทน ไม่ใช่ประโยคสาธิตที่เรียบร้อย รายการตรวจสอบด้านล่างสะท้อนสภาพจริงที่เนื้อหาของคุณจะต้องเจอ และมันทำให้การประเมินมีความซื่อตรง
- ความครอบคลุมของภาษาและสำเนียง: "รองรับภาษาสเปน" อาจไม่ได้หมายถึงสำเนียง คำศัพท์ หรือความชอบในระดับภูมิภาคที่ผู้ชมของคุณคาดหวัง ยืนยันเวอร์ชันต้นฉบับและเป้าหมาย รวมถึงภาษาอังกฤษแบบสหรัฐฯ เทียบกับแบบอื่น ภาษาสเปนแบบละตินอเมริกาเทียบกับแบบยุโรป และภาษาฝรั่งเศสแบบแคนาดาเทียบกับแบบยุโรป
- ความแม่นยำของข้อความถอดความ: การแปลไม่สามารถแก้ไขข้อความถอดความที่ทำชื่อ ตัวเลข หรือคำศัพท์ผลิตภัณฑ์พังได้อย่างเชื่อถือได้ ตรวจสอบว่าคุณสามารถตรวจสอบและแก้ไขข้อความถอดความก่อนสร้างเสียงได้หรือไม่
- ความหมายและบริบท: ทดสอบสำนวน มุกตลก คำกระตุ้นการกระทำ ข้อความโฆษณาผลิตภัณฑ์ และคำศัพท์เฉพาะอุตสาหกรรมอย่างตั้งใจ ความคล่องแคล่วไม่ใช่ความแม่นยำ
- การจัดการผู้พูด: สำหรับการสัมภาษณ์ การเสวนา และภาพยนตร์ ยืนยันว่าเครื่องมือสามารถระบุผู้พูดหลายคนและคงเสียงของพวกเขาให้สม่ำเสมอ รวมถึงเมื่อผู้คนขัดจังหวะกัน
- จังหวะเวลาและการซิงโครไนซ์: ประโยคที่แปลแล้วแทบไม่ตรงกับระยะเวลาต้นฉบับ มองหาการควบคุมจังหวะเวลาหรืออัตราการพูด พร้อมการแก้ไขบทสนทนา การรักษาเสียงพื้นหลัง การปรับระดับเสียง การสร้างเซกเมนต์ใหม่ และการจัดแนวภาพเมื่อจำเป็น
- ความเป็นธรรมชาติของเสียง: ฟังการออกเสียง การหยุดพัก การเน้น ช่วงอารมณ์ และจังหวะที่ไม่เป็นธรรมชาติ
- ความหน่วง: สำหรับการใช้งานสด วัดความล่าช้าจากผู้พูดถึงเสียง สำหรับการใช้งานแบบบันทึกไว้ ให้ความสำคัญกับความยืดหยุ่นในการแก้ไขมากกว่าความเร็วในการประมวลผลดิบ
- การควบคุมการตรวจทานและการส่งออก: เครื่องมือที่พร้อมใช้งานในการผลิตจะให้คุณแก้ไขข้อความ สร้างเซกเมนต์แต่ละส่วนใหม่ ปรับจังหวะเวลา และส่งออกในรูปแบบที่เวิร์กโฟลว์การเผยแพร่ของคุณยอมรับ
นำตัวอย่างเหล่านี้ผ่านรายชื่อที่คัดสรรของคุณและเปรียบเทียบความแม่นยำของข้อความถอดความ ความหมายของการแปล การออกเสียง ความเป็นธรรมชาติของเสียง ความสม่ำเสมอของผู้พูด จังหวะเวลา คุณภาพเสียงพื้นหลัง ความพยายามในการตรวจทาน และต้นทุนรวมที่ปริมาณที่คุณคาดหวัง ระบบที่แข็งแกร่งที่สุดไม่ใช่ระบบที่มีเสียงหรือภาษามากที่สุด แต่เป็นระบบที่ให้ผลลัพธ์ที่ยอมรับได้สำหรับเนื้อหาเฉพาะของคุณด้วยภาระงานตรวจทานที่ทีมของคุณสามารถรักษาไว้ได้จริง
ความเสี่ยงและข้อจำกัดที่ควรวางแผนไว้
ทุกขั้นตอนนำเสนอข้อผิดพลาดในแบบของตัวเอง และเสียงที่ฟังดูเป็นธรรมชาติสามารถอำพรางมันทั้งหมดได้ AI สามารถแปลสำนวนที่กำกวม ชื่อ สำนวน และคำศัพท์เฉพาะทางผิดได้ ดังนั้นการตรวจทานโดยมนุษย์ยังคงเป็นสิ่งจำเป็นในทุกที่ที่ความแม่นยำมีน้ำหนักทางกฎหมาย ความปลอดภัย การเงิน หรือชื่อเสียง ข้อผิดพลาดในการรู้จำทบทวีปัญหา: เสียงรบกวน การพูดทับกัน สำเนียง และการบันทึกที่ไม่ดีสามารถทำให้ระบบได้ยินต้นฉบับผิด ซึ่งเป็นเหตุผลว่าทำไมการตรวจสอบข้อความถอดความก่อนอนุมัติการแปลจึงเป็นสิ่งที่ต่อรองไม่ได้
ความหมายทางวัฒนธรรมสูญเสียไปได้ง่าย การแปลโดยตรงอาจทำให้อารมณ์ขัน ความสุภาพ หรือการอ้างอิงที่อยู่รอดได้ก็ต่อเมื่อเขียนใหม่มากกว่าการแปลคำต่อคำหายไป การโคลนเสียงเพิ่มความเสี่ยงด้านการยินยอมและการแอบอ้าง ดังนั้นจึงต้องบันทึกว่าใครอนุญาตเสียง ขอบเขตการใช้งาน อาณาเขต ระยะเวลา และว่าอาจปรากฏในโฆษณาหรือคำแถลงสาธารณะที่สังเคราะห์ขึ้นหรือไม่ นอกจากนี้ยังมีมิติด้านความไว้วางใจของผู้ชม: รายงานของ DTIC อธิบายว่าประสบการณ์การแปลหนึ่งแจ้งผู้ใช้ว่าเสียงที่แปลแล้วถูกสร้างขึ้นแบบสังเคราะห์ ซึ่งเป็นความคาดหวังที่สมเหตุสมผลที่ควรวางแผนไว้ในการเปิดเผยของคุณเอง
ความเสี่ยงที่เงียบกว่าสองประการปิดท้ายรายการ ความเป็นส่วนตัวมีความสำคัญทุกครั้งที่เสียงมีข้อมูลส่วนบุคคล การสนทนาที่เป็นความลับ ข้อมูลลูกค้า หรือเนื้อหาที่ยังไม่ได้เผยแพร่ ดังนั้นจึงควรตรวจสอบเงื่อนไขการจัดการข้อมูล การเก็บรักษา การเข้าถึง และการลบของผู้ให้บริการก่อนอัปโหลด และความมั่นใจที่ผิดพลาดคือความล้มเหลวที่ร้ายกาจที่สุด: เสียงที่ขัดเกลาทำให้การแปลที่ไม่ถูกต้องฟังดูน่าเชื่อถือ ดังนั้นอย่าถือว่าความคล่องแคล่วเป็นหลักฐานของความแม่นยำตามข้อเท็จจริง
DubSmart เหมาะกับตรงไหน
เราเกี่ยวข้องโดยตรงมากที่สุดกับการแปลเสียงเป็นเสียงแบบบันทึกไว้ผ่าน AI Dubbing มากกว่าการอ้างว่ารองรับการแปลการสนทนาสดแบบสากล เวิร์กโฟลว์การพากย์เสียงของเรารับการอัปโหลดเสียงและวิดีโอและลิงก์ YouTube รองรับภาษาต้นฉบับมากกว่า 60 ภาษาและภาษาเป้าหมาย 33 ภาษา โคลนเสียงของผู้พูดแต่ละคนสำหรับเวอร์ชันที่แปลแล้ว และให้คุณแก้ไขข้อความ ผู้พูด และจังหวะเวลา สร้างเซกเมนต์ใหม่ ปรับระดับเสียงพื้นหลัง และดาวน์โหลดโปรเจกต์ที่เสร็จสมบูรณ์ ชั้นบรรณาธิการนั้นคือสิ่งที่การผลิตสื่อแบบบันทึกไว้ต้องการพอดี
สำหรับทีมที่สร้างไปป์ไลน์ของตนเอง เรายังมี API สำหรับ AI Dubbing, Text to Speech และ Voice Cloning ซึ่งเหมาะกับเอเจนซี เวิร์กโฟลว์สื่อ และแอปพลิเคชันที่ต้องการทำการผลิตเสียงหลายภาษาแบบอัตโนมัติ การเลือกที่ถูกต้องขึ้นอยู่กับว่าโปรเจกต์ของคุณต้องการโปรแกรมแก้ไขสื่อที่เสร็จสมบูรณ์ ไปป์ไลน์ที่ขับเคลื่อนด้วย API หรือทั้งสองอย่าง สำหรับข้อความสั้น ๆ ที่มีความเสี่ยงสูง การแปลและการบันทึกโดยมนุษย์มืออาชีพอาจยังคงชนะ; สำหรับคลังเนื้อหาขนาดใหญ่ที่อัปเดตบ่อย เวิร์กโฟลว์ AI ขยายขนาดได้ดีกว่าโดยมีการตรวจทานของมนุษย์มุ่งเน้นไปที่สื่อที่มีความเสี่ยงสูงที่สุด
คำถามที่พบบ่อย
การแปลเสียงเป็นเสียงเหมือนกับการล่ามหรือไม่?
ไม่ การล่ามโดยมนุษย์อาศัยบุคคลที่ได้รับการฝึกฝนฟัง เข้าใจ และถ่ายทอดความหมายในขณะนั้น การแปลเสียงเป็นเสียงเป็นระบบอัตโนมัติ: รวดเร็วและขยายขนาดได้ แต่อาจต้องการการตรวจทานและอาจมีปัญหากับความละเอียดอ่อนที่ล่ามมืออาชีพจัดการได้อย่างเป็นธรรมชาติ
มันทำงานแบบเรียลไทม์เสมอหรือไม่?
ไม่ บางระบบประมวลผลเสียงที่บันทึกไว้โดยมีการควบคุมการแก้ไขแบบเต็มรูปแบบ ในขณะที่ระบบอื่นให้เอาต์พุตแบบสดหรือเกือบเรียลไทม์ ระบบสดต้องสร้างสมดุลระหว่างบริบทการแปล ความหน่วง และความแม่นยำอยู่ตลอดเวลา
มันสามารถรักษาเสียงของผู้พูดต้นฉบับได้หรือไม่?
บางครั้ง ระบบที่ใช้การโคลนเสียงหรือการสังเคราะห์ที่รักษาเสียงสามารถจำลองอัตลักษณ์ของผู้พูดต้นฉบับได้ แต่ผลลัพธ์ขึ้นอยู่กับเทคโนโลยี คู่ภาษา คุณภาพเสียง และการอนุญาตให้ใช้เสียงนั้น
การพากย์เสียงด้วย AI เป็นรูปแบบหนึ่งของการแปลเสียงเป็นเสียงหรือไม่?
ใช่ การพากย์เสียงด้วย AI เป็นการประยุกต์ใช้การแปลเสียงเป็นเสียงกับสื่อที่บันทึกไว้ซึ่งเพิ่มฟีเจอร์การแก้ไข การจัดการผู้พูด จังหวะเวลา การผสมเสียง และการส่งออกเข้าไปบนตัวการแปลหลัก
มันแม่นยำแค่ไหน?
ความแม่นยำแตกต่างกันไปตามภาษา คุณภาพการบันทึก คำศัพท์ ผู้พูด และระบบ ประเมินข้อความถอดความ การแปล และเสียงที่สร้างขึ้นแยกกันแทนที่จะเชื่อเปอร์เซ็นต์ความแม่นยำเพียงตัวเดียว