หากไมโครโฟนของคุณเก็บเสียงการจราจร เสียงพูดคุยในร้านกาแฟ หรือเสียงดนตรีที่ทับซ้อนอยู่บนบทสนทนาโดยตรง คำถามไม่ใช่ว่าการบันทึกนั้นใช้งานได้หรือไม่—แต่คือทำอย่างไรจึงจะดึงเสียงพูดกลับออกมาได้อย่างสะอาด นั่นคือสิ่งที่ตัวแยกเสียงพูด (speech separator) ทำได้พอดี พูดง่ายๆ ตัวแยกเสียงพูดคือเครื่องมือเสียงที่ขับเคลื่อนด้วย AI ซึ่งแยกเสียงพูดของมนุษย์ออกจากทุกสิ่งในการบันทึก—เสียงรบกวนพื้นหลัง เสียงดนตรี และเสียงอื่นๆ—เพื่อให้คุณเหลือแทร็กเสียงที่สะอาดที่สามารถถอดความ พากย์ โคลน หรือรีมิกซ์ได้ สำหรับใครก็ตามที่ผลิตเนื้อหาหลายภาษา แทร็กที่สะอาดนั้นคือความแตกต่างระหว่างการพากย์ที่ฟังดูเป็นมืออาชีพกับการพากย์ที่ฟังดู "พอใช้ได้"
คู่มือนี้อธิบายว่าตัวแยกเสียงพูดคืออะไรจริงๆ มันทำงานอย่างไรเบื้องหลัง เมื่อใดที่คุณต้องการมันจริงๆ และสิ่งใดที่ควรพิจารณาก่อนตัดสินใจเลือกเครื่องมือ เราสร้างตัวแยกเสียงพูด (Speech Separator) เข้าไปในเวิร์กโฟลว์ของ DubSmart AI ก็เพราะเสียงพูดที่สะอาดคือรากฐานที่ทุกสิ่งตั้งอยู่
สารบัญ
ตัวแยกเสียงพูดคืออะไรกันแน่
ในงานวิจัยด้านเสียง การแยกเสียงพูดถูกนิยามว่าเป็นงานของการแยกเสียงพูดเป้าหมายออกจากการรบกวนพื้นหลังในการบันทึกที่ผสมกัน ระบบที่ก้าวหน้ากว่านั้นไปไกลกว่าและแยกผู้พูดหลายคนออกจากกัน โดยสร้างแทร็กที่แยกออกมาสำหรับแต่ละเสียง
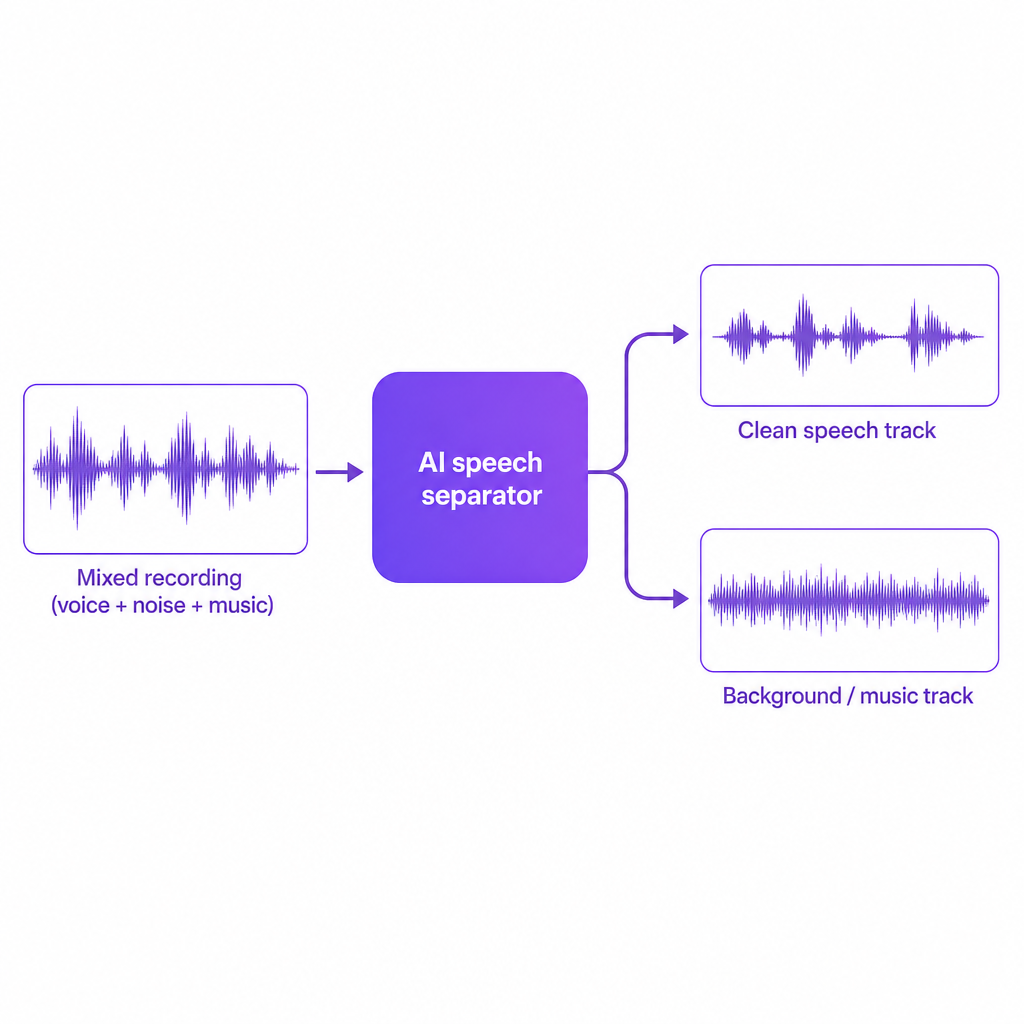
เมื่อแปลเป็นงานผลิตในชีวิตประจำวัน ตัวแยกเสียงพูดจะรับไฟล์เสียงที่ผสมกัน—บทสนทนาบวกกับเสียงรบกวนหรือเสียงดนตรี—และส่งออกแทร็กหนึ่งหรือหลายแทร็กที่มีเฉพาะเสียงพูด รวมทั้งแทร็กเสริมที่มีเสียงพื้นหลังที่เหลืออยู่ ตัวแยกเสียงพูดของเราถูกสร้างขึ้นเพื่อลบเสียงรบกวนพื้นหลังและแยกเสียงพูดออกจากการบันทึกใดๆ ซึ่งทำให้เหมาะกับงานหลังการผลิตของภาพยนตร์ พอดแคสต์ และการสัมภาษณ์ มันทำงานได้ทั้งไฟล์เสียงและวิดีโอ: สามารถลดเสียงรบกวนจากการบันทึกในสภาพแวดล้อมที่มีเสียงดัง และแยกเสียงร้องออกจากแทร็กประกอบ ทำให้คุณได้เสียงพูดและเสียงพื้นหลังที่แยกจากกัน
นี่คือจุดที่ความเข้าใจผิดที่พบบ่อยทำให้ผู้คนสะดุด ตัวแยกเสียงพูดไม่ใช่สิ่งเดียวกับการลดเสียงรบกวนแบบดั้งเดิม การลดเสียงรบกวนทำให้ระดับเสียงของเสียงที่ไม่ต้องการลดลง ส่วนตัวแยกเสียงพูดจะระบุอย่างจริงจังว่าเสียงพูดอยู่ที่ใดในสัญญาณและสร้างขึ้นใหม่เป็นสตรีมที่แยกออกมาและสะอาดกว่า ความแตกต่างนี้คือเหตุผลที่ตัวแยกเสียงสามารถกู้เสียงที่ถูกฝังอยู่ใต้เสียงดนตรีได้ ในขณะที่ตัวกั้นเสียงรบกวน (noise gate) ส่วนใหญ่ทำได้เพียงทำให้การบันทึกทั้งหมดเงียบลง
คุณจำเป็นต้องใช้มันจริงๆ หรือไม่?
การตัดสินใจที่แท้จริงคือว่างานของคุณขึ้นอยู่กับเสียงพูดที่สะอาดและเชื่อถือได้หรือไม่ มากกว่าอะไรก็ตามที่ไมโครโฟนบังเอิญเก็บมาได้ หากใช่ ตัวแยกเสียงเฉพาะทางก็เลิกเป็นแค่ของที่มีก็ดี และกลายเป็นขั้นตอนพื้นฐาน
สถานการณ์หลายอย่างทำให้การอัปเกรดนั้นชัดเจน ครีเอเตอร์ YouTube และธุรกิจขนาดเล็กมักใช้ฟุตเทจเก่าที่บันทึกในห้องที่มีเสียงก้อง ร้านกาแฟ หรือบนถนนซ้ำ ซึ่งเสียงรบกวนทำให้เสียงพูดเข้าใจยากและถอดความยาก ทีม e-learning และการฝึกอบรมสร้างคอร์สหลายภาษาจากเว็บบินาร์และการบรรยายสด ซึ่งการถอดความและการพากย์ทุกขั้นตอนที่ตามมาจะสืบทอดคุณภาพของเสียงพูดต้นฉบับ ผู้สร้างภาพยนตร์และผู้ผลิตพอดแคสต์มักจำเป็นต้องกู้การแสดงที่ยอดเยี่ยมที่บันทึกในสภาพที่ไม่สมบูรณ์แบบก่อนที่จะผสมกลับเข้ากับเสียงดนตรีและการออกแบบเสียง และนักพัฒนาหรือเอเจนซี่ที่ป้อนเสียงของผู้ใช้เข้าสู่ไปป์ไลน์การถอดความ การโคลนเสียง หรือการพากย์รู้ดีว่าอินพุตที่มีเสียงรบกวนทำให้ความแม่นยำของโมเดลลดลงโดยตรง
ตัวกระตุ้นที่เป็นรูปธรรมสองสามอย่างบ่งชี้ว่าตัวแยกเสียงคุ้มค่าที่จะนำมาใช้:
- คุณกำลังทำการแปลเป็นหลายภาษาและต้องการการพากย์และคำบรรยายที่ชัดเจนและสม่ำเสมอ เสียงพูดที่สะอาดป้อนเข้าสู่เอนจิน AI Dubbing และ Speech to Text ของเราได้อย่างน่าเชื่อถือกว่าเสียงที่ผสมกันแบบมีเสียงรบกวนมาก
- คุณพึ่งพาการโคลนเสียงสำหรับเสียงแบรนด์หรือเสียงตัวละคร และต้องการผลลัพธ์ที่ดีที่สุดโดยการฝึกจากตัวอย่างที่ลดเสียงรบกวนและปราศจากสิ่งแปลกปลอม
- คุณได้รับการบันทึกที่ผู้ใช้สร้างขึ้นหรือการบันทึกภาคสนามที่คุณไม่ได้ควบคุมอยู่เป็นประจำ และคุณยังต้องการให้พร้อมสำหรับการออกอากาศ ตัวแยกเสียงให้ขั้นตอนการทำความสะอาดที่ทำซ้ำได้แทนที่จะปรับแต่งทุกไฟล์ด้วยมือ
ข้อยกเว้นตามตรง: หากเสียงของคุณบันทึกในสตูดิโอที่ปรับสภาพแล้ว โดยมีแทร็กแยกสำหรับบทสนทนาและเสียงดนตรี ตัวแยกเสียงก็เป็นความสะดวกมากกว่าความจำเป็น สำหรับทุกคนที่ทำงานกับเสียงในโลกจริง มันสมควรได้ตำแหน่งถาวรในไปป์ไลน์
การแยกเสียงพูดทำงานอย่างไรเบื้องหลัง
การแยกเสียงพูดสมัยใหม่สร้างขึ้นบนการเรียนรู้เชิงลึกและงานวิจัยด้านการแยกแหล่งเสียง ไม่ใช่แค่ EQ และฟิลเตอร์ธรรมดา งานพื้นฐานนั้นระบุได้ง่ายแต่แก้ยาก: เมื่อได้สัญญาณที่ผสมกันซึ่งมีหลายแหล่ง จงกู้สัญญาณเสียงพูดแต่ละอันโดยไม่รู้ล่วงหน้าว่ามันคืออะไร
ระบบปัจจุบันส่วนใหญ่ปฏิบัติตามไปป์ไลน์ encoder–separator–estimator–decoder ตัว encoder จับคู่คลื่นเสียงดิบหรือสเปกโตรแกรมเข้าสู่พื้นที่คุณลักษณะมิติสูงซึ่งรูปแบบที่เกี่ยวข้องกับเสียงพูด เช่น ฟอร์แมนต์และฮาร์โมนิก จะตรวจจับได้ง่ายขึ้น ตัว separator—โครงข่ายประสาทเทียม—ประมวลผลคุณลักษณะเหล่านั้นและเรียนรู้ที่จะแยกข้อมูลที่เป็นของแหล่งเสียงต่างๆ ออกจากกัน ไม่ว่าจะเป็นเสียงพูดกับเสียงรบกวน หรือผู้พูดคนหนึ่งกับอีกคนหนึ่ง ขั้นตอนการประมาณค่าจากนั้นจะทำนายมาสก์ที่กรองส่วนประกอบที่ไม่ใช่เสียงพูดออก หรือประมาณการนำเสนอคุณลักษณะของแต่ละแหล่งโดยตรง สุดท้าย ตัว decoder จะแปลงการนำเสนอที่แยกออกเหล่านั้นกลับเป็นเสียงในโดเมนเวลา ทำให้ได้แทร็กเสียงพูดที่สะอาดหนึ่งแทร็กหรือมากกว่า และอาจมีแทร็กเสียงพื้นหลังที่เหลืออยู่
โมเดลเหล่านี้ถูกฝึกบนชุดข้อมูลขนาดใหญ่ที่เต็มไปด้วยการผสมของเสียงพูดและเสียงรบกวน เรียนรู้รูปแบบเชิงแยกแยะของเสียงพูด ผู้พูด และการรบกวนจากตัวอย่างที่มีป้ายกำกับ งานวิจัยใหม่ๆ ปรับตัว separator โดยอิงจากการฝังตัวของผู้พูด (speaker embeddings) หรือพร้อมต์ ซึ่งทำให้สามารถเล็งการแยกไปที่เสียงเฉพาะภายในเสียงที่แออัดได้
สิ่งที่ครีเอเตอร์ควรนำไปใช้ในทางปฏิบัติคือ ตัวแยกเสียงสมัยใหม่ไม่ใช่ตัวกั้นเสียงรบกวนที่ยกระดับขึ้น มันคือโมเดลที่เรียนรู้ว่าเสียงพูดมีลักษณะและเสียงเป็นอย่างไรในหลายๆ สภาพ และมันสามารถสร้างเสียงขึ้นใหม่ได้แม้ว่าจะถูกฝังอยู่ใต้เสียงดนตรี เสียงฝูงชน หรือเสียงก้องในห้อง
งานแยกเสียงหลักสองประเภท
ในทางปฏิบัติ คุณจะพบการแยกเสียงพูดสองรูปแบบ และแพลตฟอร์มมักผสมผสานทั้งสองเข้าด้วยกัน
แบบแรกคือเสียงพูดผู้พูดคนเดียวกับเสียงพื้นหลัง: การแยกแทร็กเสียงที่ต่อเนื่องหนึ่งเสียงออกจากเสียงรบกวน เสียงดนตรี หรือบรรยากาศ นี่คืองานที่ตัวแยกเสียงพูดของเราให้ความสำคัญเป็นหลักสำหรับภาพยนตร์ พอดแคสต์ และการสัมภาษณ์ เพราะมันตรงกับสิ่งที่ครีเอเตอร์ส่วนใหญ่ต้องการในแต่ละวัน
แบบที่สองคือการแยกผู้พูดหลายคน ซึ่งระบบจะสร้างแทร็กแยกสำหรับผู้พูดแต่ละคนในการสนทนา นั่นมีประโยชน์อย่างยิ่งสำหรับการแยกผู้พูด (diarization) และการวิเคราะห์ในการประชุมแบบยาวหรือการอภิปรายกลุ่ม ที่การรู้ว่าใครพูดอะไรสำคัญพอๆ กับสิ่งที่พูด
เครื่องมือสำหรับผู้บริโภคมักบรรจุสิ่งเหล่านี้ในอินเทอร์เฟซที่เรียบง่าย—อัปโหลดเพลงเพื่อให้ได้แทร็กเสียงร้องและดนตรีแยกจากกัน หรือแยกบทสนทนาในวิดีโอเพื่อการตัดต่อ การนำไปใช้ของเราเน้นการแยกเสียงพูดกับเสียงพื้นหลัง เพราะมันเป็นงานที่มีคุณค่าโดยตรงที่สุดสำหรับเวิร์กโฟลว์การพากย์ การถอดความ และการโคลน
สิ่งที่ควรพิจารณาก่อนเลือกตัวแยกเสียง
เมื่อคุณประเมินว่าตัวแยกเสียงตอบสนองความต้องการระดับมืออาชีพหรือไม่ เกณฑ์ไม่กี่ข้อสำคัญกว่าข้อความโฆษณา
เริ่มด้วยคุณภาพเสียงพูดและสิ่งแปลกปลอม ตัวแยกเสียงที่ดีจะรักษาโทนเสียงตามธรรมชาติของเสียงไว้แทนที่จะทำให้ฟังดูเป็นโลหะ เหมือนอยู่ใต้น้ำ หรือมีเสียงเฟส และหลีกเลี่ยงการนำเสียงรบกวนแบบดนตรี (musical noise) หรือการบิดเบือนที่รุนแรงเข้ามาเมื่อมันถอดองค์ประกอบพื้นหลังที่แรง เช่น เสียงดนตรี งานสำรวจทางวิชาการชี้ว่าการรบกวนที่หลงเหลือและสิ่งแปลกปลอมเป็นความท้าทายหลัก โดยเฉพาะในเสียงรบกวนที่ไม่คงที่ การทดสอบที่น่าเชื่อถือที่สุดยังคงเป็นการตรวจสอบผลลัพธ์ตัวอย่างจากเนื้อหาของคุณเอง
ความทนทานต่อเสียงรบกวนในโลกจริงมาเป็นอันดับต่อไป โมเดลที่ฝึกจากข้อมูลห้องแล็บที่สะอาดอาจมีปัญหากับเสียงการจราจร ลม เสียงพึมพำของฝูงชน ห้องที่มีเสียงก้อง และเนื้อหาที่เสียงพูดทับซ้อนกับเสียงดนตรีหรือเอฟเฟกต์ที่ดัง งานล้ำสมัยมุ่งเป้าไปที่การผสมที่ซับซ้อนเหล่านี้พอดี แต่ประสิทธิภาพยังคงแตกต่างกันไปตามสภาพการบันทึก—ดังนั้นจงทดสอบในสภาพแวดล้อมต่างๆ ที่คุณบันทึกจริง ตั้งแต่สำนักงานไปจนถึงถนนและสตูดิโอที่บ้าน
การจัดการกับเสียงดนตรีและเนื้อหาผสมเป็นความต้องการเฉพาะที่พบบ่อย การลบเพลงประกอบเพื่อพากย์ใหม่ หรือการแยกเสียงบรรยายออกจาก B-roll ต้องการเครื่องมือที่รองรับการแยกเสียงดนตรีและเสียงพูดอย่างชัดเจน และส่งออกไฟล์ที่ใช้งานได้สองไฟล์แทนที่จะเป็นผลลัพธ์อู้อี้ไฟล์เดียว ไปป์ไลน์การแยกเสียงของเราตรวจจับความถี่ของเสียงร้อง แยกออกจากเสียงดนตรี และสร้างไฟล์คุณภาพสูงที่แยกจากกัน: ไฟล์หนึ่งมีเสียงร้องที่สะอาดและอีกไฟล์มีเสียงดนตรีประกอบ นั่นมีประโยชน์อย่างยิ่งเมื่อคุณวางแผนที่จะรีมิกซ์ ใส่ดนตรีใหม่ หรือพากย์ใหม่เป็นภาษาอื่น
การผสานรวมกับเครื่องมือปลายทางกำหนดว่าตัวแยกเสียงช่วยประหยัดเวลาได้จริงมากเพียงใด การแยกเสียงแทบไม่เคยอยู่โดดเดี่ยว—มันป้อนโมเดลการถอดความที่อินพุตที่สะอาดกว่าช่วยลดอัตราความผิดพลาดของคำ เอนจินการโคลนเสียงที่ให้ผลตอบแทนจากตัวอย่างที่ปราศจากเสียงรบกวน และระบบการพากย์ที่จัดเรียงเสียงพูดต้นฉบับให้ตรงกับแทร็กที่แปลแล้ว แพลตฟอร์มของเราสร้างขึ้นรอบเวิร์กโฟลว์ที่เป็นหนึ่งเดียวที่รวม Speech Separator, Speech to Text, Text to Speech, Voice Cloning และ AI Dubbing ไว้ในที่เดียว เพื่อให้การบันทึกที่ทำความสะอาดแล้วหนึ่งไฟล์สามารถกลายเป็นเนื้อหาหลายภาษา เสียงโคลน และแปลเป็นภาษาท้องถิ่นได้อย่างสมบูรณ์ โดยไม่ต้องสร้างไปป์ไลน์ใหม่ในแต่ละครั้ง
ความหน่วง ขนาด และการทำงานอัตโนมัติสำคัญสำหรับใครก็ตามที่มีงานค้าง พอดแคสต์แบบยาว คอร์ส และคลังข้อมูลต้องการการประมวลผลแบบชุด (batch) ที่จัดการไฟล์ที่ยาวหลายชั่วโมง เวลาประมวลผลต่อไฟล์ที่สมเหตุสมผล และตัวเชื่อมการทำงานอัตโนมัติที่การแยกเสียงอยู่ภายในระบบของคุณเอง เราให้ API สำหรับ Text to Speech, Voice Cloning และ AI Dubbing เพื่อให้นักพัฒนาสามารถเชื่อมโยงการประมวลผลเสียงเข้าสู่ไปป์ไลน์แบบครบวงจร
สุดท้าย ความเป็นส่วนตัวและการปฏิบัติตามข้อกำหนดไม่ได้หายไปเมื่อเสียงสะอาด การแยกเสียงพูดออกจากเสียงพื้นหลังไม่ได้ลบความรับผิดชอบของคุณต่อการบันทึกที่อาจมีบทสนทนาที่ละเอียดอ่อน หรือต่อการเคารพสิทธิ์เมื่อคุณแยกและนำเสียงจากเนื้อหาที่มีลิขสิทธิ์กลับมาใช้ ทีมองค์กรควรยืนยันนโยบายที่ชัดเจนเกี่ยวกับการเก็บและการใช้ข้อมูล และจัดเวิร์กโฟลว์การแยกเสียงใดๆ ให้สอดคล้องกับแนวทางการปฏิบัติตามข้อกำหนดภายใน
ข้อจำกัดของมัน
ตัวแยกเสียงพูดสามารถเปลี่ยนโฉมการบันทึกได้ แต่มันไม่ใช่เวทมนตร์ และการทำเป็นว่าเป็นเช่นนั้นนำไปสู่การตัดสินใจที่ไม่ดี
การลดเสียงรบกวนมากเกินไปเป็นกับดักที่พบบ่อยที่สุด การแยกเสียงที่รุนแรงสามารถถอดสัญญาณเสียงพูดที่ละเอียดอ่อน—พยัญชนะที่เบา เสียงห้องตามธรรมชาติ—และทำให้เสียงฟังดูไม่เป็นธรรมชาติหรือเหนื่อยล้าเมื่อฟัง สิ่งแปลกปลอมที่หลงเหลือคือด้านตรงข้าม: ในสภาพที่ยากลำบาก โมเดลอาจทิ้งร่องรอยของเสียงดนตรีหรือเสียงรบกวนไว้ในแทร็กเสียงพูด หรือสร้างเสียงรบกวนแบบดนตรี โดยเฉพาะเมื่อการรบกวนแรงและเปลี่ยนแปลงอยู่ตลอดเวลา
ยังมีอคติต่อผู้พูดและภาษาที่ต้องคำนึงถึง โมเดลที่ฝึกส่วนใหญ่บนภาษา สำเนียง หรือรูปแบบการพูดบางอย่างอาจทำงานได้แย่ลงกับเสียงที่มีตัวแทนน้อย และคลื่นเสียงที่ดูสะอาดสามารถสร้างความรู้สึกปลอดภัยลวงตา: มันไม่ได้รับประกันว่าเสียงเหมาะสมสำหรับงานสำคัญ เช่น การวิเคราะห์ทางนิติวิทยาศาสตร์หรือบริบทการปฏิบัติตามข้อกำหนดที่เข้มงวด
สำหรับงานสร้างสรรค์และการแปลเป็นภาษาท้องถิ่น ข้อจำกัดเหล่านี้จัดการได้ แต่มันเป็นข้อโต้แย้งที่หนักแน่นสำหรับการทดสอบด้วยตัวอย่างที่เป็นตัวแทนของเนื้อหาของคุณเองแทนที่จะเชื่อการสาธิตของผู้จำหน่าย
ตัวแยกเสียงพูดภายในเวิร์กโฟลว์ของเรา
เราถือว่าตัวแยกเสียงพูดเป็นการนำเทคโนโลยีนี้ไปใช้อย่างเป็นประโยชน์และเป็นมิตรกับครีเอเตอร์ ผสานรวมอย่างแน่นแฟ้นกับส่วนที่เหลือของแพลตฟอร์ม DubSmart AI แทนที่จะเป็นสิ่งที่ยัดเยียดเข้าไป
ในการใช้งาน มันลบเสียงรบกวนพื้นหลังและแยกเสียงพูดออกจากการบันทึกใดๆ สร้างเสียงที่สะอาดเหมาะสำหรับงานหลังการผลิตในภาพยนตร์ พอดแคสต์ และการสัมภาษณ์ มันแยกเสียงร้องที่ชัดเจนออกจากแทร็กที่ผสมกันและสร้างไฟล์คุณภาพสูงที่แยกจากกันสำหรับเสียงพูดและเสียงดนตรีพื้นหลัง เพื่อให้คุณสามารถตัดต่อ พากย์ใหม่ หรือรีมิกซ์ได้โดยไม่ต้องต่อสู้กับเสียงที่ผสมกันต้นฉบับ มันทำงานได้ทั้งแหล่งเสียงและวิดีโอ—คุณอัปโหลดไฟล์หรือใช้ลิงก์ ประมวลผลผ่านไปป์ไลน์ และดาวน์โหลดแทร็กที่เสร็จสมบูรณ์ และที่สำคัญ ผลลัพธ์เหล่านั้นได้รับการปรับให้เหมาะสมเพื่อป้อนเครื่องมืออื่นๆ ของเรา เพื่อให้การบันทึกที่ทำความสะอาดแล้วหนึ่งไฟล์สามารถเปลี่ยนเป็นเนื้อหาหลายภาษา เสียงโคลน และแปลเป็นภาษาท้องถิ่นได้อย่างสมบูรณ์
สำหรับครีเอเตอร์ YouTube ธุรกิจขนาดเล็ก ผู้ฝึกอบรม ผู้สร้างภาพยนตร์ ผู้ทำพอดแคสต์ และทีมนักพัฒนา การผสานรวมนั้นเปลี่ยนบทบาทของการแยกเสียงเอง มันเลิกเป็นงาน "แก้ไขเสียง" ที่โดดเดี่ยวและกลายเป็นขั้นตอนมาตรฐานแรกในวงจรชีวิตการสร้างและแปลเนื้อหาที่ใหญ่ขึ้นและอัตโนมัติ หากคุณกำลังสร้างช่องหรือคลังคอร์สหลายภาษา นั่นคือจุดที่การประหยัดเวลาที่แท้จริงทวีคูณ
คำถามที่พบบ่อย
ตัวแยกเสียงพูดคืออะไรแบบง่ายๆ?
มันคือเครื่องมือ AI ที่รับการบันทึกที่มีเสียงรบกวนและผสมกัน และส่งออกแทร็กที่คุณส่วนใหญ่จะได้ยินเฉพาะเสียงมนุษย์ รวมทั้งแทร็กพื้นหลังเสริมที่คุณสามารถเก็บหรือทิ้งได้
ตัวแยกเสียงพูดเหมือนกับการลดเสียงรบกวนหรือไม่?
ไม่ การลดเสียงรบกวนเพียงแค่ทำให้เสียงที่ไม่ต้องการเบาลง การแยกเสียงพูดระบุและสร้างเสียงพูดขึ้นใหม่อย่างชัดเจนในฐานะแหล่งที่แยกออก โดยปกติจะมีความชัดเจนสูงกว่าและควบคุมผลลัพธ์ได้มากกว่า
ตัวแยกเสียงพูดจัดการกับผู้พูดมากกว่าหนึ่งคนได้หรือไม่?
ระบบระดับงานวิจัยหลายระบบและผลิตภัณฑ์บางอย่างสามารถแยกผู้พูดหลายคนเป็นแทร็กแยกได้ แม้ว่าคุณภาพจะแตกต่างกันไปตามการทับซ้อนและสภาพการบันทึก ตัวแยกเสียงพูดของเราเน้นเป็นหลักที่การแยกเสียงพูดออกจากเสียงพื้นหลังสำหรับเวิร์กโฟลว์ทั่วไปของครีเอเตอร์
การใช้ตัวแยกเสียงพูดจะช่วยปรับปรุงผลลัพธ์การพากย์และการโคลนเสียงของฉันหรือไม่?
ใช่ อินพุตเสียงที่สะอาดกว่าโดยทั่วไปจะปรับปรุงการรู้จำเสียงพูด การจัดเรียง และคุณภาพการโคลนเสียง ซึ่งทำให้การพากย์หลายภาษาและเสียงที่โคลนแล้วเป็นธรรมชาติและสม่ำเสมอมากขึ้น
การแยกเสียงพูดทำงานได้ไม่ว่าจะเป็นภาษาใดหรือไม่?
โมเดลตัวแยกเสียงส่วนใหญ่ทำงานบนรูปแบบเสียง (acoustic patterns) มากกว่าข้อความ ดังนั้นจึงสามารถจัดการได้หลายภาษา ประสิทธิภาพยังคงขึ้นอยู่กับข้อมูลการฝึกและว่าสำเนียงของคุณมีตัวแทนดีเพียงใด