หากคุณกำลังพิจารณา voiceforge text to speech สำหรับโปรเจกต์ คำถามที่แท้จริงมักไม่ใช่ว่าเสียงฟังดูน่าสนใจหรือไม่ แต่เป็นว่าเครื่องมือนี้เหมาะกับความยาวสคริปต์ของคุณ สิทธิในการเผยแพร่ของคุณ และประเภทของเนื้อหาที่คุณสร้างจริง ๆ หรือไม่ VoiceForge เป็นบริการแปลงข้อความเป็นเสียงบนเบราว์เซอร์ที่สร้างขึ้นรอบ ๆ เสียงตัวละครที่มีเอกลักษณ์ มันแปลงสคริปต์เป็นไฟล์เสียงที่ดาวน์โหลดได้โดยใช้เอนจิ้นการสังเคราะห์แบบ unit-selection ที่เย็บต่อส่วนเสียงพูดที่บันทึกจากผู้พูดจริงเข้าด้วยกัน แทนที่จะสร้างทุกเสียงจากคลื่นสัญญาณทางคณิตศาสตร์เพียงอันเดียว การตัดสินใจเชิงปฏิบัติสรุปลงที่ความต้องการสี่อย่าง ได้แก่ เสียงที่สนุกและจดจำได้สำหรับโปรเจกต์ส่วนตัว เสียงที่มีลิขสิทธิ์สำหรับสื่อที่สร้างรายได้ การควบคุมการออกเสียงและจังหวะอย่างแม่นยำ หรือเวิร์กโฟลว์หลายภาษาที่ปรับขยายได้ มีเพียงสามข้อแรกเท่านั้นที่เข้ากันได้อย่างชัดเจนกับเครื่องสร้างเสียงตัวละคร และช่องว่างนั้นเองที่ทำให้ครีเอเตอร์ส่วนใหญ่สะดุด
เราเผยแพร่คู่มือนี้เพราะความสับสนแบบเดียวกันเกิดขึ้นครั้งแล้วครั้งเล่า ผู้คนสร้างเสียงในช่วงทดลองใช้ฟรี คิดว่าพวกเขาสามารถสร้างรายได้จากมัน แล้วก็มาพบว่าลิขสิทธิ์ผูกติดกับแพ็กเกจเฉพาะ ด้านล่างนี้ เราจะแยกแยะว่าเอนจิ้นทำงานอย่างไร มันทำอะไรได้และทำอะไรไม่ได้ และเมื่อใดที่เครื่องมือเสียงเดี่ยวแบบแปลกใหม่คือตัวเลือกที่ถูกต้องเมื่อเทียบกับเวิร์กโฟลว์การแปลเป็นภาษาท้องถิ่นแบบเต็มรูปแบบ
สารบัญ
VoiceForge text to speech คืออะไรจริง ๆ
VoiceForge เปลี่ยนคำที่เขียนให้กลายเป็นเสียงพูด คุณใส่สคริปต์ เลือกเสียง สร้างคลิป ฟังตัวอย่าง และดาวน์โหลดผลลัพธ์เมื่อแพ็กเกจของคุณอนุญาต สิ่งที่ทำให้มันแตกต่างจากคลังเสียงบรรยายทั่วไปคือแนวทางของมัน VoiceForge เอนไปทางเสียงที่มีบุคลิกมากกว่าการนำเสนอแบบองค์กรที่เป็นกลาง ซึ่งทำให้มันเหมาะกับสเก็ตช์ YouTube คลิปเกม ตัวการ์ตูน มีม ประกาศแปลกใหม่ และโปรเจกต์เพลง
การมุ่งเน้นเสียงตัวละครนั้นเป็นข้อดีสำหรับเนื้อหาบางประเภทและเป็นข้อเสียสำหรับประเภทอื่น ๆ เสียงตลกหรือเสียงสังเคราะห์โดยเจตนาสามารถรองรับการล้อเลียนหรือ NPC ในเกมได้ แต่เสียงเดียวกันกลับกลายเป็นสิ่งรบกวนในคอร์ส e-learning การสาธิตผลิตภัณฑ์ หรือสปอตแบรนด์ระดับพรีเมียม ดังนั้นตัวกรองแรกไม่ใช่ "เสียงนี้ฟังดูเป็นมนุษย์ไหม?" แต่เป็น "เสียงนี้เหมาะกับผู้ชมเฉพาะของฉันหรือไม่?"
หากคุณยังตัดสินใจไม่ได้ว่าเครื่องสร้างเสียงสำเร็จรูปเหมาะกับความต้องการของคุณหรือไม่ บทความอธิบายของเราเกี่ยวกับ เครื่องสร้างเสียง AI ทำอะไร ครอบคลุมหมวดหมู่ที่กว้างขึ้นและว่าเครื่องมือเหล่านี้แตกต่างจากการโคลนและการพากย์เสียงอย่างไร
เอนจิ้น unit-selection สร้างเสียงขึ้นมาอย่างไร
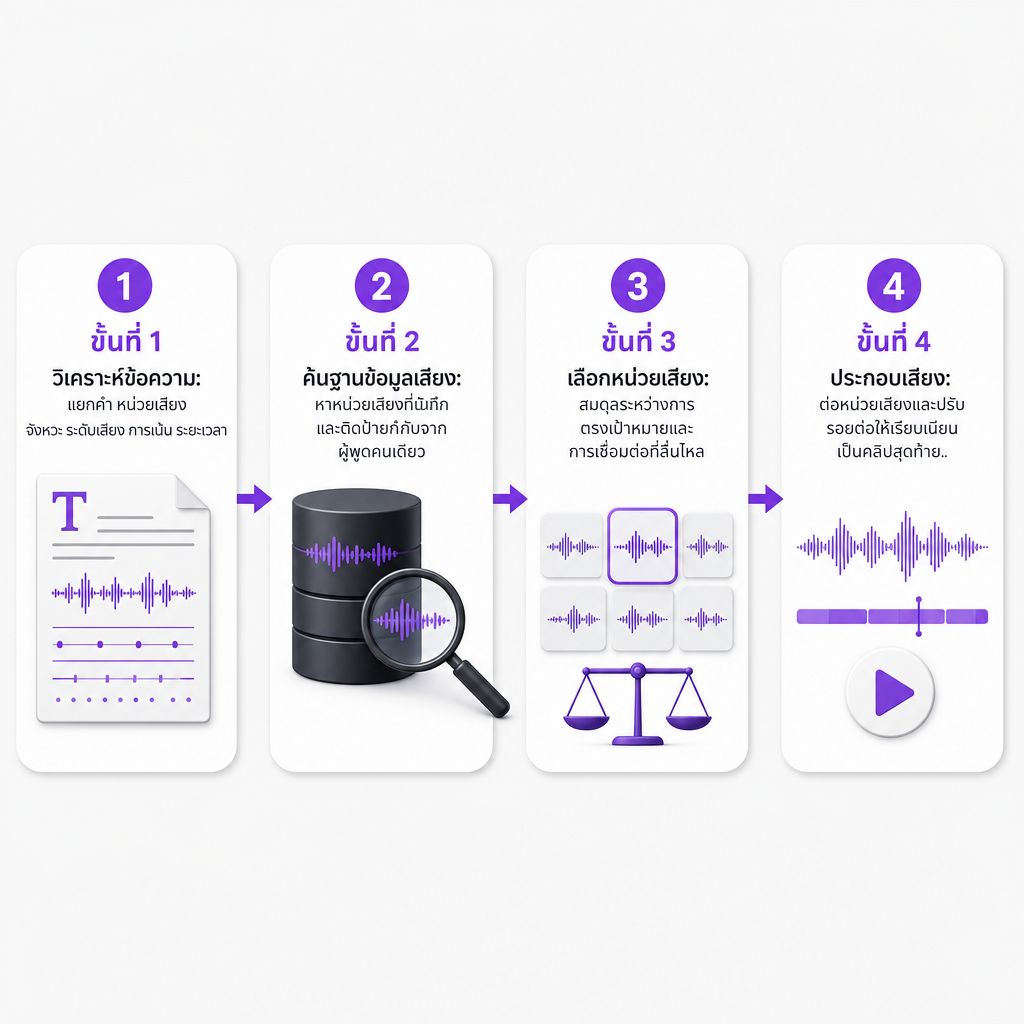
VoiceForge ใช้การสังเคราะห์แบบ unit-selection หรือเรียกอีกอย่างว่าการสังเคราะห์แบบ concatenative แทนที่จะสร้างการบันทึกทั้งหมดจากคลื่นสัญญาณที่โมเดลผลิตเพียงอันเดียว ระบบจะค้นหาฐานข้อมูลของส่วนเสียงพูดที่บันทึกไว้ และต่อชิ้นส่วนที่เหมาะสมที่สุดเข้าด้วยกันเป็นประโยคของคุณ การเข้าใจกระบวนการนี้อธิบายทั้งว่าทำไมเสียงจึงฟังดูจดจำได้และทำไมมันจึงทำงานในแบบที่เป็นเมื่อเจอแรงกดดัน
กระบวนการนี้ดำเนินไปในหลายขั้นตอน ขั้นแรก การวิเคราะห์ข้อความ เอนจิ้นจะแยกวิเคราะห์คำ โครงสร้างประโยค หน่วยเสียง จังหวะ ระดับเสียง การเน้น และระยะเวลา เพื่อตัดสินใจว่าควรพูดบรรทัดนั้นอย่างไร ต่อไป การค้นหาฐานข้อมูลเสียง เสียงแต่ละเสียงสร้างจากการบันทึกของผู้พูดที่เป็นมนุษย์ ตัดเป็นหน่วยย่อยและติดป้ายกำกับตามเสียงและบริบท จากนั้นคือการเลือกหน่วย (unit selection) ซึ่งเอนจิ้นจะสร้างสมดุลระหว่างเป้าหมายที่แข่งขันกันสองอย่างพร้อมกัน — การจับคู่เป้าหมาย ที่เลือกหน่วยที่มีเสียง ระดับเสียง ระยะเวลา และบริบทที่ถูกต้อง และการต่อที่ราบรื่น ที่สนับสนุนหน่วยข้างเคียงที่เชื่อมต่อกันโดยไม่มีรอยต่อที่เห็นได้ชัด สุดท้าย การประกอบเสียงจะเย็บลำดับที่เลือกไว้เข้าด้วยกันและใช้การปรับให้เรียบเล็กน้อยที่ขอบเขต
เนื่องจากผลลัพธ์ถูกประกอบขึ้นจากการบันทึกจริง เสียงแต่ละเสียงจึงคงเอกลักษณ์ที่โดดเด่นไว้ ข้อแลกเปลี่ยนคือวิธีนี้ไม่ได้ออกแบบมาเพื่อให้การกำกับอารมณ์ที่ไม่จำกัดหรือการนำเสนอที่ปรับได้อย่างสมบูรณ์เหมือนที่สัมพันธ์กับระบบ generative ที่ใหม่กว่า การใช้คำที่ไม่ปกติ การเปลี่ยนอย่างรวดเร็ว หรือการผสมการออกเสียงที่เก้ ๆ กัง ๆ อาจเผยให้เห็นรอยต่อระหว่างหน่วย ทำให้เกิดผลลัพธ์ที่ฟังดูสม่ำเสมอน้อยกว่าการบันทึกต่อเนื่องของมนุษย์ หากคุณต้องการดูว่ากระบวนการ generative แบบเต็มรูปแบบแตกต่างอย่างไร การแยกแยะของเราเกี่ยวกับ วิธีการทำงานของ neural text to speech จะอธิบายแนวทาง deep-learning ที่มาแทนที่การต่อหน่วย
เสียง, SSML และเพดาน 500 ตัวอักษร
VoiceForge มีรายการเสียงที่เป็นเอกลักษณ์ 42 เสียง แต่ละเสียงบันทึกโดยผู้พูดที่แตกต่างกันด้วยน้ำเสียงและสไตล์การพูดของตัวเอง นั่นมากเพียงพอเมื่อตัวเสียงเองเป็นส่วนหนึ่งของแนวคิดสร้างสรรค์ — ผู้บรรยายตลกสำหรับคลิปสั้น บุคลิกแปลก ๆ สำหรับวิดีโอเกม น้ำเสียงสังเคราะห์สำหรับมีม อย่างไรก็ตาม มันเป็นแคตตาล็อกที่เล็กกว่าสำหรับทีมที่ต้องการตัวแปรประจำภูมิภาคจำนวนมากหรือผู้บรรยายที่จับคู่อย่างระมัดระวังในหลายตลาด
สำหรับการควบคุมการนำเสนอ VoiceForge รองรับชุดย่อยของ Speech Synthesis Markup Language (SSML) แทนที่จะพึ่งพาเครื่องหมายวรรคตอนเพียงอย่างเดียว คุณฝังคำสั่งลงในสคริปต์โดยตรง
| การควบคุม SSML | มันทำอะไร |
|---|---|
<break> |
แทรกการหยุดชั่วคราว |
<emphasis> |
เน้นคำหรือวลี |
<prosody> |
ปรับระดับเสียง อัตราการพูด หรือระดับความดัง |
<phoneme> |
บังคับการออกเสียงที่แน่นอน |
<sub> |
พูดข้อความแทนที่ของข้อความที่มองเห็น |
<p> / <s> |
ทำเครื่องหมายย่อหน้าหรือประโยค |
แท็กเหล่านี้คุ้มค่าเมื่อเอนจิ้นอ่านชื่อผลิตภัณฑ์ ตัวย่อ หรือศัพท์เทคนิคผิด การครอบตัวย่อด้วย <sub alias="application programming interface">API</sub> ทำให้มันพูดวลีเต็ม และ <phoneme> ล็อกชื่อที่ยุ่งยากไว้ การใช้ <break time="500ms"/> ระหว่างบรรทัดเพิ่มจังหวะที่ตั้งใจซึ่งเครื่องหมายวรรคตอนทำไม่ได้
นี่คือข้อควรระวังที่เปลี่ยนวิธีที่คุณเขียนสำหรับมัน อินพุตข้อความถูกจำกัดที่ 500 ตัวอักษร และมาร์กอัป SSML นับรวมเข้าไปในขีดจำกัดนั้น ทุกแท็กที่คุณเพิ่มกินพื้นที่ที่มีอยู่สำหรับคำจริง ๆ การบรรยายยาว ๆ ต้องแบ่งออกเป็นหลายการสร้าง และมาร์กอัปจำนวนมากทำให้แต่ละชิ้นเล็กลงไปอีก ในทางปฏิบัติ หมายความว่าคุณต้องวางแผนสคริปต์เป็นช่วงสั้น ๆ ที่สมบูรณ์ในตัวเองแทนที่จะวางทั้งหน้า
ทดลองใช้ฟรี vs. ลิขสิทธิ์เชิงพาณิชย์: การตัดสินใจที่สำคัญ
VoiceForge มีการทดลองใช้ฟรีแบบจำกัด แต่การทดลองใช้ไม่ใช่ลิขสิทธิ์ในการเผยแพร่ แพ็กเกจของมันขีดเส้นแบ่งที่ชัดเจนระหว่างการใช้งานส่วนตัวและเชิงพาณิชย์ และเส้นแบ่งนั้นเองคือจุดที่ความผิดพลาดส่วนใหญ่เกิดขึ้น
ระดับ Fan Voice มีไว้สำหรับมุกตลก วิดีโอ เกม แอนิเมชัน และมีมที่ไม่ได้สร้างรายได้ แพ็กเกจ Publisher เป็นการสมัครสมาชิกที่ให้ลิขสิทธิ์เชิงพาณิชย์สำหรับเสียง TTS ในเนื้อหาที่สร้างรายได้หรือเชิงพาณิชย์ — วิดีโอที่สร้างรายได้ เกมอินดี้ และเพลง — และโฆษณาการดาวน์โหลดแบบไม่จำกัด การทดลองใช้ฟรีมีไว้เพื่อให้คุณทดสอบบริการก่อนตัดสินใจ
กฎการใช้งานนั้นง่าย ถ้าโปรเจกต์สร้างรายได้ ส่งเสริมธุรกิจ ปรากฏในสื่อที่สร้างรายได้ หรือเผยแพร่เชิงพาณิชย์ ให้ยืนยันแพ็กเกจที่เกี่ยวข้องก่อนที่คุณจะเผยแพร่ เสียงที่คุณสร้างระหว่างการทดลองใช้ฟรีไม่ได้มีสิทธิเชิงพาณิชย์โดยอัตโนมัติเพียงเพราะมันถูกดาวน์โหลด ภาษาเกี่ยวกับการให้ลิขสิทธิ์ก็สามารถเปลี่ยนแปลงได้ ดังนั้นหน้าแพ็กเกจเป็นจุดเริ่มต้น ไม่ใช่สิ่งทดแทนการทบทวนเฉพาะโปรเจกต์เมื่อเดิมพันสูง — งานส่งมอบให้ลูกค้า โฆษณาที่จ่ายเงิน แคมเปญที่มีแบรนด์ หรือการเปิดตัวแอป
จุดแข็งและข้อจำกัดสำหรับโปรเจกต์จริง
จุดแข็งของ VoiceForge รวมตัวอยู่รอบ ๆ บุคลิกและความเรียบง่าย เสียงตัวละครโดดเด่นเมื่อน้ำเสียงเป็นส่วนหนึ่งของมุกหรือแบรนด์ของช่อง เนื่องจากรากฐานคือเสียงพูดของมนุษย์ที่บันทึกไว้ เสียงจึงคงลักษณะเสียงตามธรรมชาติและเอกลักษณ์ที่จดจำได้ การควบคุมการออกเสียงด้วย SSML ให้คุณมีสิทธิ์ควบคุมตัวย่อ ชื่อ และศัพท์แปลก ๆ อย่างแท้จริง และแพ็กเกจ Publisher ทำให้คำถามเรื่องการใช้งานเชิงพาณิชย์ชัดเจนยิ่งขึ้นกว่าเครื่องมือที่แยกการเข้าถึงการสร้างออกจากรายละเอียดการให้ลิขสิทธิ์
ข้อจำกัดก็เป็นรูปธรรมเช่นกัน เพดาน 500 ตัวอักษรบังคับให้สคริปต์ยาวกลายเป็นการสร้างเล็ก ๆ จำนวนมาก และมาร์กอัปทำให้แต่ละอันสั้นลง แคตตาล็อก 42 เสียงนั้นน้อยเมื่อเทียบกับคลังเสียงขนาดใหญ่ ซึ่งสำคัญหากคุณต้องการตัวเลือกหลายร้อยตัวหรือสำเนียงประจำภูมิภาคจำนวนมาก สไตล์ที่เน้นตัวละครซึ่งเปล่งประกายในวงการบันเทิงอาจบั่นทอนเนื้อหาด้านกฎหมาย การแพทย์ การสอน หรือแบรนด์ระดับพรีเมียม ข้อจำกัดของแพ็กเกจสะดุดได้ง่าย เพราะความสามารถในการสร้างเสียงไม่เหมือนกับสิทธิ์ในการสร้างรายได้ และเนื่องจากเอนจิ้นต่อหน่วยที่บันทึกไว้ การใช้คำบางอย่างอาจแสดงร่องรอยการเย็บต่อที่การบันทึกต่อเนื่องจะไม่มี
ไม่มีสิ่งใดในเหล่านี้เป็นข้อตัดสิทธิ์ในตัวเอง พวกมันเพียงกำหนดจุดที่เหมาะสมที่สุด: คลิปสั้น ขับเคลื่อนด้วยบุคลิก ภาษาเดียว ที่เสียงคือประเด็นสำคัญ
เมื่อใดเสียงตัวละครเหมาะสม และเมื่อใดเวิร์กโฟลว์การแปลเป็นภาษาท้องถิ่นชนะ
VoiceForge เป็นตัวเลือกที่ถูกต้องเมื่อบุคลิกของเสียงเป็นศูนย์กลาง สคริปต์ของคุณแบ่งออกเป็นส่วนสั้น ๆ ได้อย่างเรียบร้อย คุณต้องการการควบคุมการออกเสียงและจังหวะพื้นฐาน และคุณกำลังผลิตวิดีโอ มีม แอนิเมชัน เพลง หรือเนื้อหาเกมอินดี้ — ไม่ว่าจะเป็นส่วนตัว (Fan Voice) หรือสร้างรายได้ด้วยการสมัครสมาชิกที่เหมาะสม
เวิร์กโฟลว์ที่กว้างขึ้นให้บริการคุณได้ดีกว่าเมื่อคุณต้องการผู้บรรยายที่เป็นกลางและขัดเกลา หลายภาษาและหลายสำเนียง เสียงโคลนของคุณเอง การบรรยายแบบยาว การอัปเดตเชิงพาณิชย์บ่อยครั้ง การผสานรวม API หรือเสียงที่สม่ำเสมอในแคตตาล็อกขนาดใหญ่ที่ความแปลกใหม่มีความสำคัญน้อยกว่าความน่าเชื่อถือ ช่องที่ขยายไปสู่ระดับสากลแสดงให้เห็นถึงการแบ่งนี้ได้ดี: VoiceForge อาจให้เสียงตัวละครสำหรับสเก็ตช์ภาษาอังกฤษ ในขณะที่การตั้งค่า TTS และการพากย์เสียงหลายภาษาผลิตเวอร์ชันที่แปลเป็นภาษาท้องถิ่นสำหรับผู้ชมอื่น ๆ
สถานการณ์ที่สองนั้นคือจุดที่เรามุ่งเน้น เครื่องมือ Text to Speech ของเรามีเสียง AI มากกว่า 300 เสียง เสียงพากย์หลายภาษา การควบคุมอัตราการพูด และโปรเจกต์ที่ดาวน์โหลดได้ซึ่งสร้างขึ้นสำหรับการผลิตมากกว่าความแปลกใหม่แบบครั้งเดียว ครีเอเตอร์ที่ต้องการรักษาเอกลักษณ์ของตัวเองในทุกวิดีโอสามารถใช้ Voice Cloning แทนการยอมรับตัวละครสำเร็จรูป และนักพัฒนาที่ต้องการการสร้างเสียงภายในแอปสามารถสร้างบน Text to Speech API ของเรา เมื่อเป้าหมายคือการเปลี่ยนคลิปเดียวให้เป็นการเปิดตัวที่แปลเป็นภาษาท้องถิ่นแบบเต็มรูปแบบ AI Dubbing จะนำสคริปต์เดียวกันไปยังภาษาอื่น ๆ ในที่เดียว
เช็กลิสต์คุณภาพก่อนเผยแพร่
ก่อนที่คุณจะส่งมอบเสียง VoiceForge ให้ตรวจสอบสิ่งที่มักเสียบ่อยที่สุดอย่างรวดเร็ว การสร้างช่วงทดสอบสั้น ๆ ก่อนคุ้มค่ากับเวลาเพิ่มเติมเพียงไม่กี่นาที เพราะเสียงที่ลงตัวในประโยคเดียวอาจน่าเบื่อหรือรบกวนตลอดทั้งวิดีโอ
- การออกเสียง: ชื่อ ตัวย่อ ตัวเลข และศัพท์เทคนิคถูกพูดอย่างถูกต้องหรือไม่?
- จังหวะ: การหยุดชั่วคราวตกลงอย่างเป็นธรรมชาติ ไม่ใช่กลางวลีใช่ไหม?
- ความสม่ำเสมอของตัวละคร: เสียงเดียวกันเหมาะกับทุกฉากหรือไม่ ไม่ใช่แค่ฉากเปิด?
- การเปลี่ยนผ่านของเสียง: มีการกระโดดที่ได้ยินระหว่างคลิปที่สร้างแยกกันหรือไม่?
- การให้ลิขสิทธิ์: แพ็กเกจปัจจุบันของคุณครอบคลุมการใช้งานที่สร้างรายได้หรือเชิงพาณิชย์จริง ๆ หรือไม่?
- ความเหมาะกับผู้ชม: สไตล์ตัวละครเหมาะสมกับแพลตฟอร์มและหัวข้อหรือไม่?
- การจัดเรียง: เสียงเข้ากันอย่างเรียบร้อยกับวิดีโอ เพลง หรือบทสนทนาเกมของคุณหรือไม่?
- สิทธิ์: คุณมีสิทธิ์สำหรับสคริปต์ ชื่อ หรือการอ้างอิงจากบุคคลที่สามในเสียงหรือไม่?
คำถามที่พบบ่อย
VoiceForge text to speech คืออะไร?
มันเป็นบริการบนเบราว์เซอร์ที่แปลงข้อความที่เขียนเป็นเสียงพูดโดยใช้คลังเสียงตัวละครที่มีเอกลักษณ์ มันพึ่งพาการสังเคราะห์แบบ unit-selection ซึ่งประกอบส่วนเสียงพูดที่บันทึกจากฐานข้อมูลเสียงมนุษย์ แทนที่จะสร้างเสียงจากคลื่นสัญญาณโมเดลเดียว
VoiceForge สร้างด้วย AI หรือไม่?
มันเป็นบริการสังเคราะห์เสียง แต่วิธีที่มีการบันทึกไว้คือ unit selection ไม่ใช่ระบบเสียง neural แบบ generative เต็มรูปแบบ เอนจิ้นเลือกและต่อหน่วยเสียงพูดของมนุษย์ที่บันทึกไว้เพื่อสร้างแต่ละคำพูด
VoiceForge มีเสียงให้เลือกกี่เสียง?
VoiceForge มีรายการเสียงที่เป็นเอกลักษณ์ 42 เสียง แต่ละเสียงเชื่อมโยงกับผู้พูดและบุคลิกของเสียงที่แตกต่างกัน
ขีดจำกัดตัวอักษรของ VoiceForge คือเท่าใด?
บริการมีการบันทึกขีดจำกัด 500 ตัวอักษรต่ออินพุตข้อความหนึ่งครั้ง และมาร์กอัป SSML ใด ๆ ที่คุณเพิ่มจะนับรวมเข้าไปในขีดจำกัดนั้น สคริปต์ที่ยาวกว่าต้องถูกแบ่งออกเป็นหลายการสร้าง
ฉันสามารถใช้เสียง VoiceForge บน YouTube ได้หรือไม่?
คุณสามารถทำได้ แต่เนื้อหาที่สร้างรายได้ต้องมีการสมัครสมาชิกเชิงพาณิชย์ที่เหมาะสม แพ็กเกจ Publisher ได้รับการอธิบายว่าเป็นลิขสิทธิ์สำหรับเสียง TTS ที่ใช้ในเนื้อหาที่สร้างรายได้หรือเชิงพาณิชย์ ดังนั้นให้ยืนยันแพ็กเกจของคุณก่อนเผยแพร่วิดีโอที่สร้างรายได้
VoiceForge เหมือนกับการโคลนเสียงหรือไม่?
ไม่ VoiceForge ใช้คลังเสียงที่มีอยู่ ในขณะที่การโคลนเสียงสร้างเสียงสังเคราะห์แบบกำหนดเองจากการบันทึกที่ได้รับอนุญาตของผู้พูดเฉพาะราย เราอธิบายเวิร์กโฟลว์แยกต่างหากนั้นบน หน้า Voice Cloning ของเรา