เสียงบรรยายที่ราบเรียบและออกจะดูเป็นหุ่นยนต์เล็กน้อยที่อ่านคำบรรยายทับคลิปได้กลายเป็นหนึ่งในเสียงที่คนจดจำได้มากที่สุดในวิดีโอรูปแบบสั้น เมื่อคนได้ยินเสียงนี้ พวกเขารู้ทันทีว่ากำลังดูเนื้อหาประเภทไหนอยู่ หากคุณกำลังมองหาวิธีที่เชื่อถือได้ในการนำเอฟเฟกต์ tiktok voice text to speech นั้นไปใส่ในวิดีโอที่คุณโพสต์ในที่อื่น ๆ ข่าวดีก็คือคุณไม่จำเป็นต้องติดอยู่ในตัวแก้ไขของแอปเพียงแอปเดียวเพื่อให้ได้เอฟเฟกต์นี้ ด้วยเครื่องมือ Text to Speech ของเรา คุณเขียนสคริปต์ เลือกเสียงที่ตรงกับโทนที่คุณต้องการ สร้างเสียง และซิงค์เข้ากับฟุตเทจของคุณสำหรับ TikTok, YouTube Shorts, Reels หรือที่ไหนก็ตามที่คุณเผยแพร่
เหตุผลที่เรื่องนี้สำคัญนั้นมากกว่าแค่การเลียนแบบเทรนด์ เสียงบรรยายที่มีเอกลักษณ์คือส่วนหนึ่งของอัตลักษณ์ของช่องคุณ เมื่อมันเป็นที่จดจำได้แล้ว ผู้ชมจะเชื่อมโยงมันกับคุณในทุกแพลตฟอร์ม ปัญหาของการพึ่งพาเพียงเสียงบรรยายที่มีมาในแอปก็คือคุณถูกจำกัดอยู่แค่แอปนั้น รายการเสียงสั้น ๆ ของมัน และกฎเกณฑ์ของมัน เราสร้างเวิร์กโฟลว์ของเราเพื่อให้เสียงเดียวกันที่คุณชื่นชอบสามารถติดตามเนื้อหาของคุณไปได้ทุกที่ และเมื่อคุณพร้อม ก็สามารถไปสู่ภาษาอื่น ๆ ได้ด้วย
สารบัญ
- ทำไมเสียงบรรยายของ TikTok จึงกลายเป็นเครื่องมือเล่าเรื่อง
- การสร้างเอฟเฟกต์นั้นขึ้นมาใหม่ด้วยเครื่องมือ Text to Speech ของเรา
- การก้าวข้ามเสียงสำเร็จรูปด้วยการโคลนเสียง
- การนำเสียงเดียวข้ามภาษาและรูปแบบต่าง ๆ
- การทำให้การบรรยายสไตล์ TikTok เป็นอัตโนมัติด้วย API ของเรา
- การเลือกเส้นทางของคุณ: เสียงสำเร็จรูป เสียงโคลน หรือ API
- คำถามที่พบบ่อย
ทำไมเสียงบรรยายของ TikTok จึงกลายเป็นเครื่องมือเล่าเรื่อง
เสียงบรรยายที่มีมาในตัวเริ่มต้นในฐานะฟีเจอร์เพื่อความสะดวก คุณเพิ่มข้อความลงในคลิป แตะเพื่อแปลงเป็นเสียงพูด เลือกจากเสียงไม่กี่แบบ แล้วแอปก็อ่านคำบรรยายของคุณออกมาเสียงดัง บทเรียนต่าง ๆ ทั่วเว็บพาผู้เริ่มต้นทำตามขั้นตอนนั้นอย่างชัดเจน: เพิ่มข้อความ กดค้างไว้หรือแตะไอคอนเสียง แล้วเลือกผู้บรรยาย เพราะกระบวนการนี้ง่ายมาก ครีเอเตอร์จึงนำมาใช้กับคลิปตลก คลิปอธิบายทีละขั้นตอน โพสต์เล่าเรื่อง และการรีวิวสินค้า
สิ่งที่เปลี่ยนเครื่องมืออรรถประโยชน์ให้กลายเป็นเทรนด์คือการทำซ้ำ เมื่อคลิปนับล้านใช้การบรรยายที่เป็นกลางและมีจังหวะสม่ำเสมอแบบเดียวกัน เสียงนั้นก็กลายเป็นสัญลักษณ์ของเนื้อหาสไตล์หนึ่ง ผู้ชมเลิกได้ยินมันในฐานะเครื่องจักร แล้วเริ่มได้ยินมันในฐานะเสียงของการเล่าเรื่องรูปแบบสั้น ความคุ้นเคยนี้คือเหตุผลว่าทำไมครีเอเตอร์จำนวนมากในตอนนี้จึงต้องการเอฟเฟกต์เดียวกันในทุกแพลตฟอร์มที่พวกเขาเผยแพร่ และต้องการการควบคุมมากกว่าที่รายการเสียงตายตัวจะอนุญาตให้ได้
ข้อจำกัดในทางปฏิบัติเจอได้ง่าย เสียงบรรยายที่มีมาในแอปให้เมนูเสียงสั้น ๆ แก่คุณและเก็บทุกอย่างไว้ในแอปเดียวนั้น หากคุณนำวิดีโอไปใช้ซ้ำสำหรับอีกแพลตฟอร์ม คุณก็จะสูญเสียการบรรยายไปหรือต้องอัดใหม่ หากคุณต้องการเสียงที่ไม่มีในรายการ คุณก็ติดขัด และหากคุณวางแผนที่จะเผยแพร่ไอเดียเดียวกันในอีกภาษาหนึ่ง เครื่องมือที่มีมาในตัวก็จะไม่นำผู้บรรยายของคุณข้ามไปให้ ช่องว่างเหล่านั้นคือจุดที่เวิร์กโฟลว์ Text to Speech เฉพาะทางแสดงคุณค่าของมัน โดยให้คุณสร้างการบรรยายครั้งเดียวและนำไปใช้ซ้ำได้ทุกที่ที่คุณโพสต์
การสร้างเอฟเฟกต์นั้นขึ้นมาใหม่ด้วยเครื่องมือ Text to Speech ของเรา
เครื่องมือ Text to Speech ของเราคือส่วนที่สร้างเอฟเฟกต์เสียงบรรยายบนหน้าจอขึ้นมาใหม่โดยตรง แทนที่จะพิมพ์คำบรรยายลงในแอปเดียวและหวังว่าเสียงบรรยายของมันจะเข้ากัน คุณวางสคริปต์ของคุณ เลือกจากคลังเสียงที่ฟังดูเป็นธรรมชาติมากกว่า 300 เสียง แล้วสร้างเสียงที่สะอาดซึ่งคุณสามารถวางลงในวิดีโอใดก็ได้ ผลลัพธ์เป็นไฟล์ที่ดาวน์โหลดได้ ดังนั้นมันจึงเป็นของโปรเจกต์ของคุณ ไม่ใช่ของตัวแก้ไขของแพลตฟอร์มใดแพลตฟอร์มหนึ่ง
เว็บแอปทำตามสี่ขั้นตอนที่ตรงไปตรงมา ขั้นแรก เลือก Text to Speech ขั้นที่สอง สร้างเสียงพูดโดยการป้อนข้อความของคุณและเลือกผู้พูด ขั้นที่สาม แก้ไขโปรเจกต์ ซึ่งคุณสามารถเพิ่มผู้พูดหรือปรับข้อความได้ ขั้นที่สี่ ดาวน์โหลดโปรเจกต์ที่เสร็จแล้วในรูปแบบที่คุณต้องการ ไม่มีอะไรที่ต้องใช้ทักษะทางเทคนิคเลย ซึ่งนั่นคือประเด็น: คุณควรใช้พลังงานไปกับสคริปต์และการแก้ไข ไม่ใช่กับการต่อสู้กับซอฟต์แวร์
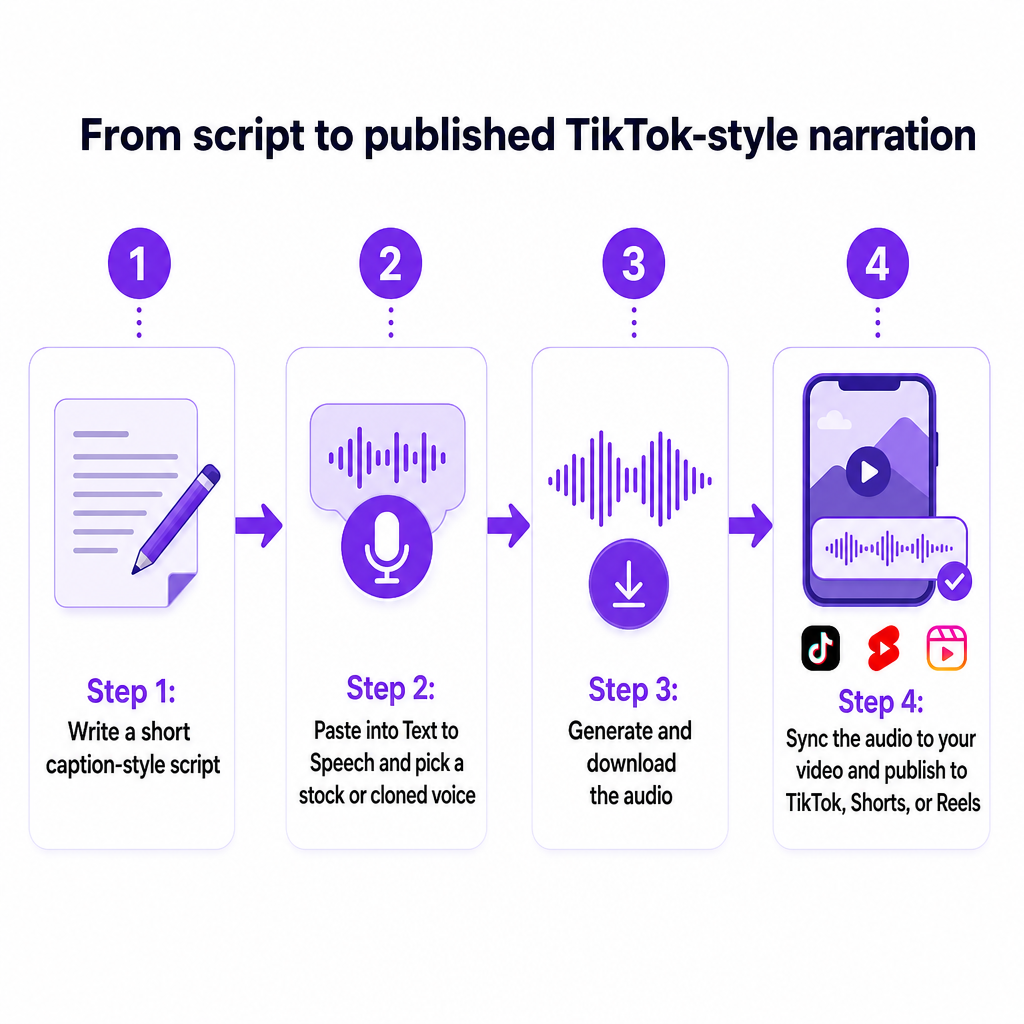
เมื่อนำมาใช้กับวิดีโอรูปแบบสั้น ขั้นตอนก็ยิ่งเป็นรูปธรรมมากขึ้น เริ่มต้นด้วยการเขียนสคริปต์สั้น ๆ สไตล์คำบรรยาย คือคำที่คุณต้องการให้อ่านทับคลิปของคุณเป๊ะ ๆ ทำให้มันกระชับ; เอฟเฟกต์เสียงบรรยายทำงานได้ดีที่สุดกับประโยคที่แน่นและมีจังหวะ วางสคริปต์นั้นลงใน Text to Speech และเลือกเสียงที่โทนตรงกับอารมณ์ที่คุณต้องการ ไม่ว่าจะเป็นแบบหน้าตาย, สดใส หรือเป็นกลาง สร้างเสียง แล้วนำมันเข้าไปในตัวแก้ไขที่คุณเลือกและจัดวางให้ตรงกับภาพก่อนที่คุณจะเผยแพร่ไปยัง TikTok, Shorts หรือ Reels
เพราะคุณกำลังสร้างการบรรยายนอกแอปใดแอปหนึ่ง ไฟล์เสียงเดียวกันจึงใช้งานได้ในทุกแพลตฟอร์มในรอบการโพสต์ของคุณ อัดครั้งเดียว ใช้ซ้ำได้ทุกที่ แค่นั้นก็แก้ปัญหาที่น่าหงุดหงิดที่สุดของเสียงบรรยายที่มีมาในแอปแล้ว: คุณไม่ต้องสร้างเสียงบรรยายเดียวกันสามครั้งสำหรับสามปลายทางอีกต่อไป
การเขียนสคริปต์ที่เหมาะกับสไตล์เสียงบรรยาย
เสียงทำหน้าที่ส่วนใหญ่ แต่สคริปต์เป็นตัวกำหนดจังหวะ ประโยคบอกเล่าสั้น ๆ อ่านได้อย่างสะอาดและลงตัวด้วยจังหวะที่ชัดเจนซึ่งผู้ชมเชื่อมโยงกับเทรนด์นี้ ตัวเลข รายการ และคำเปลี่ยนช่วงที่ชัดเจนอย่าง "อย่างแรก" "จากนั้น" และ "สุดท้าย" แปลงเป็นเสียงสังเคราะห์ได้ดีเพราะมันให้จุดหยุดพักที่เป็นธรรมชาติแก่เสียง หากประโยคหนึ่งฟังดูขัดหูตอนที่คุณอ่านออกเสียง มันก็จะฟังดูขัดหูตอนที่เสียงอ่านมันเช่นกัน ดังนั้นการอ่านออกเสียงตรวจดูสั้น ๆ ก่อนที่คุณจะสร้างเสียงจะช่วยประหยัดการสร้างใหม่ในภายหลังได้มาก
การก้าวข้ามเสียงสำเร็จรูปด้วยการโคลนเสียง
การเลือกจากคลังเสียงเป็นเส้นทางที่รวดเร็ว และสำหรับครีเอเตอร์หลายคน เสียงสำเร็จรูปที่เลือกมาอย่างดีก็เป็นทั้งหมดที่พวกเขาต้องการ แต่การฟังดูเหมือนคนอื่น ๆ ก็มีขีดจำกัด หากเป้าหมายของคุณคือผู้บรรยายที่เป็นของคุณอย่างไม่มีข้อสงสัย Voice cloning ของเราจะเปลี่ยนเสียงของคุณเอง หรือเสียงแบรนด์ที่ได้รับความยินยอม ให้เป็นโมเดลที่นำกลับมาใช้ซ้ำได้ซึ่งคุณสามารถขับเคลื่อนด้วยข้อความ
ความแตกต่างนี้สำคัญ text to speech ทั่วไปหมายถึงการเลือกจากผู้บรรยายที่ตั้งค่าไว้ล่วงหน้า การโคลนเสียงสร้างโมเดลสังเคราะห์ของผู้พูดคนใดคนหนึ่งโดยเฉพาะ ดังนั้นเสียงพูดใหม่ในเสียงนั้นสามารถสร้างขึ้นจากข้อความใด ๆ ที่คุณพิมพ์ได้ ในเว็บแอป คุณอัปโหลดไฟล์เสียงที่มีเสียงพูดที่สะอาดอย่างน้อย 20 วินาที โดยมีเสียงรบกวนพื้นหลังน้อยที่สุด ไปยังส่วนโคลนเสียง จากตัวอย่างที่สั้นและเงียบนั้น เราสร้างเสียงที่ปรับแต่งเองซึ่งคุณสามารถใช้ได้เหมือนเสียงอื่น ๆ ในโปรเจกต์ Text to Speech ของคุณ
เสียงที่สะอาดยี่สิบวินาทีเป็นเกณฑ์ที่ต่ำสำหรับความพยายามในการผลิต ห้องเงียบ ๆ โทรศัพท์หรือไมค์พื้นฐาน และการอ่านสั้น ๆ ก็เพียงพอที่จะสร้างผู้บรรยายซิกเนเจอร์ที่คุณสามารถนำกลับมาใช้ซ้ำได้ไม่จำกัด เมื่อมันมีอยู่แล้ว คุณไม่ต้องเลือกระหว่างเสียงสำเร็จรูปที่ไม่มีชื่อเสียงอีกต่อไป; คุณมีเสียงที่นำอัตลักษณ์ของคุณไปสู่ทุกคลิป และมันยังคงสม่ำเสมอไม่ว่าคุณจะเผยแพร่วันนี้หรืออีกหกเดือนข้างหน้า
นี่คือจุดที่ผู้บรรยายที่จดจำได้กลายเป็นทรัพย์สินของแบรนด์แทนที่จะเป็นเอฟเฟกต์ครั้งเดียว เสียงที่โคลนแล้วอ่านสคริปต์ที่คุณไม่เคยอัดจริง ๆ คงลักษณะเฉพาะของมันตลอดปฏิทินเนื้อหาทั้งหมด และไม่จำเป็นต้องมีเซสชันการอัดใหม่เพียงเพราะคุณเปลี่ยนอุปกรณ์ สำหรับครีเอเตอร์ที่กำลังสร้างอัตลักษณ์ช่องระยะยาว ความสม่ำเสมอนั้นคือการอัปเกรดที่แท้จริงเหนือเมนูเสียงของแอปที่หมุนเวียนไปมา
การนำเสียงเดียวข้ามภาษาและรูปแบบต่าง ๆ
เสียงบรรยายที่ใช้งานได้เพียงภาษาเดียวจำกัดการเข้าถึงของคุณทันทีที่คุณต้องการเติบโตในระดับนานาชาติ แพลตฟอร์มของเรารองรับการพากย์เสียงหลายภาษาใน 33 ภาษาเป้าหมาย และสามารถสร้างเสียงพูดจากข้อความในภาษาที่คุณเลือก ดังนั้นเทรนด์เดียวกันที่ใช้ได้ผลในภาษาอังกฤษก็สามารถทำซ้ำสำหรับผู้ชมในที่อื่นได้
นี่คือวิธีที่ชิ้นส่วนต่าง ๆ เข้ากัน Text to Speech ให้การบรรยายแก่คุณ Voice cloning ทำให้การบรรยายนั้นคงอยู่ในเสียงที่จดจำได้เพียงเสียงเดียว AI Dubbing ของเราขยายเนื้อหาเดียวกันไปสู่ภาษาอื่น ๆ โดยจัดการวิดีโอและเสียงผ่าน text to speech, speech to text และ voice cloning ภายในเวิร์กโฟลว์เดียว แทนที่จะจ้างผู้บรรยายแยกกันสำหรับแต่ละตลาด คุณคงอัตลักษณ์เสียงเดียวและปล่อยให้แพลตฟอร์มนำมันข้ามไปยังเวอร์ชันต่าง ๆ
เวิร์กโฟลว์ยังขยายขนาดเกินคลิปสั้นด้วย สำหรับเนื้อหาที่ยาวขึ้น คุณสามารถอัปโหลดวิดีโอหรือไฟล์เสียงแบบเต็ม ปรับการตั้งค่าผู้พูด เลือกภาษา และเลือกเสียงที่ต้องการภายในโปรเจกต์ก่อนส่งออก ดังนั้นวิธีเดียวกันที่คุณใช้เพิ่มผู้บรรยายสไตล์ไวรัลลงในคลิปสิบห้าวินาทีก็นำไปใช้กับคลิปอธิบาย บทเรียน หรือตอนเต็มได้ด้วย รูปแบบสั้นคือที่ที่เทรนด์อาศัยอยู่ แต่เครื่องมือพื้นฐานไม่ได้หยุดอยู่แค่รูปแบบสั้น
สำหรับครีเอเตอร์ที่วางแผนการเติบโตระดับโลก สิ่งนี้เปลี่ยนเศรษฐศาสตร์ของการปรับให้เข้ากับท้องถิ่น สคริปต์เดียวกลายเป็นคลิปสั้นภาษาอังกฤษ เวอร์ชันภาษาสเปน และเวอร์ชันภาษาอื่น ๆ ทั้งหมดบรรยายด้วยเสียงที่สม่ำเสมอ โดยไม่ต้องสร้างเสียงของคุณขึ้นใหม่จากศูนย์ในแต่ละครั้ง เอฟเฟกต์ผู้บรรยายที่จดจำได้กลายเป็นสิ่งที่คุณสามารถดำเนินการเป็นระบบที่ทำซ้ำได้แทนที่จะเป็นครั้งเดียวที่โชคดี
การทำให้การบรรยายสไตล์ TikTok เป็นอัตโนมัติด้วย API ของเรา
ครีเอเตอร์แต่ละคนสามารถทำทุกอย่างข้างต้นในเบราว์เซอร์ได้ เอเจนซี ช่องขนาดใหญ่ และทีมที่มีคลังเนื้อหาย้อนหลังมักต้องการผลลัพธ์เดียวกันในปริมาณมาก และนั่นคือจุดที่ API ของเราเข้ามา Text to Speech API เป็นบริการ RESTful ที่แปลงข้อความเป็นเสียงพูดที่ฟังดูเป็นธรรมชาติ: คุณส่งคำขอ POST พร้อมข้อความและความชอบด้านเสียงของคุณและได้รับไฟล์เสียงที่พร้อมใช้งานกลับมา มันรองรับเสียงมากกว่า 300 เสียงและการโคลนเสียงเดียวกันกับที่มีในแอป
เพื่อทำให้ผู้บรรยายที่ปรับแต่งเองสามารถโปรแกรมได้ Voice Cloning API ของเราทำตามรูปแบบสามขั้นตอนที่กระชับ ขั้นแรก อัปโหลดไฟล์เสียงและรับ file key ขั้นที่สอง สร้างเสียงที่ปรับแต่งเองโดยการระบุชื่อและ file key นั้น ขั้นที่สาม ใช้เสียงที่โคลนแล้วภายในโปรเจกต์ Text to Speech ผ่าน TTS project endpoints ของแพลตฟอร์ม เมื่อเสียงมีอยู่แล้ว มันจะกลายเป็นทรัพย์สินที่นำกลับมาใช้ซ้ำได้ซึ่งแอปพลิเคชันของคุณสามารถเรียกใช้ได้ ไม่ใช่การส่งออกที่ใช้ได้ครั้งเดียว
เมื่อรวมเข้าด้วยกัน สิ่งนี้ให้ทีมสามารถทำเอฟเฟกต์นี้ในระดับอุตสาหกรรม ลองนึกถึงเอเจนซีที่จัดการช่องของลูกค้าหลายช่อง: มันสามารถรักษาเสียงแบรนด์ที่โคลนไว้หนึ่งเสียงต่อลูกค้าหนึ่งราย ป้อนสคริปต์ผ่าน API และสร้างเสียงบรรยายสำหรับวิดีโอหลายสิบคลิปโดยไม่ต้องมีคนวางข้อความลงในเครื่องมือด้วยตนเองในแต่ละครั้ง รูปแบบเดียวกันรองรับระบบการเรียนรู้และไปป์ไลน์การปรับให้เข้ากับท้องถิ่น ซึ่งเสียงที่โคลนแล้วถูกเรียกใช้ตามความต้องการขณะที่มีการผลิตเนื้อหา
สำหรับทีมที่สร้างภาพด้วยหรือต้องการสร้างวิดีโอสั้นรอบ ๆ ภาพนิ่ง เครื่องมือ image-to-video ของเราอยู่ในระบบนิเวศเดียวกัน ดังนั้นการผลิตเสียงและภาพจึงอยู่ในที่เดียวกันแทนที่จะกระจัดกระจายไปตามแอปที่ไม่เชื่อมต่อกัน เป้าหมายคือเวิร์กโฟลว์เดียว: แพลตฟอร์มเดียวในการเขียน ให้เสียง ปรับให้เข้ากับท้องถิ่น และประกอบ
หมายเหตุเกี่ยวกับความคาดหวัง: เราอธิบาย API เหล่านี้ในเชิงฟังก์ชันเพราะนั่นคือสิ่งที่เวิร์กโฟลว์พึ่งพา หากคุณต้องการรายละเอียดเกี่ยวกับ rate limits, throughput หรือการตั้งค่าเฉพาะแผน โปรดบอกเราถึงปริมาณและกรณีการใช้งานที่คุณคาดหวัง เพื่อที่เราจะได้เตรียมคำแนะนำที่ตรงกับปริมาณงานของคุณ
การเลือกเส้นทางของคุณ: เสียงสำเร็จรูป เสียงโคลน หรือ API
ผู้อ่านส่วนใหญ่มาพร้อมกับหนึ่งในสามความต้องการ และจุดเริ่มต้นที่ถูกต้องขึ้นอยู่กับว่าอันไหนอธิบายตัวคุณ ตารางด้านล่างจับคู่แต่ละสถานการณ์กับก้าวแรกที่มีประโยชน์และเร็วที่สุด
| สถานการณ์ของคุณ | จุดเริ่มต้นที่ดีที่สุด | ทำไมมันจึงเหมาะ |
|---|---|---|
| ทดสอบเอฟเฟกต์อย่างรวดเร็ว | เสียงสำเร็จรูปใน Text to Speech | เลือกจากเสียงมากกว่า 300 เสียง สร้างเสียงได้ในไม่กี่นาที ไม่ต้องอัด |
| สร้างเสียงซิกเนเจอร์ของช่อง | Voice cloning | เปลี่ยนตัวอย่างที่สะอาด 20 วินาทีให้เป็นผู้บรรยายที่ปรับแต่งเองซึ่งนำกลับมาใช้ซ้ำได้ |
| ผลิตในระดับใหญ่หรือข้ามลูกค้าหลายราย | TTS และ Voice Cloning API | ทำให้การบรรยายเป็นอัตโนมัติข้ามวิดีโอมากมายและเวอร์ชันหลายภาษา |
หากคุณไม่แน่ใจ ให้เริ่มจากง่าย ๆ ร่างสคริปต์สั้น ๆ สไตล์คำบรรยายสำหรับโพสต์ถัดไปของคุณ เปิด Text to Speech ในเบราว์เซอร์ และสร้างมันด้วยเสียงสำเร็จรูปที่ตรงกับโทนของคุณ หากคุณชอบเอฟเฟกต์แต่ต้องการให้มันฟังดูเหมือนคุณ ให้อัปโหลดตัวอย่างที่สะอาด 20 วินาทีและโคลนเสียงของคุณ แล้วเปรียบเทียบทั้งสองบนคลิปเดียวกัน การเปรียบเทียบเดียวนั้นมักจะยุติคำถามว่าคุณต้องการผู้บรรยายสำเร็จรูปสไตล์ไวรัลหรือเสียงแบรนด์ที่เป็นเอกลักษณ์ต่อไป
ทีมและนักพัฒนาที่ดำเนินการช่องหลายช่องหรือคลังเนื้อหาย้อนหลังขนาดใหญ่จะได้รับคุณค่ามากขึ้นจากการเข้าถึง API เนื่องจากขั้นตอนในเบราว์เซอร์แบบทำมือไม่สามารถขยายไปสู่เนื้อหาหลายร้อยชิ้นได้ ไม่ว่าอันไหนจะเหมาะกับปริมาณของคุณ ความสามารถพื้นฐานก็เหมือนกัน: ผู้บรรยายที่จดจำได้ ตามเงื่อนไขของคุณ บนทุกแพลตฟอร์มที่คุณเผยแพร่ หากคุณต้องการความช่วยเหลือในการจับคู่แผนช่อง ขนาดคลัง และเป้าหมายภาษาของคุณกับแนวทางที่ถูกต้อง โปรดแบ่งปันรายละเอียดเหล่านั้นกับเราแล้วเราจะแนะนำการตั้งค่าที่เหมาะสม
ข้อควรระวังในทางปฏิบัติที่ควรจำไว้: เมื่อคุณโคลนเสียง ให้ใช้เสียงของคุณเองหรือเสียงที่คุณได้รับอนุญาตอย่างชัดเจนให้ใช้ และปฏิบัติตามกฎการโพสต์ของแพลตฟอร์มใดก็ตามที่คุณเผยแพร่ นั่นทำให้กลยุทธ์ผู้บรรยายที่จดจำได้ของคุณยั่งยืนแทนที่จะเสี่ยง
คำถามที่พบบ่อย
DubSmart AI มีพรีเซ็ตที่ระบุว่า "เสียง TikTok" หรือไม่?
เรามุ่งเน้นไปที่การสร้างเอฟเฟกต์ขึ้นมาใหม่มากกว่าการเลียนแบบพรีเซ็ตกรรมสิทธิ์ที่เฉพาะเจาะจง คุณจะได้ความรู้สึกของผู้บรรยายบนหน้าจอที่คุ้นเคยนั้นโดยการสร้างเสียงใน Text to Speech จากคลังเสียงมากกว่า 300 เสียง แล้วเลือกเสียงที่โทนตรงกับสไตล์ที่คุณต้องการ คุณยังสามารถโคลนเสียงที่ปรับแต่งเองสำหรับผู้บรรยายที่เป็นของคุณอย่างมีเอกลักษณ์ได้ด้วย หากคุณมีโทนหรือเสียงแบรนด์ที่เฉพาะเจาะจงอยู่ในใจ บอกเราแล้วเราจะแนะนำแนวทางที่เหมาะสม
ฉันจะเพิ่มเอฟเฟกต์ผู้บรรยายลงในวิดีโอนอก TikTok ได้อย่างไร?
เขียนสคริปต์สั้น ๆ สไตล์คำบรรยาย วางลงในเครื่องมือ Text to Speech ของเรา เลือกผู้พูด และสร้างเสียง ดาวน์โหลดไฟล์และจัดวางให้ตรงกับฟุตเทจของคุณในตัวแก้ไขใดก็ได้ แล้วเผยแพร่ไปยัง Shorts, Reels หรือที่ไหนก็ตาม เพราะเสียงเป็นไฟล์แบบสแตนด์อโลน การบรรยายเดียวจึงใช้งานได้ในทุกแพลตฟอร์มที่คุณโพสต์
ฉันต้องการอะไรในการโคลนเสียงของตัวเอง?
อัปโหลดไฟล์เสียงที่มีเสียงพูดที่สะอาดอย่างน้อย 20 วินาทีโดยมีเสียงรบกวนพื้นหลังน้อยที่สุดไปยังส่วนโคลนเสียง จากตัวอย่างที่สั้นและเงียบนั้น เราสร้างโมเดลเสียงที่ปรับแต่งเองซึ่งคุณสามารถใช้ภายในโปรเจกต์ Text to Speech ของคุณได้เหมือนเสียงอื่น ๆ
ฉันสามารถใช้เสียงเดียวกันในภาษาต่าง ๆ ได้หรือไม่?
ได้ แพลตฟอร์มของเรารองรับการพากย์เสียงหลายภาษาใน 33 ภาษาเป้าหมาย และด้วยการรวม Text to Speech, voice cloning และ AI Dubbing คุณสามารถคงเสียงที่จดจำได้เพียงเสียงเดียวข้ามเวอร์ชันต่าง ๆ ของเนื้อหาเดียวกัน ดังนั้นคลิปสั้นภาษาอังกฤษและเวอร์ชันภาษาอื่น ๆ ของมันจึงมีผู้บรรยายที่สม่ำเสมอเหมือนกัน
มีวิธีทำให้สิ่งนี้เป็นอัตโนมัติสำหรับวิดีโอหลายคลิปพร้อมกันหรือไม่?
นักพัฒนาและเอเจนซีสามารถใช้ Text to Speech API ของเราเพื่อแปลงข้อความเป็นเสียงแบบโปรแกรม และ Voice Cloning API เพื่ออัปโหลดตัวอย่าง สร้างเสียงที่ปรับแต่งเองที่มีชื่อ และเรียกใช้มันภายในโปรเจกต์ TTS สิ่งนี้ให้คุณสร้างการบรรยายข้ามคลังเนื้อหาขนาดใหญ่และช่องหลายช่องได้โดยไม่ต้องทำงานด้วยตนเองต่อวิดีโอ
ฉันควรเลือกเสียงสำเร็จรูปหรือโคลนเสียงของตัวเอง?
เสียงสำเร็จรูปเป็นวิธีที่เร็วที่สุดในการทดสอบเอฟเฟกต์และใช้ได้ผลดีสำหรับครีเอเตอร์หลายคน การโคลนเป็นตัวเลือกที่ดีกว่าเมื่อคุณต้องการผู้บรรยายที่ผูกติดกับแบรนด์ของคุณอย่างไม่มีข้อสงสัยและคงความสม่ำเสมอไว้ตลอดเวลา การลองทั้งสองบนคลิปเดียวกันเป็นวิธีที่เร็วที่สุดในการตัดสินใจว่าคุณชอบอันไหนมากกว่า