การขยายการผลิตคอนเทนต์ด้วย AI หมายถึงการเปลี่ยนบทแต่ละชิ้น วิดีโอ และการบันทึกเสียงให้กลายเป็นชิ้นงานหลายภาษาที่เสร็จสมบูรณ์จำนวนมาก โดยไม่ต้องขยายทีมในอัตราเดียวกัน คำตอบเชิงปฏิบัติสำหรับคำถามว่าจะขยายการผลิตคอนเทนต์ด้วย AI อย่างไรนั้น ไม่ใช่การนำเครื่องมือมากมายมาวางซ้อนกัน—แต่คือการรวมเสียง การพากย์ การถอดเสียง และภาพเข้าไว้ในเวิร์กโฟลว์เดียว ที่ทุกชิ้นงานถูกออกแบบมาตั้งแต่วันแรกให้ขยายผลได้ ที่ DubSmart AI เราสร้างแพลตฟอร์มของเราขึ้นมารอบ ๆ การเปลี่ยนแปลงนั้นพอดี ดังนั้นคอนเทนต์ต้นฉบับหนึ่งชิ้นจึงสามารถกลายเป็นเวอร์ชันที่แปลเป็นภาษาท้องถิ่นและนำกลับมาใช้ใหม่ได้หลายสิบเวอร์ชัน โดยไม่ต้องเพิ่มจำนวนพนักงานหรืองบประมาณตามสัดส่วน
การตัดสินใจที่แท้จริงไม่ได้อยู่ที่ว่า AI สามารถสร้างสื่อได้หรือไม่ แต่อยู่ที่ว่าคุณจะยังคงปฏิบัติต่อทุกวิดีโอ ตอน และคอร์สในฐานะงานผลิตครั้งเดียวจบ หรือจะวางมาตรฐานเป็นเวิร์กโฟลว์แบบ AI-first ที่คอนเทนต์ถูกสร้างขึ้นเพื่อขยายข้ามภาษา รูปแบบ และช่องทางต่าง ๆ
สารบัญ
สิ่งที่คุณกำลังพยายามขยายจริง ๆ
ก่อนที่จะเลือกเครื่องมือใด ๆ การระบุให้ชัดว่าการขยายหมายถึงอะไรสำหรับช่องหรือองค์กรของคุณจะช่วยได้ เพราะทั้งสามเวอร์ชันที่พบบ่อยนั้นดึงไปคนละทิศทาง:
- เวอร์ชันของคอนเทนต์เดิมมากขึ้น — ภาษา รูปแบบ และความยาวเพิ่มเติมจากต้นฉบับเดียว
- คอนเทนต์รวมมากขึ้น — จำนวนตอน บทเรียน หรือแคมเปญที่ส่งออกมากขึ้นในแต่ละเดือน
- ช่องทางมากขึ้น — YouTube, TikTok, พอดแคสต์, แพลตฟอร์มการเรียนรู้ และพอร์ทัลภายใน จากวัสดุต้นฉบับเดียวกัน
ครีเอเตอร์และทีมส่วนใหญ่ในที่สุดก็ต้องการทั้งสามอย่างพร้อมกัน ซึ่งเป็นเหตุผลที่เราออกแบบ DubSmart ให้เป็นที่เดียวสำหรับการสร้าง แปลเป็นภาษาท้องถิ่น และขยายสื่อ—เสียง วิดีโอ และภาพ—แทนที่จะเป็นเครื่องกำเนิดวัตถุประสงค์เดียว
สำหรับกลุ่มเป้าหมายที่เราให้บริการ การขยายมักจะมีรูปแบบที่จดจำได้ ครีเอเตอร์ YouTube เปลี่ยนวิดีโอหลักหนึ่งชิ้นให้เป็นเวอร์ชันพากย์เสียงสำหรับหลายตลาด บวกกับคลิปสั้นและโปรโม ธุรกิจขนาดเล็กแปลงวิดีโออธิบายภาษาอังกฤษจำนวนหนึ่งให้เป็นช่องทางการตลาดหลายภาษาที่สมบูรณ์ ทั้งวิดีโอหน้าแลนดิ้ง สื่อโฆษณา และคลิปแนะนำวิธีใช้ ทีม e-learning เปลี่ยนคอร์สหนึ่งให้เป็นการบรรยายที่สอดคล้องกันและฉบับแปลเป็นภาษาท้องถิ่นในหลายภูมิภาค ผู้สร้างภาพยนตร์และพอดแคสต์เตอร์นำต้นฉบับกลับมาใช้ใหม่สำหรับการเผยแพร่ในระดับนานาชาติและเวอร์ชันที่เข้าถึงได้ นักพัฒนาและเอเจนซีฝังเสียงและการพากย์เข้าไปในผลิตภัณฑ์ของตนโดยตรงผ่าน API ของเรา
การตัดสินใจที่อยู่เบื้องหลังทั้งหมดนี้เหมือนกัน: หยุดผลิตทุกชิ้นงานในฐานะโปรเจกต์ใหม่ และเริ่มผลิตต้นฉบับที่คุณตั้งใจจะขยายผลเป็นทวีคูณ
จากการผลิตด้วยมือสู่เวิร์กโฟลว์ที่เร่งความเร็วด้วย AI
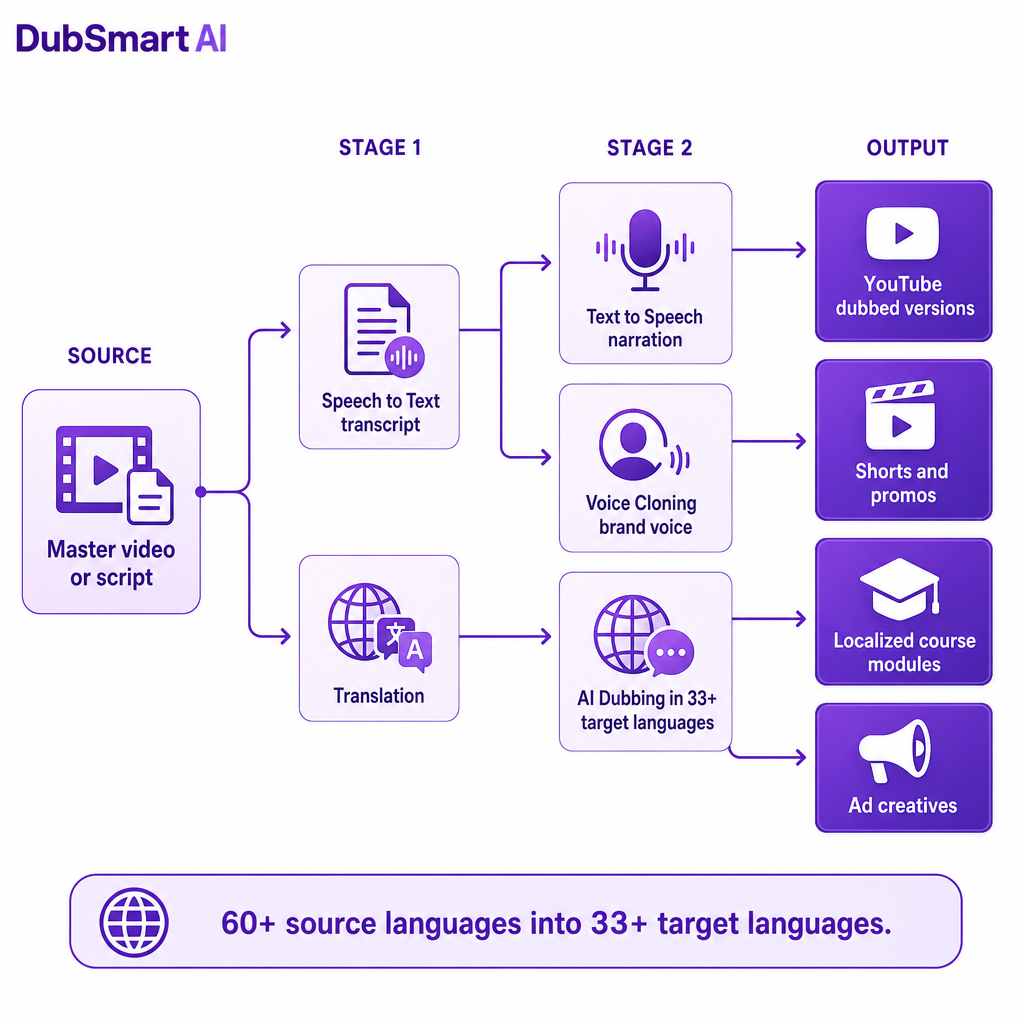
ไปป์ไลน์แบบใช้มือทำซ้ำขั้นตอนที่มีค่าใช้จ่ายสูงเดิม ๆ สำหรับทุกชิ้นงาน: เขียนบท จองและบันทึกเสียงพากย์โดยมนุษย์ ตัดต่อ มิกซ์ มาสเตอร์ จากนั้นแปลและบันทึกเสียงใหม่สำหรับแต่ละภาษา ก่อนที่จะส่งออกและส่งออกซ้ำสำหรับการแก้ไขทุกครั้ง แต่ละภาษาหรือรูปแบบใหม่จะเริ่มต้นห่วงโซ่นั้นส่วนใหญ่ใหม่
เวิร์กโฟลว์ที่เร่งความเร็วด้วย AI รักษาการตัดสินใจเชิงสร้างสรรค์ไว้และทำการผลิตที่ทำซ้ำได้ให้เป็นอัตโนมัติ ในแพลตฟอร์มของเรา ขั้นตอนที่เคยต้องใช้การจัดตารางเวลา ซอฟต์แวร์ และผู้ให้บริการแยกกันนั้นอยู่ในพื้นที่ทำงานบนเบราว์เซอร์เดียว:
- Text to Speech แปลงบทที่เขียนเป็นการบรรยายที่ฟังดูเป็นธรรมชาติในไม่กี่วินาที โดยใช้คลังเสียงกว่า 300+ เสียงในหลายภาษา
- Voice Cloning สร้างเสียงขึ้นมาใหม่จากตัวอย่างสั้น ๆ เพื่อให้บุคลิกของแบรนด์หรือครีเอเตอร์คงเส้นคงวาในทุกโปรเจกต์และทุกภาษา
- AI Dubbing นำวิดีโอหรือเสียงต้นฉบับมาถอดเสียง แปล และสร้างแทร็กเสียงที่แปลเป็นภาษาท้องถิ่นใน 33+ ภาษาปลายทางจาก 60+ ภาษาต้นทาง
- Speech to Text และ Speech Separator ทำความสะอาดและถอดเสียงการบันทึกที่มีอยู่ ทำให้คลังข้อมูลสามารถค้นหาได้และพร้อมแก้ไขใหม่
- Text to Image และ Image to Video สร้างภาพจากพรอมต์และเปลี่ยนภาพนิ่งให้เป็นภาพเคลื่อนไหว เพื่อให้คุณสามารถส่งแคมเปญออกได้โดยไม่ต้องเริ่มจากฟุตเทจ
กลไกที่สร้างการขยายผลได้จริง ๆ ไม่ใช่ฟีเจอร์ใดฟีเจอร์หนึ่งเหล่านี้ แต่คือการรวมเข้าด้วยกัน: ผลลัพธ์ของขั้นตอนหนึ่งป้อนเข้าสู่ขั้นตอนถัดไปภายในระบบเดียวกัน ดังนั้นบทจึงกลายเป็นการบรรยาย การบรรยายกลายเป็นแคตตาล็อกที่พากย์เสียง และสคริปต์ถอดเสียงกลายเป็นชิ้นงานเขียนและภาพใหม่—โดยไม่ต้องส่งออกระหว่างแอปที่ไม่เชื่อมต่อกัน
กลไกหลักที่เพิ่มผลงานของคุณเป็นทวีคูณ
การบรรยายโดยไม่ต้องจองทีมงานเพิ่ม
ด้วยเครื่องมือ Text to Speech ของเรา คุณสามารถวางบท เลือกจากเสียงชาย หญิง และเสียงกลางหลายร้อยเสียง และสร้างการบรรยายได้ทันที สิ่งนี้เปลี่ยนวิธีที่คุณวางแผน: คุณสามารถเขียนบทก่อนและสร้างเสียงทีหลัง ทดสอบโทนเสียงหลาย ๆ แบบก่อนที่จะตัดสินใจ และผลิตซีรีส์ที่สอดคล้องกัน—โมดูลคอร์ส เซ็กเมนต์พอดแคสต์ ฟลว์การเริ่มต้นใช้งาน—โดยไม่ต้องจัดเซสชันบันทึกเสียง
การโคลนเสียง ขยายสิ่งนี้โดยให้คุณสร้างเสียงที่กำหนดเองซึ่งนำกลับมาใช้ใหม่ได้จากตัวอย่างสั้น ๆ และนำไปใช้ได้ทั้งในการบรรยายและการพากย์ สำหรับแบรนด์ นั่นหมายถึงเสียงพิธีกรที่จดจำได้หนึ่งเสียงในทุกภาษา แม้ว่าทีมงานต้นฉบับจะไม่อยู่ในห้องก็ตาม บวกกับพื้นที่สำหรับความหลากหลายที่ตั้งใจ—เสียงฝึกอบรมภายในที่สงบกว่า ควบคู่ไปกับเสียงการตลาดที่กระฉับกระเฉงกว่า—ในขณะที่ยังคงเป็นไปตามแบรนด์
ต้นฉบับหนึ่งชิ้น หลายภาษา
การพากย์คือกลไกหลักสำหรับการเปลี่ยนคอนเทนต์ชิ้นเดียวให้เป็นแคตตาล็อกระดับโลก ในทางปฏิบัติ คุณอัปโหลดวิดีโอหรือวางลิงก์ แพลตฟอร์มของเราจะตรวจจับผู้พูด ถอดเสียงและแปลคำพูด และสร้างแทร็กที่แปลเป็นภาษาท้องถิ่นโดยใช้เอนจินเสียงเดียวกัน จากนั้นคุณปรับจังหวะเวลา ผู้พูด และส่วนข้อความในโปรแกรมแก้ไขก่อนที่จะส่งออกในรูปแบบที่คุณเลือก
ฟีเจอร์ที่ทำให้สิ่งนี้ขยายผลได้มากกว่าแค่การแปล คือการตรวจจับผู้พูดหลายคน—จำเป็นสำหรับการสัมภาษณ์ การเสวนา และบทสนทนาตามสคริปต์—ความครอบคลุมภาษาที่กว้างขวาง และการผสานรวมอย่างแน่นแฟ้นกับการโคลนเสียง เพื่อให้แต่ละเวอร์ชันที่พากย์สามารถคงเอกลักษณ์ของผู้พูดต้นฉบับหรือใช้เสียงแบรนด์ที่สอดคล้องกันได้ สำหรับกลยุทธ์แบบทีละขั้นตอน คู่มือของเราเกี่ยวกับวิธีสร้างช่อง YouTube หลายภาษาครอบคลุมเวิร์กโฟลว์เชิงปฏิบัติการ บทความอธิบายนี้มุ่งเน้นว่าทำไมคุณจึงนำมันมาใช้
การเปลี่ยนคลังข้อมูลให้เป็นคอนเทนต์ใหม่
การขยายผลไม่ได้เกี่ยวกับการผลิตใหม่เท่านั้น ผลงานที่ยังไม่ได้ใช้ประโยชน์ส่วนใหญ่อยู่ในการบันทึกของคุณอยู่แล้ว Speech to Text สร้างสคริปต์ถอดเสียงและคำบรรยายที่แม่นยำ ซึ่งทำให้เสียงและวิดีโอเก่าสามารถค้นหาได้ แก้ไขได้ และพร้อมนำกลับมาใช้ใหม่ Speech Separator แยกเสียงออกจากเพลงและเสียงรบกวนพื้นหลัง เพื่อให้คุณสามารถทำความสะอาด รีมิกซ์ หรือนำแทร็กกลับมาใช้ใหม่ได้โดยไม่ต้องบันทึกซ้ำ
เมื่อรวมกัน สิ่งเหล่านี้ปลดล็อกแคตตาล็อกพอดแคสต์เก่าให้กลายเป็นบล็อกโพสต์ คลิปสั้น และตอนที่พากย์เสียง การฝึกอบรมที่บันทึกไว้ให้กลายเป็นโมดูลที่มีโครงสร้างพร้อมการบรรยายและคำบรรยายที่สะอาด และฟุตเทจแบบหยาบที่สามารถขัดเกลาให้เป็นผลงานคุณภาพสูงขึ้นได้ หากคุณต้องการกระบวนการปฏิบัติจริง คำแนะนำแบบทีละขั้นตอนของเราเกี่ยวกับวิธีการถอดเสียงเป็นข้อความครอบคลุมเรื่องนี้โดยตรง
ภาพที่ความเร็วของคอนเทนต์
ทีมมักจะชนเพดานการขยายผลในด้านการออกแบบและวิดีโอ ไม่ใช่เสียง เครื่องกำเนิดภาพ AI ของเราสร้างภาพที่เป็นไปตามแบรนด์จากพรอมต์สำหรับภาพขนาดย่อ โพสต์โซเชียล และสไลด์ ในขณะที่ Image to Video แปลงภาพนิ่งให้เป็นภาพเคลื่อนไหวที่เหมาะสำหรับวิดีโออธิบาย โฆษณา และอินโทร เมื่อรวมกับการบรรยายและการพากย์ สิ่งนี้ช่วยให้คุณสามารถเคลื่อนจากบทไปสู่เสียง AI ไปสู่ภาพ AI ไปสู่การพากย์ที่แปลเป็นภาษาท้องถิ่นภายในระบบเดียว แทนที่จะต้องเย็บแอปแยกกันเข้าด้วยกันสำหรับแต่ละขั้นตอน
ทีมต่าง ๆ วางโครงสร้างกลยุทธ์การขยายของตนอย่างไร
เนื่องจากแพลตฟอร์มรวมเครื่องมือเหล่านี้ไว้ด้วยกัน กลยุทธ์ที่ถูกต้องจึงขึ้นอยู่กับว่าคุณเริ่มต้นที่ไหน
ครีเอเตอร์ YouTube และผู้สร้างภาพยนตร์อิสระ พึ่งพาการพากย์เพื่อเปลี่ยนวิดีโอหลักแต่ละชิ้นให้เป็นเวอร์ชันหลายภาษาด้วยการรองรับผู้พูดหลายคนและเสียงโคลนที่สอดคล้องกัน จากนั้นจับคู่กับโปรโมสั้น ๆ ที่บรรยายโดย Text to Speech เพื่อให้ปฏิทินเต็มอยู่เสมอโดยไม่ต้องถ่ายทำเพิ่ม
ธุรกิจขนาดเล็กและทีมการตลาด มองว่าแพลตฟอร์มเป็นตัวคูณคอนเทนต์: เขียนบทหรือบันทึกวิดีโออธิบายหลักหนึ่งชิ้น จากนั้นแปลเป็นภาษาท้องถิ่นและสร้างคลิปแนะนำการใช้ผลิตภัณฑ์และสื่อโฆษณา พร้อมภาพและวิดีโอสั้นที่เข้าชุดกัน เพื่อให้การเปิดตัวในหลายภูมิภาคไม่ต้องใช้งบประมาณออกแบบตามสัดส่วน
ผู้ผลิต e-learning และการฝึกอบรมองค์กร สร้างการบรรยายที่ชัดเจนและสอดคล้องกันสำหรับโมดูล จากนั้นแปลคอร์สเป็นภาษาท้องถิ่นผ่านการพากย์ และเพิ่มคำบรรยายที่แม่นยำด้วย Speech to Text—รักษาแคตตาล็อกขนาดใหญ่ให้สอดคล้องกันในขณะที่สนับสนุนทีมหลายภาษา
พอดแคสต์เตอร์และครีเอเตอร์ที่เน้นเสียงเป็นหลัก ทำความสะอาดบทสนทนาด้วย Speech Separator ถอดเสียงสำหรับการแก้ไขและคำบรรยาย และนำชิ้นงานเหล่านั้นกลับมาใช้ใหม่ในตอนที่พากย์หรือสรุป เมื่อการเผยแพร่ต้องการความประณีตระดับภาพยนตร์หรือระดับออกอากาศพร้อมการกำกับดูแลโดยมนุษย์ เลเยอร์สตูดิโอพากย์เสียงมืออาชีพของเราจะเพิ่มการกำกับดูแลนั้น
นักพัฒนาและเอเจนซี ผสานรวม AI Dubbing API ของเราพร้อมกับ Text to Speech และ Voice Cloning API เพื่อฝังเสียงและการแปลเป็นภาษาท้องถิ่นที่ขยายได้ภายในผลิตภัณฑ์ของตน—เหมาะสำหรับแพลตฟอร์มการเรียนรู้ แอป OTT และเครื่องมือวิดีโอโซเชียลที่ต้องการการพากย์อัตโนมัติในปริมาณมาก
การตัดสินใจว่าเมื่อใดการผลิตแบบ AI-first คือทางเลือกที่ถูกต้อง
ปัจจัยห้าประการมักจะกำหนดว่าสแต็กแบบ AER-first คุ้มค่าที่จะใช้มากกว่าการเพิ่มฟรีแลนซ์และเครื่องมือแบบใช้ครั้งเดียวหรือไม่
| ปัจจัยในการตัดสินใจ | การผลิตแบบ AI-first เหมาะเมื่อ | สิ่งที่แพลตฟอร์มของเรามอบให้ |
|---|---|---|
| ปริมาณและความถี่ | คุณเผยแพร่ซีรีส์รายสัปดาห์ รายการหลายตอน หรือคอร์สหลายโมดูล | พื้นที่ทำงานที่สร้างขึ้นสำหรับครีเอเตอร์และธุรกิจที่มีปริมาณสูง |
| ความครอบคลุมภาษาและตลาด | การเข้าถึงระดับนานาชาติหรือการเข้าถึงได้เป็นสิ่งสำคัญ | การพากย์จาก 60+ ภาษาต้นทางเป็น 33+ ภาษาปลายทาง พร้อมการถอดเสียงและการแปลในตัว |
| งบประมาณและโครงสร้างต้นทุน | ต้นทุนมนุษย์ต่อเซสชันคาดเดาไม่ได้ | โมเดลแบบเครดิตพร้อมเครดิตที่ยกยอดได้และระดับฟรีเพื่อจัดสรรข้ามเครื่องมือ |
| เสียงแบรนด์และคุณภาพ | คุณต้องการเสียงพิธีกร ตัวละคร หรือแบรนด์ที่สอดคล้องกัน | การโคลนเสียงพร้อมคลังเสียงกว่า 300+ เสียง พร้อมตัวเลือกสตูดิโอที่กำกับโดยมนุษย์สำหรับงานตัดต่อที่สำคัญ |
| เวิร์กโฟลว์และการควบคุม | คุณต้องการการกำกับดูแลด้านบรรณาธิการ ไม่ใช่ผลลัพธ์แบบกล่องดำ | โปรแกรมแก้ไขโปรเจกต์บนเบราว์เซอร์ การควบคุมผู้พูดหลายคน และ API |
หากมีหลายแถวที่อธิบายสถานการณ์ของคุณ การรวมศูนย์ไว้บนแพลตฟอร์มเดียวมักจะยั่งยืนกว่าการขยายกลุ่มผู้ให้บริการที่กระจัดกระจายและแอปที่ใช้วัตถุประสงค์เดียว หากมีเพียงแถวเดียว อาจคุ้มค่าที่จะนำเครื่องมือเดียวมาใช้ก่อนและขยายสแต็กเมื่อแคตตาล็อกของคุณเติบโต
ความเสี่ยงที่ควรจัดการก่อนที่คุณจะขยาย
การขยายด้วย AI นำมาซึ่งความเสี่ยงที่แท้จริง และมีบางประการที่สมควรมีแผนมากกว่าการยักไหล่
เสียงที่ฟังดูเป็นหุ่นยนต์หรือน่าเชื่อถือต่ำ คำพูดสังเคราะห์ที่บาง ๆ บั่นทอนความน่าเชื่อถือ การเลือกเสียงตามกรณีการใช้งาน—เลือกต่างกันสำหรับโฆษณา การฝึกอบรม และพอดแคสต์—และการทดสอบก่อนการเผยแพร่จะรักษาคุณภาพให้สูงในคลังเสียงขนาดใหญ่
เสียงแบรนด์ที่กระจัดกระจาย การกระจายงานข้ามเครื่องมือและฟรีแลนซ์จำนวนมากทำให้เอกลักษณ์ของคุณแตกออก โปรไฟล์เสียงโคลนที่นำกลับมาใช้ใหม่ได้ซึ่งใช้ข้ามการพากย์และการบรรยายจะรักษาเสียงที่จดจำได้หนึ่งเสียง
การแปลและความละเอียดอ่อนทางวัฒนธรรม การแปลอัตโนมัติเคลื่อนที่เร็วแต่อาจพลาดสำนวนและโทน สำหรับคอนเทนต์ที่มีความเสี่ยงสูง เช่น ภาพยนตร์ การออกอากาศ หรือการฝึกอบรมที่ละเอียดอ่อน ให้เพิ่มการตรวจสอบโดยมนุษย์—บริการสตูดิโอมืออาชีพของเรามีอยู่เพื่อกรณีเหล่านั้นโดยเฉพาะ
สิทธิและความยินยอมสำหรับเสียงสังเคราะห์ การโคลนเสียงก่อให้เกิดคำถามเรื่องการอนุญาตและความยินยอม ให้ปฏิบัติต่อเสียงที่โคลนในฐานะชิ้นงานที่ต้องมีการบันทึกการอนุญาต และเก็บการใช้งานไว้ภายในพื้นที่ทำงานที่มีการจัดการแทนที่จะเป็นเครื่องกำเนิดที่ไม่ระบุตัวตน สำหรับภาระผูกพันเฉพาะเขตอำนาจศาล ให้ยืนยันข้อกำหนดสำหรับสถานการณ์ของคุณเอง
การใช้ในทางที่ผิดและดีปเฟก เอนจินเสียงที่มีความสามารถใด ๆ สามารถถูกใช้ในทางที่ผิดได้เมื่อการกำกับดูแลอ่อนแอ การเก็บโปรเจกต์ไว้ในแพลตฟอร์มเดียวภายใต้นโยบายองค์กรที่ชัดเจน ทำให้ควบคุมเสียงสังเคราะห์ได้ง่ายกว่าเครื่องมือเฉพาะกิจที่กระจัดกระจายมาก
หากคุณยังคงชั่งน้ำหนักระหว่างการบรรยายด้วย AI กับการบันทึกเสียงทีมงาน การเปรียบเทียบการพากย์กับคำบรรยายสำหรับวิดีโอของเราสามารถช่วยคุณตัดสินใจว่าจะแปลเป็นภาษาท้องถิ่นไปไกลแค่ไหนก่อนที่จะทุ่มเทให้กับทั้งแคตตาล็อก
คำถามที่พบบ่อย
อะไรทำให้แพลตฟอร์มแบบครบวงจรแตกต่างจากเครื่องมือ text-to-speech เดียว?
เครื่องมือเดียวแก้ปัญหาขั้นตอนเดียว เรารวม Text to Speech, Voice Cloning, AI Dubbing, Speech to Text, Speech Separator, Text to Image และ Image to Video ไว้ในพื้นที่ทำงานเดียว เพื่อให้คุณเคลื่อนจากบทหรือวิดีโอต้นฉบับไปสู่คอนเทนต์หลายรูปแบบที่แปลเป็นภาษาท้องถิ่นอย่างสมบูรณ์โดยไม่ต้องสลับแอปหรือส่งออกระหว่างกัน
ในความเป็นจริงฉันสามารถรองรับได้กี่ภาษา?
AI Dubbing ของเรารองรับการพากย์จาก 60+ ภาษาต้นทางเป็น 33+ ภาษาปลายทาง หนุนหลังด้วยคลังเสียงกว่า 300+ เสียงและการโคลนเสียง ความครอบคลุมนั้นทำให้มันเป็นไปได้ในทางปฏิบัติสำหรับทีมเล็ก ๆ ที่จะดำเนินช่องทางระดับโลกอย่างแท้จริง
นี่สำหรับครีเอเตอร์เดี่ยวเท่านั้นหรือทีมก็ใช้ได้?
ทั้งสองอย่าง เราให้บริการครีเอเตอร์รายบุคคลและธุรกิจ รวมถึงเวิร์กโฟลว์การพากย์เสียงมืออาชีพที่มีการกำกับดูแลโดยมนุษย์และ API สำหรับนักพัฒนา—ดังนั้นแพลตฟอร์มเดียวกันจึงเหมาะกับ YouTuber เดี่ยวและทีมฝึกอบรมระดับองค์กร
ฉันสามารถผสานรวมเข้ากับแอปของฉันเองหรือสแต็กระบบอัตโนมัติได้หรือไม่?
ได้ AI Dubbing, Text to Speech และ Voice Cloning API ของเราช่วยให้นักพัฒนาและเอเจนซีฝังเสียงและการแปลเป็นภาษาท้องถิ่นที่ขยายได้โดยตรงเข้าไปในผลิตภัณฑ์และไปป์ไลน์ของตน
ฉันสามารถเปลี่ยนจากภาษาเดียวไปสู่การมีตัวตนหลายภาษาได้เร็วแค่ไหน?
กรอบเวลาขึ้นอยู่กับขนาดแคตตาล็อกและกระบวนการตรวจสอบของคุณ เนื่องจากการถอดเสียง การแปล การสร้างเสียง และการแก้ไขโปรเจกต์อยู่ในที่เดียว ทีมเล็ก ๆ จึงสามารถเปลี่ยนชิ้นงานหลักไม่กี่ชิ้นให้เป็นเวอร์ชันที่แปลเป็นภาษาท้องถิ่นจำนวนมากได้ในไม่กี่วันหรือไม่กี่สัปดาห์แทนที่จะเป็นหลายเดือน สำหรับการประเมินที่ปรับให้เหมาะกับคุณ บอกขนาดแคตตาล็อก ภาษาปลายทาง และข้อกำหนดการตรวจสอบของคุณ แล้วเราสามารถวางแผนที่เป็นจริงได้