วิธีที่รวดเร็วที่สุดในการเชื่อมต่อ text to speech API คือการมองว่ามันเป็นบริการ REST: ยืนยันตัวตนด้วย API key ส่งข้อความของคุณพร้อมการตั้งค่าเสียงในรูปแบบ JSON ปล่อยให้บริการเรนเดอร์เสียงพูดในเบื้องหลัง จากนั้นดึงและจัดเก็บไฟล์เสียงที่ได้เพื่อเล่นในที่ที่ผู้ใช้ของคุณต้องการ Text to Speech API ของเราทำตามรูปแบบนี้ทุกประการพร้อมให้เข้าถึงเสียงธรรมชาติกว่า 300 เสียงและการโคลนเสียงแบบไม่จำกัด ดังนั้นคุณจึงสามารถเพิ่มเสียงพูดที่สมจริงลงในเว็บไซต์ แอป ไปป์ไลน์วิดีโอ และแพลตฟอร์มการเรียนรู้ได้ คู่มือนี้จะพาคุณผ่านสิ่งที่คุณกำลังเชื่อมต่อเข้าไปจริง ๆ วิธีที่เอนจินของเราทำงาน และการตัดสินใจที่กำหนดว่าการเชื่อมต่อนี้เหมาะกับผลิตภัณฑ์ของคุณหรือไม่
สารบัญ
Text to speech API ทำอะไรได้บ้างใน DubSmart
Text to speech API แปลงข้อความที่มีโครงสร้างให้เป็นเสียงพูดตามความต้องการ ดังนั้นโค้ดของคุณจึงสามารถขอการบรรยายหรือบทสนทนาได้ทันทีที่สคริปต์พร้อม แทนที่จะต้องรอการบันทึกด้วยมือ เอนจิน Text to Speech ของเราขับเคลื่อนทั้งเครื่องมือ Text to Speech บนเบราว์เซอร์และ API โดยให้เข้าถึงเสียง AI กว่า 300 เสียงในหลายภาษา เพศ และสไตล์ พร้อมการปรับจังหวะเสียงให้เหมาะกับการบรรยาย คำอธิบาย และบทสนทนา
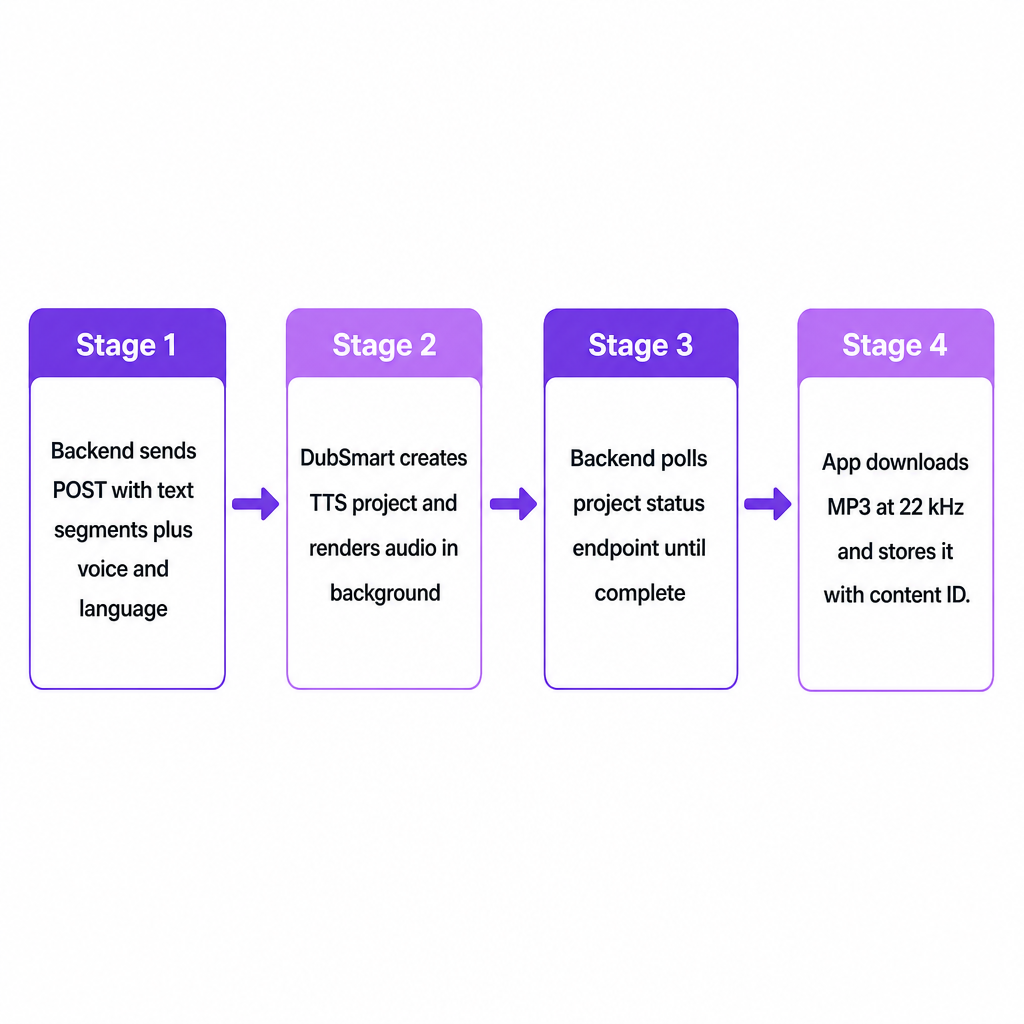
ที่ชั้น API เราเปิดเผยเอนจินนี้เป็นบริการ RESTful: แบ็กเอนด์ของคุณส่งคำขอ POST ที่มีส่วนข้อความและพารามิเตอร์เสียง และบริการจะส่งคืนอ็อบเจกต์โปรเจกต์ที่คุณสามารถ poll สถานะจนกว่าเสียงจะพร้อมสำหรับดาวน์โหลด ผลลัพธ์ถูกส่งมอบเป็นไฟล์เสียงคุณภาพสูง โดยทั่วไปเป็น MP3 ที่ 22 kHz เหมาะสำหรับการใช้งานโดยตรงในโปรแกรมตัดต่อวิดีโอ เวิร์กโฟลว์พอดแคสต์ หรือเว็บเพลเยอร์โดยไม่ต้องแปลงเพิ่มเติม
สำหรับครีเอเตอร์และทีมที่เราให้บริการ—YouTuber ธุรกิจขนาดเล็ก ผู้ผลิต e-learning ผู้สร้างภาพยนตร์ และเอเจนซีนักพัฒนา—API เชื่อมโยงการวางแผนเนื้อหาเข้ากับการเผยแพร่ ทันทีที่สคริปต์เข้าสู่ CMS หรือแพลตฟอร์มการเรียนรู้ แบ็กเอนด์สามารถสร้างเสียงบรรยายได้โดยอัตโนมัติ ซึ่งขจัดคอขวดของการบันทึกด้วยมือซ้ำ ๆ
การตัดสินใจเชื่อมต่อ: คุณกำลังเชื่อมต่ออะไรเข้าไปจริง ๆ?
"เชื่อมต่อ text to speech API" ฟังดูเป็นเรื่องทั่วไป แต่ในทางปฏิบัติคุณกำลังตัดสินใจสามเรื่อง: จุดใดในเวิร์กโฟลว์ของคุณที่ควรสร้างเสียงพูด เสียงและภาษาใดจะเป็นตัวแทนแบรนด์ของคุณ และคุณจะทำให้การสร้างและการดึงเสียงเป็นอัตโนมัติมากน้อยเพียงใด
สำหรับครีเอเตอร์ YouTube ที่ขยายไปสู่เนื้อหาหลายภาษา การเชื่อมต่อมักหมายถึงการผูก API ของเราเข้ากับเครื่องมือวางแผนวิดีโอหรือฐานข้อมูลสคริปต์ เพื่อให้แต่ละสคริปต์ที่เสร็จสมบูรณ์กลายเป็นเสียงบรรยายในภาษาและสไตล์ที่ถูกต้อง สำหรับธุรกิจขนาดเล็กและทีมการตลาด API มักอยู่เบื้องหลัง CMS หรือแพลตฟอร์มการตลาดอัตโนมัติ โดยแปลงบล็อกโพสต์ คำอธิบายผลิตภัณฑ์ และเนื้อหาโซเชียลให้เป็นสินทรัพย์เสียงที่นำกลับมาใช้ซ้ำได้ ผู้ให้บริการ e-learning และการฝึกอบรมองค์กรมักจะเชื่อมต่อ API เข้ากับเครื่องมือสร้างเนื้อหา เพื่อให้โมดูลบทเรียนสามารถขอการบรรยายต่อสไลด์หรือต่อหัวข้อ และสร้างใหม่ได้ทันทีเมื่อเนื้อหาอัปเดต
นักพัฒนาและเอเจนซีที่เชื่อมต่อ voice AI อย่างลึกซึ้งมากขึ้นมักเลือกระหว่างสองรูปแบบ โมเดลแบบ batch จะรวบรวมสคริปต์และประมวลผลผ่านงานที่กำหนดเวลาไว้ โมเดลแบบ transactional จะเรียกคำขอทันทีทุกครั้งที่มีเนื้อหาใหม่หรือการกระทำของผู้ใช้เข้ามา API แบบ project-based ของเราทำงานได้อย่างสะอาดสำหรับทั้งสองแบบ เพราะแต่ละโปรเจกต์ TTS ห่อหุ้มข้อความ การเลือกเสียง ภาษา และเสียงที่ได้ในลักษณะที่แมปเข้ากับหน่วยเนื้อหาของคุณเอง—วิดีโอ บทเรียน หรือตอนพอดแคสต์ หากคุณยังชั่งน้ำหนักแนวคิดนี้อยู่ คำอธิบายเสริมของเราเกี่ยวกับ text to speech API คืออะไรและทำงานอย่างไรครอบคลุมพื้นฐานก่อนที่คุณจะตัดสินใจเลือกดีไซน์
Text to Speech API ของเราทำงานอย่างไรเบื้องหลัง
Text to Speech API ของเราถูกสร้างขึ้นรอบ ๆ โปรเจกต์และเซกเมนต์ ซึ่งทำให้ยืดหยุ่นกว่าเอนด์พอยต์แบบ "ข้อความเข้า เสียงออก" เดี่ยว โปรเจกต์ TTS จัดกลุ่มเซกเมนต์ข้อความหนึ่งรายการหรือมากกว่านั้นภายใต้ชื่อและการกำหนดค่าที่ใช้ร่วมกัน เช่น ภาษาและเสียงเริ่มต้น แต่ละเซกเมนต์มีข้อความ ตัวระบุเสียง และแท็กภาษาของตัวเอง ซึ่งช่วยให้คุณผสมสไตล์การบรรยายหรือภาษาภายในผลลัพธ์เดียวได้
เพย์โหลด JSON ทั่วไปที่ส่งไปยังเอนด์พอยต์โปรเจกต์ TTS ประกอบด้วยชื่อโปรเจกต์ที่มนุษย์อ่านได้สำหรับแดชบอร์ดและบันทึกของคุณ พร้อมด้วยอาร์เรย์ของเซกเมนต์ แต่ละเซกเมนต์ตั้งค่า text (สคริปต์หรือประโยคที่จะพูด), voice (ทั้ง voice ID แบบในตัวหรือ voice ID แบบกำหนดเองที่สร้างผ่าน Voice Cloning API) และ language (รหัสที่ระบุภาษาของเซกเมนต์)
เมื่อแบ็กเอนด์ของคุณส่งเพย์โหลดนี้ไปยังเอนด์พอยต์ TTS พร้อม API key ที่ถูกต้องในส่วนหัว Authorization เราจะสร้างโปรเจกต์และเริ่มเรนเดอร์เสียงในเบื้องหลัง API เปิดเผยเอนด์พอยต์สถานะโปรเจกต์ที่รายงานว่าการประมวลผลยังดำเนินอยู่หรือเสร็จสมบูรณ์แล้ว พร้อมด้วยการอ้างอิงไฟล์เสียงที่สร้างขึ้นเมื่อพร้อม การออกแบบแบบ asynchronous นี้ทำให้คำขอของคุณเองรวดเร็ว: บันทึก project ID คืนการควบคุมให้ผู้ใช้ และปล่อยให้ background worker ตรวจสอบความสมบูรณ์และดึงเสียงลงมาเมื่อพร้อม
เสียงพูดที่สร้างขึ้นมาถึงในรูปแบบไฟล์ที่ดาวน์โหลดได้ในรูปแบบมาตรฐาน โดยเฉพาะ MP3 ที่ 22 kHz ซึ่งเข้ากับเว็บเพลเยอร์ แอปมือถือ และไทม์ไลน์การตัดต่อวิดีโอได้อย่างง่ายดาย เนื่องจากเอนจินเดียวกันขับเคลื่อนเครื่องมือบนเบราว์เซอร์ของเรา นักพัฒนาจึงสามารถสร้างต้นแบบเสียงและสคริปต์แบบโต้ตอบได้ แล้วจึงย้ายชุดที่ชนะเข้าสู่การเรียก API อัตโนมัติ เอกสารอ้างอิงเอนด์พอยต์แบบเต็มอยู่บนหน้า Text to Speech API
การเชื่อมต่อการโคลนเสียงและ AI Dubbing เข้ากับ text to speech
คุณสมบัติที่โดดเด่นของเราคือ Text to Speech, Voice Cloning และ AI Dubbing ใช้เอนจินเสียงและเวิร์กโฟลว์พื้นฐานเดียวกัน นั่นหมายความว่า TTS API ไม่ได้แยกออกมา—มันเป็นแกนกลางของไปป์ไลน์การแปลเป็นภาษาท้องถิ่นที่กว้างกว่า
Voice Cloning API ให้คุณอัปโหลดตัวอย่างเสียงของผู้พูด สร้างเสียง AI แบบกำหนดเอง และอ้างอิงเสียงนั้นในโปรเจกต์ TTS เมื่อมีเสียงแบบกำหนดเองอยู่แล้ว ตัวระบุของมันจะกลายเป็นฟิลด์ voice ในเซกเมนต์ Text to Speech ของคุณ ดังนั้นการบรรยายจะเล่นด้วยเสียงที่โคลนแทนที่จะเป็นเสียงสต็อกทั่วไป ความต่อเนื่องนี้สำคัญสำหรับพิธีกร พอดแคสเตอร์ และโฆษกของแบรนด์ที่ต้องการเอกลักษณ์เสียงที่สอดคล้องกันในหลายภาษาและรูปแบบ หากคุณวางแผนที่จะเพิ่มการโคลน คู่มือของเราเกี่ยวกับการเชื่อมต่อ voice cloning API ในแอปของคุณครอบคลุมรายละเอียดต่าง ๆ
AI Dubbing API ขยายเรื่องนี้ต่อไปโดยการรวมการถอดเสียง การแปล และ text to speech เข้าในไปป์ไลน์เดียวที่พากย์วิดีโอเป็นภาษาเป้าหมายมากกว่า 33 ภาษา ในที่นี้เอนจิน TTS แปลงสคริปต์ที่แปลแล้วให้เป็นเสียงพูดโดยใช้คลังเสียงกว่า 300 เสียงเดียวกันหรือเสียงที่โคลนของคุณ ดังนั้นเวอร์ชันที่พากย์จึงรักษาโทนและจังหวะไว้ สำหรับครีเอเตอร์และธุรกิจหลายภาษา Text to Speech API กลายเป็นองค์ประกอบพื้นฐานสำหรับทั้งเสียงบรรยายภาษาเดียวและเนื้อหาที่พากย์แบบแปลเป็นภาษาท้องถิ่นเต็มรูปแบบ ภาพรวมของเราเกี่ยวกับการแปลเป็นภาษาท้องถิ่นด้วย AI ทำงานอย่างไรแสดงให้เห็นว่าชิ้นส่วนเหล่านี้ประกอบเข้าด้วยกันแบบครบวงจรอย่างไร
เกณฑ์การตัดสินใจสำคัญเมื่อเชื่อมต่อ TTS API ของเรา
การเชื่อมต่อ TTS API "ใด ๆ" ไม่เพียงพอ ตัวเลือกรอบ ๆ การนำไปใช้กำหนดว่ามันเหมาะกับการผลิต แบรนด์ และสแตกเทคนิคของคุณดีเพียงใด
ความต้องการด้านสเกลและการทำอัตโนมัติ หากปริมาณเนื้อหาต่ำและไม่สม่ำเสมอ เครื่องมือบนเบราว์เซอร์อาจเพียงพอ เมื่อสคริปต์ถูกสร้างขึ้นเป็นประจำหรือผูกกับปฏิทินเนื้อหา ระบบจัดการการเรียนรู้ หรือการตลาดอัตโนมัติ API จะกลายเป็นชั้นที่เหมาะสม เพราะสามารถถูกเรียกแบบโปรแกรมและขยายไปกับแบ็กเอนด์ของคุณได้
กลยุทธ์ด้านเสียงและภาษา แพลตฟอร์มของเรารองรับการพากย์จากภาษาต้นทางกว่า 60 ภาษาเป็นภาษาเป้าหมาย 33 ภาษา ขับเคลื่อนโดยเอนจินเสียงเดียวกับที่ TTS API ใช้ หากแบรนด์ของคุณต้องการเสียงโฆษกที่เป็นเอกลักษณ์ การจับคู่ Voice Cloning API กับ TTS จะทำให้เสียงนั้นสอดคล้องกันในหลายภาษาและช่องทาง หากคุณให้ความสำคัญกับความเร็วมากกว่าการปรับให้เหมาะกับแต่ละคน เสียงในตัวจะทำให้การนำไปใช้ง่ายขึ้น
จุดเชื่อมต่อในสแตกของคุณ สำหรับช่อง YouTube จุดที่เป็นธรรมชาติคือไปป์ไลน์วิดีโอ: สคริปต์ที่จัดเก็บในเครื่องมือวางแผน ส่งไปยัง TTS API เมื่อเสร็จสมบูรณ์ และส่งคืนเป็นเสียงที่พร้อมสำหรับผู้ตัดต่อ แพลตฟอร์ม e-learning อาจเชื่อมต่อที่ระดับบทเรียนหรือสไลด์ โดยแต่ละบล็อกเนื้อหาแมปเข้ากับเซกเมนต์และโปรเจกต์แทนคอร์สทั้งหมด ทีมการตลาดมักเชื่อมต่อที่ระดับ CMS เพื่อให้แต่ละบทความหรือหน้าผลิตภัณฑ์สามารถขอเวอร์ชันเสียงเพื่อการเข้าถึงได้
การกำกับดูแล การปฏิบัติตามข้อกำหนด และความเสี่ยง เนื่องจากการโคลนเสียงสามารถจำลองเสียงที่จดจำได้ ความยินยอม การอนุญาตให้ใช้สิทธิ์ และนโยบายการใช้งานจึงมีความสำคัญ เสียงที่โคลนถูกระบุด้วย ID และสามารถแท็กด้วยเมทาดาทา ซึ่งทำให้ง่ายขึ้นในการบังคับใช้กฎภายในว่าเสียงใดอาจถูกใช้ที่ใด ตัดสินใจล่วงหน้าว่าสภาพแวดล้อมใดอาจเรียกใช้เสียงที่โคลนเทียบกับเสียงทั่วไป และเพิ่มการบันทึกในระบบของคุณเอง
ความคาดหวังด้าน latency และประสบการณ์ผู้ใช้ การประมวลผลแบบ asynchronous มอบความยืดหยุ่นแต่เพิ่มการพิจารณาด้านเวลา สำหรับเวิร์กโฟลว์ที่ผู้ใช้คาดหวังการเล่นทันที—เช่น โปรแกรมแก้ไขสคริปต์พร้อมพรีวิวทันที—ให้สร้างโปรเจกต์หรือเซกเมนต์ที่เล็กลงและแสดงตัวบ่งชี้ความคืบหน้าขณะเรนเดอร์เสียง สำหรับการแปลเป็นภาษาท้องถิ่นแบบ batch ทั่วทั้งคลัง latency มีความสำคัญน้อยลง และงานสามารถทำงานตามกำหนดเวลาโดยแนบเสียงที่เสร็จสมบูรณ์เข้ากับบันทึกเนื้อหาในภายหลัง
| ด้านการตัดสินใจ | โมเดล Batch | โมเดล Transactional |
|---|---|---|
| ตัวกระตุ้น | งานที่กำหนดเวลาไว้ | ต่อรายการเนื้อหาหรือการกระทำของผู้ใช้ |
| ความทนต่อ latency | สูง | ต่ำ |
| เหมาะสมที่สุดกับ | แคตตาล็อกคอร์ส คลังวิดีโอ | โปรแกรมแก้ไขสคริปต์ พรีวิวสด |
| กลยุทธ์เสียง | เสียงที่อนุมัติต่อภาษา | เสียงที่อนุมัติต่อภาษา |
ความเสี่ยงและมาตรการป้องกันเชิงปฏิบัติ
การเชื่อมต่อ text to speech API นำมาซึ่งความเสี่ยงที่คาดการณ์ได้บางประการซึ่งการออกแบบอย่างรอบคอบสามารถบรรเทาได้
การเลือกเสียงโดยไม่ทดสอบอาจสร้างเสียงพูดที่รู้สึกไม่เข้ากับแบรนด์หรือพิธีกร ทดลองเสียงในอินเทอร์เฟซแบบโต้ตอบก่อน และเก็บแคตตาล็อกเสียงที่อนุมัติแล้วไว้ในระบบของคุณเอง จัดระเบียบตามภาษาและประเภทเนื้อหา ก่อนที่จะกำหนด voice ID ในการเรียก API
การทำอัตโนมัติมากเกินไปสำหรับเนื้อหาที่ละเอียดอ่อนเป็นอีกกับดักหนึ่ง การสร้างเสียงพูดโดยอัตโนมัติสำหรับเนื้อหาด้านการปฏิบัติตามข้อกำหนด การแพทย์ หรือกฎหมายอาจไม่เหมาะสม เนื่องจาก API ของเราทำงานบนโปรเจกต์และเซกเมนต์ที่แยกออกจากกัน คุณสามารถรักษากฎการกำหนดเส้นทางที่ส่งเฉพาะหมวดหมู่ที่อนุมัติแล้วเข้าสู่ TTS ในขณะที่เก็บเนื้อหาที่ละเอียดอ่อนไว้ในเวิร์กโฟลว์ที่บันทึกโดยมนุษย์
ข้อผิดพลาดในการดำเนินงาน—โปรเจกต์ที่ล้มเหลวหรือการดาวน์โหลดที่หายไป—เกิดขึ้นเมื่อปัญหาเครือข่ายหรือเพย์โหลดที่ไม่ถูกต้องรบกวนการประมวลผล เอนด์พอยต์สถานะโปรเจกต์และการตอบกลับที่มีโครงสร้างช่วยให้คุณยืนยันได้ว่าโปรเจกต์เสร็จสมบูรณ์และผลลัพธ์พร้อมใช้งานก่อนเผยแพร่ จับคู่แต่ละ project ID ของ TTS กับ content ID ของคุณเอง และนำ retry หรือ fallback มาใช้เมื่อการตรวจสอบสถานะรายงานข้อผิดพลาด
การใช้เสียงที่โคลนในทางที่ผิดสมควรได้รับการควบคุมอย่างชัดเจน เสียงแบบกำหนดเองต้องถูกสร้างผ่านเอนด์พอยต์เฉพาะและอ้างอิงด้วย ID ในโปรเจกต์ TTS ซึ่งให้ขอบเขตทางเทคนิคที่ชัดเจนสำหรับการตรวจสอบ จำกัดว่าใครสามารถสร้างหรือกำหนด voice ID ที่โคลนได้ และบันทึกว่าถูกใช้ที่ไหน
เส้นทางเริ่มต้นเชิงปฏิบัติคือการเชื่อมต่อ TTS สำหรับเสียงบรรยายมาตรฐานก่อน ตรวจสอบความถูกต้องของเสียงและการจัดการข้อผิดพลาดในการใช้งานจริง จากนั้นจึงเพิ่ม Voice Cloning และ AI Dubbing เมื่อการเชื่อมต่อหลักมีเสถียรภาพ บอกเราเกี่ยวกับปริมาณเนื้อหาของคุณ ภาษาเป้าหมาย และตำแหน่งที่ API ควรอยู่ในสแตกของคุณ แล้วเราสามารถชี้ให้คุณไปยังเอนด์พอยต์ที่ถูกต้องและวางแผนสำหรับเวิร์กโฟลว์ของคุณได้
คำถามที่พบบ่อย
Text to Speech API แตกต่างจากเครื่องมือบนเบราว์เซอร์อย่างไร?
เครื่องมือบนเบราว์เซอร์เป็นอินเทอร์เฟซแบบภาพที่คุณวางข้อความ เลือกเสียง และดาวน์โหลดเสียงด้วยมือ API เปิดเผยเอนจินเดียวกันผ่านเอนด์พอยต์ REST เพื่อให้แบ็กเอนด์ของคุณสามารถสร้างและดึงเสียงได้โดยอัตโนมัติเพื่อตอบสนองต่อสคริปต์ กำหนดเวลา หรือการกระทำของผู้ใช้
API สามารถพูดด้วยเสียงของฉันเองได้ไหม ไม่ใช่แค่เสียงสต็อก?
ได้ โดยการเชื่อมต่อ Voice Cloning API คุณอัปโหลดตัวอย่างเสียงของผู้พูด สร้างเสียง AI แบบกำหนดเอง แล้วอ้างอิง ID ของเสียงนั้นในเซกเมนต์ Text to Speech ของคุณ เพื่อให้เสียงที่สร้างขึ้นทั้งหมดเล่นด้วยเสียงที่โคลน
สิ่งนี้ช่วยกับช่อง YouTube หรือพอดแคสต์หลายภาษาได้อย่างไร?
แพลตฟอร์มของเราแปลงเสียงพูดหรือสคริปต์จากภาษาต้นทางกว่า 60 ภาษาให้เป็นผลลัพธ์ที่พากย์ในภาษาเป้าหมาย 33 ภาษา โดย TTS สร้างเสียงสุดท้ายโดยใช้เสียงกว่า 300 เสียงหรือเสียงที่โคลนของคุณ การเชื่อมต่อ TTS และ AI Dubbing API เข้ากับไปป์ไลน์การเผยแพร่ของคุณช่วยให้วิดีโอหรือตอนใหม่ได้รับเสียงบรรยายหรือการพากย์เต็มรูปแบบเมื่อสคริปต์หรือเสียงต้นทางพร้อม
แอปหรือโปรแกรมตัดต่อของฉันจะได้รับรูปแบบเสียงใดบ้าง?
TTS API ส่งมอบไฟล์เสียงคุณภาพสูง รวมถึง MP3 ที่ 22 kHz เหมาะสำหรับสภาพแวดล้อมเว็บ มือถือ และการตัดต่อวิดีโอส่วนใหญ่โดยไม่ต้องแปลงเพิ่มเติม
ฉันสามารถเชื่อมต่อ Text to Speech ตอนนี้และเพิ่ม AI Dubbing ในภายหลังได้ไหม?
ได้ Text to Speech, Voice Cloning และ AI Dubbing ใช้ระบบนิเวศ API ร่วมกัน ดังนั้นคุณสามารถเริ่มต้นด้วย TTS สำหรับเสียงบรรยาย แล้วเพิ่ม Voice Cloning และ AI Dubbing ในภายหลังเพื่อทำให้การพากย์หลายภาษาเป็นอัตโนมัติโดยไม่ต้องสร้างการเชื่อมต่อหลักของคุณใหม่