ถ้าคุณถามว่าเสียงพากย์ AI สร้างขึ้นมาอย่างไร คุณกำลังถามจริง ๆ ว่าสคริปต์ที่เขียนไว้จะกลายเป็นคำพูดได้อย่างไรโดยที่ไม่มีใครต้องเข้าห้องอัด คำตอบสั้น ๆ คือ โมเดล neural text-to-speech จะแปลงสคริปต์ของคุณให้เป็นเสียงสังเคราะห์ เสียงโคลนที่เป็นตัวเลือกเสริมจะทำให้เสียงนั้นฟังดูเหมือนบุคคลใดบุคคลหนึ่ง และเลเยอร์การพากย์เสียงจะจัดทุกอย่างให้ตรงกับวิดีโอของคุณข้ามหลายภาษา ที่ DubSmart AI เรารันห่วงโซ่ทั้งหมดนั้นภายในพื้นที่ทำงานเดียว คุณจึงสามารถเริ่มจากข้อความหนึ่งย่อหน้าไปจนถึงเสียงพากย์หลายภาษาที่เสร็จสมบูรณ์ได้ โดยไม่ต้องสลับเครื่องมือหรือจองเวลาสตูดิโอ
กระบวนการนั้นจะเป็นอย่างไรสำหรับคุณ ขึ้นอยู่กับการตัดสินใจเพียงข้อเดียว และส่วนที่เหลือของคู่มือนี้จะพาคุณไปดูกลไก ตัวเลือก และวิธีการเลือก
สารบัญ
การตัดสินใจเบื้องหลังวิธีสร้างเสียงพากย์ AI
ก่อนที่จะมีการสร้างเสียงใด ๆ คุณต้องตัดสินใจสองอย่างที่กำหนดทุกสิ่งที่ตามมา อย่างแรกคือคุณต้องการเสียงสำเร็จรูปจากไลบรารีหรือเสียงโคลนของคุณเอง อย่างที่สองคือคุณต้องการเสียงพากย์ภาษาเดียวหรือเวอร์ชันที่ปรับให้เข้ากับท้องถิ่นอย่างสมบูรณ์ในหลายภาษา
สำหรับครีเอเตอร์ YouTube หรือธุรกิจขนาดเล็ก มักจะตัดสินใจได้อย่างรวดเร็ว นั่นคือเลือกเสียงสำเร็จรูปเพื่อความเร็ว โคลนเสียงเมื่อความสม่ำเสมอของแบรนด์มีความสำคัญ และหันไปพึ่งการพากย์เสียงเฉพาะเมื่อคุณจะทำหลายภาษา สำหรับนักพัฒนาและเอเจนซี ทางแยกเดียวกันนี้กลายเป็นคำถามด้านสถาปัตยกรรม — คุณจะเรียกใช้ text-to-speech endpoint เพื่อสร้างเสียงแบบครั้งเดียว หรือจะเชื่อมโยงการโคลนเสียงและการพากย์เสียงเข้าด้วยกันเป็นไปป์ไลน์ที่ทำงานได้ด้วยตัวเอง?
เราสร้าง DubSmart ขึ้นมารอบ ๆ ทางแยกเหล่านี้พอดี Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image, Image to Video และ AI Dubbing ทั้งหมดอยู่ในแพลตฟอร์มเดียว คุณจึงสามารถปรับระดับการทำงานอัตโนมัติและการปรับแต่งเฉพาะบุคคลขึ้นหรือลงได้โดยไม่ต้องเชื่อมต่อผู้ให้บริการหลายรายเข้าด้วยกัน
กลไก: เสียงพากย์ AI ถูกสร้างขึ้นจริง ๆ อย่างไร
Text to speech: การเปลี่ยนสคริปต์ให้เป็นเสียง
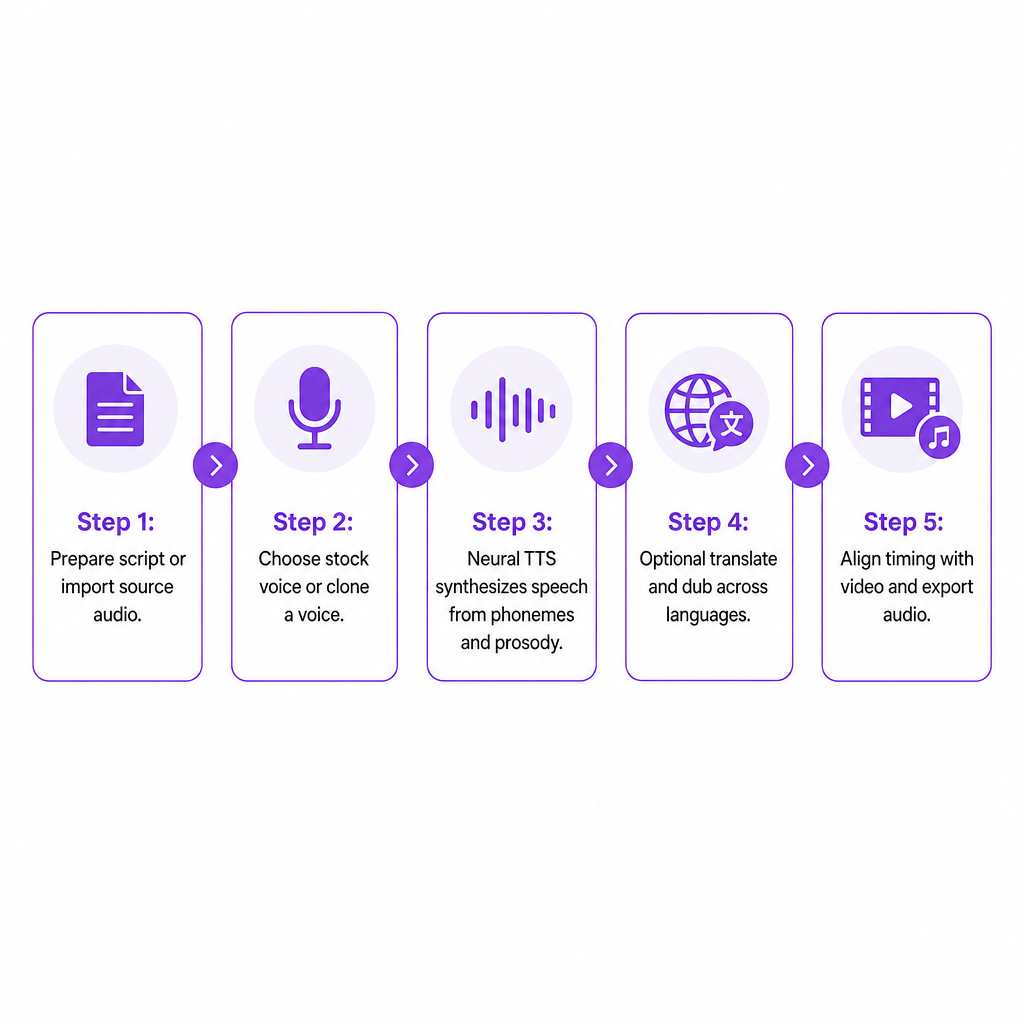
Text-to-speech (TTS) อยู่ที่ศูนย์กลางของเสียงพากย์ AI ทุกชิ้น เอนจินจะวิเคราะห์สคริปต์ของคุณก่อน — แบ่งข้อความออกเป็นหน่วยเสียง อ่านเครื่องหมายวรรคตอนและโครงสร้าง และอนุมาน prosody ซึ่งเป็นจังหวะ การเน้น และน้ำเสียงสูงต่ำที่ทำให้คำพูดไม่ฟังดูราบเรียบ จากนั้นโมเดล neural จะสังเคราะห์หน่วยเสียงเหล่านั้นให้เป็นเสียง และนำรูปแบบ prosody มาใช้เพื่อให้การนำเสนอฟังดูลื่นไหลแทนที่จะเหมือนหุ่นยนต์
เอนจิน Text to Speech ของเราให้คุณวางข้อความในภาษาใดก็ได้ เลือกเสียงจากไลบรารีที่มีมากกว่า 300 เสียง และสร้างคำพูดที่สมจริงได้ภายในไม่กี่วินาที เสียงเหล่านั้นฟังเป็นธรรมชาติและเหมือนมนุษย์ และถูกจัดหมวดหมู่ตามภาษา เพศ และสไตล์ คุณจึงสามารถจับคู่กับโทนของสิ่งที่คุณกำลังผลิตได้ สำหรับนักพัฒนา เอนจินเดียวกันนี้ถูกเปิดเผยผ่าน RESTful Text to Speech API: ส่งคำขอ POST พร้อมพารามิเตอร์ข้อความและเสียงของคุณ รับไฟล์เสียงพร้อมใช้งานกลับมา ป้อนข้อความที่มีโครงสร้างเข้าไป ได้เสียงที่สมจริงออกมา โดยไม่ต้องอัดเสียงด้วยตนเอง
โมเดลเสียงและไลบรารีเสียง
เสียงพากย์ AI พึ่งพาโมเดลเสียงที่ผ่านการฝึกฝน — โครงข่ายประสาทที่เรียนรู้ว่าเสียงหนึ่ง ๆ ควรฟังเป็นอย่างไรในคำ ภาษา และอารมณ์ที่แตกต่างกัน ไลบรารีเสียงก็คือแคตตาล็อกของโมเดลเหล่านั้นนั่นเอง เราดูแลไลบรารีที่มีเสียงฟังเป็นธรรมชาติกว่า 300 เสียง ครอบคลุมหลายเพศ สำเนียง และสไตล์การพูดในหลายภาษา และมีให้ใช้ทั้งในเว็บแอปและผ่าน API เพื่อให้เครื่องมือภายในสามารถสร้างคำพูดได้ตามต้องการ
Voice cloning: การทำให้ AI ฟังดูเหมือนคุณ
การโคลนเป็นกลไกที่ทำให้เสียงพากย์ฟังดูเหมือนบุคคลใดบุคคลหนึ่งแทนที่จะเป็นผู้บรรยายทั่วไป ระบบจะวิเคราะห์เสียงตัวอย่างที่บันทึกไว้ เรียนรู้ระดับเสียงต่ำสูง ช่วงเสียง และรูปแบบการออกเสียงของผู้พูด จากนั้นนำลักษณะเหล่านั้นมาใช้กับเสียงสังเคราะห์ใหม่
ในทางปฏิบัติ คุณอัปโหลดไฟล์เสียงที่มีความยาวอย่างน้อย 20 วินาทีไปยัง Voice Cloning — ควรจะสะอาดและปราศจากเสียงรบกวนพื้นหลัง เราจะประมวลผลเสียงตัวอย่างนั้นให้เป็นโปรไฟล์เสียงที่กำหนดเองซึ่งคุณสามารถตั้งชื่อและนำกลับมาใช้ซ้ำได้ โดยการโคลนมักใช้เวลาเพียงไม่กี่วินาที เมื่อสร้างแล้ว เสียงโคลนจะพร้อมใช้งานภายใน Text to Speech และ AI Dubbing คุณจึงสามารถสร้างสคริปต์หรือเวอร์ชันที่พากย์เสียงด้วยเสียงของคุณเองได้ ในเชิงโปรแกรม Voice Cloning API ก็ทำงานในลักษณะเดียวกัน: รับ URL สำหรับอัปโหลด ส่งเสียงของคุณในรูปแบบที่รองรับ สร้างเสียงที่กำหนดเองจาก file key ที่ได้ จากนั้นนำไปใช้ในโปรเจกต์ TTS หรือการพากย์เสียง
การพากย์เสียงและเสียงพากย์หลายภาษา
การเปลี่ยนจากเสียงพากย์ภาษาเดียวไปสู่เนื้อหาหลายภาษาจะเพิ่มการปรับให้เข้ากับท้องถิ่นเข้าไปบน TTS พื้นฐาน รูปแบบทั่วไปนั้นสม่ำเสมอ:
- บันทึกหรือนำเข้าคำพูดต้นฉบับ
- ถอดความออกมาเป็นข้อความ
- แปลข้อความนั้น
- สร้างคำพูดใหม่ในภาษาเป้าหมาย
- จัดจังหวะเวลาให้ตรงกับวิดีโอหรือเสียงต้นฉบับ
เวิร์กโฟลว์ AI Dubbing ของเราปฏิบัติตามรูปแบบนี้พอดี โดยรวม speech-to-text, การแปลด้วยเครื่อง และ text-to-speech เข้าด้วยกัน และเป็นตัวเลือกเสริมที่นำเสียงโคลนกลับมาใช้ซ้ำได้ เพื่อให้แทร็กที่พากย์เสียงตรงกับผู้พูดต้นฉบับ มันเปลี่ยนเนื้อหาที่พูดจากภาษาต้นทางมากกว่า 60 ภาษา ให้เป็นเวอร์ชันที่พากย์เสียงในภาษาเป้าหมาย 33 ภาษา การพากย์เสียงแบบ speech-to-speech มุ่งรักษาโทนและจังหวะเวลาให้ใกล้เคียงกับการแสดงต้นฉบับ ซึ่งสำคัญที่สุดสำหรับ e-learning การฝึกอบรม และเนื้อหาภาพยนตร์ที่การซิงค์ปากและจังหวะเป็นตัวขับเคลื่อนประสบการณ์
API และเวิร์กโฟลว์อัตโนมัติ
สำหรับทีมที่ผลิตเสียงพากย์ในระดับใหญ่ API คือสิ่งที่รวมการสร้างเสียงเข้ากับระบบที่มีอยู่ TTS API จัดการการป้อนข้อความเข้า-ส่งเสียงออก; Voice Cloning API เพิ่มการสร้างและการจัดการเสียงที่กำหนดเองในเชิงโปรแกรม; และ AI Dubbing API ขยายทั้งสองอย่างไปสู่การแปลและการพากย์เสียงอัตโนมัติในกว่า 33 ภาษา พร้อมการเข้าถึงเสียงโคลน เมื่อรวมกันแล้ว จะช่วยให้คุณสร้างไปป์ไลน์ที่สคริปต์ คำบรรยาย หรือบทถอดความที่ดึงมาจากระบบเนื้อหากลายเป็นเสียงพากย์หรือแทร็กที่พากย์เสียงโดยอัตโนมัติ โดยไม่ต้องจัดการไฟล์ด้วยตนเอง
สามวิธีในการสร้างเสียงพากย์ AI ใน DubSmart
ภายในแพลตฟอร์มของเรา คำถามนี้แก้ไขได้ด้วยจุดเริ่มต้นที่ใช้งานได้จริงสามจุด
เริ่มจากสคริปต์ด้วย Text to Speech วางข้อความของคุณ เลือกเสียงสำเร็จรูปหรือเสียงโคลน ตั้งค่าภาษาและการควบคุมพื้นฐาน และสร้างคำพูดที่คุณสามารถดาวน์โหลดในรูปแบบมาตรฐานได้ วิธีนี้เหมาะกับวิดีโอฝึกอบรม เนื้อหาอธิบาย สปอตการตลาด และอินโทรพอดแคสต์ที่คุณเป็นเจ้าของสคริปต์ตั้งแต่ต้น
เริ่มจากสื่อที่มีอยู่ด้วย AI Dubbing อัปโหลดวิดีโอหรือไฟล์เสียงต้นฉบับ ให้ระบบถอดความและแปล จากนั้นสร้างแทร็กที่พากย์เสียงในภาษาที่คุณเลือก — โดยนำเสียงโคลนกลับมาใช้ซ้ำเพื่อให้เสียงสม่ำเสมอ นี่คือเส้นทางสำหรับช่องที่ขยายไปสู่ผู้ชมหลายภาษา และสำหรับธุรกิจที่นำเว็บบินาร์หรือการสาธิตผลิตภัณฑ์มาใช้ซ้ำ
เริ่มจากระบบของคุณเองด้วยการสร้างที่ใช้ API แอปของคุณส่งพารามิเตอร์ข้อความและเสียงไปยัง TTS API เชื่อมโยงเนื้อหากับเสียงเฉพาะผ่าน Voice Cloning API เป็นตัวเลือกเสริม และดึงเสียงที่พร้อมแนบกับวิดีโอหรือเสียงพากย์ e-learning สำหรับโมดูลฝึกอบรม วิธีนี้เหมาะกับนักพัฒนา เอเจนซี และผู้ให้บริการ LMS ที่ต้องการผลลัพธ์เชิงโปรแกรมที่สม่ำเสมอ
เกณฑ์การตัดสินใจ: การเลือกการตั้งค่าเสียงพากย์ AI ของคุณ
ความเป็นธรรมชาติและคุณภาพเสียง
ความเป็นธรรมชาติเป็นสิ่งที่ต่อรองไม่ได้ เอนจินที่แข็งแกร่งจำลอง prosody และการออกเสียงเพื่อให้คำพูดไหลลื่นด้วยการหยุดพักและการเน้นที่เหมาะสม เนื่องจากการสร้างทำได้อย่างรวดเร็ว คุณจึงสามารถปรับปรุงสคริปต์และสร้างเสียงใหม่ได้จนกว่าการนำเสนอจะรู้สึกถูกต้อง แทนที่จะยอมรับเทคแรก
การครอบคลุมภาษาและความลึกของการปรับให้เข้ากับท้องถิ่น
หากช่องหลายภาษาหรือการฝึกอบรมระหว่างประเทศอยู่ในแผนงานของคุณ การครอบคลุมจะตัดสินว่าคุณสามารถเข้าถึงได้ไกลแค่ไหน การเปลี่ยนเนื้อหาจากภาษาต้นทางกว่า 60 ภาษา ไปเป็นภาษาเป้าหมาย 33 ภาษาจากเวิร์กโฟลว์เดียว กำหนดตลาดที่คุณสามารถให้บริการได้ และการพากย์เสียงแบบ speech-to-speech ช่วยให้โทนและจังหวะเวลาสม่ำเสมอในทุกเวอร์ชัน
การสร้างแบรนด์เสียงและความสามารถในการโคลน
เสียงที่จดจำได้มีความสำคัญสำหรับบริษัท ครีเอเตอร์ และพอดแคสต์ การโคลนช่วยให้คุณนำเสียงเดียวกันไปใช้ข้ามภาษาและช่องต่าง ๆ ได้ ความสามารถในการโคลนจากเสียงที่สะอาดประมาณ 20 วินาที และนำโปรไฟล์นั้นกลับมาใช้ซ้ำภายใน Text to Speech และ AI Dubbing ทำให้การสร้างและรักษาเสียงเอกลักษณ์เป็นไปได้จริง
ความเรียบง่ายของเวิร์กโฟลว์เทียบกับการผสานรวมทางเทคนิค
ครีเอเตอร์มักต้องการให้การอัปโหลด การแก้ไข และการดาวน์โหลดจัดการในที่เดียว ทีมเทคนิคมักต้องการ API เราเสนอทั้งสองอย่าง: เครื่องมือสำหรับผู้ใช้ในแอปที่เป็นหนึ่งเดียว และ API สำหรับนักพัฒนาที่เปิดเผยเอนจินเดียวกัน ทางเลือกขึ้นอยู่กับว่าทีมของคุณทำงานส่วนใหญ่ในเบราว์เซอร์หรือสร้างบนระบบภายใน
ความเร็ว ความสามารถในการปรับขนาด และความสม่ำเสมอ
เครื่องมือเสียงพากย์ควรลดเวลาการผลิตและปรับขนาดได้โดยไม่ให้คุณภาพลดลง การสร้าง TTS ที่เกือบจะทันทีและการโคลนที่เสร็จในไม่กี่วินาที ช่วยให้ปรับปรุงได้อย่างรวดเร็วและสร้างผลลัพธ์จำนวนมากได้ ในขณะที่ API ช่วยให้สคริปต์หรือเซกเมนต์นับพันประมวลผลได้โดยอัตโนมัติด้วยเสียงและการตั้งค่าที่สม่ำเสมอ
โครงสร้างงบประมาณและการควบคุม
แทนที่จะเป็นค่าธรรมเนียมสตูดิโอต่อเซสชัน เครื่องมือเสียงพากย์ AI มักใช้ราคาตามการใช้งาน โมเดลแบบเครดิตของเราให้คุณเข้าถึง AI Dubbing, Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image และ Image to Video ภายใต้บัญชีเดียว พร้อมแพ็กเกจฟรีและแพ็กเกจสำหรับองค์กร เครดิตช่วยให้มีขีดจำกัดการใช้งานที่คาดการณ์ได้ ในขณะที่การยกยอดและการปรับขนาดยังคงมีให้เมื่อปริมาณเพิ่มขึ้น หากคุณต้องการปรับขนาดเครดิตตามเวลาการทำงาน การแยกรายละเอียดต้นทุนการพากย์เสียง AI ต่อนาทีของเราจะพาคุณผ่านการคำนวณ
การปฏิบัติตามข้อกำหนด ความยินยอม และการจัดการข้อมูล
การโคลนและคำพูดสังเคราะห์มีน้ำหนักทางจริยธรรมและกฎหมาย เราต้องการให้คุณอัปโหลดเสียงที่คุณมีสิทธิ์ และแนะนำให้ใช้การบันทึกที่สะอาดเพื่อผลลัพธ์ที่ดีที่สุด ซึ่งทำให้ความยินยอมและการควบคุมอยู่ที่ศูนย์กลาง เอกสาร API ของเราใช้ URL สำหรับอัปโหลดที่ปลอดภัยและลงนามล่วงหน้าและรูปแบบเสียงมาตรฐาน ทำให้นักพัฒนามีรูปแบบที่ชัดเจนสำหรับการใช้งานที่สอดคล้องกับข้อกำหนดภายในแอปพลิเคชัน
ความเสี่ยงที่ควรวางแผนรับมือ
แม้จะมีเครื่องมือที่มีความสามารถ ก็ยังมีจุดที่อาจล้มเหลวสองสามอย่างที่ควรคาดการณ์ไว้ล่วงหน้า
เสียงที่ไม่เป็นธรรมชาติหรือเหมือนหุ่นยนต์มักสืบเนื่องมาจากสคริปต์ที่มีเครื่องหมายวรรคตอนไม่ดีหรือเสียงที่ไม่เข้ากับเนื้อหา การเลือกจากไลบรารีของเสียงที่เป็นธรรมชาติและสร้างใหม่จนกว่าการนำเสนอจะเหมาะสมคือวิธีแก้ที่ใช้ได้จริง และการสร้างที่รวดเร็วทำให้การทดลองนั้นมีต้นทุนต่ำ
การออกเสียงผิดมักปรากฏกับชื่อ คำศัพท์ทางเทคนิค และเนื้อหาที่ปรับให้เข้ากับท้องถิ่น ไปป์ไลน์ที่รันการถอดความ การแปล และการตรวจทาน — แทนที่จะเป็นการแปลงเสียงเป็นเสียงแบบตาบอด — จะจับข้อผิดพลาดเหล่านี้ได้มากขึ้นก่อนที่จะเผยแพร่
ความไม่ตรงกันของจังหวะเวลาระหว่างคำพูดที่สังเคราะห์กับภาพบนหน้าจอทำให้ประสบการณ์ของผู้ชมเสียหาย การพากย์เสียงแบบ speech-to-speech ที่ยังคงใกล้เคียงกับโทนและจังหวะเวลาต้นฉบับ ประกอบกับการแก้ไขภายในสภาพแวดล้อมของโปรเจกต์ ช่วยให้คุณควบคุมการจัดจังหวะให้ตรงกันได้ดีขึ้น
ในเชิงจริยธรรม การโคลนเสียงโดยไม่มีสิทธิ์ที่เหมาะสมนำมาซึ่งปัญหาร้ายแรง การกำหนดให้มีเสียงตัวอย่างที่สะอาดภายใต้การควบคุมของคุณ และการวางกรอบการโคลนให้เป็นเครื่องมือสำหรับครีเอเตอร์และธุรกิจแทนที่จะเป็นการปลอมตัวโดยไม่ระบุชื่อ คือสิ่งที่ทำให้การปฏิบัตินี้มีความรับผิดชอบ เมื่อคุณกำลังปรับฟุตเทจที่มีอยู่ให้เข้ากับท้องถิ่น คู่มือของเราเกี่ยวกับวิธีเปลี่ยนภาษาเสียงในวิดีโอจะแสดงเส้นทางที่เป็นมิตรต่อการตรวจทาน
ครีเอเตอร์ต่าง ๆ นำสิ่งนี้ไปใช้จริงอย่างไร
ครีเอเตอร์ YouTube ที่ขยายไปต่างประเทศสามารถเปลี่ยนวิดีโอภาษาอังกฤษหนึ่งเรื่องให้เป็นเวอร์ชันภาษาสเปน โปรตุเกส และเยอรมันด้วย AI Dubbing และเสียงโคลน เพื่อให้พิธีกรยังคงจดจำได้ในทุกตลาด — ทั้งหมดอยู่ในไปป์ไลน์ภาษาต้นทางกว่า 60 ภาษาและภาษาเป้าหมาย 33 ภาษา
ธุรกิจขนาดเล็กหรือทีมการตลาดสามารถร่างสคริปต์อธิบายผลิตภัณฑ์หรือโฆษณาในเอกสาร แปลงเป็นเสียงด้วย Text to Speech และเลือกเสียงที่เข้ากับโทนของแบรนด์ — มีพลัง เป็นทางการ หรือเป็นกันเอง สคริปต์เดียวกันนั้นสามารถปรับให้เข้ากับท้องถิ่นได้ในภายหลังผ่าน AI Dubbing โดยใช้เสียงแบรนด์ที่โคลน
ผู้ผลิต e-learning หรือการฝึกอบรมองค์กรสามารถทำให้การบรรยายสำหรับสไลด์และแพ็กเกจ SCORM เป็นอัตโนมัติได้ด้วยการส่งข้อความบทเรียนผ่าน TTS API และแนบเสียงที่ได้กลับมากับแต่ละโมดูล โดยการโคลนช่วยให้เสียงของผู้สอนสม่ำเสมอแม้ในเวอร์ชันของแต่ละภูมิภาค
ผู้สร้างภาพยนตร์อิสระหรือครีเอเตอร์พอดแคสต์สามารถผลิตตัวอย่างหนัง โปรโม หรือบทสนทนาที่แปลได้โดยไม่ต้องจองสตูดิโอในทุกภาษา โดยรวม Speech to Text, AI Dubbing และเสียงโคลนเข้าด้วยกันเพื่อรักษาเอกลักษณ์ของตัวละครให้คงที่
นักพัฒนาและเอเจนซีสามารถฝัง TTS, Voice Cloning และ AI Dubbing API ลงในเครื่องมือภายในหรือแพลตฟอร์มของลูกค้า ทำให้ทุกอย่างเป็นอัตโนมัติตั้งแต่เสียงพากย์โซเชียลรูปแบบสั้นไปจนถึงตัวแทนเสียงแบบโต้ตอบ
คำถามที่พบบ่อย
เสียงพากย์ AI แตกต่างจากเสียงพากย์ที่บันทึกแบบดั้งเดิมอย่างไร?
เสียงพากย์แบบดั้งเดิมต้องการนักพากย์เสียงที่เป็นมนุษย์ เวลาสตูดิโอ และหลายเซสชัน เสียงพากย์ AI ถูกสร้างโดยเอนจิน text-to-speech และ voice cloning ที่เปลี่ยนสคริปต์เป็นเสียงโดยตรงโดยใช้โมเดล neural ที่ผ่านการฝึกฝนแทนการแสดงสด
เสียงพากย์ AI สามารถฟังดูเหมือนบุคคลใดบุคคลหนึ่งได้หรือไม่?
ได้ การโคลนเสียงจะวิเคราะห์เสียงตัวอย่างสั้น ๆ ของใครสักคนและสร้างโมเดลที่กำหนดเองซึ่งสามารถพูดสคริปต์ใดก็ได้ด้วยเสียงนั้น มีให้ใช้ในเครื่องมือ Voice Cloning และ API ของเรา
ต้องใช้เสียงมากแค่ไหนในการโคลนเสียง?
เราขอเสียงที่สะอาดอย่างน้อย 20 วินาที ปราศจากเสียงรบกวนพื้นหลัง เพื่อสร้างโปรไฟล์เสียงโคลนที่เชื่อถือได้ โดยการโคลนมักเสร็จภายในไม่กี่วินาที
ฉันสามารถสร้างเสียงพากย์หลายภาษาจากวิดีโอต้นฉบับเดียวได้หรือไม่?
ได้ เรารวม speech-to-text การแปล และ text-to-speech เข้าด้วยกันเพื่อเปลี่ยนเนื้อหาจากภาษาต้นทางกว่า 60 ภาษาให้เป็นผลลัพธ์ที่พากย์เสียงในภาษาเป้าหมาย 33 ภาษา ดังนั้นวิดีโอต้นฉบับหนึ่งเรื่องจึงสามารถผลิตเสียงพากย์ที่ปรับให้เข้ากับท้องถิ่นได้หลายเวอร์ชัน
มีวิธีทำให้การสร้างเสียงพากย์เป็นอัตโนมัติแทนการใช้อินเทอร์เฟซหรือไม่?
TTS API และ Voice Cloning API ของเราช่วยให้แอปและเครื่องมือภายในส่งข้อความและเสียงตัวอย่าง สร้างเสียงที่กำหนดเอง และรับคำพูดสังเคราะห์ในเชิงโปรแกรม ดังนั้นเสียงพากย์จึงสามารถสร้างขึ้นโดยอัตโนมัติในระดับใหญ่ได้