การแยกเสียงพูดด้วย AI คือกระบวนการเรียนรู้เชิงลึกที่ดึงเสียงมนุษย์ออกจากการผสมเสียงที่มีสัญญาณรบกวน และส่งคืนแทร็กเสียงพูดที่สะอาด พร้อมสำหรับการถอดเสียง การพากย์ หรือการโคลนเสียง ความสามารถเพียงอย่างเดียวนี้ตอบคำถามที่ครีเอเตอร์ส่วนใหญ่มีอยู่จริง นั่นคือ ฉันจะกู้การบันทึกนี้ได้โดยไม่ต้องถ่ายใหม่ไหม? การเข้าใจว่าการแยกเสียงพูดด้วย AI ทำงานอย่างไรช่วยให้คุณตัดสินใจได้ว่าเมื่อไรควรพึ่งพามัน เมื่อไรควรบันทึกให้สะอาดตั้งแต่แรก และแทร็กเสียงที่สะอาดช่วยปรับปรุงทุกอย่างในขั้นตอนถัดไปอย่างเงียบๆ ได้อย่างไร คู่มือนี้จะพาคุณผ่านกลไกการทำงาน ความแตกต่างระหว่างการปรับปรุงเสียงผู้พูดคนเดียวกับการแยกผู้พูดหลายคน จุดที่กระบวนการนี้เข้ากับ pipeline การโลคัลไลเซชัน และสิ่งที่มันยังไม่สามารถแก้ไขได้
สารบัญ
การตัดสินใจเบื้องหลังการแยกเสียงพูด
การบันทึกจริงทุกครั้งจับได้มากกว่าแค่เสียงผู้พูด Vlog เว็บบินาร์ วิดีโอฝึกอบรม และพอดแคสต์จะเก็บเสียงถนน เสียงบรรยากาศห้อง ดนตรีประกอบ เสียงคลิกแป้นพิมพ์ และเสียงพูดที่ซ้อนทับกันซึ่งอาจกลบคำที่สำคัญไป เครื่องแยกเสียงพูดมีอยู่เพื่อคลี่คลายการผสมเสียงนั้น มันรับไฟล์ที่ผสมกันหนึ่งไฟล์และคืนแทร็กที่มีเสียงพูดของมนุษย์เป็นหลัก พร้อมแทร็กเสริมที่เก็บเสียงพื้นหลังส่วนที่เหลือ
แทร็กเสียงที่สะอาดนั้นกลายเป็นรากฐานสำหรับสิ่งที่จะตามมา ไม่ว่าจะเป็นการแปลงเสียงเป็นข้อความที่แม่นยำ การพากย์หลายภาษา การโคลนเสียงความละเอียดสูง หรือเพียงแค่ต้นฉบับที่ฟังดูดีขึ้น ดังนั้นการตัดสินใจที่แท้จริงจึงไม่ใช่เรื่องเทคนิค แต่เป็นเรื่องเชิงปฏิบัติ คุณไว้วางใจเสียงปัจจุบันของคุณมากพอที่จะสร้างเนื้อหาหลายภาษาบนมันหรือไม่ หรือคุณต้องการให้ AI ทำความสะอาดและแยกเสียงพูดก่อน? และคุณต้องการเครื่องมือทำความสะอาดแบบเดี่ยวๆ หรือเครื่องแยกเสียงที่ฝังอยู่ในแพลตฟอร์มการสร้างและการโลคัลไลเซชันที่กว้างขึ้น เพื่อที่คุณจะได้ไม่ต้องสลับไปมาระหว่างหลายแอป?
เราออกแบบ Speech Separator ของเราให้ทำหน้าที่เป็นด่าน AI แรกในเวิร์กโฟลว์ที่เป็นหนึ่งเดียว มันอยู่ก่อนการแปลงเสียงเป็นข้อความ การแปลงข้อความเป็นเสียง การโคลนเสียง และการพากย์ ดังนั้นทุกระบบในขั้นตอนถัดไปจะเห็นสัญญาณเสียงที่ชัดเจนที่สุดเท่าที่จะเป็นไปได้ แทนที่จะรับสัญญาณรบกวนใดๆ ที่อยู่ในห้อง
กลไก: จากคลื่นเสียงสู่เสียงที่สะอาด
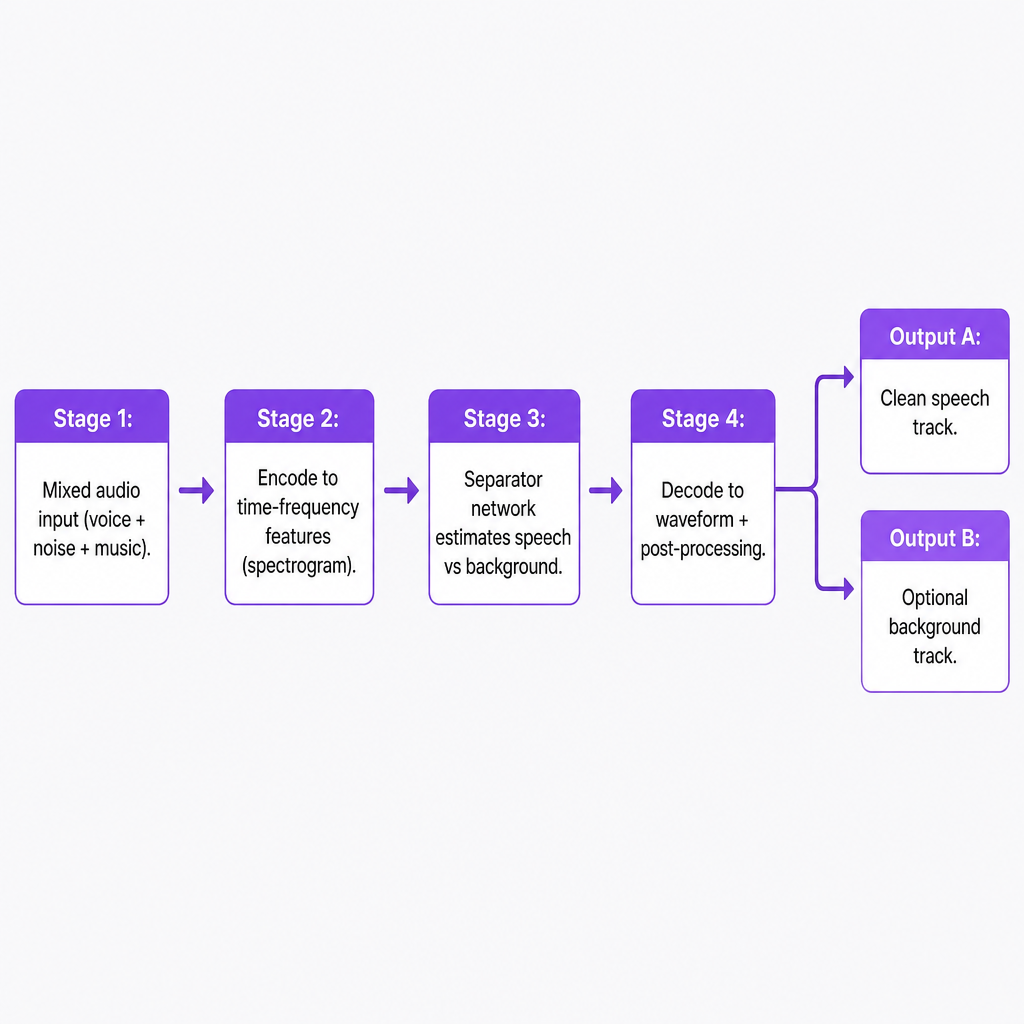
การแยกเสียงพูดด้วย AI สมัยใหม่ดำเนินตาม pipeline สี่ขั้นตอน คือ เข้ารหัสสัญญาณ แยกแหล่งเสียงในพื้นที่คุณลักษณะที่เรียนรู้แล้ว ประมาณค่าเสียงพูดที่สะอาด และถอดรหัสกลับเป็นเสียง
จากคลื่นเสียงสู่คุณลักษณะ
ระบบส่วนใหญ่จะแปลงคลื่นเสียงดิบจากไมโครโฟนของคุณให้เป็นการแสดงผลแบบเวลา-ความถี่ก่อน เช่น สเปกโตรแกรม ซึ่งแสดงว่าพลังงานในแถบความถี่ต่างๆ เปลี่ยนแปลงไปตามเวลาอย่างไร มุมมองนั้นทำให้ neural network มองเห็นรูปแบบที่ตรงกับเสียงพูดของมนุษย์เทียบกับสัญญาณรบกวนหรือดนตรีได้ง่ายขึ้น จากนั้น encoder network จะแมปอินพุตไปยังพื้นที่คุณลักษณะที่มีมิติสูง ซึ่งแหล่งเสียงต่างๆ จะแยกแยะได้ชัดเจนขึ้น โดยเน้นลักษณะเสียงพูดอย่าง formant ฮาร์มอนิก และโครงสร้างเชิงเวลา พร้อมทั้งกดเนื้อหาพื้นหลังที่ไม่เกี่ยวข้อง
เครือข่ายแยกเสียงและมาสก์
แกนหลักของกระบวนการคือเครือข่ายแยกเสียง (separator network) ซึ่งเป็นโมเดลเชิงลึกที่ถูกฝึกให้ตัดสินว่าอะไรเป็นของเสียงและอะไรไม่ใช่ในแต่ละจุดเวลา-ความถี่ มีสองกลยุทธ์ที่โดดเด่น การแยกแบบใช้มาสก์จะทำนายมาสก์สำหรับสเปกโตรแกรมที่คงพลังงานเสียงพูดไว้และลดทอนทุกอย่างอื่น เมื่อนำไปใช้กับสเปกโตรแกรมต้นฉบับ สัญญาณรบกวนพื้นหลังและดนตรีจะลดลงอย่างมากในขณะที่เสียงพูดยังคงอยู่ ส่วนการประมาณแหล่งเสียงโดยตรงจะทำนายสเปกโตรแกรมเสียงพูดที่สะอาดโดยตรง และบางครั้งประมาณเสียงพื้นหลังส่วนที่เหลือ ซึ่งจากนั้นจะถูกถอดรหัสกลับเป็นเสียง
ยังมีวิธีการเฉพาะทางสำหรับกรณีที่ยากขึ้น Deep clustering จะเรียนรู้ embedding สำหรับแต่ละ bin เวลา-ความถี่ เพื่อให้ bin จากแหล่งเดียวกันจับกลุ่มเข้าด้วยกัน หลังจากนั้นการจัดกลุ่มมาตรฐานจะแยกเสียงพูดออกจากแหล่งเสียงอื่นๆ โมเดลอื่นๆ ใช้การฝึกแบบไม่ขึ้นกับลำดับ (permutation-invariant training) เพื่อให้สามารถแยกผู้พูดหลายคนได้โดยไม่ต้องสมมติว่าผู้พูดคนใดคือเอาต์พุตที่หนึ่งเทียบกับเอาต์พุตที่สอง
การฝึกด้วยตัวอย่างแบบมีการกำกับ
โมเดลเหล่านี้เรียนรู้จากตัวอย่างการผสมเสียงที่จับคู่กับเสียงพูดสะอาดที่เป็นค่าอ้างอิงจริง โดยปรับตัวเองเพื่อลดช่องว่างระหว่างเอาต์พุตของมันกับค่าอ้างอิง เป้าหมายการฝึกอาจเป็นมาสก์ สเปกโตรแกรมสะอาด หรือคลื่นเสียงที่สร้างขึ้นใหม่ และฟังก์ชันการสูญเสียมักผูกกับการวัดคุณภาพเชิงการรับรู้ เช่น อัตราส่วนสัญญาณต่อการบิดเบือน เมื่อป้อนตัวอย่างที่หลากหลายมากมายทั้งสำเนียง ไมโครโฟน และสภาพแวดล้อม เครือข่ายจะซึมซับสัญญาณบ่งชี้ที่แข็งแกร่งซึ่งแยกเสียงพูดของมนุษย์ออกจากเนื้อหาพื้นหลัง และสามารถนำไปใช้กับการบันทึกที่มันไม่เคยเห็นมาก่อนได้
การถอดรหัสกลับเป็นเสียง
สุดท้าย ระบบจะแมปการแสดงผลเสียงพูดที่แยกออกมากลับเป็นคลื่นเสียงในโดเมนเวลาผ่านการแปลงย้อนกลับ ตามด้วยการประมวลผลภายหลัง เช่น การลดสัญญาณรบกวนและการปรับระดับความดังให้เป็นมาตรฐาน ผลลัพธ์คือแทร็กที่มีเสียงพูดเป็นหลักซึ่งสามารถยืนอยู่ได้ด้วยตัวเองหรือรวมกลับกับเสียงพื้นหลังในปริมาณที่ควบคุมได้เพื่อความเป็นธรรมชาติ Speech Separator ของเราดำเนินตามรูปแบบนี้อย่างแม่นยำ มันรับเสียงหรือวิดีโอที่คุณอัปโหลด รัน pipeline การแยกเสียง และคืนแทร็กที่เน้นเสียงพูดพร้อมเสียงพื้นหลังเสริม เพื่อให้คุณตัดสินใจได้ว่าการผสมเสียงสุดท้ายควรจะแห้งหรือมีเสียงบรรยากาศมากแค่ไหน
การปรับปรุงเสียงผู้พูดคนเดียว vs การแยกผู้พูดหลายคน
มีเส้นแบ่งที่สำคัญระหว่างการปรับปรุงเสียงผู้พูดหลักคนหนึ่งกับการแยกเสียงที่ซ้อนทับกันหลายเสียงอย่างแท้จริง และมันกำหนดว่าคุณสามารถคาดหวังอะไรได้ตามความเป็นจริง
การปรับปรุงเสียงผู้พูดคนเดียวจะแยกเสียงหลักหนึ่งเสียงออกจากสัญญาณรบกวนพื้นหลัง เสียงก้อง และเสียงที่ไม่ใช่เสียงพูด เพื่อให้ความชัดเจนของคำพูดเพิ่มขึ้น สิ่งนี้ทำงานได้ดีเป็นพิเศษกับ vlog เว็บบินาร์ การบรรยาย และเนื้อหาแบบ talking-head ที่ปัญหาคือสัญญาณรบกวนบรรยากาศหรือดนตรีประกอบมากกว่าเสียงพูดพ้องกัน Speech Separator ของเราได้รับการปรับให้เหมาะกับกรณีนี้ มันถือว่าเสียงพูดของมนุษย์เป็นแหล่งเสียงหลักและทุกอย่างอื่นเป็นพื้นหลัง โดยส่งมอบแทร็กเสียงที่สะอาดและแทร็กพื้นหลังเสริม
การแยกผู้พูดหลายคนเป็นงานที่แตกต่างออกไป คือการแยกการผสมเสียงของหลายคนที่พูดพร้อมกันออกเป็นสตรีมแยกกัน หนึ่งสตรีมต่อหนึ่งเสียง โมเดลวิจัยได้แยกเสียงมากถึงห้าเสียงจากไมโครโฟนตัวเดียว โดยการฝึกเครือข่ายที่ต่างกันสำหรับจำนวนผู้พูดที่ต่างกันและเลือกตัวที่เหมาะสมที่สุดสำหรับแต่ละตัวอย่าง เทคนิคอย่าง deep clustering และ multi-microphone neural beamforming ผลักดันประสิทธิภาพให้ก้าวหน้ายิ่งขึ้นในสภาพแวดล้อมระยะไกลและหลายช่องสัญญาณ แต่มันซับซ้อนกว่าและใช้การคำนวณหนักกว่า ในทางปฏิบัติ ระบบเหล่านี้ยังคงมุ่งเป้าไปที่สถานการณ์เฉพาะทาง เช่น การถอดเสียงการประชุม คอลเซ็นเตอร์ และอุปกรณ์อัจฉริยะ มากกว่าเวิร์กโฟลว์ของครีเอเตอร์ในชีวิตประจำวัน สำหรับผู้ใช้ส่วนใหญ่ของเราที่ดำเนินช่อง YouTube ทีมการตลาด หรือคลังคอร์ส ประโยชน์เชิงปฏิบัติที่ใหญ่ที่สุดมาจากการปรับปรุงเสียงผู้พูดคนเดียวที่แข็งแกร่งและการแยกเสียงพูดจากพื้นหลัง ไม่ใช่การแยกหลายเสียงอย่างเต็มรูปแบบ
จุดที่การแยกเสียงอยู่ในเวิร์กโฟลว์การโลคัลไลเซชัน
การแยกเสียงคือสะพานเชื่อมระหว่างการบันทึกในโลกจริงที่มีสัญญาณรบกวนกับงานเสียง AI คุณภาพสูง เส้นทางทั่วไปจะไหลผ่านเครื่องมือหลายอย่างอย่างราบรื่น
ครีเอเตอร์อัปโหลดไฟล์เสียงหรือวิดีโอ และเครื่องแยกเสียงจะแยกแทร็กเสียงพูดและเสียงพื้นหลัง (แบบเสริม) ออกมา เสียงพูดที่สะอาดนั้นจะป้อนเข้าสู่ การแปลงเสียงเป็นข้อความ ดังนั้นการถอดเสียงและการแปลจะทำงานบนสัญญาณที่ชัดเจน ซึ่งช่วยเพิ่มความแม่นยำและลดคำที่แต่งขึ้นเองอันเกิดจากดนตรีหรือสัญญาณรบกวนหนักๆ ข้อความและการแปลที่ได้จะเคลื่อนเข้าสู่การแปลงข้อความเป็นเสียงและ AI dubbing ซึ่งสร้างเวอร์ชันภาษาใหม่โดยใช้เสียงที่โคลนหรือสังเคราะห์ เนื่องจากเสียงพูดต้นฉบับสะอาด การจัดตำแหน่งเชิงเวลาจึงแม่นยำมากขึ้นและ artifact จากการผสมเสียง เช่น การกระตุก จะลดลง
การโคลนเสียงขึ้นอยู่กับอินพุตที่สะอาดเช่นเดียวกัน โมเดลต้องการตัวอย่างที่ค่อนข้างปลอดสัญญาณรบกวนเพื่อเรียนรู้โทนเสียง จังหวะการพูด และการออกเสียงของผู้พูดได้อย่างน่าเชื่อถือ และการแยกเสียงจะลดการปนเปื้อนของพื้นหลังที่อาจบิดเบือนเสียงที่โคลนขึ้น คู่มือภาษาสเปนของเราเกี่ยวกับการแยกเสียงจับประสบการณ์ในชีวิตประจำวันได้ดี คือ อัปโหลดไฟล์ ให้ AI แยกเสียงออกจากพื้นหลัง จากนั้นดาวน์โหลดแทร็กเสียงที่สะอาดหรือพื้นหลังที่แยกออกมาเพื่อการแก้ไข การพากย์ หรือการบรรยายเพิ่มเติม ทั้งหมดอยู่ในเวิร์กโฟลว์เดียว การรวมเข้าด้วยกันนั้นเป็นประเด็นสำคัญสำหรับทีมเล็กๆ ที่มิฉะนั้นจะต้องกระโดดไปมาระหว่างปลั๊กอินลดสัญญาณรบกวน เครื่องมือถอดเสียง บริการพากย์ และแพลตฟอร์มโคลนเสียงที่แยกจากกัน
การเลือกและใช้การแยกเสียงพูดด้วย AI
เมื่อคุณตัดสินใจว่าจะนำการแยกเสียงมาใช้อย่างไร เกณฑ์เชิงปฏิบัติไม่กี่ข้อทำงานเป็นส่วนใหญ่
สภาพเสียงและประเภทเนื้อหา เมื่อมีผู้พูดหลักคนเดียวและสัญญาณรบกวนพื้นหลังหรือดนตรีในระดับปานกลาง การแยกเสียงจะมีประสิทธิภาพสูงและความเสี่ยงต่ำ เมื่อมีการซ้อนทับกันหนัก ไมโครโฟนระยะไกล หรืออินพุตคุณภาพต่ำมาก ให้คาดหวังผลตอบแทนที่ลดลงและจับคู่ AI กับการบันทึกที่ดีขึ้นแทนที่จะพึ่งพามันในการกู้ทุกอย่าง
การผสานรวมกับเครื่องมือในขั้นตอนถัดไป เครื่องแยกเสียงที่ไหลตรงเข้าสู่การถอดเสียง การแปลงข้อความเป็นเสียง และการพากย์ จะลดแรงเสียดทานและ artifact ที่สะสมเมื่อเทียบกับการส่งออกและนำเข้าใหม่ระหว่างแอป เราเชื่อมต่อ Speech Separator เข้ากับเครื่องมือโลคัลไลเซชันอื่นๆ ของเราด้วยเหตุผลนี้เอง ซึ่งสำคัญมากขึ้นเมื่อเป้าหมายของคุณคือการเผยแพร่หลายภาษามากกว่าการลดสัญญาณรบกวนแบบครั้งเดียว
การควบคุมเสียงพื้นหลัง สำหรับการเล่าเรื่องแบรนด์ คุณมักต้องการเก็บบรรยากาศหรือดนตรีบางส่วนไว้เพื่อผลกระทบทางอารมณ์ ระบบที่ให้เอาต์พุตทั้งแทร็กเสียงพูดที่สะอาดและพื้นหลังที่แยกออกมาจะให้พื้นที่แก่เอดิเตอร์มากกว่าเครื่องมือที่ผลิตเพียงการผสมเสียงที่ลดสัญญาณรบกวนแล้วอันเดียว เครื่องแยกเสียงของเรารองรับกระบวนทัศน์เสียงพูดบวกพื้นหลังเสริมนี้ เพื่อให้คุณสามารถรีมิกซ์ได้อย่างจงใจ
ความเร็ว ความเรียบง่าย และการปรับขนาด สำหรับครีเอเตอร์และทีมเล็กๆ ความสามารถในการใช้งานแข่งขันกับประสิทธิภาพดิบ การแยกเสียงด้วยคลิกเดียวผ่านเบราว์เซอร์หรือ API พร้อมการจัดการรูปแบบทั่วไปโดยอัตโนมัติ เอาชนะโซ่ปลั๊กอินที่ซับซ้อนซึ่งสมมติว่าต้องมีความเชี่ยวชาญด้านวิศวกรรมเสียง เมื่อคุณจัดการวิดีโอหรือโมดูลคอร์สหลายร้อยรายการ การประมวลผลแบบชุดและระบบอัตโนมัติก็เลิกเป็นสิ่งฟุ่มเฟือย
ความน่าเชื่อถือและ artifact โมเดลที่แข็งแกร่งจะปรับปรุงความชัดเจนของคำพูดโดยไม่เพิ่มการบิดเบือนที่ชัดเจน เสียงก้องแบบโลหะ หรือ artifact จากการหายใจ เดโมอาจทำให้ระบบดูดีเกินจริง ดังนั้นให้ทดสอบด้วยการบันทึกที่เป็นตัวแทนของคุณเองก่อนที่คุณจะทำให้เครื่องแยกเสียงใดๆ เป็นส่วนหนึ่งที่ตายตัวของ pipeline ของคุณ
ความเป็นส่วนตัวและการปฏิบัติตามข้อกำหนด การแยกเสียงทำงานโดยตรงกับข้อมูลเสียงที่อาจรวมข้อมูลที่ละเอียดอ่อน ทีมองค์กรควรยืนยันว่าเสียงถูกจัดเก็บอย่างไร ถูกใช้ในการฝึกโมเดลหรือไม่ และมีการควบคุมอะไรบ้างสำหรับการเก็บรักษาและการเข้าถึง โดยเฉพาะสำหรับอุตสาหกรรมที่มีการกำกับดูแลและเนื้อหาการฝึกอบรมภายใน
การชั่งน้ำหนักเกณฑ์เหล่านี้เทียบกับกรณีการใช้งานจริงของคุณ ไม่ว่าจะเป็นการขยายช่อง การฝึกอบรม การตลาด งานเล่าเรื่อง หรือผลิตภัณฑ์ API จะบอกคุณได้ว่าเครื่องแยกเสียงที่ผสานรวมกับเครื่องมือเสียงในขั้นตอนถัดไปเข้ากับวิธีการทำงานของคุณหรือไม่
ความเสี่ยง ข้อจำกัด และสิ่งที่มันแก้ไขไม่ได้
แม้แต่โมเดลที่แข็งแกร่งก็มีขอบเขตที่ควรรู้ก่อนที่คุณจะตัดสินใจ
- สัญญาณรบกวนสุดขั้วหรืออัตราส่วนสัญญาณต่อสัญญาณรบกวนต่ำมาก เมื่อเสียงพูดถูกฝังอยู่ใต้สัญญาณรบกวนหรือดนตรีที่ดัง โมเดลอาจล้มเหลวในการกู้ทุกคำ ทำให้เกิดการหลุดหายหรือเอาต์พุตที่อู้อี้
- การซ้อนทับของผู้พูดที่หนัก คนที่พูดในเวลาเดียวกันพอดีท้าทายแม้แต่ระบบแยกผู้พูดหลายคนที่ก้าวหน้า และอาจทำให้เสียงพูดรั่วไหลระหว่างสตรีมที่แยกออกมา
- artifact จากการแยกเสียงมากเกินไป การใช้มาสก์ที่รุนแรงสามารถทำให้เกิดสัญญาณรบกวนแบบดนตรีหรือโทนเสียงแบบหุ่นยนต์ ซึ่งสังเกตได้ชัดที่สุดในเสียงที่ยืดยาวและเสียงเสียดแทรก
- ความไม่ตรงกันระหว่างการฝึกกับความเป็นจริง โมเดลที่ปรับแต่งบนไมโครโฟน ภาษา หรือสภาพแวดล้อมบางอย่างอาจทำงานได้ต่ำกว่ามาตรฐานกับการบันทึกที่แตกต่างกันมาก ซึ่งจะลากความแม่นยำของการถอดเสียงและการพากย์ลงมา
- จริยธรรมและสิทธิ์ เสียงพูดที่แยกออกมาอย่างสะอาดจะถอดเสียง วิเคราะห์ และรีมิกซ์ได้ง่ายขึ้น ดังนั้นทีมต้องเคารพความยินยอมและสิทธิ์เมื่อนำเสียงกลับมาใช้ในภาษาหรือบริบทใหม่
ข้อสรุปที่ตรงไปตรงมาคือการแยกเสียงเป็นการปรับปรุงที่ทรงพลัง ไม่ใช่การทดแทนนิสัยการบันทึกที่สมเหตุสมผล ไมโครโฟนที่ดี ระดับเสียงที่เหมาะสม และการเลือกสถานที่อย่างรอบคอบยังคงคุ้มค่า และ AI ก็จะทวีคูณตัวเลือกเหล่านั้นด้วยการทำให้เนื้อหายืดหยุ่นมากขึ้นสำหรับการโลคัลไลเซชันและการนำกลับมาใช้ หากคุณกำลังสำรวจวิธีที่จะนำสิ่งนี้เข้ากับการตั้งค่าการเผยแพร่ที่ใหญ่ขึ้น บทความอธิบายของเราเกี่ยวกับว่าเครื่องแยกเสียงพูดคืออะไรครอบคลุมพื้นฐานในเชิงลึกมากขึ้น
คำถามที่พบบ่อย
การแยกเสียงพูดด้วย AI คืออะไรในแบบง่ายๆ?
มันคือกระบวนการ AI ที่รับการบันทึกที่ผสมกันและแยกเสียงพูดของมนุษย์ออกมา ให้แทร็กเสียงที่สะอาดแก่คุณ และแทร็กพื้นหลังแยกต่างหาก (แบบเสริม) ที่คุณสามารถเก็บหรือทิ้งได้
Speech Separator ของเราต่างจากการลดสัญญาณรบกวนพื้นฐานอย่างไร?
การลดสัญญาณรบกวนแบบดั้งเดิมส่วนใหญ่จะลดทอนสัญญาณรบกวนแบบคงที่ เครื่องแยกเสียงของเราใช้การเรียนรู้เชิงลึกเพื่อรับรู้รูปแบบเสียงพูดและดึงมันออกจากเสียงพื้นหลังและดนตรีที่หลากหลาย ซึ่งมักให้บทสนทนาที่สะอาดกว่าและเป็นธรรมชาติกว่า
มันจัดการผู้พูดหลายคนได้ไหม?
Speech Separator ของเราได้รับการปรับให้เหมาะกับการแยกเสียงพูดของมนุษย์ออกจากพื้นหลังที่ไม่ใช่เสียงพูด ซึ่งทำงานได้ดีที่สุดกับผู้พูดหลักในการผสมเสียง การแยกเสียงที่ซ้อนทับกันหลายเสียงเป็นสาขาการวิจัยที่กำลังดำเนินการอยู่ และมีโมเดลเฉพาะทางอยู่ แต่มักมุ่งเป้าไปที่การประชุมหรือคอลเซ็นเตอร์มากกว่าเวิร์กโฟลว์ของครีเอเตอร์ทั่วไป
ทำไมการแยกเสียงพูดจึงสำคัญสำหรับการพากย์หลายภาษา?
การโลคัลไลเซชันพึ่งพาการถอดเสียงและการจับเวลาที่แม่นยำ แทร็กเสียงพูดที่สะอาดช่วยลดข้อผิดพลาดในการรับรู้และช่วยให้เสียงพากย์ที่แปลแล้วจัดตำแหน่งตรงกับวิดีโอต้นฉบับ ลด artifact ที่ได้ยินเมื่อเสียงใหม่ถูกผสมกับดนตรีและเอฟเฟกต์ที่คงไว้
ฉันต้องมีความรู้ทางเทคนิคมากแค่ไหนในการใช้มัน?
น้อยมาก คุณเพียงอัปโหลดไฟล์เสียงหรือวิดีโอ ปล่อยให้ AI ประมวลผล และดาวน์โหลดแทร็กเสียงพูดและพื้นหลังที่แยกออกมาเพื่อการแก้ไข การพากย์ หรือการทำงานอัตโนมัติ โดยไม่ต้องปรับพารามิเตอร์ด้วยตนเอง