A tradução de fala para fala converte palavras faladas em um idioma em fala audível em outro, de modo que seu público ouve a tradução em vez de lê-la. Imagine um instrutor que gravou uma aula em inglês e agora precisa de uma versão em espanhol sem regravar nada: o sistema transcreve o inglês, traduz o significado e gera o áudio em espanhol no lugar dele. Essa mudança de leitura para escuta é o ponto central, e ela altera como você planeja, revisa e publica conteúdo multilíngue.
A verdadeira questão raramente é se a tecnologia funciona. É qual versão dela você precisa: tradução gravada para vídeos, cursos e podcasts; tradução quase em tempo real para reuniões e eventos; saída que preserva a voz e mantém a identidade do locutor original; ou uma API que você pode integrar ao seu próprio aplicativo. Cada um desses caminhos traz diferentes compromissos em qualidade, latência e esforço de revisão, e este guia os mapeia para que você possa escolher com os olhos abertos.
Índice
Como funciona a tradução de fala para fala
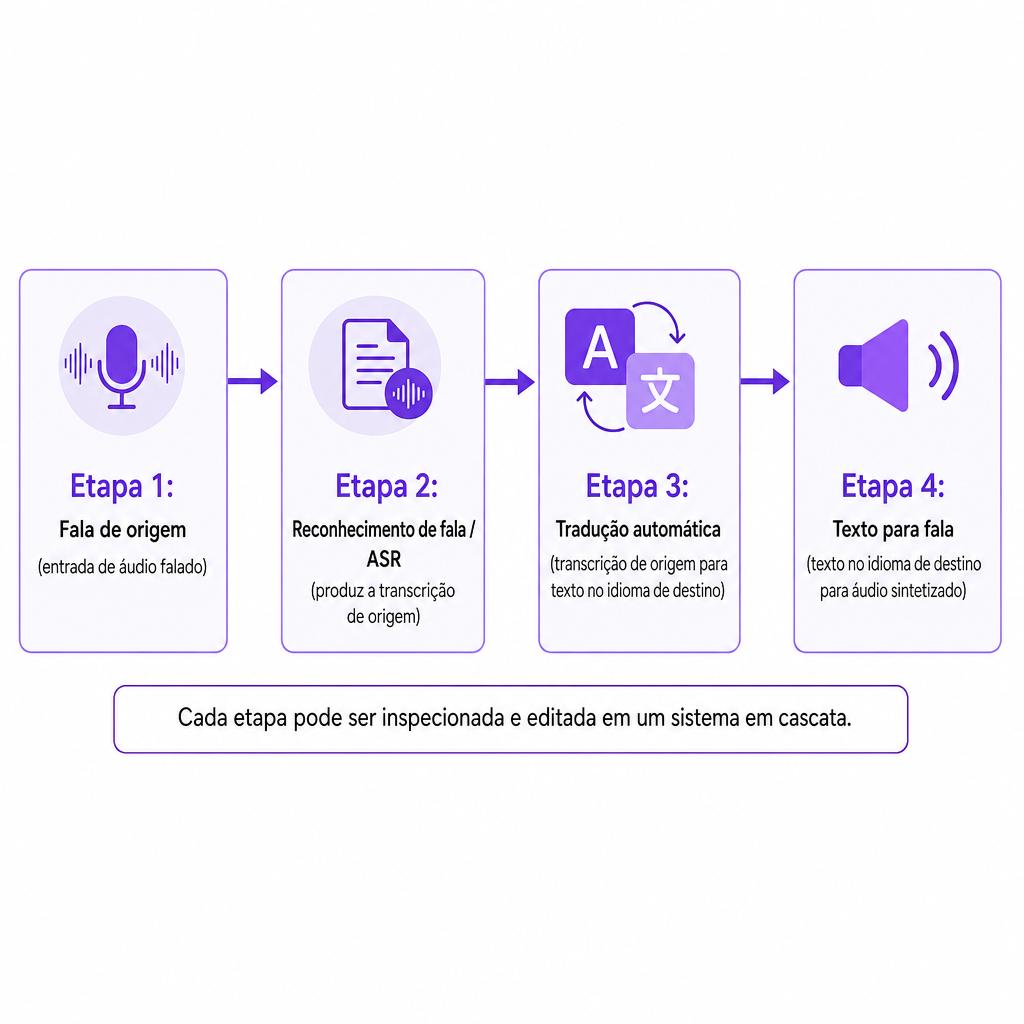
A maioria dos sistemas executa um pipeline conectado de três tecnologias. Primeiro, o reconhecimento automático de fala (ASR) analisa o áudio de origem e produz uma transcrição. Em seguida, a tradução automática converte esse texto no idioma de origem para o idioma de destino. Por fim, a conversão de texto em fala transforma o texto traduzido em áudio falado. O fluxo se lê claramente como fala de origem, depois reconhecimento, depois texto traduzido, depois fala sintetizada.
Fala de origem → reconhecimento de fala → texto traduzido → fala sintetizada
Esse design em camadas é chamado de tradução de fala para fala em cascata, e a publicação do NIST sobre avaliação de tradução de fala descreve a mesma estrutura: o ASR constrói a transcrição de origem, a tradução automática produz o texto no idioma de destino e a conversão de texto em fala gera a saída falada. A vantagem de uma cascata é que cada etapa é inspecionável, então você pode corrigir uma transcrição ou uma tradução antes mesmo de o áudio ser gerado.
Uma abordagem mais recente treina um modelo de ponta a ponta para mapear o áudio de origem diretamente para o áudio no idioma de destino, sem expor etapas separadas de transcrição e síntese. A pesquisa compartilhada por meio do relatório técnico da DTIC sobre tradução direta de fala enquadra isso como uma forma de reduzir o atraso e preservar mais da voz do locutor original, embora observe que ela ainda compromete velocidade, contexto, cobertura de idiomas e qualidade de saída. Na prática, a cascata lhe dá mais controle editorial; a abordagem de ponta a ponta busca menor latência e continuidade de voz.
Tradução de fala para fala versus tarefas relacionadas
As pessoas costumam confundir a tradução de fala para fala com transcrição, tradução de texto e dublagem, mas cada uma termina com um resultado diferente. A tradução de texto para no resultado escrito. A tradução de fala para fala termina com uma saída falada, embora um sistema em cascata ainda use texto internamente como representação intermediária. Esclarecer as entradas e saídas evita que você escolha a ferramenta errada para o trabalho.
| Tecnologia | Entrada | Saída | Uso típico |
|---|---|---|---|
| Fala para texto | Áudio falado | Transcrição escrita | Legendas, notas, conteúdo pesquisável |
| Tradução de texto | Texto escrito | Texto traduzido | Documentos, legendas, páginas web |
| Texto para fala | Texto escrito | Fala sintética | Narração, acessibilidade, interfaces de voz |
| Tradução de fala para fala | Áudio falado | Fala traduzida | Conversas, dublagem, mídia multilíngue |
A dublagem merece sua própria distinção. A tradução de fala para fala concentra-se estritamente em mudar o idioma falado. A dublagem é o fluxo de trabalho mais amplo de localização de mídia que a envolve: traduzir diálogos, atribuir locutores, gerar novas vozes, ajustar o tempo, mixar vozes traduzidas com música e áudio de fundo e exportar um projeto finalizado. Para um vídeo gravado do YouTube, um curso on-line, um podcast ou um filme, a dublagem geralmente é o formato mais prático porque adiciona esses controles editoriais sobre a tradução. Se você está pesando áudio contra texto na tela, nosso artigo sobre dublagem versus legendas para vídeo aborda essa escolha específica, e os mecanismos mais amplos estão em nosso guia sobre o que é dublagem por IA e como ela funciona.
Os três componentes que determinam a qualidade
A qualidade da saída não é um número único. É o produto de três etapas, cada uma com seus próprios modos de falha, então ajuda avaliá-las separadamente em vez de confiar em uma impressão geral.
O reconhecimento automático de fala identifica as palavras na gravação de origem, e sua precisão cai com música de fundo, locutores sobrepostos, sotaques fortes, fala rápida ou incompleta, termos específicos de domínio, microfones ruins e alternância entre idiomas. Uma métrica comum aqui é a taxa de erro de palavras (WER), que compara uma transcrição automática com uma referência humana contando substituições, exclusões e inserções. A mesma publicação do NIST usa a WER como referência de reconhecimento, embora uma WER baixa não confirme que a tradução posterior preservou significado ou tom. Se o seu áudio de origem for ruidoso, isolar a fala limpa primeiro com uma ferramenta como nosso separador de fala pode aumentar a precisão do reconhecimento antes mesmo de a tradução começar.
A tradução automática precisa interpretar mais do que palavras individuais. Ela lida com estrutura de frase, contexto, pronomes e gênero, expressões idiomáticas, humor, formalidade, referências culturais, terminologia técnica e diferenças na ordem das palavras. Uma tradução literal pode ser gramaticalmente correta, mas soar não natural ou alterar discretamente o significado pretendido, o que é especialmente arriscado para alegações publicitárias, instruções legais, informações médicas, conteúdo financeiro e material educacional.
A síntese de fala gera a voz final no idioma de destino, controlando pronúncia, pausas, velocidade de fala, entonação, ênfase, tom emocional, identidade de voz e sotaque ou variante de idioma. Nosso produto de Texto para Fala oferece mais de 300 vozes de IA, geração multilíngue e clonagem de voz em 33 idiomas, com controles para velocidade de fala, ênfase, leitura de números e entrega emocional. Uma tradução tecnicamente precisa ainda pode cair mal se a entrega não combinar com a marca, o curso ou o documentário a que pertence.
Clonagem de voz na fala traduzida
A clonagem de voz é opcional, mas é o que faz o conteúdo traduzido parecer vir do mesmo criador, em vez de um estranho lendo um roteiro. Em vez de atribuir uma voz pré-gravada sem relação a cada idioma, um sistema pode construir uma performance no idioma de destino modelada na identidade vocal do locutor original. Essa continuidade importa para um canal que quer uma voz reconhecível em todos os idiomas, uma empresa com um apresentador conhecido, um longo curso ministrado por instrutor, um cineasta que precisa de consistência entre versões dubladas ou um apresentador de podcast que mantém um som familiar em episódios traduzidos.
Não é uma garantia. A clonagem preserva a identidade vocal, mas emoção, humor, ritmo, pronúncia e contexto cultural ainda precisam de uma revisão humana antes de você publicar. Igualmente importante é a autorização: um fluxo de trabalho responsável confirma que quem forneceu a gravação consentiu com a clonagem e que a voz resultante pode ser usada para a distribuição comercial, pública ou geográfica pretendida. Se você tem curiosidade sobre os mecanismos por trás disso, nossa visão geral sobre como funciona a clonagem de voz aprofunda o tema, e a ferramenta de Clonagem de Voz mostra o lado da produção.
Tradução gravada versus tradução em tempo real
Essa é a decisão que a maioria das equipes realmente enfrenta, e os dois modos não devem ser julgados pela mesma medida.
A tradução gravada costuma ser a melhor escolha para produção de mídia porque dá tempo para trabalhar. Você pode corrigir a transcrição, editar a terminologia, revisar a tradução, identificar locutores, ajustar o tempo, regerar vozes, mixar áudio de fundo e executar garantia de qualidade humana antes que qualquer coisa seja publicada. Isso a torna bem adequada para canais do YouTube, e-learning, treinamento corporativo, podcasts, vídeos de produtos e filmes independentes.
A tradução em tempo real opera sob uma restrição mais rígida: ela precisa começar a produzir resultados antes que o locutor termine uma frase. Mais contexto melhora a qualidade da tradução, mas adiciona atraso, enquanto atrasos menores forçam previsões ou traduções parciais, e os erros são difíceis de retirar depois que o áudio já foi reproduzido. O relatório da DTIC observa que sistemas em cascata anteriores frequentemente funcionavam com atrasos de quatro a cinco segundos, acumulavam erros entre etapas e tinham personalização limitada, e que aumentar a antecipação de um modelo pode elevar a qualidade enquanto torna a interação menos imediata. Um recurso de conferência ao vivo e uma dublagem multilíngue polida resolvem problemas diferentes, então avalie-os por padrões diferentes.
Como avaliar um fluxo de trabalho de fala para fala
Teste com uma amostra representativa, não com uma frase de demonstração arrumada. A lista de verificação abaixo espelha as condições reais que seu conteúdo vai encontrar, e mantém a avaliação honesta.
- Cobertura de idioma e dialeto: "Suporta espanhol" pode não significar o sotaque, o vocabulário ou as preferências regionais que seu público espera. Confirme as variantes de origem e destino, incluindo inglês dos EUA versus outros ingleses, espanhol latino-americano versus europeu e francês canadense versus europeu.
- Precisão da transcrição: Uma tradução não pode corrigir de forma confiável uma transcrição que distorce nomes, números ou termos de produto. Verifique se você pode inspecionar e editar a transcrição antes de gerar o áudio.
- Significado e contexto: Teste deliberadamente expressões idiomáticas, piadas, chamadas à ação, alegações de produto e terminologia do setor. Fluência não é precisão.
- Tratamento de locutores: Para entrevistas, painéis e filmes, verifique se a ferramenta consegue identificar múltiplos locutores e manter suas vozes consistentes, inclusive quando as pessoas se interrompem.
- Tempo e sincronização: As frases traduzidas raramente correspondem à duração original. Procure controles de tempo ou velocidade de fala, além de edições de diálogo, preservação de áudio de fundo, ajuste de volume, regeneração de segmentos e alinhamento visual onde necessário.
- Naturalidade da voz: Ouça com atenção a pronúncia, pausas, ênfase, alcance emocional e ritmo não natural.
- Latência: Para uso ao vivo, meça o atraso do locutor ao áudio. Para uso gravado, priorize a flexibilidade de edição em vez da velocidade bruta de processamento.
- Controles de revisão e exportação: Uma ferramenta pronta para produção permite que você corrija texto, regere segmentos individuais, ajuste o tempo e exporte em um formato que seu fluxo de publicação aceite.
Execute essas amostras na sua lista de finalistas e compare a precisão da transcrição, o significado da tradução, a pronúncia, a naturalidade da voz, a consistência de locutores, o tempo, a qualidade do áudio de fundo, o esforço de revisão e o custo total no volume esperado. O sistema mais forte não é o que tem mais vozes ou idiomas. É aquele que produz resultados aceitáveis para o seu conteúdo específico com uma carga de revisão que sua equipe consiga realmente sustentar.
Riscos e limitações que vale a pena planejar
Cada etapa introduz seu próprio tipo de erro, e uma voz de som natural pode disfarçar todos eles. A IA pode traduzir incorretamente expressões ambíguas, nomes, expressões idiomáticas e termos especializados, então a revisão humana continua essencial sempre que a precisão carregar peso legal, de segurança, financeiro ou de reputação. Os erros de reconhecimento agravam o problema: ruído, sobreposição de vozes, sotaques e gravações ruins podem fazer o sistema ouvir errado a origem, razão pela qual revisar a transcrição antes de aprovar a tradução é inegociável.
O significado cultural é fácil de perder. Uma tradução direta pode descartar humor, cortesia ou referências que só sobrevivem a uma reescrita, em vez de uma passagem palavra por palavra. A clonagem de voz adiciona risco de consentimento e falsidade de identidade, então documente quem autorizou a voz, o escopo de uso, o território, a duração e se ela pode aparecer em publicidade ou declarações públicas sintéticas. Há também uma dimensão de confiança do público: o relatório da DTIC descreve como uma experiência de tradução informa os usuários de que o áudio traduzido é gerado sinteticamente, uma expectativa razoável a ser planejada em suas próprias divulgações.
Dois riscos mais silenciosos completam a lista. A privacidade importa sempre que o áudio contém informações pessoais, discussões confidenciais, dados de clientes ou conteúdo não lançado, então revise os termos de tratamento, retenção, acesso e exclusão de dados de um provedor antes de fazer o upload. E a falsa confiança é a falha mais insidiosa de todas: uma voz polida faz uma tradução incorreta soar confiável, então nunca trate a fluência como prova de precisão factual.
Onde o DubSmart se encaixa
Somos mais diretamente relevantes para a tradução gravada de fala para fala por meio da Dublagem por IA, em vez de qualquer alegação de tradução conversacional universal ao vivo. Nosso fluxo de trabalho de dublagem aceita uploads de áudio e vídeo e links do YouTube, suporta mais de 60 idiomas de origem e 33 idiomas de destino, clona a voz de cada locutor para a versão traduzida e permite que você edite texto, locutores e tempos, regere segmentos, ajuste o volume do som de fundo e baixe o projeto finalizado. Essa camada editorial é exatamente o que a produção de mídia gravada precisa.
Para equipes que constroem seus próprios pipelines, também oferecemos APIs de Dublagem por IA, Texto para Fala e Clonagem de Voz, que atendem agências, fluxos de trabalho de mídia e aplicativos que precisam automatizar a produção de voz multilíngue. A escolha certa depende de se o seu projeto quer um editor de mídia finalizado, um pipeline orientado por API ou ambos. Para uma mensagem curta e de alto risco, a tradução e gravação profissional humana ainda podem vencer; para uma biblioteca de conteúdo grande e frequentemente atualizada, um fluxo de trabalho de IA escala melhor, com a revisão humana focada no material de maior risco.
Perguntas frequentes
A tradução de fala para fala é o mesmo que interpretação?
Não. A interpretação humana depende de uma pessoa treinada ouvindo, entendendo e transmitindo o significado no momento. A tradução de fala para fala é automatizada: rápida e escalável, mas pode exigir revisão e pode ter dificuldades com nuances que um intérprete profissional lida naturalmente.
Ela sempre funciona em tempo real?
Não. Alguns sistemas processam áudio gravado com controle total de edição, enquanto outros fornecem saída ao vivo ou quase em tempo real. Os sistemas ao vivo equilibram constantemente contexto de tradução, latência e precisão.
Ela pode preservar a voz do locutor original?
Às vezes. Sistemas que usam clonagem de voz ou síntese que preserva a voz podem modelar a identidade do locutor original, mas o resultado depende da tecnologia, do par de idiomas, da qualidade do áudio e da autorização para usar essa voz.
A dublagem por IA é uma forma de tradução de fala para fala?
Sim. A dublagem por IA é uma aplicação para mídia gravada da tradução de fala para fala que adiciona recursos de edição, gerenciamento de locutores, tempo, mixagem e exportação sobre a tradução principal.
Qual é a precisão dela?
A precisão varia conforme o idioma, a qualidade da gravação, a terminologia, o locutor e o sistema. Avalie a transcrição, a tradução e o áudio gerado separadamente, em vez de confiar em uma única porcentagem de precisão.