Se o seu microfone capta o trânsito, a conversa de um café ou uma trilha musical bem em cima do diálogo, a questão não é se a gravação é utilizável — é como extrair a voz de volta de forma limpa. É exatamente isso que um separador de fala faz. Em termos simples, um separador de fala é uma ferramenta de áudio com inteligência artificial que isola a fala humana de tudo o mais em uma gravação — ruído de fundo, música e outros sons — deixando você com uma faixa de voz limpa que pode transcrever, dublar, clonar ou remixar. Para quem produz conteúdo multilíngue, essa faixa limpa é a diferença entre uma dublagem que soa profissional e uma que soa "boa o suficiente".
Este guia explica o que um separador de fala realmente é, como funciona por baixo dos panos, quando você genuinamente precisa de um e o que considerar antes de se comprometer com uma ferramenta. Nós integramos o Separador de Fala ao fluxo de trabalho da DubSmart AI justamente porque a fala limpa é a base sobre a qual tudo o mais se apoia.
Índice
O que realmente é um separador de fala
Na pesquisa de áudio, a separação de fala é definida como a tarefa de separar a fala-alvo da interferência de fundo em uma gravação mista. Sistemas mais avançados vão além e separam vários locutores uns dos outros, produzindo uma faixa isolada para cada voz.
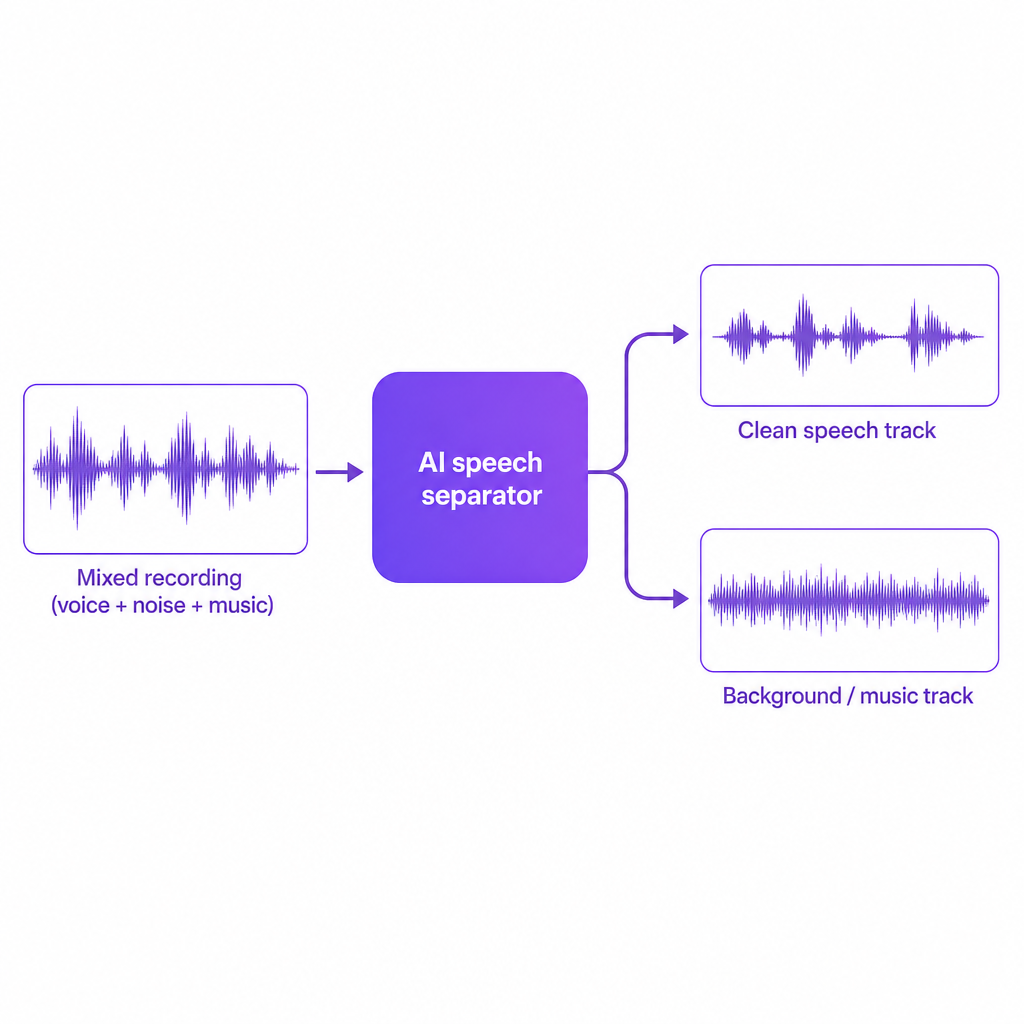
Traduzido para o trabalho cotidiano de produção, um separador de fala recebe um arquivo de áudio misto — diálogo mais ruído ou música — e gera uma ou mais faixas contendo apenas fala, além de uma faixa opcional com o áudio de fundo restante. Nosso Separador de Fala foi criado para remover o ruído de fundo e isolar a fala de qualquer gravação, o que o torna ideal para a pós-produção de filmes, podcasts e entrevistas. Ele funciona tanto com arquivos de áudio quanto de vídeo: pode reduzir o ruído de gravações feitas em ambientes barulhentos e separar os vocais de uma faixa de acompanhamento, deixando você com stems distintos de voz e de fundo.
É aqui que um equívoco comum atrapalha as pessoas. Um separador de fala não é a mesma coisa que redução de ruído tradicional. A redução de ruído diminui o volume do som indesejado. Um separador de fala identifica ativamente onde a fala está presente no sinal e a reconstrói como um fluxo separado e mais limpo. Essa distinção é o motivo pelo qual um separador consegue resgatar uma voz enterrada sob a música, enquanto um noise gate na maioria das vezes apenas deixa toda a gravação mais silenciosa.
Você realmente precisa de um?
A verdadeira decisão é se o seu trabalho depende de um áudio de fala confiável e limpo, em vez do que o microfone acabou capturando. Se depender, um separador dedicado deixa de ser um "seria bom ter" e se torna uma etapa fundamental.
Várias situações tornam essa melhoria óbvia. Criadores do YouTube e pequenas empresas costumam reaproveitar filmagens antigas gravadas em salas com eco, cafés ou na rua, onde o ruído torna a fala difícil de entender e de transcrever. Equipes de e-learning e treinamento montam cursos multilíngues a partir de webinars e palestras ao vivo, nos quais cada transcrição e dublagem subsequente herda a qualidade da fala original. Cineastas e produtores de podcast frequentemente precisam recuperar uma ótima performance capturada em condições imperfeitas antes de mixá-la novamente com música e design de som. E desenvolvedores ou agências que alimentam áudio de usuários em pipelines de transcrição, clonagem de voz ou dublagem sabem que entradas ruidosas prejudicam diretamente a precisão do modelo.
Alguns gatilhos concretos sinalizam que vale a pena adotar um separador:
- Você está localizando para vários idiomas e quer dublagem e legendas consistentes e claras. A fala limpa alimenta nossos motores de Dublagem com IA e Fala para Texto de forma muito mais confiável do que uma mistura ruidosa.
- Você depende da clonagem de voz para uma voz de marca ou de personagem e quer os melhores resultados possíveis, treinando com amostras livres de ruído e artefatos.
- Você recebe regularmente gravações geradas por usuários ou feitas em campo sobre as quais não teve controle, e ainda assim precisa que fiquem prontas para transmissão. Um separador oferece uma etapa de limpeza repetível em vez de ajustar manualmente cada arquivo.
A exceção honesta: se o seu áudio já é gravado em um estúdio tratado, com stems separados para diálogo e música, um separador é uma conveniência e não uma exigência. Para todos os demais que trabalham com som do mundo real, ele conquista um lugar permanente no pipeline.
Como a separação de fala funciona por baixo dos panos
A separação de fala moderna é construída sobre aprendizado profundo e pesquisa de separação de fontes, não sobre EQ e filtros simples. A tarefa subjacente é fácil de enunciar e difícil de resolver: dado um sinal misto que contém várias fontes, recuperar os sinais individuais de fala sem conhecê-los de antemão.
A maioria dos sistemas atuais segue um pipeline codificador–separador–estimador–decodificador. O codificador mapeia a forma de onda bruta ou o espectrograma para um espaço de características de alta dimensão, onde padrões relevantes para a fala, como formantes e harmônicos, ficam mais fáceis de detectar. O separador — uma rede neural — processa essas características e aprende a desacoplar as informações pertencentes a diferentes fontes sonoras, seja fala versus ruído ou um locutor versus outro. A etapa de estimativa então prevê máscaras que filtram os componentes que não são fala ou estima diretamente a representação de características de cada fonte. Por fim, o decodificador converte essas representações separadas de volta em áudio no domínio do tempo, resultando em uma ou mais faixas de fala limpa e, opcionalmente, uma faixa residual de fundo.
Esses modelos são treinados em grandes conjuntos de dados repletos de misturas de fala e ruído, aprendendo os padrões discriminativos de fala, locutores e interferência a partir de exemplos rotulados. Pesquisas mais recentes condicionam o separador a embeddings de locutor ou prompts, o que torna possível direcionar a separação para uma voz específica dentro de um áudio cheio de sons.
A conclusão prática para os criadores é que um separador moderno não é um noise gate glorificado. É um modelo que aprendeu como a fala se parece e soa em muitas condições, e que consegue reconstruir uma voz mesmo quando ela está enterrada sob música, barulho de multidão ou eco da sala.
As duas principais tarefas de separação
Na prática, você encontrará dois tipos de separação de fala, e as plataformas frequentemente os combinam.
O primeiro é fala de um único locutor versus fundo: extrair uma faixa de voz coerente do ruído, da música ou do ambiente. Esta é a tarefa em que nosso Separador de Fala se concentra para filmes, podcasts e entrevistas, porque corresponde diretamente ao que a maioria dos criadores precisa no dia a dia.
O segundo é a separação de múltiplos locutores, na qual o sistema produz uma faixa separada para cada locutor de uma conversa. Isso é especialmente útil para diarização e análise em reuniões longas ou debates em painel, onde saber quem disse o quê importa tanto quanto o que foi dito.
As ferramentas para o consumidor tendem a empacotar isso em interfaces simples — faça upload de uma música para obter faixas separadas de vocal e instrumental, ou isole o diálogo em um vídeo para edição. Nossa implementação enfatiza a separação de fala versus fundo porque é a tarefa de valor mais imediato para fluxos de trabalho de dublagem, transcrição e clonagem.
O que considerar antes de escolher um separador
Ao avaliar se um separador atende a necessidades profissionais, um punhado de critérios importa mais do que o texto de marketing.
Comece pela qualidade da fala e pelos artefatos. Um bom separador preserva o timbre natural de uma voz em vez de fazê-la soar metálica, subaquática ou com efeito de fase, e evita introduzir ruído musical ou distorção áspera ao remover elementos de fundo fortes, como música. Levantamentos acadêmicos apontam a interferência residual e os artefatos como os principais desafios, especialmente em ruído não estacionário. O teste mais confiável ainda é verificar amostras de saída no seu próprio material.
A robustez ao ruído do mundo real vem em seguida. Modelos treinados com dados limpos de laboratório podem ter dificuldade com trânsito, vento, murmúrio de multidão, salas reverberantes e conteúdo em que a fala se sobrepõe a música ou efeitos altos. O trabalho de ponta mira exatamente essas misturas complexas, mas o desempenho ainda varia conforme as condições de gravação — então teste nos ambientes em que você realmente grava, de escritórios a ruas e estúdios caseiros.
Lidar com música e conteúdo misto é uma necessidade frequente e específica. Remover uma trilha sonora para redublar, ou isolar a narração do B-roll, exige uma ferramenta que suporte explicitamente a separação de música e voz e produza dois arquivos utilizáveis em vez de um único resultado abafado. Nosso pipeline de separação detecta as frequências vocais, isola-as da música e produz arquivos separados de alta qualidade: um com vocais limpos e outro com a trilha musical. Isso é especialmente útil quando você planeja remixar, re-trilhar ou redublar para outros idiomas.
A integração com ferramentas subsequentes determina quanto tempo o separador realmente economiza. A separação raramente atua sozinha — ela alimenta modelos de transcrição, nos quais uma entrada mais limpa reduz taxas de erro de palavras, motores de clonagem de voz que recompensam amostras livres de ruído e sistemas de dublagem que alinham a fala original com as faixas traduzidas. Nossa plataforma é construída em torno de um fluxo de trabalho unificado que mantém Separador de Fala, Fala para Texto, Texto para Fala, Clonagem de Voz e Dublagem com IA em um só lugar, de modo que uma única gravação limpa pode se tornar conteúdo multilíngue, com voz clonada e totalmente localizado, sem reconstruir um pipeline a cada vez.
Latência, escala e automação importam para quem tem uma fila de trabalho acumulada. Podcasts, cursos e arquivos de longa duração precisam de processamento em lote que lide com arquivos de várias horas, tempos de processamento razoáveis por arquivo e ganchos de automação para que a separação atue dentro dos seus próprios sistemas. Fornecemos APIs de Texto para Fala, Clonagem de Voz e Dublagem com IA para que desenvolvedores possam conectar o processamento de fala a pipelines de ponta a ponta.
Por fim, privacidade e conformidade não desaparecem quando o áudio fica limpo. Separar a fala do fundo não elimina a sua responsabilidade sobre gravações que possam conter conversas sensíveis, nem sobre o respeito aos direitos quando você extrai e reutiliza vozes de material licenciado. Equipes corporativas devem confirmar políticas claras de retenção e uso de dados e alinhar qualquer fluxo de trabalho de separação às diretrizes internas de conformidade.
Onde ele deixa a desejar
Um separador de fala pode transformar uma gravação, mas não é mágica, e fingir o contrário leva a decisões ruins.
A redução excessiva de ruído é a armadilha mais comum. A separação agressiva pode remover pistas sutis da fala — consoantes suaves, o tom natural da sala — e deixar uma voz soando artificial ou cansativa de ouvir. Os artefatos residuais são o outro lado da moeda: em condições difíceis, um modelo pode deixar traços de música ou ruído na faixa de fala, ou gerar ruído musical, particularmente quando a interferência é forte e muda constantemente.
Há também o viés de locutor e idioma a considerar. Modelos treinados predominantemente em certos idiomas, sotaques ou estilos de fala podem ter desempenho pior com vozes sub-representadas. E uma forma de onda de aparência limpa pode criar uma falsa sensação de segurança: ela não garante que o áudio seja adequado para tarefas críticas, como análise forense ou contextos de conformidade rigorosa.
Para trabalhos criativos e de localização, essas limitações são gerenciáveis, mas são um forte argumento para testar com amostras representativas do seu próprio material, em vez de confiar nas demonstrações do fornecedor.
O Separador de Fala dentro do nosso fluxo de trabalho
Tratamos o Separador de Fala como uma implementação prática e amigável ao criador dessa tecnologia, fortemente integrada ao restante da plataforma DubSmart AI, em vez de acoplada por cima.
Na prática, ele remove o ruído de fundo e isola a fala de qualquer gravação, produzindo uma voz limpa adequada para pós-produção em filmes, podcasts e entrevistas. Ele extrai vocais nítidos de faixas mistas e gera arquivos separados de alta qualidade para fala e música de fundo, permitindo que você edite, reduble ou remixe sem lutar contra a mixagem original. Ele funciona tanto com fontes de áudio quanto de vídeo — você faz upload dos arquivos ou usa links, passa-os pelo pipeline e baixa as faixas finalizadas. E, o mais importante, essas saídas são otimizadas para alimentar nossas outras ferramentas, de modo que uma única gravação limpa pode se transformar em conteúdo multilíngue, com voz clonada e totalmente localizado.
Para criadores do YouTube, pequenas empresas, instrutores, cineastas, podcasters e equipes de desenvolvimento, essa integração muda o papel da própria separação. Ela deixa de ser uma tarefa isolada de "consertar o áudio" e se torna a primeira etapa padronizada em um ciclo de vida maior, automatizado, de criação e localização de conteúdo. Se você está construindo um canal ou uma biblioteca de cursos multilíngue, é aí que a real economia de tempo se acumula.
Perguntas frequentes
O que é um separador de fala, em termos simples?
É uma ferramenta de IA que recebe uma gravação ruidosa e mista e gera uma faixa em que você ouve principalmente apenas a voz humana, além de faixas de fundo opcionais que você pode manter ou descartar.
Um separador de fala é a mesma coisa que redução de ruído?
Não. A redução de ruído simplesmente diminui os sons indesejados. A separação de fala identifica e reconstrói explicitamente a fala como uma fonte distinta, geralmente com maior clareza e mais controle sobre o resultado.
Um separador de fala consegue lidar com mais de um locutor?
Muitos sistemas de nível acadêmico e alguns produtos conseguem separar vários locutores em faixas individuais, embora a qualidade varie conforme a sobreposição e as condições de gravação. Nosso Separador de Fala foca principalmente em isolar a fala do fundo para fluxos de trabalho comuns de criadores.
Usar um separador de fala vai melhorar meus resultados de dublagem e clonagem de voz?
Sim. Um áudio de entrada mais limpo geralmente melhora o reconhecimento de fala, o alinhamento e a qualidade da clonagem de voz, o que torna a dublagem multilíngue e as vozes clonadas mais naturais e consistentes.
A separação de fala funciona independentemente do idioma?
A maioria dos modelos de separação opera com base em padrões acústicos, e não em texto, então consegue lidar com muitos idiomas. O desempenho ainda depende dos dados de treinamento e de quão bem o seu sotaque está representado.