Um modificador de voz com IA em tempo real converte sua voz em uma voz diferente enquanto você fala, capturando o áudio do microfone, analisando-o, transformando a identidade do locutor e reproduzindo o áudio convertido com um pequeno atraso. Diferente de um filtro básico de alteração de tom, ele pode manter grande parte das suas palavras, ritmo e expressão intactos, ao mesmo tempo em que altera qualidades como timbre, idade percebida, apresentação de gênero ou estilo de personagem. E, ao contrário da conversão de texto em fala, ele parte da fala ao vivo em vez de texto digitado.
A verdadeira decisão para criadores de conteúdo, streamers, educadores e empresas não é simplesmente se o resultado soa realista. É se a ferramenta se adapta ao seu tipo de entrada, tolerância à latência, necessidades de controle de voz, integrações, obrigações de direitos e qualidade de produção desejada. Este guia explica como a tecnologia funciona, onde ela se encaixa em relação a ferramentas de voz com IA relacionadas e quando um fluxo de trabalho gravado atende melhor às suas necessidades.
Índice
O que "tempo real" realmente significa
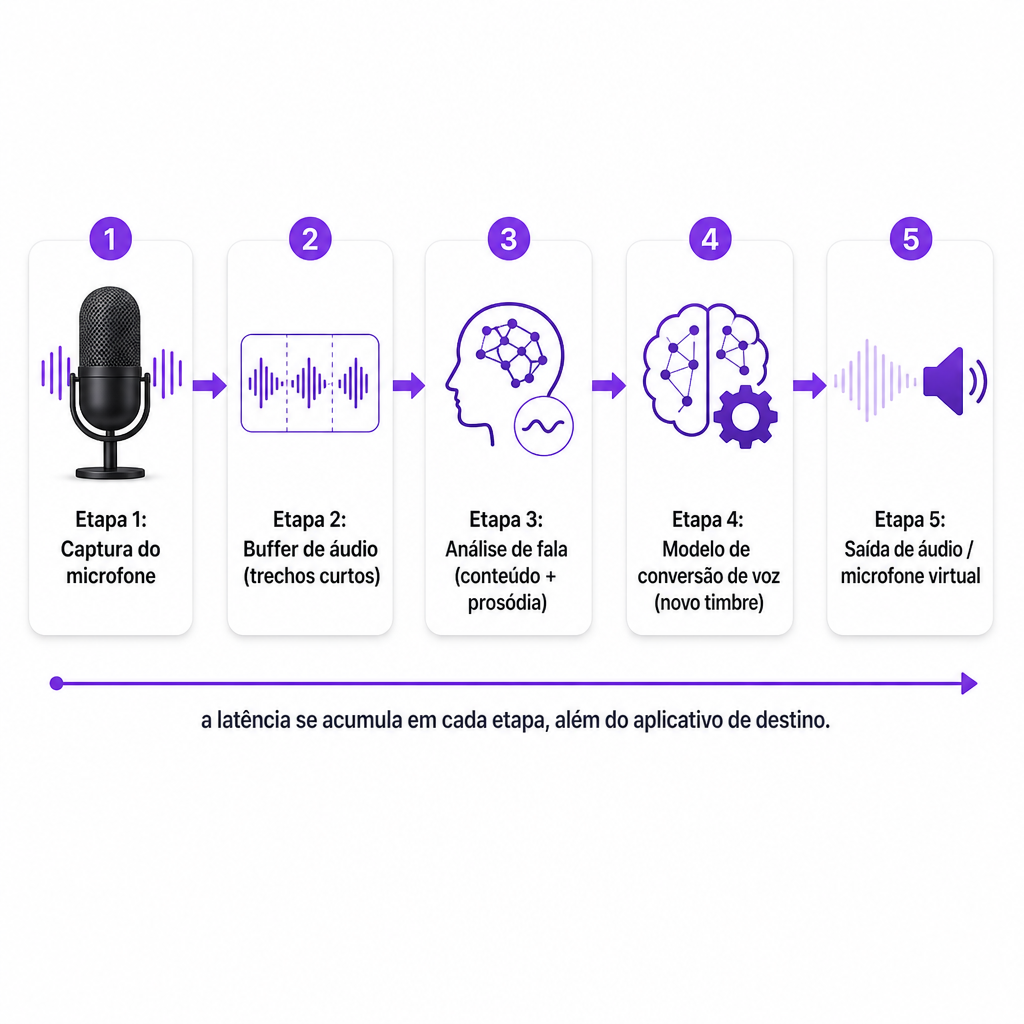
"Tempo real" significa que o sistema processa um fluxo de áudio recebido enquanto você fala, em vez de esperar por uma gravação completa ou um roteiro finalizado. O sinal percorre um caminho contínuo: microfone, buffer de áudio, análise de fala, modelo de conversão de voz, saída de áudio. Como o conversor trabalha em segmentos curtos em vez de frases completas, a conversão de voz por streaming é tecnicamente diferente de renderizar uma narração finalizada em que todo o roteiro é conhecido com antecedência.
Algum atraso é inevitável. O sistema precisa de tempo para capturar, analisar, sintetizar e emitir cada fragmento de áudio. Pesquisas demonstram que a conversão de baixa latência é possível, embora os números dependam fortemente do modelo, do hardware, do tamanho do buffer e da qualidade do áudio. O modelo de pesquisa LLVC relata latência abaixo de 20 milissegundos em uma CPU de consumo, enquanto o StreamVC relata uma latência de ponta a ponta de 70,8 milissegundos em seu ambiente de avaliação. Esses são resultados de pesquisa sob condições específicas, não garantias de desempenho para qualquer ferramenta comercial que você possa baixar.
Como funciona um modificador de voz com IA em tempo real
O processo é executado como um loop enquanto você fala, não como uma única renderização. Entender os quatro estágios ajuda a avaliar por que uma ferramenta parece natural e outra parece robótica ou travada.
Primeiro, o sistema captura sua fala. Ele recebe o áudio de um microfone ou de outra entrada ao vivo e o divide em fragmentos curtos para que o modelo possa processá-lo continuamente. A qualidade da entrada importa mais do que muitos usuários esperam. Ruído de fundo, eco do ambiente, barulho de teclado, clipping e um sinal instável empurram a conversão para artefatos não naturais.
Segundo, ele separa o conteúdo da fala da identidade do locutor. Uma voz carrega várias camadas sobrepostas ao mesmo tempo: o conteúdo linguístico, ou palavras; a prosódia, ou seja, ritmo, ênfase e entonação; o tom; o timbre que torna uma voz reconhecível; e a identidade mais ampla do locutor. Os sistemas de conversão tentam preservar o conteúdo e a expressão enquanto substituem as características do locutor. Pesquisas modernas de streaming descrevem isso como manter o conteúdo e a prosódia da fala de origem ao mesmo tempo em que correspondem ao timbre vocal de um locutor-alvo. Essa separação é o motivo pelo qual um bom conversor permite que você fale espontaneamente em uma voz transformada em vez de aplicar um filtro fixo de "robô" por toda a forma de onda.
Terceiro, o modelo sintetiza uma nova voz. Ele reconstrói o áudio usando um perfil de voz-alvo, que pode ser um personagem integrado, uma voz de biblioteca, uma voz personalizada criada a partir de gravações autorizadas ou um perfil projetado para anonimização em vez de imitação. A saída é produzida continuamente com um pequeno buffer de antecipação. Mais contexto pode melhorar a estabilidade, mas também adiciona atraso, que é o principal compromisso da conversão ao vivo.
Quarto, o sinal convertido é roteado para um aplicativo. Uma ferramenta de desktop normalmente expõe a saída como um microfone virtual, de modo que outros programas a recebem como se fosse um microfone normal. Esse roteamento é o que torna possíveis transmissões ao vivo, jogos online, videochamadas, bate-papos por voz e eventos virtuais. Um modificador em tempo real, portanto, precisa funcionar no nível do sistema operacional e do aplicativo, não apenas dentro do modelo. A compatibilidade com software de streaming, Discord, Zoom, navegadores e dispositivos móveis pode importar tanto quanto a qualidade pura da voz. Se você quiser extrair um texto limpo desse mesmo áudio capturado para legendas ou reaproveitamento, uma etapa separada de fala para texto cuida da transcrição em vez da conversão.
Conversão em tempo real vs. ferramentas de voz com IA relacionadas
Essas tecnologias se sobrepõem na mente das pessoas, mas resolvem problemas genuinamente diferentes. A tabela abaixo esclarece o que cada uma recebe como entrada e quando a saída chega.
| Tecnologia | Entrada | Momento da saída | Mais adequado para |
|---|---|---|---|
| Modificador de voz em tempo real | Fala ao vivo pelo microfone | Durante a conversa | Chamadas ao vivo, jogos, streaming, performance |
| Texto para fala | Texto escrito | Após o envio do texto | Narração, tutoriais, anúncios, e-learning |
| Clonagem de voz | Amostras de voz | Gerada sob demanda | Voz sintética reutilizável para narração ou dublagem |
| Dublagem com IA | Áudio ou vídeo existente | Após o processamento | Traduzir e localizar conteúdo gravado |
| Efeito de tom ou formante | Áudio ao vivo ou gravado | Ao vivo ou quase ao vivo | Modificação criativa simples de voz |
Essa distinção é prática, não acadêmica. Uma plataforma pode oferecer geração de voz com IA ou clonagem de voz robustas sem oferecer um modificador de microfone ao vivo para chamadas e transmissões. Nossas próprias ferramentas focam em mídia gerada e localizada: oferecemos Texto para Fala, Clonagem de Voz, Dublagem com IA, Fala para Texto, Separador de Fala, Texto para Imagem e Imagem para Vídeo dentro de um único fluxo de trabalho. Estes são projetados para produzir áudio a partir de texto ou construir uma voz reutilizável para conteúdo gerado, então pertencem ao lado do fluxo de trabalho gravado desta tabela, e não à conversão de microfone ao vivo.
Para que serve a conversão de voz ao vivo
Streamers e gamers recorrem à conversão de voz para manter um personagem, proteger a privacidade ou manter uma persona de canal consistente. A baixa latência importa mais aqui, porque você está reagindo a outros jogadores e conversando com um público. Um pequeno atraso é tolerável em um monólogo no estilo transmissão, mas se torna gritante durante uma conversa rápida, jogo competitivo ou tempo cômico.
Em reuniões online e eventos virtuais, uma voz convertida pode apoiar interpretação de papéis, demonstrações, cenários de acessibilidade ou participação com preocupação com a privacidade. Para contextos profissionais, a inteligibilidade e a confiabilidade devem superar a novidade, e os participantes devem ser informados quando uma voz é transformada, caso o silêncio possa induzi-los ao erro.
A performance de personagem é outro uso ao vivo. Cineastas independentes, desenvolvedores de jogos e podcasters podem testar vozes de personagens ou executar diálogos temporários na hora. Para a entrega final, no entanto, uma narração com IA gravada ou uma performance humana geralmente oferece melhor controle de edição e consistência de sessão para sessão.
Privacidade e anonimização de voz são um objetivo distinto da imitação. A anonimização tenta ocultar quem está falando, enquanto a imitação tenta reproduzir uma identidade-alvo específica. Nenhuma das duas é infalível, e uma voz transformada ainda pode revelar hábitos de fala, maneirismos ou sons de fundo que ajudam a identificar o locutor.
Por fim, a tecnologia de voz sintética apoia a acessibilidade e a comunicação assistiva para pessoas que perderam a capacidade de falar. A Comissão Federal de Comércio dos EUA (FTC) reconhece esse benefício médico e de acessibilidade, ao mesmo tempo em que alerta que a replicação de voz pode ser abusada para fraude e uso indevido de dados biométricos.
Os critérios de decisão que realmente importam
A latência vem primeiro, e você deve pedir a latência medida de ponta a ponta, não apenas a velocidade de inferência do modelo. O atraso que você realmente sente inclui a captura do microfone, o buffering, a extração de características, a inferência do modelo, a síntese, o roteamento da saída e o que quer que o aplicativo de chamada ou streaming adicione por cima. Um modelo que tem um bom desempenho em testes isolados pode parecer lento quando o caminho completo é montado.
A naturalidade é o próximo teste. Preste atenção a artefatos metálicos, saltos tonais repentinos, problemas de respiração e pronúncia, pausas não naturais, consoantes distorcidas, falhas nos limites das frases e perda de expressão emocional. Uma voz convincente deve permanecer compreensível durante a fala espontânea, não apenas durante falas de demonstração cuidadosamente lidas.
A preservação do conteúdo da fala é fácil de ignorar até que falhe. Teste fala rápida, interrupções, números, nomes, sotaques, risadas, perguntas e mudanças de volume. Uma ferramenta que altera a identidade mas achata seu ritmo e entonação é inadequada para performance ou interação ao vivo.
A seleção e personalização de voz determinam o quanto você pode moldar o resultado. Verifique vozes integradas, criação de voz personalizada, controles de tom e timbre, opções de emoção ou estilo, escolhas de sotaque, consistência entre sessões e quaisquer restrições de uso comercial. A criação de voz personalizada deve sempre exigir autorização clara: uma amostra de voz não é permissão para imitar a pessoa de quem ela veio.
O suporte a hardware e plataforma decide se a ferramenta se encaixa no seu setup. Confirme se ela roda localmente em CPU ou GPU, em um navegador, por meio de um aplicativo de desktop, em dispositivos móveis, por meio de um microfone virtual ou por meio de uma API. O processamento na nuvem pode simplificar a configuração, mas introduz latência de rede e questões de governança de dados, enquanto o processamento local pode reduzir o atraso de rede, mas exige hardware mais capaz. Separadamente, verifique o roteamento de áudio: um modelo robusto é inútil se sua saída não puder ser selecionada como o microfone no aplicativo pretendido.
O tratamento de dados encerra a lista. Antes de enviar qualquer amostra de voz, verifique se as gravações são retidas, se elas alimentam a melhoria do modelo, como as vozes personalizadas são excluídas, quem pode acessar os arquivos, se existem controles corporativos ou empresariais e o que acontece com o áudio gerado posteriormente. Gravações de voz podem ser dados pessoais sensíveis ou relacionados a biometria, dependendo do contexto e da lei aplicável, então trate-as dessa forma.
Quando um fluxo de trabalho gravado supera o tempo real
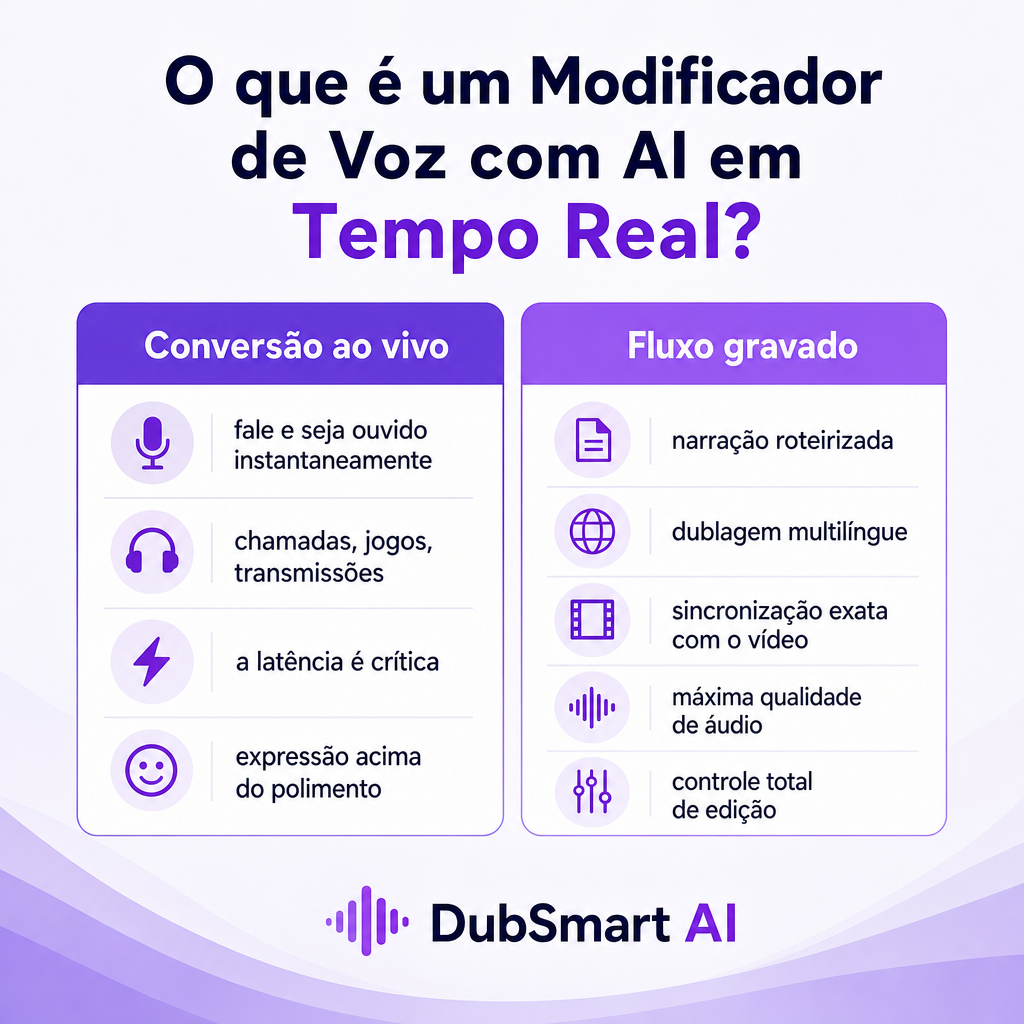
A conversão ao vivo é a escolha certa quando uma pessoa precisa falar naturalmente e ter a voz transformada ouvida imediatamente. É a escolha errada quando sua prioridade é a máxima qualidade de áudio, pronúncia precisa, narração multilíngue, sincronização exata com o vídeo, edição detalhada, narração comercial consistente ou dublagem de alta qualidade.
Para esses objetivos, um pipeline gravado vence. Com texto para fala, você controla e refina o roteiro antes que qualquer áudio seja gerado, o que elimina totalmente o problema da latência ao vivo. Com a dublagem com IA, o sistema processa um vídeo existente e alinha a fala traduzida com a origem, algo que nenhum modificador ao vivo consegue fazer. Se o seu arquivo de origem mistura diálogo com música ou ruído, um separador de fala pode isolar uma faixa de voz limpa antes de você processá-la. Nossa Dublagem com IA foi criada para traduzir áudio ou vídeo gravado para os idiomas-alvo suportados, não para converter um feed de microfone ao vivo.
Riscos e uso responsável
Falsidade ideológica e fraude são o principal risco. Uma voz convertida realista pode tornar uma identidade falsa mais crível, e a FTC alerta que sistemas de clonagem de voz são usados em golpes familiares, falsidade ideológica empresarial, extorsão e outras fraudes, além de riscos para artistas de voz cujas vozes podem ser apropriadas. Não use a voz reconhecível de uma pessoa real sem autorização e nunca apresente uma voz gerada ou convertida por IA como prova de que uma pessoa específica falou.
Consentimento e direitos de voz vêm logo em seguida. Obtenha permissão antes de clonar ou imitar deliberadamente a voz de outra pessoa, e mantenha um registro dessa permissão, especialmente para projetos comerciais, publicidade, treinamento, jogos ou mídia pública. O material da FTC citado aqui discute danos, fiscalização e soluções propostas, em vez de estabelecer uma regra única de consentimento para todo uso, então obrigações específicas podem depender da jurisdição, do contrato, da plataforma e do caso de uso. Em caso de dúvida, verifique para a sua situação.
A divulgação é sensata sempre que um público possa razoavelmente acreditar que uma pessoa real está falando ao vivo. Um breve aviso de que a voz é gerada ou convertida por IA reduz a confusão. A segurança também importa: proteja amostras de voz e arquivos de voz personalizados como outros ativos sensíveis, limite o acesso, evite enviar gravações sem permissão e remova perfis de voz não utilizados quando o serviço permitir. Por fim, planeje-se para falhas de qualidade. Latência, áudio perdido e artefatos de conversão podem atrapalhar uma conversa, então teste toda a configuração com o microfone, os fones de ouvido, o aplicativo, a rede e o hardware reais antes de ir ao ar.
Onde nossas ferramentas se encaixam no seu projeto de voz
Apresentamos um fluxo de trabalho integrado de mídia com IA, em vez de um produto modificador de voz ao vivo por microfone. Em nossa plataforma você pode gerar fala a partir de texto, escolher entre mais de 300 vozes, criar vozes clonadas a partir de uma amostra curta e usar essas vozes em projetos de Texto para Fala e Dublagem com IA. Oferecemos suporte à dublagem de mais de 60 idiomas de origem para 33 idiomas-alvo, o que nos torna uma ótima opção quando o trabalho é criar uma narração a partir de um roteiro, produzir fala com uma voz personalizada, dublar áudio ou vídeo gravado ou localizar conteúdo para públicos multilíngues.
Para desenvolvedores, publicamos páginas de API separadas para Texto para Fala, Clonagem de Voz e Dublagem com IA. Estes são fluxos de trabalho de geração e localização. Se o seu projeto precisar especificamente de um modificador de voz ao vivo por microfone, confirme que a entrada de streaming em tempo real, o roteamento de saída, as metas de latência e o suporte a sessões ao vivo estão explicitamente documentados antes de se comprometer com qualquer API, a nossa ou a de qualquer outra pessoa.
Se você está avaliando a conversão ao vivo em comparação com um pipeline gravado e não tem certeza de qual caminho se encaixa no seu conteúdo, conte-nos o formato de origem, os idiomas-alvo e se você precisa de saída ao vivo ou pré-gravada, e indicaremos o fluxo de trabalho certo.
Perguntas frequentes
Um modificador de voz com IA em tempo real é o mesmo que texto para fala?
Não. Um modificador de voz em tempo real transforma a fala ao vivo do microfone enquanto você fala, enquanto o texto para fala gera uma nova fala a partir do texto escrito que você envia primeiro. Nosso Texto para Fala foi criado para gerar fala a partir de texto, não para conversão ao vivo por microfone.
Um modificador de voz com IA em tempo real tem atraso zero?
Não. Todo sistema precisa de tempo para capturar e processar o áudio, então alguma latência é inevitável. O atraso prático depende do modelo, do dispositivo, das configurações de buffer, da rede e do aplicativo de destino, e os sistemas de pesquisa relatam números diferentes sob diferentes condições de teste.
Um modificador de voz com IA pode copiar a voz de uma celebridade?
Alguns sistemas podem tecnicamente imitar vozes reconhecíveis, mas capacidade técnica não é permissão. Evite a falsidade ideológica não autorizada e verifique os contratos relevantes, as regras da plataforma e as leis antes de usar a voz de qualquer pessoa reconhecível.
O que devo usar para criar vídeos multilíngues no YouTube?
Para vídeos pré-gravados, a dublagem com IA geralmente se encaixa melhor do que um modificador de voz ao vivo, porque processa o vídeo existente e produz áudio localizado e alinhado. Nossa Dublagem com IA traduz e dubla áudio ou vídeo gravado para os idiomas suportados.
Sua plataforma pode mudar minha voz ao vivo durante uma chamada?
Nossa plataforma documenta Texto para Fala, Clonagem de Voz e Dublagem com IA, em vez de conversão de voz ao vivo por microfone. Se você está planejando um fluxo de trabalho de chamada ao vivo, confirme a documentação atual do produto conosco primeiro para que possamos recomendar a abordagem certa.