Se você está avaliando o voiceforge text to speech para um projeto, a verdadeira questão raramente é se as vozes soam interessantes. É se a ferramenta se encaixa no tamanho do seu roteiro, nos seus direitos de publicação e no tipo de conteúdo que você realmente cria. O VoiceForge é um serviço de conversão de texto em fala baseado em navegador, construído em torno de vozes de personagens distintas. Ele converte um roteiro em áudio para download usando um motor de síntese por seleção de unidades que costura segmentos de fala gravados por locutores humanos, em vez de gerar cada som a partir de uma única forma de onda matemática. A decisão prática se resume a quatro necessidades: uma voz divertida e reconhecível para projetos pessoais; áudio licenciado para mídia monetizada; controle preciso sobre pronúncia e ritmo; ou um fluxo de trabalho multilíngue escalável. Apenas as três primeiras se encaixam perfeitamente em um gerador de vozes de personagens, e é nessa lacuna que a maioria dos criadores tropeça.
Publicamos este guia porque a mesma confusão aparece repetidamente: as pessoas geram áudio em uma versão de avaliação gratuita, presumem que podem monetizá-lo e, então, descobrem que a licença está vinculada a um plano específico. Abaixo, explicamos como o motor funciona, o que ele pode e não pode fazer, e quando uma ferramenta de novidade de voz única é a escolha certa em comparação com um fluxo de trabalho completo de localização.
Índice
O que o VoiceForge text to speech realmente é
O VoiceForge transforma palavras escritas em áudio falado: você insere um roteiro, escolhe uma voz, gera o clipe, faz a pré-visualização e baixa o resultado quando seu plano permite. O que o diferencia de uma biblioteca de narração geral é sua orientação. O VoiceForge se inclina para vozes com personalidade em vez de uma entrega corporativa neutra, o que o torna um ajuste natural para esquetes do YouTube, clipes de jogos, personagens animados, memes, anúncios de novidade e projetos musicais.
Esse foco em personagens é uma vantagem para alguns conteúdos e uma desvantagem para outros. Uma voz cômica ou deliberadamente sintética pode sustentar uma paródia ou um NPC de jogo, mas a mesma voz se torna uma distração em um curso de e-learning, uma demonstração de produto ou um anúncio de marca premium. Então, o primeiro filtro não é "isso soa humano?". É "essa voz pertence ao meu público específico?".
Se você ainda está decidindo se um gerador de vozes padrão atende às suas necessidades, nosso artigo explicativo sobre o que um gerador de voz com IA faz aborda a categoria mais ampla e como essas ferramentas diferem da clonagem e da dublagem.
Como o motor de seleção de unidades constrói uma voz
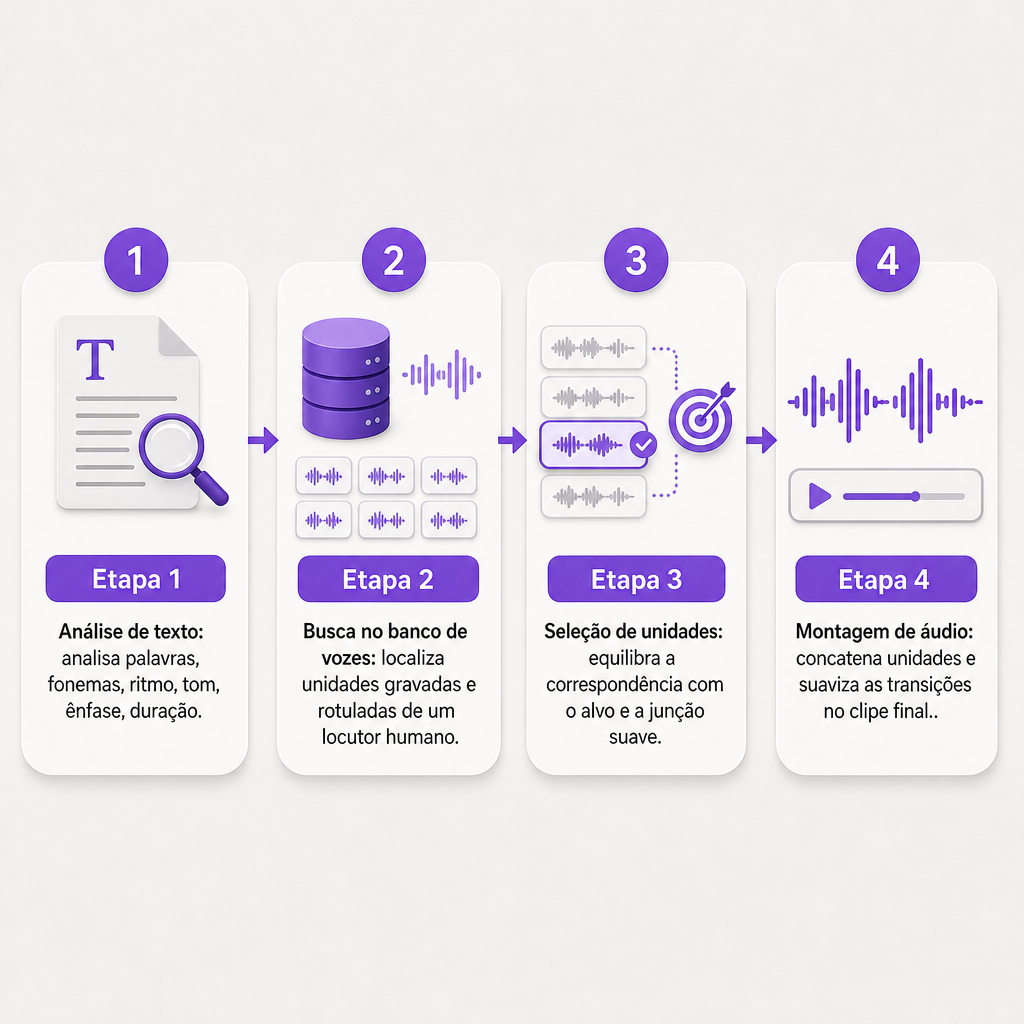
O VoiceForge usa síntese por seleção de unidades, também chamada de síntese concatenativa. Em vez de gerar uma gravação inteira a partir de uma única forma de onda produzida por um modelo, o sistema pesquisa um banco de dados de segmentos de fala gravados e une as peças que melhor se encaixam na sua frase. Compreender esse pipeline explica tanto por que as vozes soam reconhecíveis quanto por que se comportam da maneira que se comportam sob pressão.
O processo ocorre em algumas etapas. Primeiro, a análise de texto: o motor analisa palavras, estrutura de frases, fonemas, ritmo, entonação, ênfase e duração para decidir como uma linha deve ser falada. Em seguida, uma busca no banco de dados de vozes: cada voz é construída a partir das gravações de um locutor humano, divididas em unidades menores e rotuladas por som e contexto. Depois, a seleção de unidades, em que o motor equilibra dois objetivos concorrentes ao mesmo tempo — a correspondência com o alvo, que escolhe uma unidade com o som, a entonação, a duração e o contexto corretos, e a junção suave, que favorece unidades vizinhas que se conectam sem uma emenda óbvia. Por fim, a montagem de áudio costura a sequência escolhida e aplica uma suavização leve nas fronteiras.
Como a saída é montada a partir de gravações reais, cada voz mantém uma identidade distinta. A desvantagem é que esse método não foi projetado para oferecer direção emocional ilimitada ou a entrega totalmente ajustável associada a sistemas generativos mais recentes. Fraseados incomuns, mudanças rápidas ou combinações estranhas de pronúncia podem expor as junções entre as unidades, produzindo resultados que soam menos consistentes do que uma gravação humana contínua. Se você quiser ver como um pipeline totalmente generativo difere, nossa análise de como funciona o text to speech neural detalha a abordagem de aprendizado profundo que substitui a concatenação.
Vozes, SSML e o limite de 500 caracteres
O VoiceForge lista 42 vozes únicas, cada uma gravada por um locutor diferente com seu próprio timbre e estilo de fala. Isso é suficiente quando a própria voz faz parte do conceito criativo — um narrador cômico para um curta, uma personalidade peculiar para um vídeo de jogos, um tom sintético para um meme. É um catálogo menor, porém, para equipes que precisam de muitas variantes regionais ou de um narrador cuidadosamente combinado em vários mercados.
Para controle de entrega, o VoiceForge oferece suporte a um subconjunto da Speech Synthesis Markup Language (SSML). Em vez de depender apenas da pontuação, você incorpora instruções diretamente no roteiro.
| Controle SSML | O que faz |
|---|---|
<break> |
Insere uma pausa |
<emphasis> |
Enfatiza uma palavra ou frase |
<prosody> |
Ajusta entonação, velocidade de fala ou volume |
<phoneme> |
Força uma pronúncia exata |
<sub> |
Fala um substituto para o texto visível |
<p> / <s> |
Marca um parágrafo ou frase |
Essas tags valem a pena quando o motor lê incorretamente o nome de um produto, uma sigla ou um termo técnico. Envolver uma abreviação em <sub alias="application programming interface">API</sub> faz com que ela fale a frase completa, e <phoneme> fixa um nome complicado. Um <break time="500ms"/> entre as linhas adiciona uma pausa deliberada onde a pontuação não faria.
Aqui está o detalhe que remodela a forma como você escreve para ele: a entrada de texto é limitada a 500 caracteres, e a marcação SSML conta para esse limite. Cada tag que você adiciona consome o espaço disponível para as palavras reais. Narrações longas precisam ser divididas em várias gerações, e marcações pesadas reduzem ainda mais cada trecho. Na prática, isso significa planejar seu roteiro em passagens curtas e autossuficientes, em vez de colar uma página inteira.
Avaliação gratuita vs. licença comercial: a decisão que importa
O VoiceForge oferece uma avaliação gratuita limitada, mas uma avaliação não é uma licença de publicação. Seus planos traçam uma linha clara entre uso pessoal e comercial, e é nessa linha que a maioria dos erros acontece.
O nível Fan Voice destina-se a piadas, vídeos, jogos, animações e memes que não são monetizados. O plano Publisher é a assinatura que concede uma licença comercial para áudio de TTS em conteúdo monetizado ou comercial — vídeos monetizados, jogos indie e música — e anuncia downloads ilimitados. A avaliação gratuita existe para que você possa testar o serviço antes de se comprometer.
A regra de operação é simples: se um projeto gera dinheiro, promove um negócio, aparece em mídia monetizada ou é comercializado, confirme o plano aplicável antes de publicar. O áudio que você gera durante uma avaliação gratuita não carrega automaticamente direitos comerciais só porque foi baixado. A linguagem de licenciamento também pode mudar, então a página de planos é um ponto de partida, não um substituto para uma análise específica do projeto quando as apostas são altas — uma entrega para cliente, um anúncio pago, uma campanha de marca ou o lançamento de um aplicativo.
Pontos fortes e limitações para projetos reais
Os pontos fortes do VoiceForge se concentram em personalidade e simplicidade. As vozes de personagens se destacam quando o timbre faz parte da piada ou da marca de um canal. Como a base é a fala humana gravada, as vozes mantêm características vocais naturais e uma identidade reconhecível. Os controles de pronúncia SSML dão a você uma real influência sobre siglas, nomes e termos estranhos. E o plano Publisher torna a questão do uso comercial mais explícita do que ferramentas que separam o acesso à geração dos detalhes de licenciamento.
As limitações são igualmente concretas. O limite de 500 caracteres força roteiros longos a se dividirem em muitas pequenas gerações, e a marcação torna cada uma mais curta. O catálogo de 42 vozes é modesto ao lado de grandes bibliotecas, o que importa se você precisa de centenas de opções ou de muitos sotaques regionais. O estilo focado em personagens que brilha no entretenimento pode prejudicar conteúdos jurídicos, médicos, instrucionais ou de marcas premium. As restrições de plano são fáceis de tropeçar, já que a capacidade de gerar áudio não é o mesmo que o direito de monetizá-lo. E como o motor une unidades gravadas, certos fraseados podem revelar artefatos de costura que uma gravação contínua não teria.
Nenhum desses fatores é desqualificante por si só. Eles simplesmente definem o ponto ideal: clipes curtos, orientados à personalidade, em um único idioma, onde a voz é o ponto central.
Quando uma voz de personagem se encaixa e quando um fluxo de trabalho de localização vence
O VoiceForge é a escolha certa quando a personalidade da voz é central, seus roteiros se dividem perfeitamente em seções curtas, você precisa de controle básico de pronúncia e ritmo, e está produzindo vídeos, memes, animações, música ou conteúdo de jogos indie — seja pessoal (Fan Voice) ou monetizado com a assinatura apropriada.
Um fluxo de trabalho mais amplo atende melhor a você quando precisa de um narrador neutro e polido, muitos idiomas e sotaques, sua própria voz clonada, narração em formato longo, atualizações comerciais frequentes, integração via API ou vozes consistentes em um grande catálogo, onde a confiabilidade importa mais do que a novidade. Um canal em expansão internacional ilustra bem essa divisão: o VoiceForge pode fornecer a voz de personagem para uma esquete em inglês, enquanto uma configuração de TTS e dublagem multilíngue produz as versões localizadas para outros públicos.
É nesse segundo cenário que nos concentramos. Nossa ferramenta de Text to Speech oferece mais de 300 vozes com IA, locuções multilíngues, controles de velocidade de fala e projetos para download criados para produção em vez de novidade pontual. Criadores que querem manter sua própria identidade em cada vídeo podem usar a Clonagem de Voz em vez de se contentar com um personagem padrão, e desenvolvedores que precisam de geração de fala dentro de um aplicativo podem construir sobre nossa API de Text to Speech. Quando o objetivo é transformar um único clipe em um lançamento totalmente localizado, a Dublagem com IA leva o mesmo roteiro para idiomas adicionais em um só lugar.
Uma lista de verificação de qualidade pré-publicação
Antes de publicar o áudio do VoiceForge, faça uma revisão rápida das coisas que mais costumam falhar. Gerar passagens de teste curtas primeiro vale os poucos minutos extras, porque uma voz que funciona em uma frase pode se tornar cansativa ou distrativa ao longo de um vídeo inteiro.
- Pronúncia: Nomes, abreviações, números e termos técnicos são falados corretamente?
- Ritmo: As pausas caem naturalmente, não no meio de uma frase?
- Consistência do personagem: A mesma voz combina com todas as cenas, não apenas com a abertura?
- Transições de áudio: Há saltos audíveis entre clipes gerados separadamente?
- Licenciamento: Seu plano atual realmente cobre uso monetizado ou comercial?
- Adequação ao público: O estilo do personagem é apropriado para a plataforma e o assunto?
- Alinhamento: O áudio se encaixa perfeitamente no seu vídeo, música ou diálogo de jogo?
- Direitos: Você tem permissão para qualquer roteiro, nome ou referência de terceiros fornecida no áudio?
Perguntas Frequentes
O que é o VoiceForge text to speech?
É um serviço baseado em navegador que converte texto escrito em áudio falado usando uma biblioteca de vozes de personagens distintas. Ele se baseia na síntese por seleção de unidades, que monta segmentos de fala gravados de bancos de dados de vozes humanas em vez de gerar áudio a partir de uma única forma de onda de modelo.
O VoiceForge é gerado por IA?
É um serviço de síntese de fala, mas seu método documentado é a seleção de unidades, não um sistema de voz neural totalmente generativo. O motor seleciona e une unidades de fala humana gravadas para produzir cada enunciado.
Quantas vozes do VoiceForge estão disponíveis?
O VoiceForge lista 42 vozes únicas, cada uma associada a um locutor e uma personalidade vocal diferentes.
Qual é o limite de caracteres do VoiceForge?
O serviço documenta um limite de 500 caracteres por entrada de texto, e qualquer marcação SSML que você adicionar conta para esse limite. Roteiros mais longos precisam ser divididos em várias gerações.
Posso usar o áudio do VoiceForge no YouTube?
Você pode, mas conteúdo monetizado exige a assinatura comercial apropriada. O plano Publisher é descrito como a licença para áudio de TTS usado em conteúdo monetizado ou comercial, então confirme seu plano antes de publicar um vídeo monetizado.
O VoiceForge é o mesmo que clonagem de voz?
Não. O VoiceForge usa sua biblioteca de vozes existente, enquanto a clonagem de voz cria uma voz sintética personalizada a partir de gravações autorizadas de um locutor específico. Explicamos esse fluxo de trabalho separado em nossa página de Clonagem de Voz.