A maneira mais rápida de integrar uma API de texto para fala é tratá-la como um serviço REST: autentique-se com uma chave de API, envie seu texto junto com as configurações de voz em formato JSON, deixe o serviço renderizar a fala em segundo plano e, em seguida, busque e armazene os arquivos de áudio resultantes para reprodução onde seus usuários precisarem. Nossa API de Texto para Fala segue exatamente esse padrão, oferecendo mais de 300 vozes naturais e clonagem de voz ilimitada, para que você possa incorporar fala realista em sites, aplicativos, pipelines de vídeo e plataformas de aprendizagem. Este guia explica o que você está realmente conectando, como nosso mecanismo funciona e as decisões que determinam se a integração se encaixa no seu produto.
Índice
O que uma API de texto para fala faz no DubSmart
Uma API de texto para fala transforma texto estruturado em áudio falado sob demanda, para que seu código possa solicitar narração ou diálogo assim que um roteiro estiver pronto, em vez de esperar por gravação manual. Nosso mecanismo de Texto para Fala alimenta tanto a ferramenta Texto para Fala baseada em navegador quanto a API, dando acesso a mais de 300 vozes de IA em diferentes idiomas, gêneros e estilos, com prosódia ajustada para narração, explicações e diálogos.
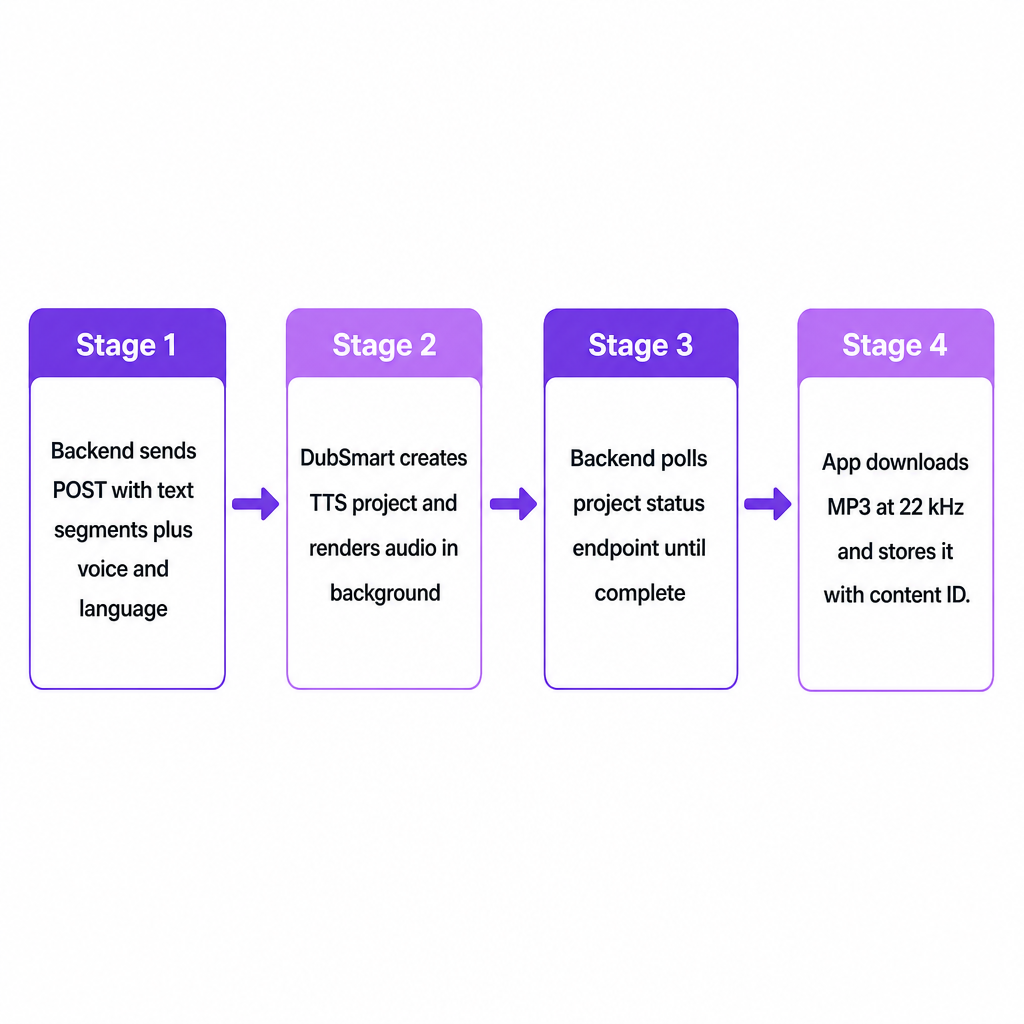
Na camada de API, expomos esse mecanismo como um serviço RESTful: seu backend envia uma requisição POST contendo segmentos de texto e parâmetros de voz, e o serviço retorna um objeto de projeto cujo status você pode consultar até que o áudio esteja pronto para download. A saída é entregue como arquivos de áudio de alta qualidade, normalmente MP3 a 22 kHz, adequados para uso direto em editores de vídeo, fluxos de trabalho de podcast ou players web sem conversão extra.
Para os criadores e equipes que atendemos—YouTubers, pequenas empresas, produtores de e-learning, cineastas e agências de desenvolvimento—a API faz a ponte entre o planejamento de conteúdo e a publicação. Assim que um roteiro chega a um CMS ou plataforma de aprendizagem, o backend pode gerar narrações automaticamente, o que elimina o gargalo da gravação manual repetida.
A decisão de integração: o que você está realmente conectando?
"Integrar uma API de texto para fala" parece genérico, mas, na prática, você está decidindo três coisas: onde no seu fluxo de trabalho a fala deve ser gerada, quais vozes e idiomas representarão sua marca e com que rigor você automatiza a geração e a recuperação do áudio.
Para um criador do YouTube expandindo para conteúdo multilíngue, a integração muitas vezes significa vincular nossa API a uma ferramenta de planejamento de vídeo ou banco de dados de roteiros, para que cada roteiro finalizado se torne uma narração no idioma e estilo corretos. Para pequenas empresas e equipes de marketing, a API normalmente fica por trás de um CMS ou plataforma de automação de marketing, transformando posts de blog, explicações de produtos e textos de redes sociais em ativos de áudio reutilizáveis. Provedores de e-learning e treinamento corporativo tendem a conectar a API a ferramentas de autoria para que módulos de aula possam solicitar narração por slide ou por tópico e regenerá-la instantaneamente quando o material for atualizado.
Desenvolvedores e agências que integram IA de voz de forma mais profunda geralmente escolhem entre dois padrões. Um modelo em lote coleta roteiros e os processa por meio de tarefas agendadas. Um modelo transacional dispara uma requisição imediata sempre que chega novo conteúdo ou uma ação do usuário. Nossa API baseada em projetos funciona perfeitamente para qualquer um dos dois, porque cada projeto de TTS encapsula texto, escolha de voz, idioma e o áudio resultante de uma forma que se mapeia às suas próprias unidades de conteúdo—vídeos, aulas ou episódios de podcast. Se você ainda está avaliando o próprio conceito, nosso guia complementar sobre o que é uma API de texto para fala e como ela funciona aborda os fundamentos antes de você se comprometer com um design.
Como nossa API de Texto para Fala funciona nos bastidores
Nossa API de Texto para Fala é construída em torno de projetos e segmentos, o que a torna mais flexível do que um único endpoint de "texto entra, áudio sai". Um projeto de TTS agrupa um ou mais segmentos de texto sob um título e uma configuração compartilhada, como idioma e voz padrão. Cada segmento carrega seu próprio texto, identificador de voz e tag de idioma, o que permite misturar estilos de narração ou idiomas dentro de uma única saída.
Um payload JSON típico para o endpoint de projeto de TTS inclui um título de projeto legível para seus painéis e logs, além de um array de segmentos. Cada segmento define text (o roteiro ou frase a ser falada), voice (um ID de voz integrada ou um ID de voz personalizada criado via API de Clonagem de Voz) e language (um código indicando o idioma do segmento).
Quando seu backend envia esse payload ao endpoint de TTS com uma chave de API válida no cabeçalho Authorization, criamos o projeto e começamos a renderizar o áudio em segundo plano. A API expõe um endpoint de status do projeto que informa se o processamento ainda está em andamento ou concluído, junto com referências aos arquivos de áudio gerados quando prontos. Esse design assíncrono mantém suas próprias requisições rápidas: registre o ID do projeto, devolva o controle ao usuário e deixe um worker em segundo plano verificar a conclusão e baixar o áudio quando disponível.
A fala gerada chega como arquivos para download em formatos padrão, notadamente MP3 a 22 kHz, que se encaixa facilmente em players web, aplicativos móveis e linhas do tempo de edição de vídeo. Como o mesmo mecanismo alimenta nossa ferramenta baseada em navegador, os desenvolvedores podem prototipar vozes e roteiros de forma interativa e depois migrar as combinações vencedoras para chamadas de API automatizadas. A referência completa dos endpoints está na página API de Texto para Fala.
Conectando clonagem de voz e dublagem por IA ao texto para fala
Nossa característica definidora é que Texto para Fala, Clonagem de Voz e Dublagem por IA compartilham um único mecanismo de voz e fluxo de trabalho subjacente. Isso significa que a API de TTS não é isolada—ela é o núcleo de um pipeline de localização mais amplo.
A API de Clonagem de Voz permite que você envie amostras de áudio de um locutor, crie uma voz de IA personalizada e referencie essa voz em projetos de TTS. Uma vez que uma voz personalizada existe, seu identificador se torna o campo voice nos seus segmentos de Texto para Fala, para que a narração toque na voz clonada em vez de uma voz genérica de estoque. Essa continuidade é importante para apresentadores, podcasters e porta-vozes de marca que desejam uma identidade sonora consistente entre idiomas e formatos. Se você planeja adicionar clonagem, nosso guia sobre integrar uma API de clonagem de voz em seu aplicativo aborda os detalhes.
A API de Dublagem por IA amplia ainda mais isso ao combinar transcrição, tradução e texto para fala em um único pipeline que dubla vídeos em mais de 33 idiomas de destino. Aqui o mecanismo de TTS converte roteiros traduzidos em fala usando a mesma biblioteca de mais de 300 vozes ou sua voz clonada, para que as versões dubladas preservem tom e ritmo. Para criadores e empresas multilíngues, a API de Texto para Fala se torna o bloco de construção tanto para narrações monolíngues quanto para conteúdo dublado totalmente localizado. Nossa visão geral sobre como funciona a localização por IA mostra como essas peças se encaixam de ponta a ponta.
Principais critérios de decisão ao integrar nossa API de TTS
Integrar "qualquer" API de TTS não é suficiente; as escolhas em torno da implementação determinam o quão bem ela se encaixa em sua produção, marca e stack técnico.
Necessidades de escala e automação. Se o volume de conteúdo for baixo e esporádico, a ferramenta baseada em navegador pode ser suficiente. Quando os roteiros são gerados regularmente ou vinculados a calendários de conteúdo, sistemas de gerenciamento de aprendizagem ou automação de marketing, a API se torna a camada certa porque pode ser acionada programaticamente e escalada com seu backend.
Estratégia de voz e idioma. Nossa plataforma suporta dublagem de mais de 60 idiomas de origem para 33 idiomas de destino, alimentada pelo mesmo mecanismo de voz que a API de TTS usa. Se sua marca precisa de uma voz de porta-voz distinta, combinar a API de Clonagem de Voz com o TTS mantém essa voz consistente entre idiomas e canais. Se você prioriza velocidade em vez de personalização, as vozes integradas mantêm a implementação mais simples.
Ponto de integração em seu stack. Para canais do YouTube, um ponto natural é o pipeline de vídeo: roteiros armazenados em uma ferramenta de planejamento, enviados à API de TTS quando finalizados e retornados como áudio pronto para os editores. Plataformas de e-learning podem integrar no nível da aula ou do slide, onde cada bloco de conteúdo se mapeia a um segmento e os projetos representam cursos inteiros. Equipes de marketing frequentemente integram no nível do CMS para que cada artigo ou página de produto possa solicitar uma versão em áudio por acessibilidade.
Governança, conformidade e risco. Como a clonagem de voz pode replicar vozes reconhecíveis, consentimento, licenciamento e políticas de uso são importantes. Vozes clonadas são identificadas por IDs e podem ser marcadas com metadados, o que facilita a aplicação de regras internas sobre onde vozes específicas podem ser usadas. Decida antecipadamente quais ambientes podem acionar vozes clonadas versus vozes genéricas e adicione registro em seus próprios sistemas.
Expectativas de latência e experiência do usuário. O processamento assíncrono oferece flexibilidade, mas adiciona uma consideração de tempo. Para fluxos de trabalho em que os usuários esperam reprodução imediata—como um editor de roteiros com prévia instantânea—crie projetos ou segmentos menores e exiba indicadores de progresso enquanto o áudio é renderizado. Para localização em lote de bibliotecas inteiras, a latência importa menos, e as tarefas podem rodar em cronogramas com o áudio concluído anexado aos registros de conteúdo posteriormente.
| Área de decisão | Modelo em lote | Modelo transacional |
|---|---|---|
| Gatilho | Tarefas agendadas | Por item de conteúdo ou ação do usuário |
| Tolerância à latência | Alta | Baixa |
| Melhor uso | Catálogos de cursos, bibliotecas de vídeo | Editores de roteiro, prévias ao vivo |
| Estratégia de voz | Voz aprovada por idioma | Voz aprovada por idioma |
Riscos e salvaguardas práticas
Integrar uma API de texto para fala traz alguns riscos previsíveis que um design cuidadoso pode mitigar.
Escolher vozes sem testar pode produzir uma fala que parece fora do personagem para uma marca ou apresentador. Experimente as vozes primeiro na interface interativa e mantenha um catálogo de vozes aprovadas dentro de seus próprios sistemas, organizado por idioma e tipo de conteúdo, antes de codificar os IDs de voz nas chamadas de API.
A automação excessiva de conteúdo sensível é outra armadilha. Gerar fala automaticamente para material de conformidade, médico ou jurídico pode não ser apropriado. Como nossa API opera em projetos e segmentos discretos, você pode manter regras de roteamento que enviam apenas categorias aprovadas para o TTS, mantendo o conteúdo sensível em fluxos de trabalho com gravação humana.
Erros operacionais—projetos com falha ou downloads ausentes—acontecem quando problemas de rede ou payloads inválidos interrompem o processamento. Os endpoints de status do projeto e as respostas estruturadas permitem confirmar que um projeto foi concluído e que suas saídas estão disponíveis antes de publicar. Combine cada ID de projeto de TTS com seu próprio ID de conteúdo e implemente novas tentativas ou fallbacks quando as verificações de status reportarem erros.
O uso indevido de vozes clonadas merece controles explícitos. Vozes personalizadas devem ser criadas por meio de endpoints dedicados e depois referenciadas por ID em projetos de TTS, o que lhe dá um limite técnico claro para monitorar. Restrinja quem pode criar ou atribuir IDs de voz clonada e registre onde eles são usados.
Um caminho prático para começar é integrar primeiro o TTS para narrações padrão, validar vozes e tratamento de erros em produção e, em seguida, adicionar Clonagem de Voz e Dublagem por IA quando a integração central estiver estável. Conte-nos seu volume de conteúdo, idiomas de destino e onde a API deve ficar em seu stack, e podemos indicar os endpoints certos e planejar seu fluxo de trabalho.
Perguntas frequentes
Como a API de Texto para Fala é diferente da ferramenta de navegador?
A ferramenta de navegador é uma interface visual onde você cola texto, escolhe uma voz e baixa o áudio manualmente. A API expõe o mesmo mecanismo por meio de endpoints REST para que seu backend possa gerar e recuperar áudio automaticamente em resposta a roteiros, cronogramas ou ações do usuário.
A API pode falar com minha própria voz, não apenas vozes de estoque?
Sim. Ao integrar a API de Clonagem de Voz, você envia amostras de áudio de um locutor, cria uma voz de IA personalizada e, em seguida, referencia o ID dessa voz nos seus segmentos de Texto para Fala, para que toda a fala gerada toque na voz clonada.
Como isso ajuda com canais do YouTube ou podcasts multilíngues?
Nossa plataforma transforma fala ou roteiros de mais de 60 idiomas de origem em saída dublada em 33 idiomas de destino, com o TTS gerando o áudio final usando mais de 300 vozes ou sua voz clonada. Conectar as APIs de TTS e Dublagem por IA ao seu pipeline de publicação permite que novos vídeos ou episódios recebam narrações ou dublagens completas assim que os roteiros ou o áudio de origem estiverem prontos.
Quais formatos de áudio meu aplicativo ou editor receberá?
A API de TTS entrega arquivos de áudio de alta qualidade, incluindo MP3 a 22 kHz, adequados para a maioria dos ambientes web, móveis e de edição de vídeo sem conversão extra.
Posso integrar o Texto para Fala agora e adicionar a Dublagem por IA depois?
Sim. Texto para Fala, Clonagem de Voz e Dublagem por IA compartilham um ecossistema de API comum, então você pode começar com o TTS para narrações e depois adicionar Clonagem de Voz e Dublagem por IA para automatizar a dublagem multilíngue sem reconstruir sua integração central.