Pergunte como as narrações com IA são feitas e você estará, na verdade, perguntando como um roteiro escrito se transforma em fala sem que ninguém precise entrar em um estúdio. A resposta curta: um modelo neural de conversão de texto em fala transforma seu roteiro em áudio sintético, uma voz clonada opcional faz esse áudio soar como uma pessoa específica, e uma camada de dublagem alinha tudo com seu vídeo entre diferentes idiomas. Na DubSmart AI, executamos toda essa cadeia dentro de um único espaço de trabalho, para que você possa partir de um parágrafo de texto até uma narração multilíngue finalizada sem trocar de ferramentas ou reservar tempo de estúdio.
Como esse processo será para você depende de uma decisão, e o restante deste guia percorre os mecanismos, as opções e como escolher.
Índice
A decisão por trás de como as narrações com IA são feitas
Antes de qualquer áudio ser gerado, você faz duas escolhas que moldam tudo o que vem depois. A primeira é se você quer uma voz pré-construída de uma biblioteca ou um clone da sua própria. A segunda é se você precisa de uma narração em um único idioma ou de uma versão totalmente localizada em vários.
Para um criador do YouTube ou uma pequena empresa, isso geralmente se resolve rápido: escolha uma voz de estoque para agilidade, clone uma voz quando a consistência da marca importar, e recorra à dublagem apenas quando for multilíngue. Para desenvolvedores e agências, essa mesma bifurcação se torna uma questão de arquitetura — você chama um endpoint de conversão de texto em fala para áudio pontual, ou conecta clonagem de voz e dublagem em um pipeline que roda por conta própria?
Construímos a DubSmart em torno exatamente dessas bifurcações. Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image, Image to Video e AI Dubbing vivem todos em uma única plataforma, para que você possa aumentar ou diminuir o nível de automação e personalização sem juntar fornecedores separados.
Os mecanismos: como as narrações com IA são realmente feitas
Text to speech: transformando roteiro em som
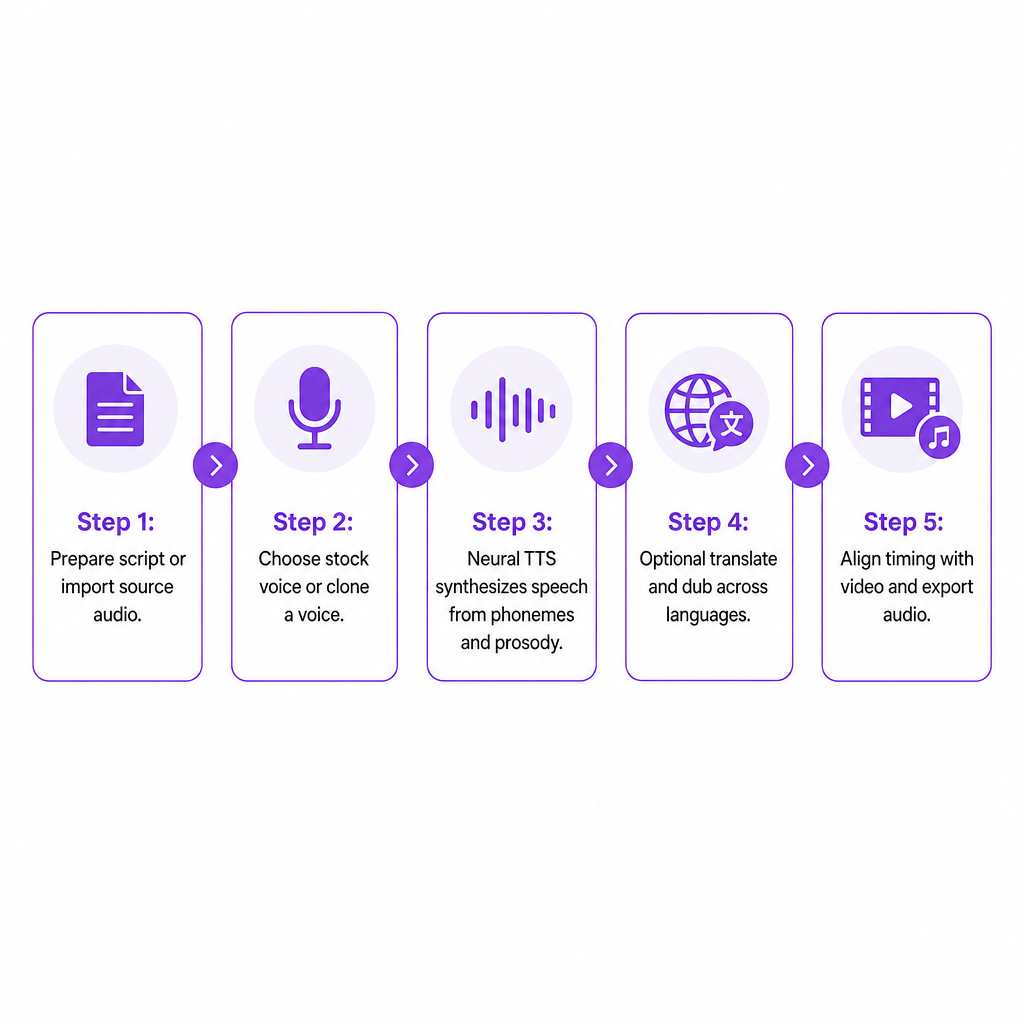
A conversão de texto em fala (TTS) está no centro de toda narração com IA. O motor primeiro analisa seu roteiro — dividindo o texto em fonemas, lendo pontuação e estrutura, e inferindo a prosódia, que é o ritmo, a ênfase e a entonação que evitam que a fala soe monótona. Modelos neurais então sintetizam esses fonemas em áudio e aplicam os padrões de prosódia que fazem a entrega soar fluente em vez de robótica.
Nosso motor de Text to Speech permite que você cole texto em qualquer idioma, escolha uma voz de uma biblioteca com mais de 300 e gere fala realista em segundos. As vozes soam naturais e humanas, e são categorizadas por idioma, gênero e estilo para que você possa combinar com o tom do que está produzindo. Para desenvolvedores, o mesmo motor é exposto por meio de uma Text to Speech API RESTful: envie uma requisição POST com seu texto e parâmetros de voz, e receba arquivos de áudio prontos para uso de volta. Texto estruturado entra, áudio realista sai, sem gravação manual.
Modelos de voz e bibliotecas de voz
As narrações com IA dependem de modelos de voz treinados — redes neurais que aprendem como uma voz específica deve soar em diferentes palavras, idiomas e emoções. Uma biblioteca de voz é simplesmente um catálogo desses modelos. Mantemos uma biblioteca de mais de 300 vozes que soam naturais, cobrindo múltiplos gêneros, sotaques e estilos de fala em vários idiomas, e ela está disponível tanto no aplicativo web quanto pela API, para que ferramentas internas possam gerar fala sob demanda.
Clonagem de voz: fazendo a IA soar como você
A clonagem é o mecanismo que faz uma narração soar como uma pessoa específica em vez de um narrador genérico. O sistema analisa uma gravação de amostra, aprende o timbre, a faixa de tom e os padrões de pronúncia do falante, e então aplica essas características a novas falas sintéticas.
Na prática, você faz upload de um arquivo de áudio de pelo menos 20 segundos no Voice Cloning — de preferência limpo e livre de ruído de fundo. Processamos essa amostra em um perfil de voz personalizado que você pode nomear e reutilizar, sendo que a clonagem geralmente leva apenas alguns segundos. Uma vez criada, a voz clonada fica disponível dentro do Text to Speech e do AI Dubbing, para que você possa gerar roteiros ou versões dubladas com sua própria voz. Programaticamente, a Voice Cloning API reflete isso: obtenha uma URL de upload, envie seu áudio em um formato suportado, crie uma voz personalizada a partir da chave do arquivo resultante e, então, use-a em projetos de TTS ou dublagem.
Dublagem e narrações multilíngues
Passar de uma narração em um único idioma para conteúdo multilíngue adiciona localização sobre o TTS básico. O padrão geral é consistente:
- Capture ou importe a fala original.
- Transcreva-a em texto.
- Traduza esse texto.
- Gere nova fala no idioma de destino.
- Alinhe o tempo com o vídeo ou áudio original.
Nosso fluxo de AI Dubbing segue exatamente esse padrão, combinando conversão de fala em texto, tradução automática e conversão de texto em fala, opcionalmente reutilizando uma voz clonada para que a faixa dublada combine com o falante original. Ele transforma conteúdo falado de mais de 60 idiomas de origem em versões dubladas em 33 idiomas de destino. A dublagem de fala para fala busca manter o tom e o tempo próximos da performance original, o que importa mais para conteúdo de e-learning, treinamento e cinema, onde a sincronia labial e o ritmo carregam a experiência.
APIs e fluxos de trabalho automatizados
Para equipes que produzem narrações em escala, as APIs são o que integra a criação de voz aos sistemas existentes. A TTS API lida com texto entrando, áudio saindo; a Voice Cloning API adiciona criação e gerenciamento programático de vozes personalizadas; e a AI Dubbing API estende ambas para tradução e dublagem automáticas em mais de 33 idiomas com acesso a vozes clonadas. Juntas, elas permitem que você construa pipelines em que roteiros, legendas ou transcrições extraídos de um sistema de conteúdo se transformam em narrações ou faixas dubladas automaticamente, sem manuseio manual de arquivos.
Suas três maneiras de criar narrações com IA na DubSmart
Dentro da nossa plataforma, a questão se resolve em três pontos de partida práticos.
Comece a partir de um roteiro com o Text to Speech. Cole seu texto, escolha uma voz de estoque ou clonada, defina o idioma e os controles básicos, e gere fala que você pode baixar em formatos padrão. Isso se encaixa em vídeos de treinamento, conteúdo explicativo, peças de marketing e vinhetas de podcast em que você é dono do roteiro desde o início.
Comece a partir de mídia existente com o AI Dubbing. Faça upload de um vídeo ou arquivo de áudio de origem, deixe o sistema transcrever e traduzir, e então gere faixas dubladas nos idiomas escolhidos — reutilizando vozes clonadas para manter o som consistente. Este é o caminho para canais que se expandem para públicos multilíngues e para empresas que reaproveitam webinars ou demonstrações de produto.
Comece a partir dos seus próprios sistemas com geração baseada em API. Seu aplicativo envia texto e parâmetros de voz para a TTS API, opcionalmente vincula conteúdo a uma voz específica por meio da Voice Cloning API, e recupera áudio pronto para anexar a vídeos ou narrações de e-learning para módulos de treinamento. Isso atende desenvolvedores, agências e provedores de LMS que precisam de saída consistente e programática.
Critérios de decisão: escolhendo sua configuração de narração com IA
Naturalidade e qualidade do áudio
A naturalidade é inegociável. Motores robustos modelam a prosódia e a articulação para que a fala flua com pausas e ênfases apropriadas. Como a geração é rápida, você pode iterar em um roteiro e regenerar o áudio até que a entrega pareça certa, em vez de se contentar com a primeira tentativa.
Cobertura de idiomas e profundidade de localização
Se canais multilíngues ou treinamento internacional estão no seu roteiro, a cobertura decide até onde você pode chegar. Transformar conteúdo de mais de 60 idiomas de origem em 33 idiomas de destino a partir de um único fluxo de trabalho define os mercados que você pode atender, e a dublagem de fala para fala ajuda a manter o tom e o tempo consistentes em todas as versões.
Identidade de marca por voz e capacidade de clonagem
Uma voz reconhecível importa para empresas, criadores e podcasts. A clonagem permite que você leve a mesma voz por diferentes idiomas e canais. Poder clonar a partir de cerca de 20 segundos de áudio limpo e reutilizar esse perfil dentro do Text to Speech e do AI Dubbing torna prático estabelecer e manter um som característico.
Simplicidade do fluxo de trabalho versus integração técnica
Criadores frequentemente querem upload, edição e download resolvidos em um só lugar. Equipes técnicas frequentemente precisam de APIs. Oferecemos ambos: ferramentas voltadas ao usuário em um aplicativo unificado e APIs para desenvolvedores que expõem os mesmos motores. A escolha se resume a saber se sua equipe trabalha principalmente em um navegador ou constrói sobre sistemas internos.
Velocidade, escalabilidade e consistência
Uma ferramenta de narração deve encurtar a produção e escalar sem que a qualidade caia. A geração de TTS quase instantânea e a clonagem que se completa em segundos permitem iteração rápida e saída em massa, enquanto as APIs permitem que milhares de roteiros ou segmentos sejam processados automaticamente com vozes e configurações consistentes.
Estrutura de orçamento e controle
Em vez de taxas de estúdio por sessão, as ferramentas de narração com IA geralmente usam preços baseados em uso. Nosso modelo baseado em créditos dá acesso a AI Dubbing, Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image e Image to Video em uma única conta, com um nível gratuito e planos empresariais. Os créditos oferecem limites de uso previsíveis, enquanto acúmulo e escalonamento permanecem disponíveis quando o volume aumenta. Se você quiser dimensionar créditos em relação ao tempo de execução, nossa análise do custo de dublagem com IA por minuto explica a conta.
Conformidade, consentimento e tratamento de dados
Clonagem e fala sintética carregam peso ético e legal. Exigimos que você faça upload de áudio sobre o qual tenha os direitos e recomendamos gravações limpas para melhores resultados, o que mantém consentimento e controle no centro. Nossa documentação de API usa URLs de upload pré-assinadas e seguras e formatos de áudio padrão, dando aos desenvolvedores um padrão claro para uso em conformidade dentro de aplicativos.
Riscos que vale a pena antecipar
Mesmo com ferramentas capazes, alguns modos de falha valem a pena antecipar.
Áudio não natural ou robótico geralmente remonta a roteiros mal pontuados ou a uma voz incompatível com o conteúdo. Escolher de uma biblioteca de vozes naturais e regenerar até que a entrega se encaixe é a solução prática, e a geração rápida torna essa experimentação barata.
A pronúncia incorreta tende a surgir com nomes, termos técnicos e conteúdo localizado. Um pipeline que executa transcrição, tradução e revisão — em vez de uma conversão cega de áudio para áudio — captura mais desses erros antes que sejam lançados.
Descompassos de tempo entre a fala sintetizada e os elementos visuais na tela prejudicam a experiência do espectador. A dublagem de fala para fala que se mantém próxima do tom e do tempo originais, aliada à edição dentro do ambiente do projeto, dá a você melhor controle sobre o alinhamento.
Eticamente, clonar uma voz sem os devidos direitos convida sérios problemas. Exigir uma amostra limpa sob seu controle e enquadrar a clonagem como uma ferramenta para criadores e empresas em vez de personificação anônima é o que mantém a prática responsável. Quando você está localizando material existente, nosso guia sobre como mudar o idioma da voz em um vídeo mostra o caminho amigável à revisão.
Como diferentes criadores colocam isso em prática
Um criador do YouTube que se expande para o exterior pode transformar um vídeo em inglês em versões em espanhol, português e alemão com o AI Dubbing e uma voz clonada, para que o apresentador permaneça reconhecível em todos os mercados — tudo dentro do pipeline de mais de 60 idiomas de origem e 33 de destino.
Uma pequena empresa ou equipe de marketing pode redigir um roteiro de explicação de produto ou de anúncio em um documento, convertê-lo em áudio com o Text to Speech e escolher uma voz que combine com o tom da marca — enérgica, formal ou conversacional. Esses mesmos roteiros podem ser localizados depois por meio do AI Dubbing usando uma voz de marca clonada.
Um produtor de e-learning ou de treinamento corporativo pode automatizar a narração de apresentações de slides e pacotes SCORM enviando o texto da lição pela TTS API e anexando o áudio retornado a cada módulo, com a clonagem mantendo a voz do instrutor consistente mesmo entre versões regionais.
Um cineasta independente ou criador de podcast pode produzir trailers, promoções ou diálogos traduzidos sem reservar um estúdio em cada idioma, combinando Speech to Text, AI Dubbing e vozes clonadas para manter a identidade dos personagens estável.
Desenvolvedores e agências podem incorporar as APIs de TTS, Voice Cloning e AI Dubbing em ferramentas internas ou plataformas de clientes, automatizando tudo, desde narrações de conteúdo curto para redes sociais até agentes de voz interativos.
Perguntas frequentes
Como as narrações com IA são diferentes das narrações gravadas tradicionais?
As narrações tradicionais precisam de um dublador humano, tempo de estúdio e várias sessões. As narrações com IA são geradas por motores de conversão de texto em fala e clonagem de voz que transformam roteiros diretamente em áudio usando modelos neurais treinados em vez de uma performance ao vivo.
Uma narração com IA pode soar como uma pessoa específica?
Sim. A clonagem de voz analisa uma pequena amostra da voz de alguém e cria um modelo personalizado que pode falar qualquer roteiro naquela voz, disponível em nossa ferramenta e API Voice Cloning.
Quanto áudio é necessário para clonar uma voz?
Pedimos pelo menos 20 segundos de áudio limpo, livre de ruído de fundo, para criar um perfil de voz clonada confiável, sendo que a clonagem geralmente termina em segundos.
Posso fazer narrações em vários idiomas a partir de um único vídeo de origem?
Sim. Combinamos conversão de fala em texto, tradução e conversão de texto em fala para transformar conteúdo de mais de 60 idiomas de origem em saída dublada em 33 idiomas de destino, para que um vídeo original possa produzir muitas narrações localizadas.
Existe uma forma de automatizar a criação de narrações em vez de usar a interface?
Nossa TTS API e Voice Cloning API permitem que aplicativos e ferramentas internas enviem texto e amostras de áudio, criem vozes personalizadas e recebam fala sintética programaticamente, para que as narrações possam ser geradas automaticamente em escala.