A separação de fala por IA é um processo de aprendizado profundo que extrai uma voz humana de uma mistura ruidosa e devolve uma faixa de fala limpa, pronta para transcrição, dublagem ou clonagem de voz. Essa única capacidade responde à pergunta que a maioria dos criadores realmente tem: consigo salvar esta gravação sem regravá-la? Entender como funciona a separação de fala por IA ajuda você a decidir quando recorrer a ela, quando gravar com mais qualidade desde o início e como uma faixa de voz limpa melhora discretamente tudo que vem depois. Este guia percorre o mecanismo, a diferença entre aprimorar um único locutor e separar vários, onde o processo se encaixa em um fluxo de localização e o que ele ainda não consegue corrigir.
Índice
A decisão por trás da separação de fala
Qualquer gravação real captura muito mais do que o locutor. Vlogs, webinars, vídeos de treinamento e podcasts captam ruído de rua, ambiência do ambiente, trilhas musicais, cliques de teclado e conversas sobrepostas que podem soterrar as palavras que importam. Um separador de fala existe para desembaraçar essa mistura: ele pega um arquivo misturado e devolve uma faixa contendo majoritariamente fala humana, além de uma faixa opcional com o áudio de fundo restante.
Essa faixa de voz limpa se torna a base para o que vem a seguir: conversão de fala em texto precisa, dublagem multilíngue, clonagem de voz de alta fidelidade ou simplesmente um original com melhor sonoridade. Portanto, a verdadeira decisão não é técnica, é prática. Você confia no seu áudio atual o suficiente para construir conteúdo multilíngue sobre ele, ou prefere que a IA limpe e separe a fala primeiro? E você quer um utilitário de limpeza autônomo ou um separador incorporado a uma plataforma mais ampla de criação e localização para não ficar malabarizando vários aplicativos?
Projetamos nosso Separador de Fala para atuar como a primeira barreira de IA em um fluxo de trabalho unificado. Ele fica antes da conversão de fala em texto, texto em fala, clonagem de voz e dublagem, de modo que todo sistema posterior recebe o sinal de voz mais nítido possível em vez de herdar qualquer ruído que estivesse no ambiente.
O mecanismo: da forma de onda à voz limpa
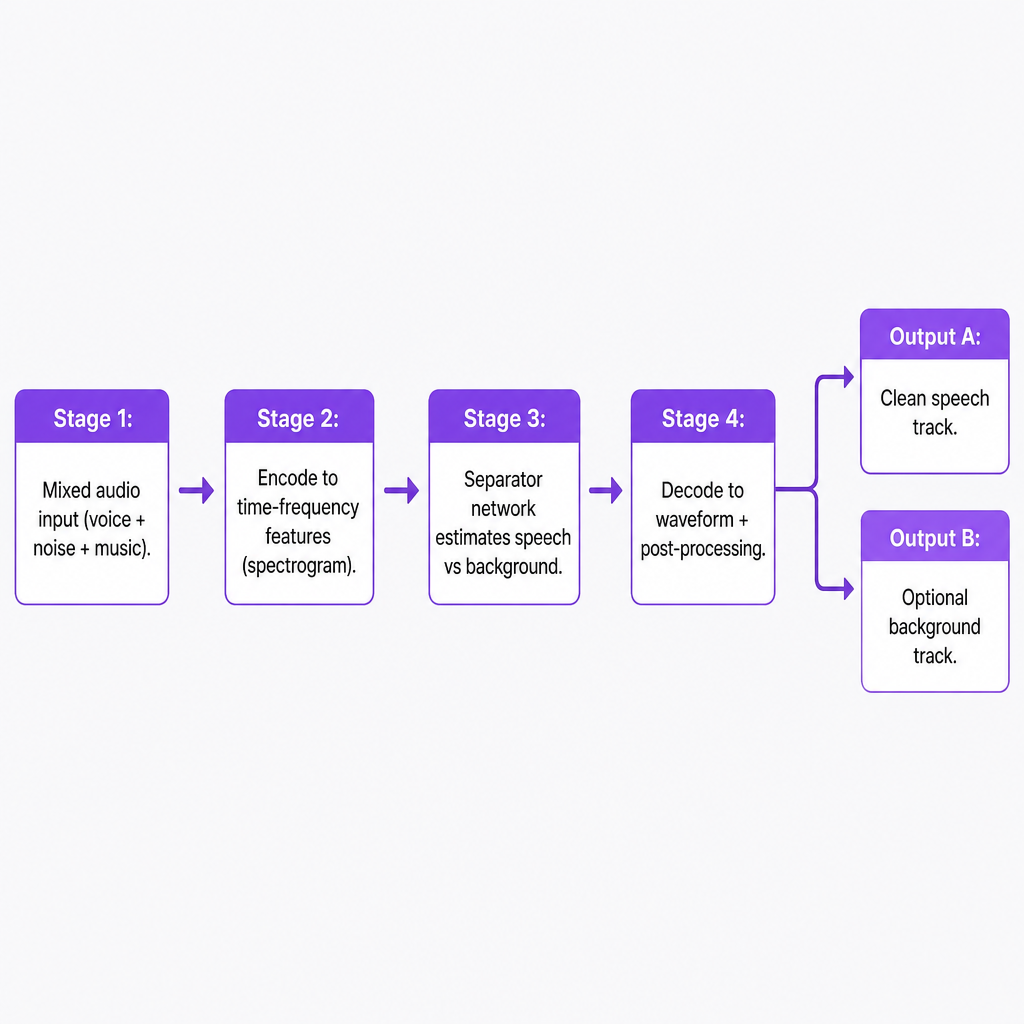
A separação de fala por IA moderna segue um pipeline de quatro estágios: codificar o sinal, separar as fontes em um espaço de características aprendido, estimar a fala limpa e decodificá-la de volta em áudio.
Da forma de onda às características
A maioria dos sistemas primeiro converte a forma de onda bruta do seu microfone em uma representação tempo-frequência como um espectrograma, que mostra como a energia em diferentes faixas de frequência muda ao longo do tempo. Essa visão facilita para uma rede neural enxergar os padrões que correspondem à fala humana em contraste com ruído ou música. Uma rede codificadora então mapeia a entrada em um espaço de características de alta dimensão onde diferentes fontes sonoras se tornam mais distinguíveis, enfatizando traços da fala como formantes, harmônicos e estrutura temporal enquanto suprime conteúdo de fundo irrelevante.
Redes separadoras e máscaras
O núcleo do processo é a rede separadora, um modelo profundo treinado para julgar o que pertence à voz e o que não pertence em cada ponto tempo-frequência. Duas estratégias dominam. A separação baseada em máscara prevê uma máscara para o espectrograma que mantém a energia da fala e atenua todo o resto; quando aplicada ao espectrograma original, o ruído de fundo e a música caem drasticamente enquanto a fala permanece. A estimativa direta de fonte, em vez disso, prevê o próprio espectrograma da fala limpa e, às vezes, um fundo residual, que é então decodificado de volta em áudio.
Existem abordagens mais especializadas para casos mais difíceis. O agrupamento profundo aprende uma incorporação para cada bin tempo-frequência de modo que bins da mesma fonte se agrupem, após o que o agrupamento padrão separa a fala das outras fontes. Outros modelos usam treinamento invariante à permutação para que possam separar vários locutores sem presumir qual locutor é a saída um versus a saída dois.
Treinamento com exemplos supervisionados
Esses modelos aprendem a partir de misturas de exemplo pareadas com a fala limpa de referência (ground-truth), ajustando-se para minimizar a diferença entre sua saída e a referência. Os alvos de treinamento podem ser máscaras, espectrogramas limpos ou formas de onda reconstruídas, e as funções de perda costumam estar ligadas a medidas de qualidade perceptiva como a relação sinal-distorção. Alimentada com muitas amostras diversas de sotaques, microfones e ambientes, a rede internaliza pistas robustas que separam a fala humana do conteúdo de fundo e generaliza para gravações que nunca viu.
Decodificação de volta em áudio
Por fim, o sistema mapeia a representação da fala separada de volta em uma forma de onda no domínio do tempo por meio de uma transformada inversa, seguida de pós-processamento como remoção de ruído e normalização de volume. O resultado é uma faixa dominada pela fala que pode ficar sozinha ou ser recombinada com uma quantidade controlada de fundo para naturalidade. Nosso Separador de Fala segue exatamente esse padrão: ele ingere seu áudio ou vídeo enviado, executa o pipeline de separação e devolve uma faixa focada na fala mais o fundo opcional, para que você decida quão seca ou ambiental a mixagem final deve ser.
Aprimoramento de locutor único vs separação de múltiplos locutores
Há uma linha importante entre aprimorar um locutor dominante e realmente separar várias vozes sobrepostas, e ela define o que você pode realisticamente esperar.
O aprimoramento de locutor único isola uma voz principal do ruído de fundo, reverberação e sons não vocais para que a inteligibilidade dispare. Isso funciona especialmente bem para vlogs, webinars, palestras e conteúdo de talking-head, onde o problema é o ruído ambiente ou uma trilha musical em vez de conversa cruzada. Nosso Separador de Fala é otimizado para esse caso: ele trata a fala humana como a fonte primária e todo o resto como fundo, entregando uma faixa de voz limpa e uma faixa de fundo opcional.
A separação de múltiplos locutores é uma tarefa diferente: dividir uma mistura de várias pessoas falando ao mesmo tempo em fluxos individuais, um por voz. Modelos de pesquisa já separaram até cinco vozes de um único microfone treinando diferentes redes para diferentes contagens de locutores e escolhendo o melhor ajuste para cada amostra. Técnicas como o agrupamento profundo e o beamforming neural com múltiplos microfones levam o desempenho ainda mais longe em cenários de campo distante e multicanal, mas são mais complexas e computacionalmente pesadas. Na prática, esses sistemas ainda visam cenários especializados como transcrição de reuniões, call centers e dispositivos inteligentes, em vez de fluxos cotidianos de criadores. Para a maioria dos nossos usuários, que administram canais do YouTube, equipes de marketing ou bibliotecas de cursos, o maior ganho prático vem de um forte aprimoramento de locutor único e da separação fala-versus-fundo, não da divisão completa de múltiplas vozes.
Onde a separação se encaixa em um fluxo de localização
A separação é a ponte entre gravações ruidosas do mundo real e o trabalho de voz por IA de alta qualidade. Um caminho típico flui de forma limpa por várias ferramentas.
Um criador envia um arquivo de áudio ou vídeo, e o separador isola a faixa de fala e, opcionalmente, o fundo. Essa fala limpa alimenta a conversão de fala em texto, de modo que a transcrição e a tradução operam sobre um sinal claro, o que melhora a precisão e reduz palavras alucinadas causadas por música ou ruído intensos. O texto e as traduções resultantes seguem então para a conversão de texto em fala e a dublagem por IA, que geram novas versões em outros idiomas usando vozes clonadas ou sintéticas; como a fala de origem estava limpa, o alinhamento temporal é mais preciso e artefatos de mixagem como o pumping são reduzidos.
A clonagem de voz depende do mesmo input limpo. Os modelos precisam de exemplos relativamente livres de ruído para aprender de forma confiável o timbre, a prosódia e a articulação de um locutor, e a separação reduz a contaminação de fundo que pode distorcer uma voz clonada. Nosso guia em espanhol sobre separação captura bem a experiência cotidiana: envie um arquivo, deixe a IA separar a voz do fundo, depois baixe a faixa de voz limpa ou o fundo isolado para edição, dublagem ou narração adicionais, tudo dentro de um único fluxo de trabalho. Essa consolidação é o ponto para equipes pequenas, que de outra forma ficam saltando entre plugins de redução de ruído, ferramentas de transcrição, serviços de dublagem e plataformas de clonagem separados.
Escolhendo e usando a separação de fala por IA
Quando você decide como adotar a separação, um punhado de critérios práticos faz a maior parte do trabalho.
Condições do áudio e tipo de conteúdo. Com um único locutor principal e ruído de fundo ou música moderados, a separação é altamente eficaz e de baixo risco. Com sobreposição intensa, microfones de campo distante ou entrada de qualidade muito baixa, espere retornos decrescentes e combine a IA com uma gravação melhor em vez de contar com ela para resgatar tudo.
Integração com ferramentas posteriores. Um separador que flui diretamente para a transcrição, a conversão de texto em fala e a dublagem reduz o atrito e os artefatos cumulativos em comparação com exportar e reimportar entre aplicativos. Conectamos o Separador de Fala ao restante das nossas ferramentas de localização exatamente por esse motivo, o que importa mais quando seu objetivo é a publicação multilíngue em vez de uma redução de ruído pontual.
Controle sobre o áudio de fundo. Para storytelling de marca, você muitas vezes quer manter alguma ambiência ou música para impacto emocional. Sistemas que produzem tanto uma faixa de fala limpa quanto um fundo isolado dão mais espaço aos editores do que ferramentas que só produzem uma única mixagem sem ruído. Nosso separador oferece suporte a esse paradigma de fala-mais-fundo-opcional, para que você possa remixar deliberadamente.
Velocidade, simplicidade e escala. Para criadores e equipes pequenas, a usabilidade rivaliza com o desempenho bruto. Separação com um clique por meio de um navegador ou API, com tratamento automático de formatos comuns, supera cadeias complexas de plugins que pressupõem experiência em engenharia de áudio. Uma vez que você esteja gerenciando centenas de vídeos ou módulos de curso, o processamento em lote e a automação deixam de ser luxos.
Confiabilidade e artefatos. Um modelo forte melhora a inteligibilidade sem adicionar distorção óbvia, chiado metálico ou artefatos de respiração. Demonstrações podem favorecer um sistema, então teste com suas próprias gravações representativas antes de tornar qualquer separador uma parte fixa do seu pipeline.
Privacidade e conformidade. A separação opera diretamente sobre dados de voz que podem incluir informações sensíveis. Equipes corporativas devem confirmar como o áudio é armazenado, se é usado para treinamento de modelos e quais controles existem para retenção e acesso, especialmente para setores regulamentados e conteúdo de treinamento interno.
Ponderar esses critérios em relação aos seus casos de uso reais, seja expansão de canal, treinamento, marketing, trabalho narrativo ou um produto de API, diz a você se um separador integrado com ferramentas de voz posteriores se encaixa em como você opera.
Riscos, limites e o que ela não consegue corrigir
Mesmo modelos fortes têm arestas duras que vale a pena conhecer antes de você se comprometer.
- Ruído extremo ou relação sinal-ruído muito baixa. Quando a fala está soterrada sob ruído ou música altos, o modelo pode falhar em recuperar cada palavra, produzindo quedas de áudio ou saída abafada.
- Forte sobreposição de locutores. Pessoas falando exatamente ao mesmo tempo desafiam até os sistemas avançados de múltiplos locutores e podem fazer a fala vazar entre os fluxos separados.
- Artefatos de superseparação. A mascaramento agressivo pode introduzir ruído musical ou um timbre robótico, mais perceptível em sons sustentados e sibilantes.
- Descompasso entre treinamento e realidade. Modelos ajustados em certos microfones, idiomas ou ambientes podem ter desempenho inferior em gravações muito diferentes, o que então arrasta para baixo a precisão da transcrição e da dublagem.
- Ética e direitos. A fala separada de forma limpa é mais fácil de transcrever, analisar e remixar, então as equipes devem respeitar o consentimento e os direitos ao reutilizar vozes em novos idiomas ou contextos.
A conclusão honesta é que a separação é um aprimoramento poderoso, não um substituto para hábitos razoáveis de gravação. Bons microfones, níveis sensatos e escolhas conscientes de local ainda compensam, e a IA então multiplica essas escolhas ao tornar o conteúdo muito mais flexível para localização e reutilização. Se você está explorando como encaixar isso em uma configuração de publicação maior, nosso artigo explicativo sobre o que é um separador de fala cobre os fundamentos com mais profundidade.
Perguntas frequentes
O que é a separação de fala por IA em termos simples?
É um processo de IA que pega uma gravação misturada e isola a fala humana, dando a você uma faixa de voz limpa e, opcionalmente, uma faixa de fundo separada que você pode manter ou descartar.
Como o nosso Separador de Fala é diferente da redução de ruído básica?
A redução de ruído tradicional atenua principalmente o ruído em estado estacionário. Nosso separador usa aprendizado profundo para reconhecer padrões de fala e extraí-los de uma ampla gama de sons de fundo e músicas, o que geralmente resulta em diálogos mais limpos e naturais.
Ele consegue lidar com múltiplos locutores?
Nosso Separador de Fala é otimizado para isolar a fala humana de fundos não vocais, o que funciona melhor com um locutor principal na mistura. Dividir várias vozes sobrepostas é uma área de pesquisa ativa, e modelos especializados existem, mas eles normalmente visam reuniões ou call centers em vez de fluxos de trabalho gerais de criadores.
Por que a separação de fala importa para a dublagem multilíngue?
A localização depende de transcrição e sincronização precisas. Uma faixa de fala limpa reduz erros de reconhecimento e ajuda as narrações traduzidas a se alinharem com o vídeo original, reduzindo artefatos audíveis quando novas vozes são mixadas com música e efeitos preservados.
De quanto conhecimento técnico eu preciso para usá-lo?
Muito pouco. Você envia um arquivo de áudio ou vídeo, deixa a IA processá-lo e baixa as faixas de fala e fundo separadas para edição, dublagem ou automação, sem necessidade de ajuste manual de parâmetros.