Tłumaczenie mowy na mowę zamienia słowa wypowiedziane w jednym języku na słyszalną mowę w innym, dzięki czemu Twoi odbiorcy słyszą tłumaczenie, zamiast je czytać. Wyobraź sobie wykładowcę, który nagrał lekcję po angielsku, a teraz potrzebuje wersji hiszpańskiej bez ponownego nagrywania czegokolwiek: system transkrybuje angielski, tłumaczy sens i generuje w jego miejsce hiszpańskie audio. Ta zmiana z czytania na słuchanie jest sednem sprawy i zmienia sposób, w jaki planujesz, sprawdzasz i publikujesz treści wielojęzyczne.
Prawdziwym pytaniem rzadko jest to, czy technologia działa. Pytanie brzmi raczej, której jej wersji potrzebujesz: nagranego tłumaczenia dla filmów, kursów i podcastów; tłumaczenia niemal w czasie rzeczywistym dla spotkań i wydarzeń; wyjścia zachowującego głos, które utrzymuje tożsamość oryginalnego mówcy; albo API, które możesz wpiąć we własną aplikację. Każda z tych ścieżek wiąże się z innymi kompromisami w zakresie jakości, opóźnienia i nakładu pracy przy weryfikacji, a ten przewodnik mapuje je, abyś mógł wybierać z otwartymi oczami.
Spis treści
Jak działa tłumaczenie mowy na mowę
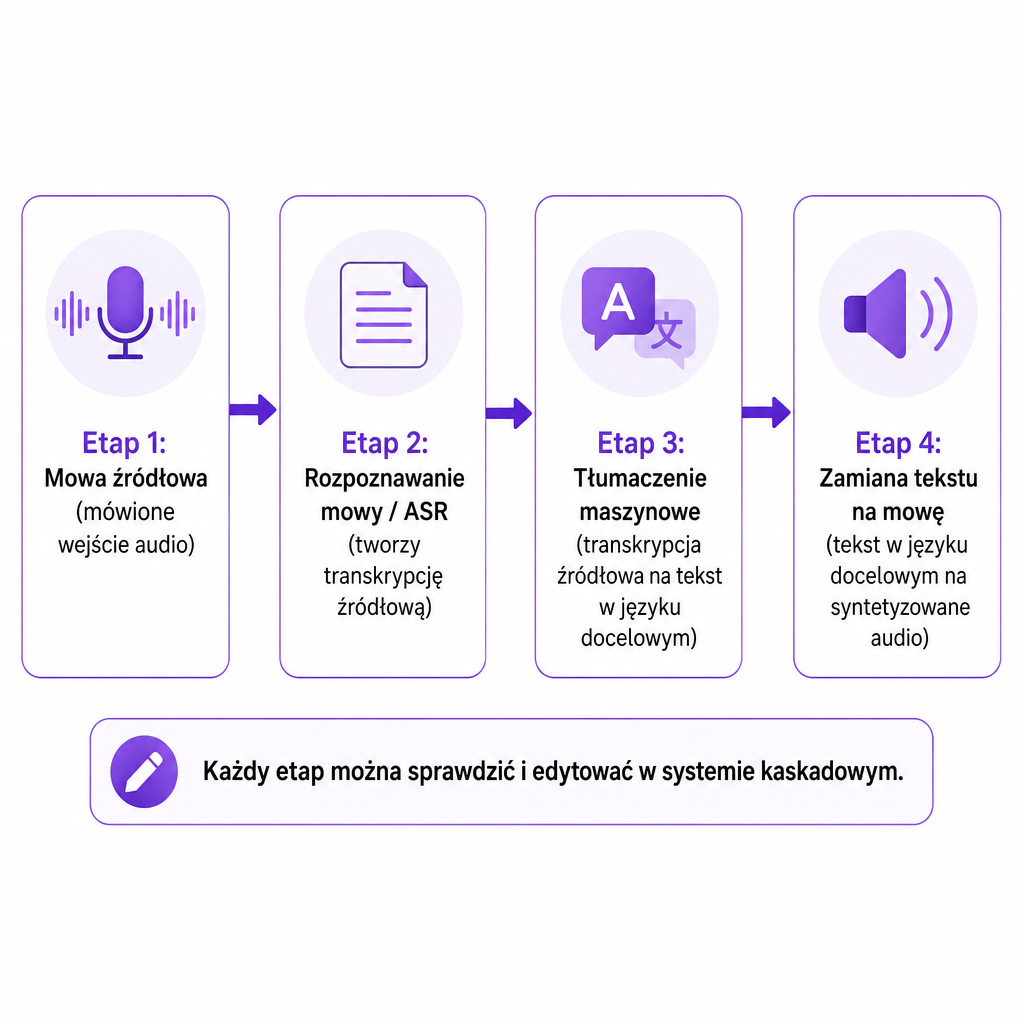
Większość systemów działa w połączonym potoku trzech technologii. Najpierw automatyczne rozpoznawanie mowy (ASR) analizuje źródłowe audio i tworzy transkrypcję. Następnie tłumaczenie maszynowe zamienia ten tekst w języku źródłowym na język docelowy. Na koniec synteza mowy zamienia przetłumaczony tekst na mówione audio. Przepływ czyta się klarownie jako mowa źródłowa, potem rozpoznawanie, potem przetłumaczony tekst, a potem zsyntetyzowana mowa.
Mowa źródłowa → rozpoznawanie mowy → przetłumaczony tekst → zsyntetyzowana mowa
Ta warstwowa konstrukcja nazywana jest kaskadowym tłumaczeniem mowy na mowę, a publikacja NIST na temat oceny tłumaczenia mowy opisuje tę samą strukturę: ASR buduje transkrypcję źródłową, tłumaczenie maszynowe tworzy tekst w języku docelowym, a synteza mowy generuje mówione wyjście. Zaletą kaskady jest to, że każdy etap można zbadać, dzięki czemu można poprawić transkrypcję lub tłumaczenie, zanim audio w ogóle zostanie wygenerowane.
Nowsze podejście trenuje model typu end-to-end, aby mapował audio źródłowe bezpośrednio na audio w języku docelowym bez ujawniania oddzielnych etapów transkrypcji i syntezy. Badania udostępnione w raporcie technicznym DTIC o bezpośrednim tłumaczeniu mowy przedstawiają to jako sposób na zmniejszenie opóźnienia i zachowanie większej części głosu oryginalnego mówcy, zaznaczając jednocześnie, że nadal wiąże się to z kompromisami w zakresie szybkości, kontekstu, zasięgu językowego i jakości wyjścia. W praktyce kaskada daje większą kontrolę redakcyjną; podejście end-to-end dąży do niższego opóźnienia i ciągłości głosu.
Tłumaczenie mowy na mowę a pokrewne zadania
Ludzie często mylą tłumaczenie mowy na mowę z transkrypcją, tłumaczeniem tekstu i dubbingiem, ale każde z nich kończy się innym produktem. Tłumaczenie tekstu zatrzymuje się na wyjściu pisemnym. Tłumaczenie mowy na mowę kończy się wyjściem mówionym, mimo że system kaskadowy nadal używa tekstu wewnętrznie jako reprezentacji pośredniej. Rozróżnienie wejść i wyjść chroni cię przed wyborem niewłaściwego narzędzia do zadania.
| Technologia | Wejście | Wyjście | Typowe zastosowanie |
|---|---|---|---|
| Mowa na tekst | Mówione audio | Transkrypcja pisemna | Napisy, notatki, treści przeszukiwalne |
| Tłumaczenie tekstu | Tekst pisany | Przetłumaczony tekst | Dokumenty, podpisy, strony internetowe |
| Tekst na mowę | Tekst pisany | Mowa syntetyczna | Narracja, dostępność, interfejsy głosowe |
| Tłumaczenie mowy na mowę | Mówione audio | Przetłumaczona mowa | Rozmowy, dubbing, media wielojęzyczne |
Dubbing zasługuje na własne rozróżnienie. Tłumaczenie mowy na mowę koncentruje się wąsko na zmianie języka mówionego. Dubbing to szerszy przepływ pracy lokalizacji mediów, który go obejmuje: tłumaczenie dialogów, przypisywanie mówców, generowanie nowych głosów, dostosowywanie synchronizacji, miksowanie przetłumaczonych głosów z muzyką i dźwiękiem tła oraz eksport gotowego projektu. W przypadku nagranego filmu na YouTube, kursu online, podcastu lub filmu dubbing jest zwykle bardziej praktycznym formatem, ponieważ dodaje te kontrolki redakcyjne na wierzchu tłumaczenia. Jeśli rozważasz audio w porównaniu z tekstem na ekranie, nasz artykuł o dubbingu a napisach do filmów omawia ten konkretny wybór, a szersze mechanizmy znajdziesz w naszym przewodniku o tym, czym jest dubbing AI i jak działa.
Trzy komponenty decydujące o jakości
Jakość wyjścia to nie pojedyncza liczba. To iloczyn trzech etapów, z których każdy ma własne tryby awarii, więc warto oceniać je osobno, zamiast ufać ogólnemu wrażeniu.
Automatyczne rozpoznawanie mowy identyfikuje słowa w nagraniu źródłowym, a jego dokładność spada przy muzyce w tle, nakładających się mówcach, silnych akcentach, szybkiej lub niepełnej mowie, terminach specjalistycznych, słabych mikrofonach i przełączaniu kodów między językami. Powszechną miarą jest tu wskaźnik błędów słów (WER), który porównuje automatyczną transkrypcję z referencją ludzką, licząc podstawienia, usunięcia i wstawienia. Ta sama publikacja NIST używa WER jako wskaźnika odniesienia dla rozpoznawania, choć niski WER nie potwierdza, że późniejsze tłumaczenie zachowało znaczenie lub ton. Jeśli twoje audio źródłowe jest zaszumione, wyizolowanie najpierw czystej mowy za pomocą narzędzia takiego jak nasz separator mowy może podnieść dokładność rozpoznawania, zanim tłumaczenie w ogóle się zacznie.
Tłumaczenie maszynowe musi interpretować więcej niż pojedyncze słowa. Obsługuje strukturę zdań, kontekst, zaimki i rodzaj, idiomy, humor, formalność, odniesienia kulturowe, terminologię techniczną i różnice w szyku wyrazów. Dosłowne tłumaczenie może być poprawne gramatycznie, a jednak brzmieć nienaturalnie lub po cichu zmieniać zamierzone znaczenie, co jest szczególnie ryzykowne w przypadku haseł reklamowych, instrukcji prawnych, informacji medycznych, treści finansowych i materiałów edukacyjnych.
Synteza mowy generuje ostateczny głos w języku docelowym, kontrolując wymowę, pauzy, tempo mówienia, intonację, akcentowanie, ton emocjonalny, tożsamość głosu oraz akcent lub wariant językowy. Nasz produkt Text to Speech oferuje ponad 300 głosów AI, generowanie wielojęzyczne i klonowanie głosu w 33 językach, z kontrolkami tempa mowy, akcentowania, czytania liczb i ekspresji emocjonalnej. Technicznie dokładne tłumaczenie może nadal źle wypaść, jeśli sposób przekazu nie pasuje do marki, kursu lub filmu dokumentalnego, do którego należy.
Klonowanie głosu w przetłumaczonej mowie
Klonowanie głosu jest opcjonalne, ale to właśnie ono sprawia, że przetłumaczone treści brzmią jak ten sam twórca, a nie jak obca osoba czytająca scenariusz. Zamiast przypisywać każdemu językowi niepowiązany głos z biblioteki, system może zbudować wykonanie w języku docelowym wzorowane na tożsamości głosowej oryginalnego mówcy. Ta ciągłość ma znaczenie dla kanału, który chce jednego rozpoznawalnego głosu w różnych językach, firmy ze znanym prezenterem, długiego kursu prowadzonego przez wykładowcę, filmowca potrzebującego spójności między wersjami dubbingowanymi lub prowadzącego podcast, który chce zachować znajome brzmienie w przetłumaczonych odcinkach.
To nie jest gwarancja. Klonowanie zachowuje tożsamość głosu, ale emocje, humor, tempo, wymowa i kontekst kulturowy nadal wymagają przejścia przez człowieka przed publikacją. Równie ważna jest autoryzacja: odpowiedzialny przepływ pracy potwierdza, że osoba, która dostarczyła nagranie, wyraziła zgodę na klonowanie oraz że powstały głos może być wykorzystany do zamierzonej dystrybucji komercyjnej, publicznej lub geograficznej. Jeśli ciekawią cię mechanizmy stojące za tym, nasz przegląd jak działa klonowanie głosu zagłębia się bardziej, a narzędzie Voice Cloning pokazuje stronę produkcyjną.
Tłumaczenie nagrane a tłumaczenie w czasie rzeczywistym
To decyzja, przed którą faktycznie staje większość zespołów, a tych dwóch trybów nie należy oceniać według tej samej miary.
Tłumaczenie nagrane zwykle lepiej pasuje do produkcji medialnej, ponieważ daje czas na pracę. Możesz poprawić transkrypcję, zredagować terminologię, sprawdzić tłumaczenie, zidentyfikować mówców, dostosować synchronizację, ponownie wygenerować głosy, zmiksować dźwięk tła i przeprowadzić ludzką kontrolę jakości, zanim cokolwiek zostanie wysłane. To sprawia, że dobrze nadaje się do kanałów YouTube, e-learningu, szkoleń korporacyjnych, podcastów, filmów produktowych i filmów niezależnych.
Tłumaczenie w czasie rzeczywistym działa pod trudniejszym ograniczeniem: musi zacząć wytwarzać wyjście, zanim mówca skończy zdanie. Więcej kontekstu poprawia jakość tłumaczenia, ale dodaje opóźnienie, podczas gdy krótsze opóźnienia wymuszają przewidywania lub częściowe tłumaczenia, a błędy trudno wycofać, gdy audio już się odtworzyło. Raport DTIC zauważa, że wcześniejsze systemy kaskadowe często działały z opóźnieniami od czterech do pięciu sekund, kumulowały błędy między etapami i miały ograniczoną personalizację, a także że zwiększenie wyprzedzenia modelu może podnieść jakość, jednocześnie sprawiając, że interakcja wydaje się mniej natychmiastowa. Funkcja tłumaczenia konferencji na żywo i dopracowany wielojęzyczny dubbing rozwiązują różne problemy, więc oceniaj je według różnych standardów.
Jak ocenić przepływ pracy mowy na mowę
Testuj na reprezentatywnej próbce, a nie na starannie dobranym zdaniu demonstracyjnym. Poniższa lista kontrolna odzwierciedla rzeczywiste warunki, na jakie natrafi twoja treść, i utrzymuje ocenę uczciwą.
- Zasięg języków i dialektów: „Obsługuje hiszpański" może nie oznaczać akcentu, słownictwa ani regionalnych preferencji, jakich oczekują twoi odbiorcy. Potwierdź warianty źródłowe i docelowe, w tym amerykański a inny angielski, hiszpański latynoamerykański a europejski oraz francuski kanadyjski a europejski.
- Dokładność transkrypcji: Tłumaczenie nie naprawi niezawodnie transkrypcji, która przekręca nazwy, liczby lub terminy produktowe. Sprawdź, czy możesz zbadać i edytować transkrypcję przed wygenerowaniem audio.
- Znaczenie i kontekst: Celowo testuj idiomy, żarty, wezwania do działania, twierdzenia o produktach i terminologię branżową. Płynność to nie dokładność.
- Obsługa mówców: W przypadku wywiadów, paneli i filmów sprawdź, czy narzędzie potrafi zidentyfikować wielu mówców i utrzymać spójność ich głosów, również gdy ludzie sobie przerywają.
- Synchronizacja i zgranie w czasie: Przetłumaczone zdania rzadko odpowiadają oryginalnemu czasowi trwania. Szukaj kontrolek synchronizacji lub tempa mowy, a także edycji dialogów, zachowania dźwięku tła, regulacji głośności, ponownego generowania segmentów i wizualnego dopasowania tam, gdzie to potrzebne.
- Naturalność głosu: Wsłuchaj się w wymowę, pauzy, akcentowanie, zakres emocjonalny i nienaturalny rytm.
- Opóźnienie: W przypadku użycia na żywo zmierz opóźnienie między mówcą a audio. W przypadku użycia nagranego przedkładaj elastyczność edycji nad surową szybkość przetwarzania.
- Kontrolki weryfikacji i eksportu: Narzędzie gotowe do produkcji pozwala poprawić tekst, ponownie wygenerować poszczególne segmenty, dostosować synchronizację i eksportować w formacie, który akceptuje twój przepływ pracy publikacyjnej.
Przepuść te próbki przez swoją krótką listę i porównaj dokładność transkrypcji, znaczenie tłumaczenia, wymowę, naturalność głosu, spójność mówców, synchronizację, jakość dźwięku tła, nakład pracy przy weryfikacji oraz całkowity koszt przy oczekiwanej objętości. Najsilniejszy system to nie ten z największą liczbą głosów czy języków. To ten, który daje akceptowalne wyniki dla twojej konkretnej treści przy nakładzie pracy weryfikacyjnej, który twój zespół jest w stanie faktycznie udźwignąć.
Ryzyka i ograniczenia, które warto uwzględnić w planowaniu
Każdy etap wprowadza własny rodzaj błędu, a naturalnie brzmiący głos może je wszystkie zamaskować. AI może błędnie przetłumaczyć wieloznaczne wyrażenia, nazwy, idiomy i terminy specjalistyczne, więc ludzka weryfikacja pozostaje niezbędna wszędzie tam, gdzie dokładność niesie ciężar prawny, związany z bezpieczeństwem, finansowy lub reputacyjny. Błędy rozpoznawania potęgują problem: szum, nakładanie się głosów, akcenty i słabe nagrania mogą sprawić, że system źle usłyszy źródło, dlatego przegląd transkrypcji przed zatwierdzeniem tłumaczenia jest nie do pominięcia.
Znaczenie kulturowe łatwo utracić. Bezpośrednie tłumaczenie może pominąć humor, uprzejmość lub odniesienia, które przetrwają jedynie dzięki przepisaniu, a nie przejściu słowo w słowo. Klonowanie głosu dodaje ryzyko związane ze zgodą i podszywaniem się, więc udokumentuj, kto autoryzował głos, zakres użycia, terytorium, czas trwania oraz to, czy może pojawić się w reklamie lub syntetycznych oświadczeniach publicznych. Istnieje też wymiar zaufania odbiorców: raport DTIC opisuje, jak jedno z doświadczeń tłumaczeniowych informuje użytkowników, że przetłumaczone audio zostało wygenerowane syntetycznie — rozsądne oczekiwanie, które warto uwzględnić we własnych ujawnieniach.
Dwa cichsze ryzyka dopełniają listę. Prywatność ma znaczenie zawsze, gdy audio zawiera dane osobowe, poufne dyskusje, dane klientów lub nieopublikowane treści, więc przejrzyj warunki dostawcy dotyczące obsługi danych, ich przechowywania, dostępu i usuwania przed przesłaniem. A fałszywa pewność to najbardziej podstępna awaria ze wszystkich: dopracowany głos sprawia, że błędne tłumaczenie brzmi autorytatywnie, więc nigdy nie traktuj płynności jako dowodu dokładności faktograficznej.
Gdzie wpisuje się DubSmart
Jesteśmy najbardziej bezpośrednio istotni dla nagranego tłumaczenia mowy na mowę poprzez AI Dubbing, a nie przez jakiekolwiek twierdzenie o uniwersalnym tłumaczeniu konwersacyjnym na żywo. Nasz przepływ pracy dubbingu przyjmuje przesłane pliki audio i wideo oraz linki z YouTube, obsługuje ponad 60 języków źródłowych i 33 języki docelowe, klonuje głos każdego mówcy do przetłumaczonej wersji oraz pozwala edytować tekst, mówców i synchronizację, ponownie generować segmenty, regulować głośność dźwięku tła i pobierać gotowy projekt. Ta warstwa redakcyjna jest dokładnie tym, czego potrzebuje produkcja nagranych mediów.
Dla zespołów budujących własne potoki oferujemy także API AI Dubbing, Text to Speech i Voice Cloning, które pasują do agencji, przepływów pracy medialnych i aplikacji wymagających automatyzacji wielojęzycznej produkcji głosu. Właściwy wybór sprowadza się do tego, czy twój projekt potrzebuje gotowego edytora mediów, potoku napędzanego API, czy obu. W przypadku krótkiego komunikatu o wysokiej stawce profesjonalne ludzkie tłumaczenie i nagranie mogą nadal wygrywać; w przypadku dużej, często aktualizowanej biblioteki treści przepływ pracy AI lepiej się skaluje, z ludzką weryfikacją skupioną na materiale o najwyższym ryzyku.
Często zadawane pytania
Czy tłumaczenie mowy na mowę to to samo, co tłumaczenie ustne?
Nie. Tłumaczenie ustne przez człowieka opiera się na wyszkolonej osobie, która słucha, rozumie i przekazuje znaczenie na bieżąco. Tłumaczenie mowy na mowę jest zautomatyzowane: szybkie i skalowalne, ale może wymagać weryfikacji i miewa trudności z niuansami, z którymi profesjonalny tłumacz ustny radzi sobie naturalnie.
Czy zawsze działa w czasie rzeczywistym?
Nie. Niektóre systemy przetwarzają nagrane audio z pełną kontrolą edycji, podczas gdy inne zapewniają wyjście na żywo lub niemal w czasie rzeczywistym. Systemy na żywo nieustannie równoważą kontekst tłumaczenia, opóźnienie i dokładność.
Czy może zachować głos oryginalnego mówcy?
Czasami. Systemy wykorzystujące klonowanie głosu lub syntezę zachowującą głos mogą modelować tożsamość oryginalnego mówcy, ale wynik zależy od technologii, pary językowej, jakości audio i autoryzacji do użycia tego głosu.
Czy dubbing AI jest formą tłumaczenia mowy na mowę?
Tak. Dubbing AI to zastosowanie tłumaczenia mowy na mowę w nagranych mediach, które dodaje funkcje edycji, zarządzania mówcami, synchronizacji, miksowania i eksportu na wierzchu podstawowego tłumaczenia.
Jak dokładne jest?
Dokładność różni się w zależności od języka, jakości nagrania, terminologii, mówcy i systemu. Oceniaj transkrypcję, tłumaczenie i wygenerowane audio osobno, zamiast ufać pojedynczemu procentowi dokładności.