Platforma do tworzenia mediów oparta na AI to jedno środowisko, w którym generujesz, udźwiękawiasz, lokalizujesz i eksportujesz media — dźwięk, wideo, obrazy i tekst — przy użyciu sztucznej inteligencji, zamiast łączyć ze sobą osobne narzędzia i ręczne przekazywanie plików. Więc gdy pytasz, czym jest platforma do tworzenia mediów oparta na AI, krótka odpowiedź brzmi: zastępuje ona zlepek aplikacji do transkrypcji, narzędzi głosowych, usług tłumaczeniowych i edytorów jednym połączonym przepływem pracy. W DubSmart AI zbudowaliśmy naszą platformę dokładnie wokół tej idei: przejdź od surowego scenariusza lub materiału źródłowego do w pełni udźwiękowionej, wielojęzycznej treści, nie opuszczając przestrzeni roboczej.
Ta konsolidacja ma znaczenie, ponieważ najtrudniejszą częścią współczesnej pracy nad treścią rzadko jest pojedyncze zadanie. Chodzi o zachowanie spójności głosów, zsynchronizowanie czasu i płynne przenoszenie plików między etapami. Platforma, która obejmuje cały proces, eliminuje tarcia pochłaniające godziny między nagrywaniem, dubbingiem a publikacją.
Spis treści
Co właściwie liczy się jako platforma do tworzenia mediów oparta na AI
Cechą definiującą jest przepływ pracy, a nie liczba funkcji. Zbiór możliwości AI staje się platformą dopiero wtedy, gdy te możliwości dzielą jedno środowisko: importujesz media raz, przekształcasz je przez kilka etapów AI i eksportujesz gotowy zasób bez eksportowania i ponownego importowania między narzędziami.
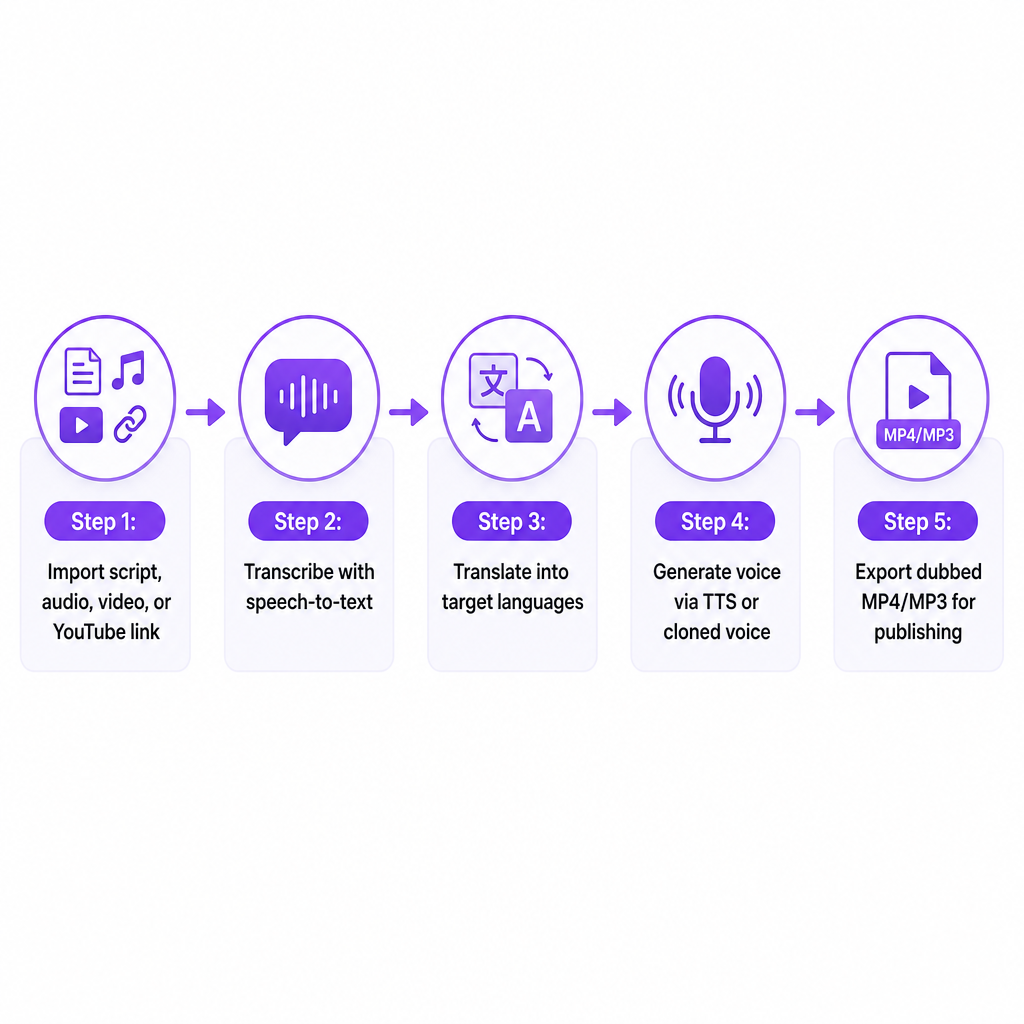
Po naszej stronie oznacza to, że zamiana tekstu na mowę, klonowanie głosu, dubbing AI, zamiana mowy na tekst, separator mowy, generowanie obrazu z tekstu oraz przekształcanie obrazu w wideo — wszystko to znajduje się w jednym miejscu. Twórca YouTube, zespół marketingowy czy producent e-learningu może zacząć od scenariusza lub materiału źródłowego i osiągnąć wielojęzyczny, w pełni udźwiękowiony efekt w jednym systemie. Zadaniem platformy jest obsługa pracy łączącej etapy — transkrypcja zasilająca tłumaczenie, tłumaczenie zasilające generowanie głosu, generowanie głosu zasilające zsynchronizowany dubbing — tak aby żaden etap nie stał się ręcznym przekładaniem plików.
To praktyczna granica między narzędziem jednozadaniowym a platformą. Samodzielny generator zamiany tekstu na mowę tworzy dźwięk i na tym kończy. Platforma traktuje ten dźwięk jako jeden etap dłuższego procesu, który kończy się gotowym do publikacji, zlokalizowanym plikiem.
Czy jej potrzebujesz, czy wystarczą osobne narzędzia
Prawdziwa decyzja dotyczy tego, czy nadal zarządzać treścią i lokalizacją za pomocą rozproszonych dostawców i subskrypcji SaaS, czy scentralizować tę pracę tam, gdzie generowanie głosu, wideo i obrazów łączy się bezpośrednio. Dla większości zespołów odpowiedź zależy od tego, jak często pojawia się to pytanie.
Kilka scenariuszy sprawia, że wybór staje się konkretny:
- Kanał YouTube, który odniósł sukces po angielsku, chce mieć wersje hiszpańskie, portugalskie lub hindi bez ponownego nagrywania każdego filmu.
- Mały zespół marketingowy potrzebuje opłacalnej lokalizacji kampanii, prezentacji produktów i materiałów wyjaśniających w regularnym harmonogramie.
- Grupa zajmująca się e-learningiem lub szkoleniami korporacyjnymi musi spójnie dostarczać długie kursy w kilku językach dla pracowników na całym świecie.
- Niezależny filmowiec lub podcaster chce wielojęzycznego dubbingu, ale nie może uzasadnić powtarzających się sesji studyjnych i honorariów lektorów.
- Zespół deweloperski lub agencja potrzebuje głosu AI udostępnionego przez API, aby zasilić własny produkt lub proces lokalizacji.
Jeśli Twój obecny proces opiera się na ręcznym nagrywaniu, zewnętrznych studiach, kilku niepołączonych aplikacjach lub niestandardowych skryptach tylko po to, by przenosić pliki między systemami, pytanie przestaje dotyczyć dodania kolejnego narzędzia. Staje się kwestią wydajności, skali i kontroli. Jeśli lokalizujesz jeden film rocznie, osobne narzędzia w zupełności wystarczą. Jeśli lokalizujesz co tydzień, to właśnie przekazywanie plików między etapami pochłania Twój czas i spójność.
Jak te platformy działają od kuchni
Implementacje się różnią, ale większość platform do tworzenia mediów opartych na AI dzieli kilka wspólnych mechanizmów. Oto jak łączą się one w naszym przepływie pracy.
Scentralizowana przestrzeń robocza do pracy z mediami
Wszystko zaczyna się od importu: scenariuszy, dźwięku, plików wideo lub linku do YouTube. Stamtąd organizujesz projekty według języka, mówcy i kanału, stosujesz transformacje AI na wspólnej osi czasu i eksportujesz w formacie, którego potrzebuje miejsce docelowe — MP4 lub MP3 na YouTube, gotowe do edycji pliki do postprodukcji, dźwięk dla platformy LMS. Nasz interfejs jest zbudowany tak, abyś przesyłał lokalne wideo lub linkował do treści online, konfigurował mówców i czasy oraz pobierał gotowe zlokalizowane projekty z tej samej przestrzeni roboczej.
Tworzenie i klonowanie głosu jako spoiwo
Głos jest zazwyczaj kręgosłupem całego procesu. Traktujemy klonowanie głosu jako spoiwo, a nie nowinkę: przesyłasz czystą próbkę mowy, przetwarzamy ją w nazwany, niestandardowy głos w kilka sekund, a Ty wykorzystujesz ten głos wielokrotnie w zamianie tekstu na mowę i dubbingu. Mechanika jest prosta — nagraj lub dostarcz co najmniej 20 sekund czystej mowy, prześlij ją do sekcji klonowania głosu, a następnie zastosuj powstały profil tam, gdzie go potrzebujesz. Ten sam sklonowany głos może generować intra i lektory szkoleniowe w TTS oraz zachować tożsamość mówcy w różnych językach podczas dubbingu. Biblioteka ponad 300 naturalnie brzmiących głosów bazowych pokrywa przypadki, gdy chcesz mieć różne głosy dla różnych rynków.
Zamiana tekstu na mowę i dubbing z mowy na mowę
Zamiana tekstu na mowę przekształca scenariusze i napisy w naturalnie brzmiący dźwięk, a ponieważ łączy się bezpośrednio z dubbingiem i generowaniem napisów, pojedynczy projekt może przejść od tekstu do zlokalizowanego wideo bez opuszczania przepływu pracy. Dubbing z mowy na mowę działa inaczej: bierze istniejący nagrany głos, analizuje ton, wysokość, styl mówienia i czas, a następnie odtwarza ten głos mówiący w nowym języku docelowym. Nasz proces dubbingu AI wykorzystuje to, aby zachować cechy oryginalnego mówcy zamiast wstawiać ogólną narrację — przydatne, gdy autentyczność jest kluczowa. Jeśli chcesz poznać głębszą mechanikę, nasze wyjaśnienie dotyczące dubbingu z mowy na mowę omawia przepływ od analizy do regeneracji.
Wielojęzyczny proces lokalizacji
Wartość platformy zależy w dużej mierze od zakresu językowego i tego, jak tłumaczenie łączy się z głosem. Nasz zestaw narzędzi dubbingowych obsługuje dubbing z ponad 60 języków źródłowych na 33 języki docelowe, pozwalając wybrać języki docelowe, mówców i style dla każdego projektu. W praktyce: importujesz wideo lub link, wybierasz jeden lub więcej języków docelowych, na przykład z angielskiego na hiszpański i portugalski, wybierasz sklonowane lub gotowe głosy dla każdego języka, a system zajmuje się transkrypcją, tłumaczeniem, generowaniem głosu i ponownym synchronizowaniem czasu w gotowy do przesłania dubbing. Ponieważ klonowanie jest zintegrowane, ten sam głos prowadzącego może przenosić się przez wszystkie języki, utrzymując widownię na znajomym gruncie.
API dla deweloperów i agencji
Gdy zespoły budują własne produkty, potrzebują możliwości udostępnionych programowo. Publikujemy API klonowania głosu, które odzwierciedla przepływ w aplikacji: poproś o wstępnie podpisany adres URL przesyłania, prześlij próbkę dźwiękową (MP3, WAV, AAC, M4A lub FLAC), utwórz niestandardowy głos, wysyłając zwrócony klucz pliku wraz z nazwą głosu, a następnie odwołuj się do tego głosu w kolejnych wywołaniach. API dubbingu AI pozwala deweloperom tworzyć projekty dubbingowe, ustawiać języki docelowe i ustawienia głosu oraz uruchamiać analizę głosu oryginalnego mówcy przed wygenerowaniem mowy zachowującej te cechy w nowym języku. Oznacza to, że agencje mogą osadzać głos i dubbing wewnątrz własnych produktów bez odbudowywania leżących u ich podstaw modeli.
Trzy ogólne podejścia do tworzenia mediów opartego na AI
Nawet w obrębie zintegrowanych platform rynek dzieli się na kilka typów opcji, a każdy pasuje do innego nabywcy.
Platformy skupione na twórcy, napędzane przepływem pracy kładą nacisk na przystępny interfejs, organizację projektów i kompleksową lokalizację wideo, dźwięku i obrazów. Tutaj plasuje się nasza aplikacja internetowa, obejmująca TTS, klonowanie, dubbing, zamianę mowy na tekst, separację mowy, generowanie obrazu z tekstu i przekształcanie obrazu w wideo w jednym interfejsie.
Platformy skoncentrowane na API kierują ofertę przede wszystkim do deweloperów, koncentrując się na punktach końcowych i ładunkach danych zamiast na nietechnicznym interfejsie. Nasze API klonowania głosu, TTS i dubbingu AI rozszerzają produkt skupiony na twórcy dla zespołów potrzebujących kontroli programowej.
Wąskie narzędzia o pojedynczej funkcji robią jedną rzecz — podstawowe TTS lub prostą transkrypcję — bez otaczającego procesu. Mogą sprawdzić się w bardzo skoncentrowanym zadaniu, ale będziesz potrzebować dodatkowych narzędzi, aby dojść do gotowego, zlokalizowanego zasobu.
Dla większości amerykańskich twórców i firm wybór sprowadza się do platformy przepływu pracy, której zespół marketingowy lub zespół ds. treści może używać bezpośrednio, w porównaniu z podejściem API, które deweloperzy wpinają w istniejące systemy. Świadomie odpowiadamy na oba końce: produkt oparty na kredytach z przepływami pracy w interfejsie oraz API do integracji.
Jak wybrać: kryteria, które mają znaczenie
Gdy zastanawiasz się, czy w ogóle wdrożyć platformę i którą, kilka kryteriów wykonuje większość pracy.
| Kryterium | Co sprawdzić | Jak my do tego podchodzimy |
|---|---|---|
| Zakres przepływu pracy | Czy obejmuje drogę od scenariusza lub materiału źródłowego do gotowych zlokalizowanych mediów? | TTS, klonowanie, dubbing, zamiana mowy na tekst, separator mowy, generowanie obrazu z tekstu, przekształcanie obrazu w wideo w jednym procesie |
| Jakość języka i głosu | Zakres języków źródłowych i docelowych oraz realizm głosu | Ponad 60 języków źródłowych na 33 docelowe, ponad 300 naturalnych głosów, klonowanie dla autentycznej tożsamości |
| Szybkość i skala | Jak szybko dane wejściowe stają się wyjściowymi; pojemność wsadowa | Klonowanie z krótkich próbek przetwarzane w sekundy; dubbing zbudowany z myślą o powtarzalnych projektach |
| Model cenowy | Przewidywalny, elastyczny koszt powiązany z wolumenem | Oparty na kredytach z darmowym poziomem, przenoszonymi kredytami i planami dla przedsiębiorstw |
| Integracja | API do połączenia istniejącego LMS, CMS lub narzędzi wewnętrznych | API klonowania głosu, TTS i dubbingu AI udostępniające kluczowe funkcje |
Dwa z nich zasługują na bliższe spojrzenie. Jeśli chodzi o szybkość, nasze klonowanie działa z około 20 sekund dźwięku i zwraca gotowy do użycia głos w kilka sekund, więc czas realizacji nie zależy od nagrywania długich zestawów danych. Jeśli chodzi o cenę, model oparty na kredytach z przenoszeniem oznacza, że niewykorzystane saldo przechodzi dalej, a koszt dopasowuje się do wolumenu treści, a nie wyłącznie do stałych stanowisk — co pasuje do twórców i zespołów szkoleniowych, których produkcja rośnie i maleje.
Ryzyka, ograniczenia i odpowiedzialne korzystanie
Skala wiąże się z obowiązkami, a uczciwa wersja tej odpowiedzi je nazywa.
- Prawa do głosu i zgoda. Klonowanie głosu bez odpowiedniego upoważnienia rodzi obawy prawne i etyczne. Zachęcamy do czystych próbek za zgodą i traktujemy sklonowane głosy jako profesjonalne zasoby, a nie narzędzia do podszywania się. Nasz przewodnik po zastosowaniach klonowania głosu dla twórców opiera się na uzasadnionych przypadkach, takich jak wielojęzyczne kanały i szkolenia.
- Autentyczność i ujawnianie. Widownia może zwracać uwagę na to, czy głos jest syntetyczny. W marketingu, szkoleniach i filmie przejrzystość co do wykorzystania AI chroni zaufanie — zwłaszcza gdy zdubbingowany głos brzmi niemal identycznie jak oryginalny mówca w różnych językach.
- Niuanse językowe i kulturowe. Nawet dobre tłumaczenie i dubbing korzystają na weryfikacji przez człowieka. Lokalne idiomy, frazeologia regulacyjna i wrażliwości kulturowe sprawiają, że efekt AI należy traktować jako pierwsze podejście w przypadku treści o wysokiej stawce, takich jak komunikaty dotyczące zgodności, medyczne czy finansowe.
- Bezpieczeństwo danych. Dźwięk, scenariusze i wideo są często własnością zastrzeżoną. Kontrolowane przepływy przesyłania i organizacja oparta na projektach — jak nasz model wstępnie podpisanych adresów URL — mają znaczenie dla zespołów pracujących z materiałami wrażliwymi.
Obsłużone za pomocą polityk i weryfikacji, te ryzyka nie przekreślają wartości platformy do tworzenia mediów opartej na AI. Określają, jak profesjonalne zespoły powinny ustrukturyzować korzystanie z niej.
Dla amerykańskich twórców, firm i zespołów szkoleniowych nasza platforma jest konkretną odpowiedzią na pierwotne pytanie: kompleksowe środowisko do tworzenia i lokalizacji mediów, które konsoliduje narzędzia głosowe i wizualne, utrzymuje Twój własny głos spójnym w różnych językach, skaluje się do głównych rynków dzięki dubbingowi z ponad 60 języków na 33, i pozostaje dostępne zarówno poprzez przyjazną twórcom aplikację internetową, jak i API. Podajemy, że obsługujemy ponad 500 000 użytkowników wśród twórców i firm. Twój następny ruch to dopasowanie powyższych kryteriów do tego, jak często faktycznie lokalizujesz — a jeśli robisz to regularnie, podaj nam swoje języki i typ treści, abyśmy mogli wskazać Ci właściwy przepływ pracy.
Najczęściej zadawane pytania
Czym jest platforma do tworzenia mediów oparta na AI w prostych słowach?
To oprogramowanie, które pozwala tworzyć, udźwiękawiać i lokalizować media — szczególnie wideo i dźwięk — przy użyciu AI z jednego centralnego przepływu pracy, zamiast polegać na osobnych narzędziach dla każdego etapu.
Czym to się różni od podstawowego narzędzia do zamiany tekstu na mowę?
Osadzamy TTS wewnątrz szerszego procesu, który obejmuje klonowanie głosu, dubbing AI, zamianę mowy na tekst, separator mowy i generowanie wizualne, dzięki czemu przechodzisz od scenariusza lub materiału źródłowego do gotowej wielojęzycznej treści w jednym miejscu.
Czy mogę zachować własny głos przy dubbingu na inne języki?
Tak. Dzięki klonowaniu głosu i dubbingowi z mowy na mowę analizujemy Twój głos z krótkiej próbki i generujemy dźwięk w nowych językach, który zachowuje Twój ton, wysokość i styl mówienia.
Ile języków obsługuje DubSmart w dubbingu?
Obsługujemy dubbing z ponad 60 języków na 33 języki docelowe, obejmując główne rynki, na które zazwyczaj ekspandują amerykańscy twórcy i firmy.
Czy istnieje sposób, aby wypróbować DubSmart przed podjęciem zobowiązania?
Tak. Oferujemy darmowy poziom w modelu opartym na kredytach, dzięki czemu twórcy i zespoły mogą testować przepływy pracy, kredyty się przenoszą, a plany dla przedsiębiorstw obsługują użytkowanie o większym wolumenie.