Voice AI API to programowalne połączenie, które pozwala Twojej aplikacji tworzyć, rozumieć, przekształcać lub lokalizować mówione audio przy użyciu modeli AI, których nie musisz budować samodzielnie. Wysyłasz tekst, audio lub wideo do punktu końcowego i otrzymujesz coś użytecznego: zsyntetyzowaną narrację, transkrypcję, niestandardowy głos lub w pełni zdubbingowane wideo. Prawdziwe pytanie na początku nie brzmi, czy potrzebujesz „głosu AI" — chodzi o to, której funkcji głosowej faktycznie wymaga Twój produkt, ponieważ generowanie mowy, rozpoznawanie mowy, klonowanie głosu i dubbing to odrębne produkty, które przypadkiem dzielą wspólną nazwę kategorii.
Ten przewodnik omawia, co oznacza ten termin, główne typy API i czym się różnią, jak żądanie przechodzi przez potok przetwarzania, kryteria decyzyjne oddzielające dobre dopasowanie od kosztownego błędu oraz ryzyka, którymi warto zarządzać, zanim wdrożysz produkt. To centrum naszej serii dla deweloperów i API, więc znajdziesz tu odnośniki do bardziej szczegółowych przewodników integracyjnych tam, gdzie są przydatne.
Spis treści
Co tak naprawdę oznacza „voice AI API"
To wyrażenie łączy trzy idee. Voice AI to sztuczna inteligencja, która pracuje z ludzką mową lub generuje mowę syntetyczną. API to interfejs programowania aplikacji — zdefiniowany sposób wymiany żądań i odpowiedzi między dwoma systemami oprogramowania. Połączenie oznacza, że intensywne przetwarzanie modeli odbywa się po stronie dostawcy, podczas gdy Twoja aplikacja obsługuje doświadczenie użytkownika, reguły biznesowe i finalną treść.
Żądanie może być tak proste jak krótki ładunek JSON z tekstem, który chcesz usłyszeć, identyfikatorem głosu i kodem języka. Odpowiedź zazwyczaj zwraca identyfikator projektu, status przetwarzania i adres URL do wygenerowanego audio, gdy będzie gotowe. W przypadku lokalizacji wideo żądanie odwołuje się natomiast do przesłanego pliku i listy języków docelowych.
Ta struktura odróżnia API od generatora głosu w przeglądarce. Aplikacja webowa jest zbudowana tak, by osoba obsługiwała ją ręcznie, jedno zadanie na raz. API jest zbudowane tak, by oprogramowanie wywoływało je wielokrotnie, automatycznie i na dużą skalę. Jeśli produkujesz jeden sporadyczny lektor, narzędzie webowe jest często szybsze. Jeśli lokalizujesz każde publikowane wideo, API jest tym, o co chodzi.
Pięć głównych typów voice AI API
„Voice AI API" to kategoria, a nie jedna technologia. Pięć powszechnych typów przyjmuje różne dane wejściowe i zwraca różne wyniki, a wybór niewłaściwego marnuje czas integracji. Poniższa tabela je odwzorowuje, abyś mógł dopasować materiał wyjściowy do pożądanego rezultatu.
| Typ API | Wejście | Wyjście | Typowe zastosowanie |
|---|---|---|---|
| Text-to-speech | Tekst pisany | Syntetyczne audio mowy | Narracja, dostępność, komunikaty w aplikacjach, szkolenia |
| Speech-to-text | Mowa lub wideo | Transkrypcja pisemna | Napisy, wyszukiwanie, notatki ze spotkań, przerabianie treści |
| Klonowanie głosu | Autoryzowana próbka głosu | Niestandardowy głos syntetyczny | Głosy marki, powracający prezenterzy, wielojęzyczna narracja |
| Dubbing AI | Wideo lub audio | Przetłumaczone i zdubbingowane media | Lokalizacja YouTube, kursy, filmy, podcasty |
| Speech-to-speech | Nagrana mowa | Przekształcona lub przetłumaczona mowa | Konwersja głosu, produkcja wielojęzyczna |
Zasada wyboru jest prosta. Jeśli masz już scenariusz, text to speech jest zwykle najprostszą drogą. Jeśli masz nagranie, które potrzebuje transkrypcji, potrzebujesz speech to text. Jeśli chcesz zachować tożsamość tego samego prezentera w kilku językach, bardziej odpowiednie jest klonowanie głosu lub dubbing. Aby zapoznać się z ukierunkowanym wyjaśnieniem samej strony TTS, nasz towarzyszący przewodnik na temat czym jest API text to speech głębiej zagłębia się w potok syntezy.
Warte uwagi rozróżnienie: klonowanie głosu to nie zmieniacz głosu. Zmieniacz głosu przekształca istniejące wykonanie na miejscu, podczas gdy klonowanie tworzy wielokrotnego użytku model głosu, który generuje nową mowę z tekstu lub innego kontrolowanego wejścia.
Jak żądanie przechodzi przez potok przetwarzania
Implementacje się różnią, ale większość API głosowych przechodzi przez te same cztery etapy. Zrozumienie kształtu przepływu oszczędza godziny domysłów, gdy coś zwraca nieoczekiwany status.
Po pierwsze, Twoja aplikacja uwierzytelnia się. Wysyła klucz API lub token bearer w nagłówku żądania. API TTS DubSmart na przykład używa punktu końcowego REST z uwierzytelnianiem tokenem bearer i żądań JSON względem bazowego adresu URL https://dubsmart.ai/api/v1. Zasada, która ma większe znaczenie, niż się wydaje: nigdy nie umieszczaj prywatnego klucza w JavaScript po stronie przeglądarki ani w rozprowadzanej aplikacji mobilnej. Przechowuj go na bezpiecznym serwerze i spraw, by Twój klient wywoływał ten serwer.
Po drugie, Twoja aplikacja wysyła treść i ustawienia. Żądanie zwykle niesie jakąś mieszankę tekstu lub odwołania do pliku, języka źródłowego i docelowego, identyfikatora głosu, prędkości lub wysokości tonu, informacji o mówcy, preferencji wyjściowych i metadanych projektu. W przypadku prostego TTS treścią jest tekst. W przypadku dubbingu API często wymaga najpierw przesłania wideo, a następnie osobnego żądania utworzenia projektu.
Po trzecie, usługa przetwarza treść. W zależności od zadania może to oznaczać normalizację i interpretację tekstu, przewidywanie wymowy i prozodii, tłumaczenie mówionej treści, oddzielanie mówców lub izolowanie mowy od dźwięków tła, generowanie audio głosem standardowym lub niestandardowym oraz synchronizowanie wyniku z osią czasu wideo. Dłuższe zadania działają asynchronicznie: zamiast zwracać gotowy plik, API zwraca identyfikator projektu.
Po czwarte, Twoja aplikacja pobiera wynik — adres URL audio lub wideo, adresy URL poszczególnych segmentów, transkrypcję, przetłumaczony tekst, dane czasowe oraz pola statusu lub błędu. API TTS DubSmart dokumentuje stany projektu takie jak pending, processing, completed i failed, a ukończone projekty mogą zwracać adresy URL MP3 na poziomie projektu lub segmentu.
Synchroniczne kontra asynchroniczne: rozróżnienie, które kształtuje Twoją implementację
Sposób, w jaki API zwraca wyniki, określa, jak zaprojektujesz wokół niego architekturę, więc zdecyduj o tym, zanim napiszesz kod integracji.
Synchroniczne API utrzymuje żądanie otwarte do zakończenia przetwarzania, a następnie zwraca wynik. To dobrze sprawdza się przy krótkim tekście, zwięzłych komunikatach głosowych, małych fragmentach audio i interaktywnych funkcjach o niskiej latencji. Jego słabością jest to, że długie zadania mogą przekroczyć limity czasu żądania.
Asynchroniczne API zwraca identyfikator projektu lub zadania natychmiast. Twoja aplikacja następnie odpytuje punkt końcowy statusu lub otrzymuje webhook po zakończeniu zadania. Ten model pasuje do długiej narracji, dubbingu wideo, wielu języków docelowych, generowania wsadowego i dużych plików. Udokumentowane przepływy pracy TTS i dubbingu DubSmart używają stanów projektu i pobierania wyników, co jest wzorcem asynchronicznym zbudowanym dla zadań medialnych.
Gdy oceniasz opcję, sprawdź, czy obsługuje webhooki. Odpytywanie co kilka sekund jest trywialne do wdrożenia, ale webhooki eliminują zbędne żądania i lepiej się skalują, gdy uruchamiasz wiele zadań naraz.
Co ocenić przed podjęciem decyzji
Właściwe API zależy od zadania, ale garść kryteriów dotyczy niemal każdego projektu. Przejdź przez nie świadomie, zamiast ufać krótkiemu demu.
Dopasowanie funkcjonalności. Potwierdź, że API obsługuje dokładnie to zadanie — text to speech, speech to text, klonowanie głosu, dubbing, wielu mówców, wyjście tylko audio lub wideo, w czasie rzeczywistym lub wsadowo. Nie zakładaj, że cokolwiek reklamowanego jako „voice AI" obejmuje wszystkie te możliwości.
Zakres języków. Sprawdź języki źródłowe i docelowe. „Obsługuje 30 języków" może oznaczać 30 głosów TTS, 30 celów tłumaczenia lub mieszankę języków i dialektów. Dla kanału wielojęzycznego rozważ też jakość akcentu, wymowę nazw i miejsc, słownictwo regionalne, dostępność głosów na język oraz to, czy jeden sklonowany głos przenosi się między językami.
Obsługa wyjścia i mediów. Zweryfikuj formaty audio, kontenery wideo, częstotliwość próbkowania i bitrate, pobieranie na poziomie segmentów, pełne wyrenderowane wideo, dostępność transkrypcji lub napisów oraz maksymalny rozmiar pliku. To kształtuje Twój przepływ pracy przy edycji i koszty przechowywania.
Jakość i możliwość kontroli. Wsłuchaj się w naturalne pauzy, poprawną wymowę, stabilną głośność, spójną tożsamość mówcy, odpowiednie akcentowanie i dokładne wyczucie czasu. Głos może brzmieć nienagannie w dziesięciosekundowej próbce, a potknąć się na terminach technicznych, długich akapitach, liczbach czy nietypowych nazwach. Testuj reprezentatywną treść, a nie wyselekcjonowany klip dostawcy.
Latencja i przepustowość. Zmierz czas względem Twojego rzeczywistego obciążenia. Jeden krótki lektor i setki zlokalizowanych filmów to różne problemy. Zapytaj, czy przetwarzanie jest w czasie rzeczywistym czy asynchroniczne, jakie są limity szybkości, czy zadania działają równolegle, czy istnieje przetwarzanie priorytetowe oraz jak ponawiane są niepowodzenia. DubSmart podaje, że typowe pięciominutowe wideo zajmuje około jednej minuty przetwarzania, zaznaczając, że czas zależy od długości i rozmiaru pliku.
Model cenowy. API głosowe mogą naliczać opłaty według znaków, słów, czasu trwania audio lub wideo, kredytów, żądań, przechowywania lub równoczesnych zadań. W przypadku dubbingu liczba języków docelowych zwielokrotnia efektywny koszt. Oblicz kompletny przepływ pracy — ponowne próby, ponownie wygenerowane segmenty, przegląd tłumaczenia, przechowywanie — a nie tylko pierwsze wywołanie. Nasza analiza cennika voice AI API szczegółowo omawia matematykę kredytów.
Ryzyka, którymi warto zarządzać wcześnie
Voice AI wprowadza tryby awarii, które nie istnieją w zwykłych narzędziach medialnych. Zajęcie się nimi na etapie projektowania jest znacznie tańsze niż po publicznym błędzie.
Nieautoryzowane użycie głosu. Klonowanie głosu osoby bez pozwolenia stwarza ekspozycję prawną, etyczną i reputacyjną. Stosuj pisemny proces zgody, który określa, kto jest właścicielem nagrania, co może zostać wygenerowane, gdzie głos może być używany, czy użycie komercyjne jest dozwolone, jak głos jest usuwany i co dzieje się po zakończeniu umowy.
Nieprawidłowe tłumaczenie lub wymowa. Generowana mowa może źle obsłużyć nazwy, akronimy, adresy i terminy branżowe. Utrzymuj przegląd przez człowieka w pętli dla treści publicznych: odczyt przetłumaczonego scenariusza, odsłuch przez native speakera, wyrywkowe sprawdzenia wymowy, przebieg kontrolujący wyczucie czasu i ruch ust oraz końcowy przegląd wyeksportowanych mediów.
Podszywanie się i oszustwa. Głosy syntetyczne mogą być nadużywane do oszustw lub fałszywych rekomendacji. Unikaj generowania czegokolwiek, co mogłoby sprawić, że rozsądny słuchacz uwierzy, że prawdziwa osoba powiedziała coś, czego nie powiedziała. W przypadku wrażliwej komunikacji dodaj ujawnienie, kontrole zatwierdzania i dzienniki audytu.
Prywatność głosu i danych. Próbki mogą zawierać dane osobowe. Przed przesłaniem ustal zgodę, reguły przechowywania, ograniczenia dostępu, procedury usuwania, warunki przetwarzania danych dostawcy oraz wszelkie zasady wtórnego użycia. DubSmart podaje, że przesłane pliki do klonowania są szyfrowane oraz że użytkownicy mogą usuwać niestandardowe głosy i powiązane dane audio, choć zespoły powinny nadal potwierdzić aktualne warunki i kontrole dla swojego konkretnego planu.
Zmiany dostawcy i modelu. Identyfikatory głosów, obsługa języków, formaty wyjściowe i limity szybkości mogą się zmieniać. Traktuj API jako zewnętrzną zależność: przypnij konfigurację tam, gdzie możesz, przechowuj scenariusze źródłowe, zapisuj zatwierdzone audio, monitoruj wskaźniki błędów, utrzymuj awaryjny przepływ pracy i ponownie testuj po dużych aktualizacjach dostawcy. Dla zespołów, które chcą mniej ruchomych części, nasze podsumowanie narzędzi wideo AI typu all-in-one wyjaśnia kompromisy związane z konsolidacją tych możliwości.
Kiedy API przewyższa ręczny przepływ pracy
Voice AI API uzasadnia swój koszt integracji, gdy potrzebujesz powtarzalnej, programowej produkcji. Dobrze się sprawdza, gdy twórca publikuje zlokalizowane wersje każdego wideo, mała firma generuje narrację produktową w kilku językach, firma e-learningowa aktualizuje setki lekcji, podcast wypuszcza przetłumaczone wydania, produkt programowy dodaje mówioną dostępność lub agencja wplata generowanie głosu w swój system zarządzania treścią.
Ręczny, studyjny przepływ pracy może nadal wygrać w konkretnych przypadkach: gdy projekt opiera się na wysoce niuansowym ludzkim wykonaniu, gdy zatwierdzenie prawne wymaga profesjonalnego aktora, gdy treść niesie wrażliwe stwierdzenia, gdy jednorazowe nagranie jest szybsze niż budowanie integracji lub gdy wynik wymaga intensywnego kierownictwa artystycznego. Chodzi nie o zastąpienie każdego ludzkiego głosu. Chodzi o automatyzację części, w których spójność, szybkość, skala lub wyjście wielojęzyczne mają największe znaczenie.
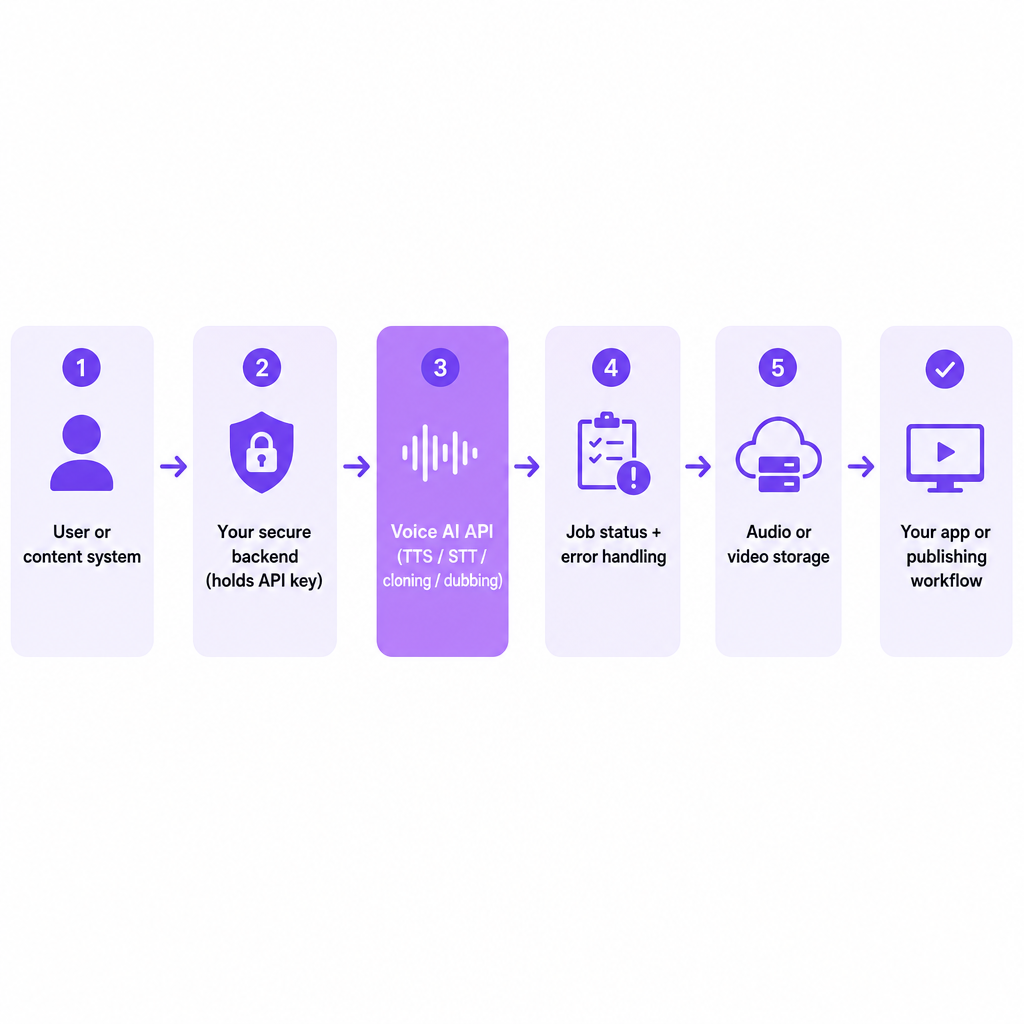
Dla małej implementacji utrzymaj prostą architekturę. Bezpieczny backend znajduje się między Twoim użytkownikiem lub systemem treści a API głosowym. Ten backend utrzymuje poświadczenia w tajemnicy, waliduje dane wejściowe, tworzy projekty, przechowuje identyfikatory zadań, odpytuje status lub odbiera webhooki, ponawia tymczasowe niepowodzenia, zapisuje adresy URL wyników i metadane, stosuje limity użycia oraz rejestruje zgodę na każdy sklonowany głos. Wersja skierowana do twórcy mogłaby przyjąć gotowe wideo w języku angielskim, wysłać je do punktu końcowego dubbingu dla wybranych języków, zaczekać na zakończenie, skierować wyniki do folderu przeglądowego i publikować dopiero po zatwierdzeniu.
Gdzie wpisuje się DubSmart
Wbudowujemy kilka możliwości API związanych z głosem w jedną platformę mediów AI, co ma największe znaczenie, gdy chcesz połączyć generowanie i lokalizację z istniejącym przepływem pracy, zamiast uruchamiać każde zadanie ręcznie.
Nasze API Text to Speech zapewnia programowe generowanie mowy z głosami neuronowymi, klonowaniem głosu, obsługą wielu języków, śledzeniem statusu projektu i wynikami MP3 — jego przykładowe żądanie używa segmentów tekstu z identyfikatorem głosu, językiem, prędkością i wysokością tonu. Nasze API Klonowania Głosu podąża za trzyetapowym wzorcem: zażądaj wstępnie podpisanego adresu URL do przesłania, prześlij próbkę audio, a następnie utwórz niestandardowy głos z klucza przesłanego pliku; akceptuje MP3, WAV, AAC, M4A i FLAC, a dla lepszych wyników zalecamy co najmniej 20 sekund czystego audio. Nasze API Dubbingu AI obsługuje lokalizację wideo z tworzeniem projektów wielojęzycznych, ustawieniami mówców, przetłumaczonymi segmentami i możliwym do pobrania zdubbingowanym wynikiem, akceptując dane wejściowe takie jak MP4, MOV, AVI, MKV i WebM o rozmiarze do 5 GB.
Jeśli zastanawiasz się, od którego punktu końcowego zacząć, dopasuj go do swojej treści: narracja ze scenariusza wskazuje na TTS, autoryzowany powracający głos wskazuje na klonowanie, a wideo wielojęzyczne wskazuje na dubbing.
Często zadawane pytania
Czym jest voice AI API w prostych słowach?
To połączenie, które pozwala oprogramowaniu generować, rozpoznawać, klonować, tłumaczyć lub przekształcać mowę bez budowania własnego systemu głosu AI. Twoja aplikacja wysyła żądanie i otrzymuje przetworzone audio, tekst lub wideo.
Czy voice AI API to to samo co text to speech?
Nie. Text to speech to jeden typ voice AI API. Kategoria obejmuje również rozpoznawanie mowy, klonowanie głosu, dubbing i funkcje speech-to-speech.
Czy potrzebuję doświadczenia w programowaniu, by z niego korzystać?
Zazwyczaj trochę, ponieważ API wiążą się z uwierzytelnianiem, żądaniami HTTP, JSON, przesyłaniem plików i obsługą statusów. Przy sporadycznych zadaniach ręcznych aplikacja webowa typu no-code jest często łatwiejsza.
Czy voice AI API może przetłumaczyć wideo z YouTube?
API dubbingu może przetłumaczyć i wygenerować nowe audio dla wideo, gdy obsługuje wymagane języki źródłowe i docelowe, format pliku oraz przepływ pracy wyjściowej. Przejrzyj wynik przed publikacją.
Czy mogę sklonować głos dowolnej osoby?
Technicznie możliwe to nie to samo co dozwolone prawnie lub etycznie. Klonuj głos tylko za odpowiednim pozwoleniem i przestrzegaj zasad dostawcy, swoich umów oraz obowiązujących wymogów dotyczących prywatności i wizerunku.