Większość projektów wideo nie kończy się w momencie zatrzymania nagrywania. Transkrypcja, czyszczenie dźwięku, lektor, dubbing, generowanie obrazów, animacja, a czasem integracja API — wszystko to znajduje się pomiędzy surowym materiałem a gotowym, gotowym do publikacji zasobem. Najbardziej przydatne kompleksowe narzędzia wideo AI rozwiązują ten problem rozdrobnienia: zamiast eksportować pliki między niepowiązanymi aplikacjami, przechodzisz od materiału źródłowego do zlokalizowanych, zdubbingowanych i ponownie wykorzystanych treści w ramach jednego połączonego przepływu pracy.
Ta lista nie jest rankingiem popularności. Wybraliśmy narzędzia z naszego własnego zestawu do tworzenia mediów na podstawie zadania produkcyjnego, które każde z nich eliminuje, i oznaczamy ograniczenia każdego z nich, abyś mógł je przetestować przed podjęciem zobowiązania. Nasze kryteria selekcji to zakres przepływu pracy, praktyczne wejścia i wyjścia, potencjał integracji, dopasowanie do odbiorców w postaci twórców i zespołów oraz przejrzyste ograniczenia, takie jak obsługiwane formaty i kwalifikacje językowe. Poniższe sekcje są uporządkowane według przypadków użycia, ponieważ odpowiedni punkt wyjścia zależy od tego, czy najbardziej zależy ci na publikowaniu wielojęzycznym, czyszczeniu dźwięku, krótkich materiałach wizualnych, transkrypcji czy automatyzacji dla programistów.
Spis treści
Dubbing AI do wielojęzycznego publikowania wideo
Jeśli gotowy zasób już istnieje i po prostu musi dotrzeć do szerszej publiczności, dubbing jest dobrym punktem wyjścia. Nasz Dubbing AI obsługuje dubbing z ponad 60 języków źródłowych na 33 języki docelowe, klonuje głosy mówców i jest stworzony tak, aby zachować ton, emocje i kontekst podczas lokalizacji.
To, co odróżnia go od zwykłego tłumacza tekstu lub samodzielnego generatora głosu, to fakt, że cała praca odbywa się w jednym projekcie. Przesyłasz plik wideo lub audio albo wklejasz link do YouTube, wybierasz język docelowy, dodajesz mówców, edytujesz tekst lub taktowanie, regenerujesz pojedyncze segmenty, gdy jakaś kwestia wymaga poprawek, i pobierasz wynik. Zdubbingowany dźwięk można również dopasować do ruchów ust i mimiki postaci, co ma znaczenie, gdy wyjściem jest wideo, a nie tylko dźwięk.
Najlepsze dla: twórców YouTube, zespołów e-learningowych, firm, filmowców i podcasterów przenoszących istniejące treści na nowe języki. Pasuje również do zespołów, które chcą przetestować wersję międzynarodową przed zleceniem tradycyjnego dubbingu.
Ograniczenie, o którym warto wiedzieć: strona publiczna nie wymienia wszystkich 33 języków docelowych ani wszystkich ponad 60 języków źródłowych i nie określa formatów do pobrania, maksymalnej rozdzielczości ani czasów przetwarzania. Najpierw przetestuj reprezentatywny klip, najlepiej taki z wieloma mówcami, akcentami, muzyką lub specjalistyczną terminologią, zanim przeznaczysz do przetworzenia dużą partię.
Zamiana mowy na tekst dla napisów, transkrypcji i ponownego wykorzystania
Transkrypcja znajduje się na obu końcach przepływu pracy: zanim nagranie stanie się scenariuszem i po tym, gdy stanie się treścią, którą chcesz ponownie wykorzystać. Nasze narzędzie do zamiany mowy na tekst przekształca dźwięk lub wideo w edytowalny tekst i napisy oraz akceptuje linki do YouTube, a także przesłany dźwięk i wideo.
Proces jest prosty: przesyłasz plik lub wklejasz link, generujesz transkrypcję lub projekt napisów, dodajesz mówców, edytujesz, a następnie pobierasz w potrzebnym formacie. Narzędzie opisano jako obsługujące długie nagrania, spotkania, wywiady, wykłady, podcasty, wielu mówców, szumy w tle i różne akcenty, co czyni je praktycznym dla rzeczywistego materiału, a nie tylko dla czystego dźwięku studyjnego.
Najlepsze dla: przekształcania długich materiałów wideo w napisy, przeszukiwalne transkrypcje, scenariusze do dubbingu, pisane artykuły lub krótkie klipy oraz poprawy dostępności dla odbiorców niesłyszących i niedosłyszących.
Ograniczenie, o którym warto wiedzieć: zakres językowy jest opisany na dwa sposoby na stronie — do 99 języków w jednym miejscu i ponad 60 w sekcji FAQ, więc potwierdź dokładny język swojego projektu przed produkcją. Pliki mogą mieć do 5 GB bez podanego limitu długości wideo, ale nie ma opublikowanej wartości dokładności ani szczegółowego wyjaśnienia automatycznej identyfikacji mówców. Dokładność zależy od jakości dźwięku, nakładającej się mowy i słownictwa technicznego. Jeśli później zlokalizujesz tę transkrypcję, nasz Dubbing AI podejmie pracę tam, gdzie kończy się edytowany tekst.
Separator mowy do czyszczenia zaszumionych nagrań
Czysty dźwięk źródłowy po cichu decyduje o jakości wszystkiego, co następuje później. Nasz Separator mowy izoluje mówiony głos od szumów w tle, celując w nagrania zepsute przez hałas uliczny, sprzężenie mikrofonu lub dźwięki otoczenia.
Powód, dla którego należy do wczesnego etapu zestawu, jest konkretny: szumy w tle obniżają jakość klonu głosu, dlatego separację pozycjonujemy jako krok przygotowawczy przed klonowaniem, a także przed transkrypcją i narracją. Obsługuje popularne formaty audio, w tym MP3, WAV i AAC, a także akceptuje pliki wideo, więc możesz czyścić materiał źródłowy bezpośrednio, zamiast najpierw ręcznie wyodrębniać ścieżkę dźwiękową.
Najlepsze dla: podcasterów, producentów wywiadów i filmowców ratujących użyteczną mowę z niedoskonałego dźwięku produkcyjnego oraz wszystkich przygotowujących czystą próbkę do klonowania głosu.
Ograniczenie, o którym warto wiedzieć: strona opisuje oddzielanie mowy od szumów w tle, a nie pełną separację ścieżek wielu mówców. Nie określa, jak radzi sobie z nakładającymi się mówcami, nagraniami z dużą ilością muzyki, silnym echem lub skrajnie zmiennym szumem. Odsłuchaj oczyszczony plik, zanim potraktujesz go jako finalny miks lub źródło do klonowania.
Obraz na wideo do krótkich wstawek wizualnych
Gdy potrzebujesz ruchu, ale nie chcesz filmować, animowanie nieruchomego obrazu to najszybsza droga. Nasze narzędzie Obraz na wideo zamienia wysokiej jakości nieruchomy obraz w krótki animowany klip: przesłany obraz staje się pierwszą klatką, a tekstowy prompt opisuje ruch obiektu, ruch kamery lub dynamikę sceny.
Przepływ pracy z założenia pozostaje krótki. Prześlij obraz wysokiej jakości, opisz ruch, wybierz czas trwania, rozdzielczość, proporcje i jakość, a następnie wygeneruj, przejrzyj i pobierz. Dostępne czasy trwania to 4, 6 i 8 sekund. Proporcje obejmują poziome, kwadratowe i pionowe, w tym 16:9, 1:1 i 9:16. Standardowa jakość tworzy wideo bez dźwięku, natomiast opcje High i Ultra High są opisane jako zawierające dźwięk.
Najlepsze dla: zespołów social media, marketerów i edukatorów potrzebujących animowanych intro, przejść, klipów z grafiką produktową lub ruchu na slajdach, którzy następnie wstawiają te klipy do większej edycji.
Ograniczenie, o którym warto wiedzieć: to generator krótkich klipów, a nie edytor materiałów długich, a publikowane czasy trwania kończą się na 8 sekundach. Strona nie określa formatów plików obrazów, maksymalnego rozmiaru pliku, długości promptu, limitów generowania ani dokładnego zachowania dźwięku. Używaj czystych, wolnych od artefaktów obrazów źródłowych i traktuj każde wyjście jako element większego projektu. Jeśli potrzebujesz samej grafiki źródłowej, nasz generator obrazów AI tworzy nieruchome obrazy, które możesz następnie animować.
API dubbingu AI do skalowalnej, powtarzalnej lokalizacji
Sporadyczne ręczne eksporty sprawdzają się do momentu, aż lokalizacja staje się powtarzalnym zadaniem. Do tego celu udostępniamy API dubbingu AI stworzone do tłumaczenia i dubbingu wideo na ponad 33 języki, w tym z możliwościami klonowania głosu.
Wartość tego rozwiązania różni się od edytora opartego na przeglądarce. API pozwala wyzwalać i zarządzać lokalizacją z wnętrza istniejącej aplikacji, dzięki czemu możesz połączyć dubbing z platformą do przesyłania wideo, systemem zarządzania nauczaniem, pipeline'em przetwarzania mediów, panelem agencji lub automatycznym przepływem publikacji. To nie kolejny element kontroli twórczej; to możliwość uczynienia lokalizacji powtarzalnym systemem.
Najlepsze dla: programistów, agencji i zespołów SaaS generujących wersje językowe automatycznie po przesłaniu plików, budujących wielojęzyczne biblioteki szkoleniowe lub przetwarzających duże katalogi treści. Zespoły rozważające koszty automatyzacji mogą zapoznać się z naszym wyjaśnieniem cennika API głosu AI przed zaplanowaniem budowy.
Ograniczenie, o którym warto wiedzieć: strona publiczna potwierdza istnienie API, ale nie publikuje zachowania punktów końcowych, wymagań uwierzytelniania, limitów szybkości, webhooków, formatów wyjściowych ani wskazówek dotyczących obsługi błędów. Poproś o aktualną dokumentację techniczną lub zapoznaj się z nią przed oszacowaniem nakładu pracy przy wdrożeniu.
Jeden przepływ pracy dla czyszczenia, transkrypcji, materiałów wizualnych i lokalizacji
Prawdziwym argumentem za platformą kompleksową nie jest to, że każda pojedyncza funkcja przewyższa każdą specjalistyczną aplikację. Chodzi o to, że kilka kroków działa w ramach jednego szerszego przepływu pracy, dzięki czemu zasoby źródłowe, transkrypcje, dźwięk i zlokalizowane wersje pozostają bliżej siebie przy mniejszej liczbie przekazywań plików.
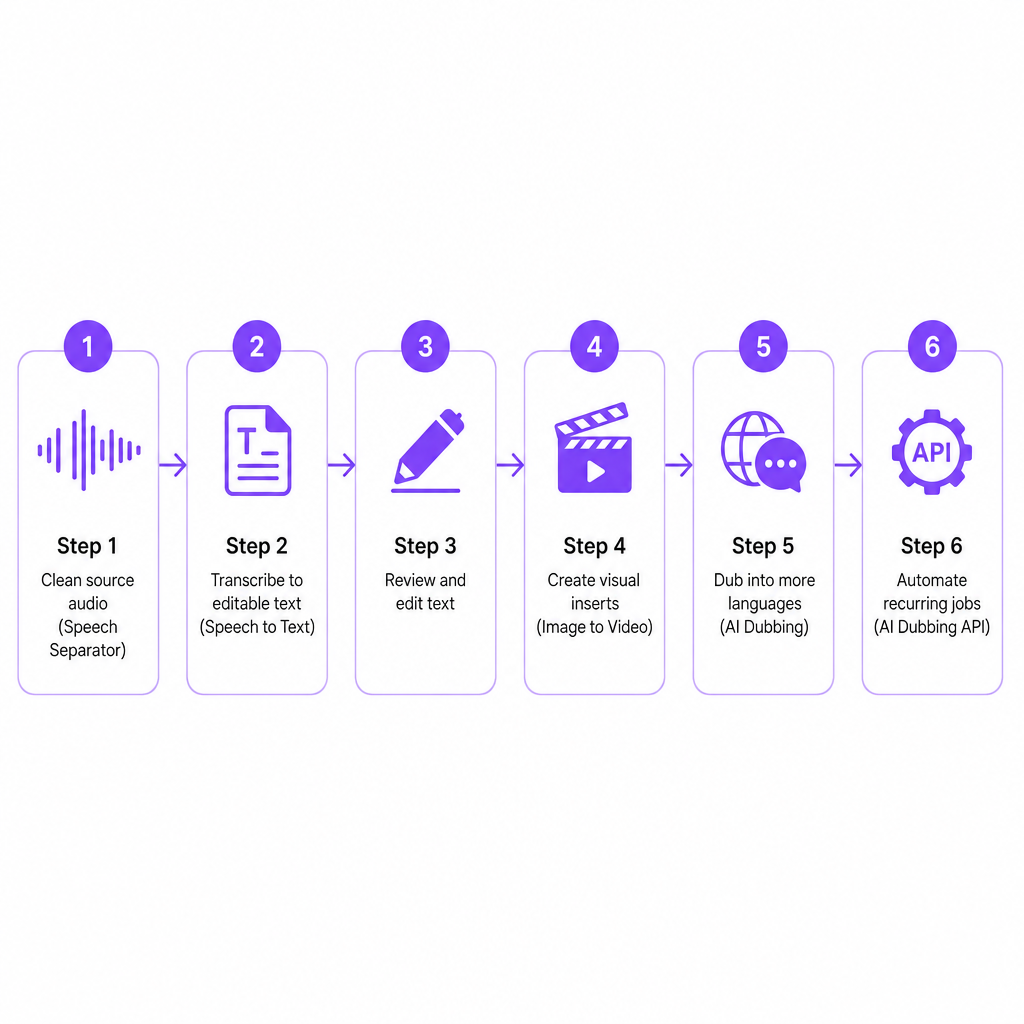
Powtarzalna sekwencja wygląda tak:
- Oczyść nagranie źródłowe za pomocą Separatora mowy.
- Przetranskrybuj treść za pomocą Zamiany mowy na tekst.
- Przejrzyj i edytuj tekst przed narracją lub lokalizacją.
- Utwórz nowe wstawki wizualne za pomocą Obraz na wideo.
- Zdubbinguj gotowe wideo na dodatkowe języki.
- Połącz powtarzalne zadania produkcyjne poprzez API.
Ta struktura najbardziej się opłaca, gdy ten sam zespół tworzy, dostosowuje i lokalizuje treści w regularnym rytmie, w tym wielojęzyczne kanały YouTube, małe zespoły marketingowe z częstymi filmami produktowymi, korporacyjne biblioteki szkoleniowe oraz agencje żonglujące kilkoma językami klientów.
Ograniczenie, o którym warto wiedzieć: kompleksowy nie oznacza w pełni automatyczny. Transkrypcje nadal wymagają przeglądu, tłumaczenia mogą wymagać adaptacji kulturowej, sklonowane głosy wymagają pozwolenia, a wygenerowane materiały wizualne wymagają wyboru lub edycji. Niektóre szczegóły techniczne pozostają nieokreślone na stronach produktów, więc zweryfikuj swoje dokładne typy plików, języki, limity i wymagania eksportu przed przeniesieniem całej operacji. Nasza lista kontrolna lokalizacji wideo dla zespołów to praktyczny sposób na przetestowanie tego przekazania.
Jak wybrać odpowiednie narzędzie do swojego zadania
Dopasuj zadanie do możliwości, zamiast zaczynać od listy funkcji. Poniższa mapa wskaże ci odpowiedni punkt wyjścia dla najczęstszych zadań produkcyjnych.
| Twoje główne zadanie | Zacznij od | Dlaczego |
|---|---|---|
| Opublikuj istniejące wideo w innych językach | Dubbing AI | Lokalizuje wideo lub audio i obsługuje sklonowane głosy mówców |
| Utwórz napisy lub przeszukiwalną transkrypcję | Zamiana mowy na tekst | Przekształca przesłany dźwięk, wideo lub linki YouTube w edytowalny tekst |
| Popraw zaszumiony dialog | Separator mowy | Izoluje mowę od szumów w tle, obsługuje MP3, WAV, AAC |
| Animuj nieruchomy obraz | Obraz na wideo | Dodaje ruch na podstawie obrazu oraz tekstowego promptu ruchu |
| Wbuduj lokalizację w produkt | API dubbingu AI | Łączy dubbing z aplikacją lub zautomatyzowanym pipeline'em mediów |
| Przygotuj próbkę głosu do klonowania | Separator mowy, a następnie klonowanie | Czystszy dźwięk źródłowy poprawia jakość klonowania |
| Twórz wielojęzyczne treści kursów | Zamiana mowy na tekst plus Dubbing AI | Najpierw transkrypcja, następnie zlokalizowane wersje głosowe |
Zanim ujednolicisz pracę na jakiejkolwiek platformie, przeprowadź krótką weryfikację. Potwierdź, że twoje języki źródłowe i docelowe są obsługiwane, sprawdź maksymalne rozmiary plików i czasy trwania oraz przetestuj, czy eksporty płynnie przechodzą do twojego przepływu pracy edycyjnej lub publikacyjnej. Wyjaśnij, czy mówcy są identyfikowani automatycznie, czy dodawani ręcznie, potwierdź, że masz pozwolenie na sklonowanie lub syntezę każdego głosu, i sprawdź, czy wygenerowane klipy są wystarczająco długie dla swojego miejsca. Na koniec zdecyduj, gdzie człowiek przejrzy tłumaczenie, wymowę, taktowanie i kontekst kulturowy oraz czy potrzebujesz API do przetwarzania wsadowego. Uczciwa odpowiedź na te pytania zwykle podpowie ci, czy pojedyncza platforma, czy wąskie specjalistyczne narzędzie pasuje do pracy, którą masz przed sobą.
Najczęściej zadawane pytania
Czym są kompleksowe narzędzia wideo AI?
Łączą one kilka zadań produkcji medialnej, takich jak transkrypcja, generowanie głosu, czyszczenie dźwięku, animacja obrazów i dubbing, w ramach jednej platformy lub połączonego przepływu pracy, dzięki czemu unikasz eksportowania plików między niepowiązanymi aplikacjami.
Które narzędzie jest najlepsze do wielojęzycznych treści na YouTube?
Zacznij od Dubbingu AI. Obsługuje dubbing z ponad 60 języków źródłowych na 33 języki docelowe, z klonowaniem głosu mówców i edytowalnymi projektami dubbingu. Potwierdź dokładną parę językową i przejrzyj próbkę przed publikacją na dużą skalę.
Czy mogę używać tych narzędzi do podcastów?
Tak. Separator mowy czyści zaszumiony dźwięk podcastu, Zamiana mowy na tekst tworzy transkrypcję, a Dubbing AI produkuje zlokalizowane wersje. Nasze strony wyraźnie opisują przypadki użycia dla podcastów, wywiadów i audio.
Czy zamiana mowy na tekst obsługuje długie wideo?
Nie ma podanego limitu długości wideo, ale istnieje limit rozmiaru pliku wynoszący 5 GB. Dokładność może się jednak różnić w zależności od jakości dźwięku, akcentów, nakładających się mówców i specjalistycznej terminologii.
Czy filmy zdubbingowane przez AI są gotowe do publikacji bez przeglądu?
Nie zawsze. Dubbing przyspiesza produkcję, ale najpierw przejrzyj tłumaczenia, nazwy, taktowanie, wymowę, pozwolenia dotyczące głosu i kontekst kulturowy. Krótki testowy eksport ma największe znaczenie dla treści z wieloma mówcami lub specjalistycznym językiem.